

Inferless Overview
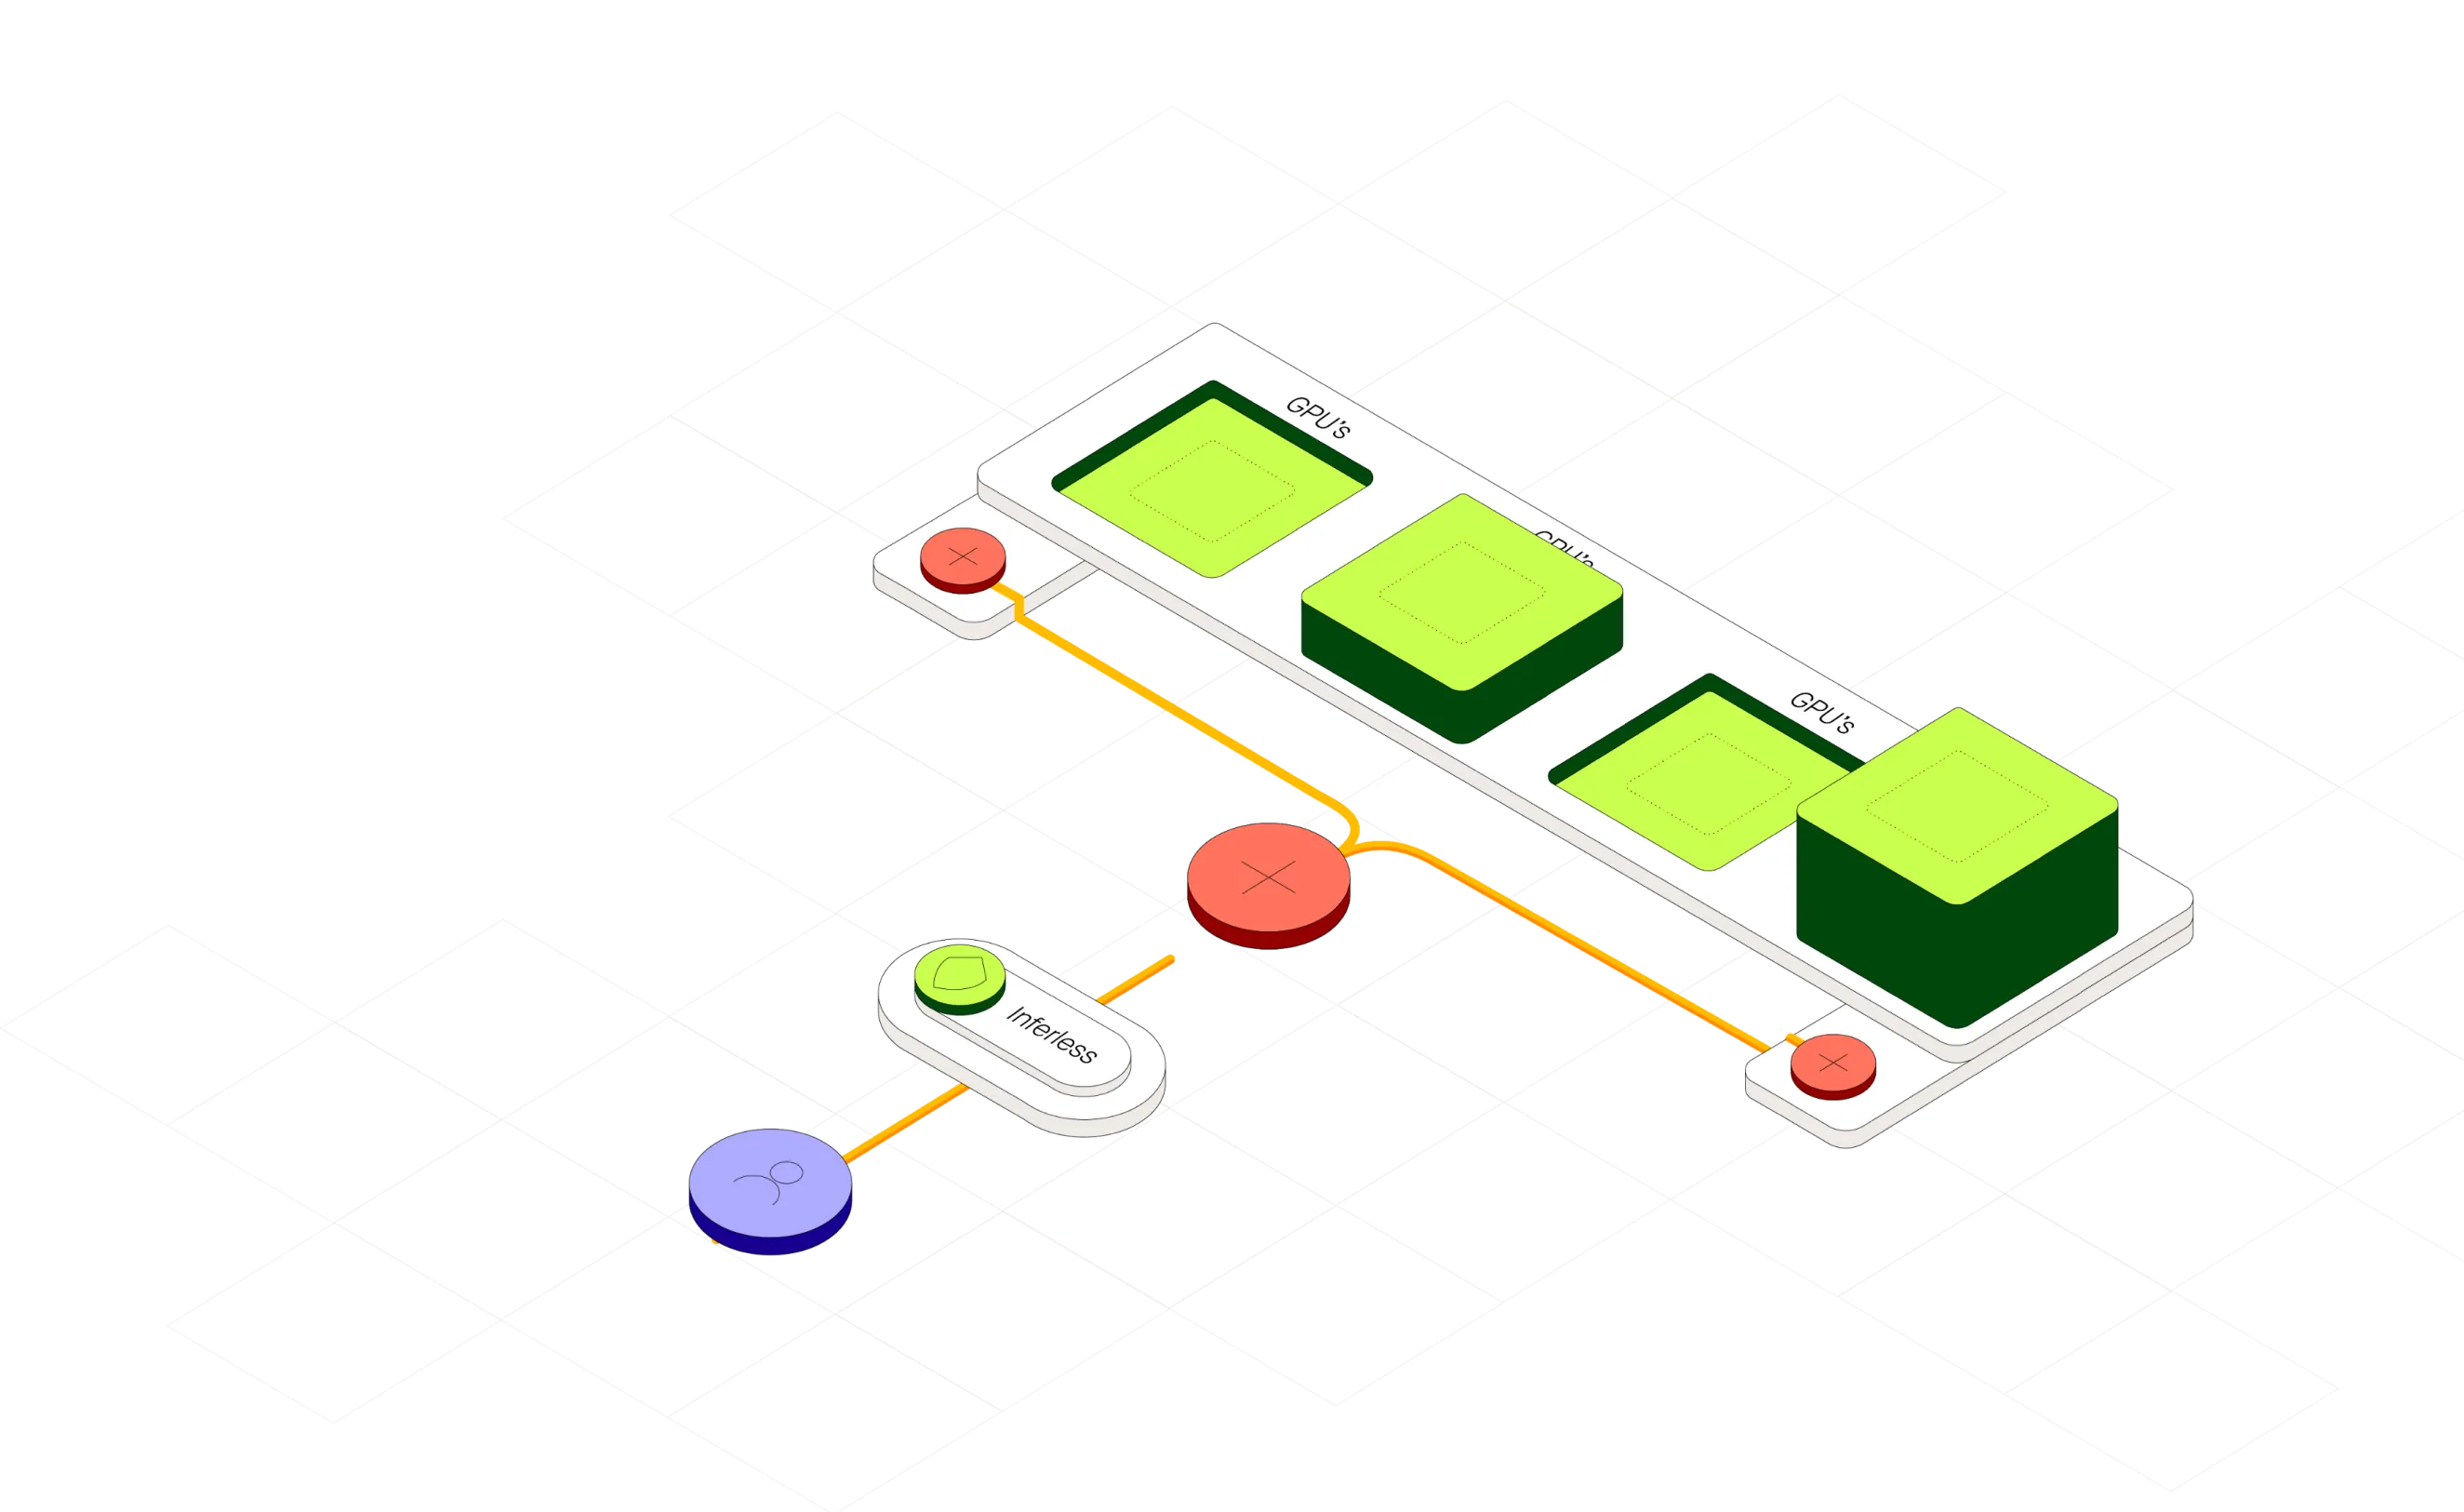
Inferless est une plateforme GPU sans serveur de pointe conçue pour rationaliser le déploiement de modèles d'apprentissage automatique pour les charges de travail de production. Elle permet aux développeurs et aux scientifiques des données de passer d'un fichier de modèle à un point de terminaison d'API en direct et évolutif en quelques minutes seulement, en faisant totalement abstraction des complexités de la gestion de l'infrastructure. En prenant en charge le déploiement direct à partir de sources telles que Hugging Face, Git, Docker ou sa propre CLI, Inferless offre une flexibilité inégalée et accélère le passage à la production.
La plateforme est conçue pour gérer des schémas de trafic imprévisibles et fluctuants grâce à ses capacités robustes de mise à l'échelle automatique, passant de zéro à des centaines de GPU à la demande. Cela garantit une haute disponibilité et des performances élevées sans le coût des ressources inactives. Avec un fort accent sur la fiabilité et la sécurité de niveau entreprise, Inferless est certifié SOC-2 Type II et subit des analyses de vulnérabilité régulières, ce qui en fait un choix de confiance pour les entreprises de toutes tailles.
Comment utiliser Inferless
Le déploiement d'un modèle sur Inferless est un processus simple conçu pour la vitesse et l'efficacité :
- Inscrivez-vous et Connectez-vous : Créez un compte Inferless et connectez votre source de modèle. Vous pouvez intégrer directement votre compte Hugging Face, un dépôt Git ou un registre Docker.
- Importez votre Modèle : Dans l'espace de travail Inferless, sélectionnez 'Ajouter un modèle personnalisé'. Choisissez votre fournisseur, entrez le nom du modèle et spécifiez son type (par ex. Transformer, Diffuser) et sa tâche (par ex. Génération de texte, Texte en image).
- Personnalisez la Configuration : Adaptez le déploiement à vos besoins. Vous pouvez modifier le code d'inférence (par ex. `app.py`), définir des schémas d'entrée personnalisés et configurer l'environnement d'exécution avec des dépendances logicielles et des bibliothèques spécifiques.
- Configurez le Matériel et la Mise à l'échelle : Sélectionnez le type de GPU approprié (par ex. Nvidia T4, A10, A100). Définissez le nombre minimum et maximum de répliques pour définir le comportement de la mise à l'échelle automatique. Configurez des paramètres tels que le délai d'inférence, la concurrence des conteneurs et les périodes de réduction d'échelle.
- Déployez et Surveillez : Cliquez sur 'Déployer' pour construire votre modèle et lancer le point de terminaison. Une fois en ligne, vous pouvez utiliser les journaux détaillés d'appels et de construction pour surveiller les performances, déboguer les problèmes et affiner vos modèles efficacement.
Fonctionnalités principales de Inferless
- Infrastructure GPU sans Serveur : Aucune configuration ou gestion d'infrastructure. La plateforme gère automatiquement l'approvisionnement, la mise à l'échelle et la maintenance.
- Démarrages à Froid Ultra-rapides : L'architecture optimisée garantit des temps de réponse inférieurs à la seconde, même pour les grands modèles, éliminant les délais de préchauffage.
- Mise à l'échelle Automatique Dynamique : Met à l'échelle les ressources automatiquement de zéro à des centaines de GPU en fonction du trafic en temps réel, garantissant des performances et des coûts optimaux.
- Batching Dynamique : Augmente le débit et l'utilisation du GPU en combinant automatiquement plusieurs requêtes côté serveur en un seul lot.
- Runtimes Personnalisés : Flexibilité totale pour personnaliser l'environnement du conteneur avec tous les logiciels et dépendances nécessaires.
- CI/CD Automatisé : Activez la reconstruction automatique des modèles pour un redéploiement automatique lors des modifications dans le dépôt source, rationalisant le cycle de vie du développement.
- Volumes Persistants : Fournit des volumes inscriptibles de type NFS qui prennent en charge les connexions simultanées, permettant des applications avec état et un partage de données efficace.
- Sécurité de Niveau Entreprise : Certifié SOC-2 Type II, avec des tests d'intrusion et des analyses de vulnérabilité réguliers pour garantir la sécurité des données.
Cas d'utilisation pour Inferless
Inferless est idéal pour une large gamme d'applications d'IA :
- Applications d'IA Générative : Déploiement de grands modèles de langage (LLM) pour les chatbots, la création de contenu et la génération de code avec une faible latence.
- API en Temps Réel : Alimentation de services nécessitant un grand nombre de requêtes par seconde (QPS) et des réponses immédiates, tels que la détection de fraude ou les moteurs de recommandation.
- Vision par Ordinateur : Service de modèles pour la reconnaissance d'images, la détection d'objets et la génération d'images à grande échelle.
- Traitement Audio et Vocal : Hébergement de modèles de synthèse vocale (TTS), de reconnaissance vocale et d'autres modèles d'IA basés sur l'audio.
- Prototypage et Production Rentables : Les startups et les entreprises peuvent réduire considérablement leurs factures de cloud GPU (jusqu'à 90 %) tout en évoluant efficacement.
Avantages de Inferless
Les principaux avantages de l'utilisation d'Inferless incluent des économies de coûts significatives grâce à son modèle de paiement à l'utilisation, une productivité accrue des développeurs en éliminant les frais généraux de DevOps, et des performances supérieures avec une latence minimale. Sa capacité à gérer de manière fiable les charges de travail fluctuantes en fait une solution robuste pour les environnements de production. La flexibilité de la plateforme avec des runtimes personnalisés et des intégrations directes avec des outils comme Hugging Face en fait un choix polyvalent et puissant pour toute équipe de ML.
Tarification et plans
Inferless propose un modèle de tarification transparent de paiement à l'utilisation avec un crédit gratuit de 30 $ pour commencer.
- Tarification GPU (Paiement à la seconde) :
- Nvidia T4 : 0,66 $/heure
- Nvidia A10 : 1,22 $/heure
- Nvidia A100 (80 Go) : 5,36 $/heure
- Tarification des Volumes : Les 50 premiers Go de stockage sont gratuits chaque mois. Le stockage supplémentaire coûte 0,3 $/Go/mois.
- Plan Startup : Conçu pour un minimum de 10 000 requêtes d'inférence par mois, comprend une concurrence de 5 GPU, une rétention des journaux de 15 jours et un support via un canal Slack privé.
- Plan Enterprise : Pour un minimum de 100 000 requêtes d'inférence par mois, avec une concurrence de 50 GPU, une rétention des journaux de 365 jours et un ingénieur de support dédié.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 31.3K
- 2026-1: 23.7K
- 2026-2: 15.1K
- 2026-3: 20.2K
- 2026-4: 13.3K
- 2026-5: 8.4K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis32.3%
- 🇻🇳Viêt Nam24.5%
- 🇮🇳Inde22.9%
- 🇧🇷Brésil11.0%
- 🇮🇹Italie9.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| deepseek | $0.45 |
| goel a, borgohain r (2024) exploring llms speed benchmarks: independent analysis | $0.00 |
| kokoro-82m alternative | $0.00 |
| qwen | $0.28 |
| qwen 2.5 3b architecture | $0.00 |
Inferless Alternatives
Supervised.co
Supervised.co est une plateforme de bout en bout pour la création, l'entraînement et le déploiement de modèles d'apprentissage automatique supervisé. Elle simplifie le cycle de vie MLOps avec l'annotation de données intégrée, l'entraînement de modèles automatisé et le déploiement d'API en un clic, permettant aux équipes de créer efficacement des solutions d'IA haute performance.
Annotation de données
Modal
Modal est une plateforme d'infrastructure sans serveur haute performance pour les développeurs IA et ML. Elle vous permet d'exécuter des fonctions Python dans le cloud avec une seule ligne de code, offrant un accès instantané aux GPU, une mise à l'échelle automatique de zéro à des milliers de conteneurs et une tarification à la seconde. Éliminez la surcharge d'infrastructure et concentrez-vous sur la création et le déploiement d'applications gourmandes en calcul comme l'IA générative, le traitement par lots et l'analyse de données.
Déploiement de modèle
Runpod
Runpod est une plateforme cloud conçue pour l'IA et l'apprentissage automatique, offrant une puissance de calcul GPU évolutive pour le déploiement, l'entraînement et l'exécution de modèles d'IA. Elle fournit des GPU sans serveur, des modèles préconfigurés et une tarification rentable pour simplifier l'ensemble du flux de travail de développement de l'IA, de l'idée à la production.
Apprentissage automatique
ClearML GenAI App Engine
Une plateforme de niveau entreprise pour déployer, gérer et mettre à l'échelle rapidement des applications d'IA Générative. Elle fournit un plan de contrôle d'infrastructure unifié pour rationaliser le déploiement des LLM, surveiller les performances et optimiser les coûts de calcul, accélérant ainsi l'adoption de la GenAI de manière sécurisée et efficace.
MLOps
Beam
Beam est une plateforme cloud sans serveur conçue pour les développeurs afin d'exécuter, de mettre à l'échelle et de déployer facilement des modèles et des applications d'IA/ML sur des GPU. Elle offre une mise à l'échelle automatique instantanée, une facturation à la seconde et un flux de travail simplifié, vous permettant de passer du code à une API évolutive en quelques minutes sans gérer une infrastructure complexe.
Apprentissage automatiqueInferless Categories
Inferless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Modal
Modal est une plateforme d'infrastructure sans serveur haute performance pour les développeurs IA et ML. Elle vous permet d'exécuter des fonctions Python dans le cloud avec une seule ligne de code, offrant un accès instantané aux GPU, une mise à l'échelle automatique de zéro à des milliers de conteneurs et une tarification à la seconde. Éliminez la surcharge d'infrastructure et concentrez-vous sur la création et le déploiement d'applications gourmandes en calcul comme l'IA générative, le traitement par lots et l'analyse de données.
Déploiement de modèleRunpod
Runpod est une plateforme cloud conçue pour l'IA et l'apprentissage automatique, offrant une puissance de calcul GPU évolutive pour le déploiement, l'entraînement et l'exécution de modèles d'IA. Elle fournit des GPU sans serveur, des modèles préconfigurés et une tarification rentable pour simplifier l'ensemble du flux de travail de développement de l'IA, de l'idée à la production.
Apprentissage automatiqueBeam
Beam est une plateforme cloud sans serveur conçue pour les développeurs afin d'exécuter, de mettre à l'échelle et de déployer facilement des modèles et des applications d'IA/ML sur des GPU. Elle offre une mise à l'échelle automatique instantanée, une facturation à la seconde et un flux de travail simplifié, vous permettant de passer du code à une API évolutive en quelques minutes sans gérer une infrastructure complexe.
Apprentissage automatique
Cerebrium
Cerebrium est une plateforme d'infrastructure IA sans serveur conçue pour que les développeurs déploient, gèrent et mettent à l'échelle des modèles d'apprentissage automatique avec facilité. Elle abstrait l'infrastructure complexe, offrant des fonctionnalités telles que l'auto-scaling, des démarrages à froid rapides et un accès GPU payant à l'usage, permettant aux équipes de créer des applications IA haute performance sans gérer de serveurs.
Serverless
Vast.ai
Vast.ai est une plateforme cloud GPU de premier plan offrant un accès à la demande à un vaste réseau de GPU pour les charges de travail d'IA et de machine learning. Elle fournit aux développeurs et aux entreprises une puissance de calcul haute performance à des coûts nettement inférieurs — jusqu'à 80 % de moins que les fournisseurs de cloud traditionnels — via un marché transparent de paiement à l'utilisation.
Location de GPU
Nebius
Nebius est une plateforme cloud haute performance spécialement conçue pour l'IA et l'apprentissage automatique. Elle fournit un accès aux derniers GPU NVIDIA, à des clusters évolutifs avec réseau InfiniBand et à des services entièrement gérés comme Kubernetes et Slurm, permettant un entraînement, un affinage et une inférence de modèles d'IA fluides à n'importe quelle échelle.
Apprentissage automatique
Lightning AI
Lightning AI est une plateforme cloud conçue pour construire, entraîner et déployer des modèles d'IA à grande échelle. Elle combine le populaire framework open-source PyTorch Lightning avec Lightning AI Studio, un environnement collaboratif basé sur un navigateur sans aucune configuration. Accédez à de puissants GPU, passez d'un ordinateur portable au cloud en toute transparence et accélérez l'ensemble de votre flux de travail de développement d'IA.
Plateforme en tant que service (PaaS)
Fluidstack
Fluidstack est une plateforme cloud IA de premier plan fournissant des clusters GPU dédiés et haute performance pour l'entraînement et le déploiement de modèles d'IA de pointe. Elle offre un déploiement rapide de milliers de GPU, des services entièrement gérés avec un support expert 24/7, et une tarification transparente sans frais de sortie de données, permettant aux équipes IA de se développer sans friction d'infrastructure.
Solutions d'entreprise
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
Gmi Cloud
Gmi Cloud est une plateforme cloud GPU haute performance conçue pour l'entraînement et l'inférence d'IA évolutifs. Elle fournit un accès à la demande aux meilleurs GPU NVIDIA, un moteur d'inférence optimisé pour une faible latence et un moteur de cluster pour des MLOps rationalisés, permettant aux développeurs et aux entreprises de construire, déployer et faire évoluer des applications d'IA de manière efficace et rentable.
MLOps
GreenNode
GreenNode est un fournisseur d'infrastructure cloud IA tout-en-un, offrant des solutions GPU NVIDIA haute performance pour les startups et les entreprises. Il fournit un accès instantané à des ressources de pointe comme les GPU H100, une infrastructure évolutive et le soutien d'experts de l'AI Lab. Axé sur la rentabilité et la performance, GreenNode aide à accélérer l'entraînement, l'ajustement fin et l'inférence des modèles, avec une forte présence en Asie du Sud-Est.
Entraînement de modèle
Nebius
Nebius est une plateforme cloud haute performance spécialement conçue pour les charges de travail exigeantes en IA et en Machine Learning. Elle offre un accès évolutif aux derniers GPU NVIDIA, des instances uniques aux clusters massifs, complété par une suite de services gérés et un AI Studio intégré pour rationaliser l'ensemble du cycle de vie du ML, de la formation à l'inférence.
Cloud GPU
GPUX
GPUX est une plateforme cloud GPU décentralisée et sans serveur pour une inférence de modèles d'IA rapide et abordable. Elle permet aux développeurs d'exécuter des modèles via une API et aux propriétaires de GPU de gagner de l'argent en contribuant leur matériel à un réseau P2P.
Déploiement de modèle
Modelbit
Modelbit est une plateforme MLOps pour déployer des modèles de machine learning directement depuis des notebooks Python en production. Elle fournit un flux de travail d'infrastructure-as-code, permettant aux data scientists de déployer, héberger, mettre à l'échelle et gérer des modèles avec une seule ligne de code et un git push.
MLOps
PostgresML
PostgresML est une puissante extension open-source qui intègre l'apprentissage automatique et l'IA directement dans votre base de données PostgreSQL. Elle permet l'inférence accélérée par GPU, la recherche vectorielle et des pipelines RAG complets à l'aide de simples commandes SQL, éliminant le mouvement des données et simplifiant la pile MLOps pour des applications IA performantes et évolutives.
MLOps
Inferless Comments (0)
Sign in to comment.
ConnexionNo comments yet.