

Datacurve Overview
Datacurve est un fournisseur de données spécialisé qui collabore avec les plus grands laboratoires de modèles de fondation et entreprises du monde pour créer des données de codage complexes et de haute qualité. Sa mission est de débloquer des améliorations significatives des modèles et de permettre de nouvelles capacités d'IA en fournissant les données de pointe nécessaires au post-entraînement et à l'évaluation. Soutenue par Y Combinator et d'éminents investisseurs providentiels, Datacurve s'est imposée comme un partenaire essentiel pour les projets d'IA critiques, bénéficiant de la confiance d'entreprises comme Cohere.
L'entreprise répond au besoin croissant d'ensembles de données sophistiqués qui vont au-delà de simples extraits de code. Elle se concentre sur des données qui capturent les nuances du développement logiciel, y compris le raisonnement, le débogage et le comportement agentique. Ceci est réalisé grâce à une plateforme unique, ludifiée et basée sur des primes, appelée 'Shipd', qui attire et fidélise une communauté de plus de 14 000 ingénieurs d'élite qui s'affrontent dans des 'Quêtes' pour générer des données diverses et complexes.
Comment utiliser Datacurve
Datacurve fonctionne comme un fournisseur de services à forte interaction, et non comme une plateforme en libre-service. Le processus d'engagement est adapté aux besoins spécifiques de chaque client :
- Consultation initiale : Les clients potentiels planifient un appel pour discuter de leurs objectifs de projet, de leurs besoins en données, de la complexité souhaitée et de l'échelle.
- Cadrage du projet et pilote : L'équipe technique de Datacurve collabore avec le client pour définir les formats de données précis, les métriques de qualité et les critères d'évaluation. Un programme pilote est souvent lancé pour itérer rapidement et s'assurer que les données correspondent parfaitement aux besoins de recherche et développement du client.
- Campagne de création de données : Une fois le périmètre défini, Datacurve lance une 'Quête' sur sa plateforme Shipd. Des ingénieurs validés de leur pool mondial sont sélectionnés pour participer à ces compétitions basées sur des primes afin de créer les données spécifiées.
- Assurance qualité multicouche : Toutes les données générées subissent un processus d'assurance qualité rigoureux et multicouche. Cela inclut des vérifications de cohérence automatisées, la détection d'anomalies statistiques et des boucles d'évaluation humaine méticuleuses pour corriger les erreurs et gérer les cas limites.
- Production à grande échelle et livraison : Après un pilote réussi, Datacurve augmente la production pour répondre aux demandes de gros volumes, garantissant une livraison ponctuelle qui s'aligne sur les calendriers de lancement de modèles et de recherche du client.
Fonctionnalités principales de Datacurve
- Données d'Affinage Supervisé (SFT) : Ensembles de données de haute qualité pour une variété de tâches de codage afin d'affiner les modèles.
- Environnements d'Apprentissage par Renforcement (RLE) : Environnements RL conçus sur mesure pour une évaluation et une vérification complètes du code à l'échelle du référentiel.
- Apprentissage par Renforcement avec Rétroaction Humaine (RLHF) : Boucles RLHF personnalisées avec le point de terminaison du modèle du client directement intégré dans le processus de rétroaction.
- Traces de Flux de Travail Agentique : Télémétrie complète du processus d'un développeur de logiciels, y compris l'exécution de code, les boucles d'édition, la navigation dans les fichiers et les pensées verbales/écrites, conçue pour l'entraînement d'agents logiciels avancés.
- Tâches de Raisonnement et de Débogage : Ensembles de données construits à partir de bogues de production réels et de scénarios de raisonnement complexes fournis par des ingénieurs professionnels.
- Banc d'essai pour Dépôt Privé : La capacité de concevoir des tâches d'entraînement et d'évaluation personnalisées sur des bases de code privées et propriétaires (par exemple, applications d'entreprise, jeux, logiciels système).
- Données d'Interface Multimodale : Tâches qui apprennent aux modèles à connecter le code statique au comportement dynamique, en utilisant des invites, des captures d'écran ou des enregistrements pour entraîner une compréhension de l'apparence, de la sensation et du fonctionnement des logiciels interactifs.
Cas d'utilisation pour Datacurve
Les données de Datacurve sont essentielles pour une gamme d'applications d'IA avancées :
- Entraînement de Modèles de Fondation de Nouvelle Génération : Fournir les données algorithmiques et de raisonnement de base pour améliorer les capacités de codage fondamentales d'un modèle.
- Développement d'Agents Logiciels IA Autonomes : Utiliser des traces agentiques détaillées pour entraîner des modèles capables d'effectuer de manière indépendante des tâches complexes de développement logiciel comme le codage, le débogage et les tests.
- Benchmarking et Évaluation de Modèles : Créer des benchmarks personnalisés et stimulants sur du code privé ou public pour évaluer et comparer avec précision les performances de différents modèles.
- Affinage pour des Domaines Spécialisés : Créer des ensembles de données pour adapter les modèles à des industries ou des tâches spécifiques, telles que le développement de jeux, les logiciels de modélisation financière ou les systèmes embarqués.
- Amélioration de la Génération et du Débogage de Code : Utiliser des ensembles de données de bogues réels et de solutions d'ingénierie pour améliorer la capacité d'un modèle à générer du code correct et à identifier et corriger efficacement les erreurs.
Avantages de Datacurve
- Qualité et Complexité des Données Inégalées : Un processus d'assurance qualité multicouche et une spécialisation dans les formats complexes garantissent la plus haute précision.
- Plateforme de Contributeurs Ludifiée : Le système de primes et de quêtes de la plateforme 'Shipd' incite les meilleurs ingénieurs à produire des données créatives, diverses et de haute qualité.
- Expertise en Données de Pointe : Compréhension approfondie des besoins en données pour la recherche en IA de pointe, y compris l'IA agentique et le raisonnement avancé.
- Évolutivité et Vitesse : Infrastructure conçue pour la production de gros volumes et une équipe technique qui permet des cycles d'itération rapides avec les équipes de recherche des clients.
- Partenaire de Confiance pour les Leaders de l'IA : Une expérience avérée de collaboration avec les équipes d'IA les plus exigeantes du monde sur leurs projets les plus critiques.
Tarification et plans
Datacurve propose des plans d'entreprise personnalisés. La tarification est déterminée au cas par cas, en fonction de facteurs tels que la complexité des données, le volume requis, le calendrier du projet et les services spécifiques impliqués. Pour recevoir un devis et discuter de votre projet, vous devez planifier une réunion avec leur équipe via le site web officiel.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 13.3K
- 2026-1: 16.6K
- 2026-2: 10.6K
- 2026-3: 13.2K
- 2026-4: 10.1K
- 2026-5: 93.9K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis70.2%
- 🇮🇳Inde15.2%
- 🇰🇷Corée du Sud7.0%
- 🇨🇦Canada6.5%
- 🇯🇵Japon1.2%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 82.7% |
Referral | 14.8% |
Email | 2.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| data curve | $4.37 |
| datacurve | $4.94 |
| deep swe | $0.00 |
| deepswe | $0.00 |
| deepswe benchmark | $0.00 |
Datacurve Videos on YouTube
Singularity Feed | AI Models , Agents & Robotics

Matthew Berman

John Oluleke-Oke

Eliott Meunier

Datacurve Alternatives
Surge AI
Surge AI est une plateforme d'étiquetage de données de premier plan qui fournit une intelligence humaine d'élite pour alimenter le développement de l'IA avancée et de l'AGI. Spécialisée dans les données de haute qualité pour le RLHF, l'évaluation de modèles et la création d'ensembles de données personnalisés, Surge AI s'associe à des laboratoires d'IA de pointe comme OpenAI et Anthropic pour entraîner, aligner et tester les modèles de nouvelle génération. Ils se concentrent sur la nuance et la complexité requises pour construire des systèmes véritablement intelligents.
MLOps
DefinedCrowd
DefinedCrowd est un fournisseur de premier plan de données d'entraînement pour l'IA de haute qualité. Il s'appuie sur une foule mondiale pour collecter, annoter et enrichir des données pour les modèles d'apprentissage automatique, en se spécialisant dans la parole, le NLP et la vision par ordinateur. Il offre un service entièrement géré pour aider les entreprises à construire des applications d'IA robustes et non biaisées à grande échelle.
Apprentissage automatique
Revelo
Revelo est une plateforme de talents de premier plan qui met en relation les entreprises avec les 2 % meilleurs développeurs de logiciels présélectionnés d'Amérique latine. Elle offre une solution de service complet, gérant la paie, les avantages sociaux et la conformité, permettant aux entreprises de faire évoluer leurs équipes d'ingénierie rapidement et à moindre coût. Avec un alignement sur les fuseaux horaires et des économies significatives par rapport aux embauches aux États-Unis, Revelo fournit également des services spécialisés de données humaines pour l'entraînement des modèles d'IA et de LLM.
Étiquetage de Données
Innovatiana
Innovatiana est un service spécialisé fournissant des données d'entraînement de haute qualité, issues de sources éthiques, pour les modèles d'IA. Ils proposent la création de jeux de données sur mesure et l'annotation de données pour la vision par ordinateur, le NLP, l'IA générative et le traitement de documents. En employant des équipes dédiées et formées plutôt que le crowdsourcing, Innovatiana garantit une précision des données, une sécurité et un développement d'IA responsable supérieurs, aidant les entreprises à construire des modèles plus robustes et non biaisés.
Création de jeu de données
Alaya AI
Alaya AI est une plateforme de données IA décentralisée qui connecte une communauté mondiale à des tâches d'entraînement de l'IA. Elle fournit des solutions de données évolutives et de haute qualité pour les développeurs via un modèle ludique de 'train-to-earn', permettant aux utilisateurs du monde entier de contribuer au développement de l'IA et de gagner des récompenses.
Entraînement de modèleDatacurve Categories
Datacurve Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
SuperAnnotate
SuperAnnotate est une plateforme de données IA de premier plan qui rationalise l'ensemble du pipeline de données pour l'apprentissage automatique. Elle permet aux équipes d'annoter, de gérer et de conserver des ensembles de données multimodales de haute qualité (image, vidéo, texte, audio) pour accélérer le développement de modèles, y compris pour des flux de travail complexes comme RLHF, RAG et SFT. Elle est conçue pour améliorer la précision et l'efficacité des modèles.
Étiquetage
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation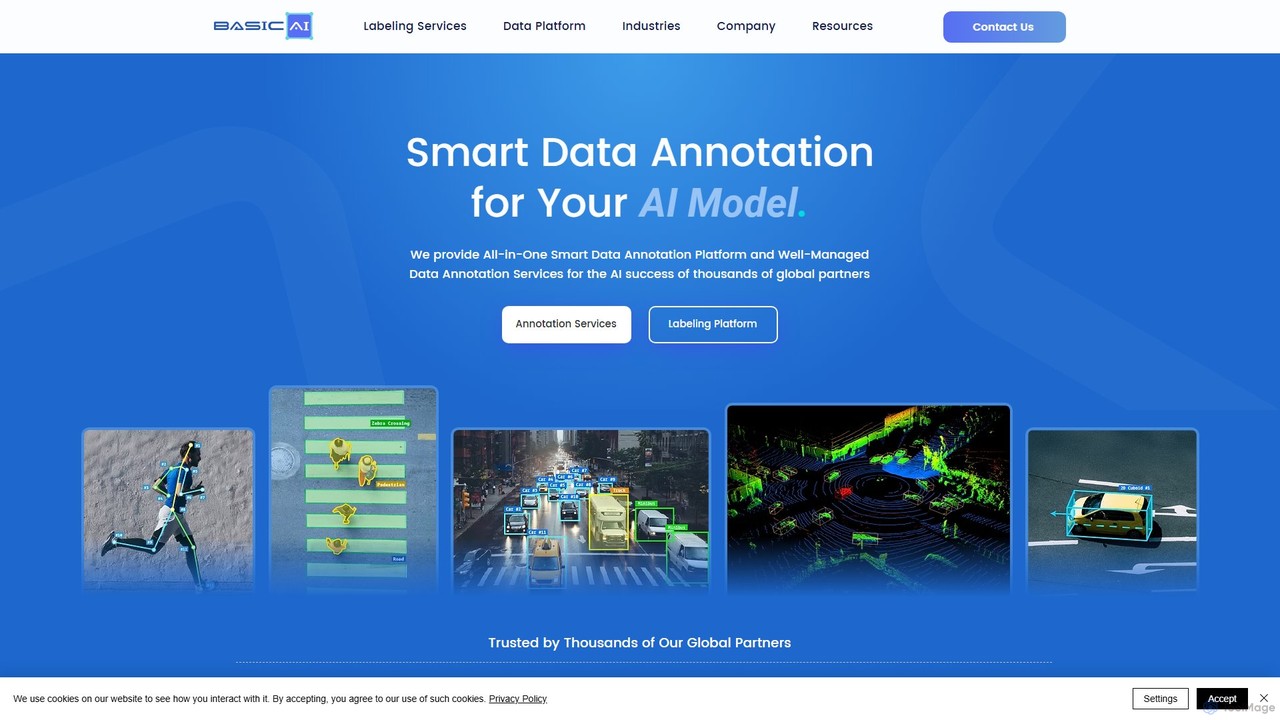
BasicAI
BasicAI propose une plateforme complète d'annotation de données et des services gérés pour créer des données d'entraînement de haute qualité pour les modèles d'IA. Spécialisée dans les données 3D LiDAR, image, vidéo et NLP, elle fournit des outils assistés par l'IA, des flux de travail évolutifs et une sécurité de niveau entreprise pour accélérer le développement de l'IA.
Étiquetage de donnéesSurge AI
Surge AI est une plateforme d'étiquetage de données de premier plan qui fournit une intelligence humaine d'élite pour alimenter le développement de l'IA avancée et de l'AGI. Spécialisée dans les données de haute qualité pour le RLHF, l'évaluation de modèles et la création d'ensembles de données personnalisés, Surge AI s'associe à des laboratoires d'IA de pointe comme OpenAI et Anthropic pour entraîner, aligner et tester les modèles de nouvelle génération. Ils se concentrent sur la nuance et la complexité requises pour construire des systèmes véritablement intelligents.
MLOps
Labelbox
Labelbox est une plateforme d'IA complète et centrée sur les données, ou "Data Factory", conçue pour les équipes d'IA. Elle fournit un logiciel intégré, des services d'experts et une place de marché de talents pour créer, gérer et évaluer des données d'entraînement de haute qualité pour les modèles d'IA avancés, y compris les LLM et les systèmes multimodaux.
Étiquetage
Scale AI
Scale AI est une plateforme full-stack qui accélère le développement de l'IA en fournissant des données de haute qualité, des services d'évaluation de modèles et de fine-tuning. Elle s'adresse aux laboratoires d'IA de premier plan, aux entreprises et aux agences gouvernementales, offrant un Moteur de Données complet pour le RLHF, l'étiquetage et la génération de données afin d'alimenter l'IA générative avancée et les LLM.
Étiquetage
Encord
Encord est une plateforme complète de développement de données pour l'IA visuelle et multimodale. Elle fournit des outils pour gérer, organiser et annoter des données non structurées à grande échelle, telles que des images, des vidéos et des fichiers DICOM. La plateforme aide les équipes d'IA à créer des jeux de données de haute qualité, à améliorer les performances des modèles et à accélérer le déploiement d'applications d'IA prêtes pour la production grâce à un étiquetage avancé, une évaluation de modèle et des flux de travail avec intervention humaine.
AnnotationDefinedCrowd
DefinedCrowd est un fournisseur de premier plan de données d'entraînement pour l'IA de haute qualité. Il s'appuie sur une foule mondiale pour collecter, annoter et enrichir des données pour les modèles d'apprentissage automatique, en se spécialisant dans la parole, le NLP et la vision par ordinateur. Il offre un service entièrement géré pour aider les entreprises à construire des applications d'IA robustes et non biaisées à grande échelle.
Apprentissage automatiqueRevelo
Revelo est une plateforme de talents de premier plan qui met en relation les entreprises avec les 2 % meilleurs développeurs de logiciels présélectionnés d'Amérique latine. Elle offre une solution de service complet, gérant la paie, les avantages sociaux et la conformité, permettant aux entreprises de faire évoluer leurs équipes d'ingénierie rapidement et à moindre coût. Avec un alignement sur les fuseaux horaires et des économies significatives par rapport aux embauches aux États-Unis, Revelo fournit également des services spécialisés de données humaines pour l'entraînement des modèles d'IA et de LLM.
Étiquetage de DonnéesInnovatiana
Innovatiana est un service spécialisé fournissant des données d'entraînement de haute qualité, issues de sources éthiques, pour les modèles d'IA. Ils proposent la création de jeux de données sur mesure et l'annotation de données pour la vision par ordinateur, le NLP, l'IA générative et le traitement de documents. En employant des équipes dédiées et formées plutôt que le crowdsourcing, Innovatiana garantit une précision des données, une sécurité et un développement d'IA responsable supérieurs, aidant les entreprises à construire des modèles plus robustes et non biaisés.
Création de jeu de donnéesAlaya AI
Alaya AI est une plateforme de données IA décentralisée qui connecte une communauté mondiale à des tâches d'entraînement de l'IA. Elle fournit des solutions de données évolutives et de haute qualité pour les développeurs via un modèle ludique de 'train-to-earn', permettant aux utilisateurs du monde entier de contribuer au développement de l'IA et de gagner des récompenses.
Entraînement de modèle
Cursor
Cursor est un éditeur de code axé sur l'IA, conçu pour la programmation en binôme avec l'intelligence artificielle. Construit comme un fork de VS Code, il offre un environnement familier suralimenté par des capacités d'IA avancées pour la génération de code, l'édition, le débogage et la compréhension de la base de code, visant à augmenter considérablement la productivité des développeurs.
Assistant de code
Emergent
Emergent est la première plateforme de "vibe-coding" agentique au monde, conçue pour créer des applications full-stack ambitieuses à l'aide de l'IA. Elle traduit les descriptions en langage naturel et les intentions en code fonctionnel, permettant aux développeurs et aux équipes de prototyper, construire et itérer sur des logiciels plus rapidement que jamais.
Développement
BLACKBOX.AI
BLACKBOX.AI est un agent de codage IA autonome conçu pour accélérer le développement de logiciels. Il aide les développeurs à écrire du code plus rapidement, à déboguer efficacement et peut même créer des applications complètes à partir d'images ou de descriptions textuelles, en s'intégrant de manière transparente avec des IDE populaires comme JetBrains.
Assistant de Code
Kiro
Kiro est un Environnement de Développement Intégré (IDE) alimenté par l'IA, conçu pour rationaliser l'ensemble du cycle de vie du développement logiciel, du prototype à la production. Il introduit une approche structurée de développement piloté par les spécifications, transformant les invites en langage naturel en exigences claires, en conceptions de système et en tâches exécutables. En s'appuyant sur des agents IA, Kiro automatise le codage, les tests et la documentation, aidant les développeurs à créer des applications complexes plus rapidement et avec une meilleure qualité.
Assistant de code
Datacurve Comments (0)
Sign in to comment.
ConnexionNo comments yet.