
Unsloth Overview
Unsloth est une bibliothèque d'IA open-source révolutionnaire conçue pour résoudre deux des plus grands défis de la personnalisation des grands modèles de langage (LLM) : la vitesse d'entraînement et la consommation de mémoire. Développée par une équipe dévouée, Unsloth redéfinit l'efficacité du fine-tuning en employant des optimisations mathématiques dérivées manuellement et des noyaux GPU écrits à la main. Cette approche innovante permet aux développeurs, chercheurs et entreprises d'entraîner des modèles comme Llama, Mistral et Gemma jusqu'à 30 fois plus vite qu'avec des méthodes standard comme Flash Attention 2, et avec une réduction stupéfiante de 90% de l'utilisation de la mémoire. Cela signifie que des tâches qui prenaient autrefois un mois peuvent maintenant être achevées en seulement 24 heures, et que des modèles puissants peuvent être affinés sur un seul GPU grand public.
La magie principale d'Unsloth réside dans son optimisation profonde au niveau du matériel. Au lieu de s'appuyer sur des bibliothèques génériques de haut niveau, les créateurs d'Unsloth sont revenus aux principes de base, réécrivant les étapes les plus lourdes en calcul du processus d'entraînement pour maximiser l'efficacité du GPU. Il en résulte non seulement un entraînement plus rapide, mais aussi des vitesses d'inférence significativement plus rapides (jusqu'à 2x), permettant un déploiement plus rapide des modèles affinés. Unsloth est conçu pour l'évolutivité, offrant des performances exceptionnelles sur un seul GPU, des systèmes multi-GPU et même des clusters multi-nœuds pour les tâches d'entreprise.
Comment utiliser Unsloth
L'utilisation d'Unsloth est conçue pour être simple pour toute personne familière avec l'écosystème Python et Hugging Face. Le processus comprend généralement ces étapes :
- Installation : Installez la bibliothèque Unsloth dans votre environnement Python, généralement avec une simple commande pip. La bibliothèque est disponible en tant que logiciel gratuit open-source.
- Importation et chargement du modèle : Dans votre script d'entraînement, importez le `FastLanguageModel` d'Unsloth. Au lieu de charger un modèle directement depuis les `transformers` de Hugging Face, vous utilisez la fonction d'Unsloth pour charger le modèle de base. Cette fonction applique automatiquement tous les correctifs de performance et optimisations nécessaires. Vous pouvez spécifier le nom du modèle (par ex., 'unsloth/llama-3-8b-Instruct-bnb-4bit') et le type de données (par ex., quantification 4 bits) lors de cette étape.
- Ajout d'adaptateurs LoRA : Unsloth simplifie le processus d'ajout d'adaptateurs d'Adaptation de Bas Rang (LoRA) au modèle. Vous pouvez configurer les paramètres LoRA (comme `r`, `lora_alpha`, `target_modules`) et les appliquer au modèle avec une seule ligne de code.
- Préparation des données : Préparez votre jeu de données d'entraînement comme vous le feriez normalement pour une tâche de fine-tuning avec Hugging Face.
- Entraînement : Utilisez le `SFTTrainer` de Hugging Face ou une classe d'entraînement similaire, en lui passant votre modèle optimisé par Unsloth, votre jeu de données et vos arguments d'entraînement. Unsloth s'intègre de manière transparente à ce flux de travail, accélérant automatiquement les étapes de rétropropagation et d'optimisation.
- Inférence : Une fois l'entraînement terminé, vous pouvez utiliser le modèle affiné pour l'inférence, qui bénéficie également des améliorations de vitesse d'Unsloth.
Fonctionnalités principales de Unsloth
- Augmentation extrême de la vitesse : Entraînement et fine-tuning jusqu'à 30 fois plus rapides par rapport aux implémentations standard comme Flash Attention 2.
- Réduction massive de la mémoire : Réduit l'utilisation de la VRAM jusqu'à 90%, permettant le fine-tuning de grands modèles sur des GPU grand public (comme Tesla T4 ou même la série GeForce RTX).
- Noyaux GPU écrits à la main : Les opérations mathématiques de base sont optimisées manuellement pour une performance matérielle maximale, surpassant les capacités des bibliothèques génériques.
- Large prise en charge des modèles : Prend en charge nativement une large gamme de LLM open-source populaires, y compris Llama 1/2/3, Mistral, Gemma, Qwen, DeepSeek, et plus encore.
- Prise en charge de la quantification : Prise en charge complète du fine-tuning LoRA 4 bits et 16 bits, rendant l'entraînement encore plus économe en mémoire.
- Évolutivité : Optimisé pour les configurations à un seul GPU, multi-GPU (jusqu'à 8) et multi-nœuds (Enterprise).
- Inférence plus rapide : Offre des vitesses d'inférence jusqu'à 2 fois plus rapides après l'entraînement, rendant le déploiement du modèle plus efficace.
- Amélioration de la précision : Le plan Enterprise offre des fonctionnalités qui peuvent augmenter la précision du modèle jusqu'à 30% sur certaines tâches.
Cas d'utilisation pour Unsloth
Unsloth est un outil polyvalent pour quiconque travaille avec des LLM :
- Startups en IA : Créez et itérez sur des modèles personnalisés et spécialisés pour des applications de niche sans encourir de coûts massifs de cloud computing.
- Chercheurs universitaires : Accélérez les cycles de recherche et exécutez plus d'expériences avec des budgets matériels universitaires limités.
- Équipes MLOps d'entreprise : Réduisez considérablement le coût et le temps d'entraînement des modèles internes pour des tâches telles que le support client, l'analyse de documents ou la génération de code.
- Développeurs individuels et amateurs : Expérimentez et apprenez le fine-tuning des LLM sur des ordinateurs personnels, abaissant la barrière à l'entrée pour le développement d'IA de pointe.
- Scientifiques des données : Affinez rapidement des modèles sur des jeux de données spécifiques pour extraire des informations ou construire des outils prédictifs pour l'intelligence d'affaires.
Avantages de Unsloth
Le principal avantage d'Unsloth est son efficacité inégalée. En s'attaquant aux goulots d'étranglement centraux de la vitesse et de la mémoire, il démocratise l'accès à la personnalisation puissante de l'IA. Cela conduit à des économies de coûts significatives sur le matériel GPU et les services cloud. Sa nature open-source favorise la transparence et l'amélioration par la communauté, tandis que l'intégration transparente avec l'écosystème Hugging Face garantit une adoption facile pour quiconque est déjà dans le domaine. En fin de compte, Unsloth permet aux utilisateurs de faire plus avec moins, transformant ce qui était autrefois un processus gourmand en ressources en un processus rapide et accessible.
Tarification et plans
Unsloth fonctionne sur un modèle freemium avec trois niveaux distincts :
- Gratuit : C'est la version gratuite et open-source d'Unsloth. Elle offre une augmentation de vitesse de 2x, une réduction de 60% de la VRAM et prend en charge les configurations à un seul GPU. Elle est parfaite pour les particuliers et les projets à petite échelle, prenant en charge le fine-tuning LoRA 4 et 16 bits pour des modèles comme Mistral, Gemma et Llama.
- Unsloth Pro : Destiné aux professionnels et aux équipes, ce plan offre une augmentation de vitesse de 2,5x par GPU, une réduction de 80% de la VRAM et une prise en charge multi-GPU améliorée (jusqu'à 8 GPU). Ce plan convient à tout cas d'utilisation nécessitant plus de puissance et d'efficacité. La tarification est disponible en contactant l'équipe d'Unsloth.
- Unsloth Enterprise : Le niveau de performance ultime pour les opérations à grande échelle. Il débloque un entraînement jusqu'à 32 fois plus rapide, une réduction de 90% de la VRAM, une prise en charge multi-nœuds et une augmentation de la précision jusqu'à 30%. Il inclut également la prise en charge de l'entraînement complet du modèle (pas seulement LoRA), une inférence 5 fois plus rapide et un support client dédié. La tarification est disponible en contactant l'équipe d'Unsloth.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 426.2K
- 2026-1: 574.8K
- 2026-2: 698.3K
- 2026-3: 1.3M
- 2026-4: 1.6M
- 2026-5: 1.1M
Geography
Top 5 countries / regions
- 🇨🇳Chine43.4%
- 🇺🇸États-Unis30.2%
- 🇮🇳Inde11.4%
- 🇰🇷Corée du Sud7.9%
- 🇩🇪Allemagne7.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 64.9% |
Referral | 34.0% |
Email | 1.1% |
Top keywords
| Keyword | Cost per click |
|---|---|
| kimi k2.6 | $0.00 |
| qwen3.5 | $0.00 |
| unsloth | $2.86 |
| unsloth ai | $3.35 |
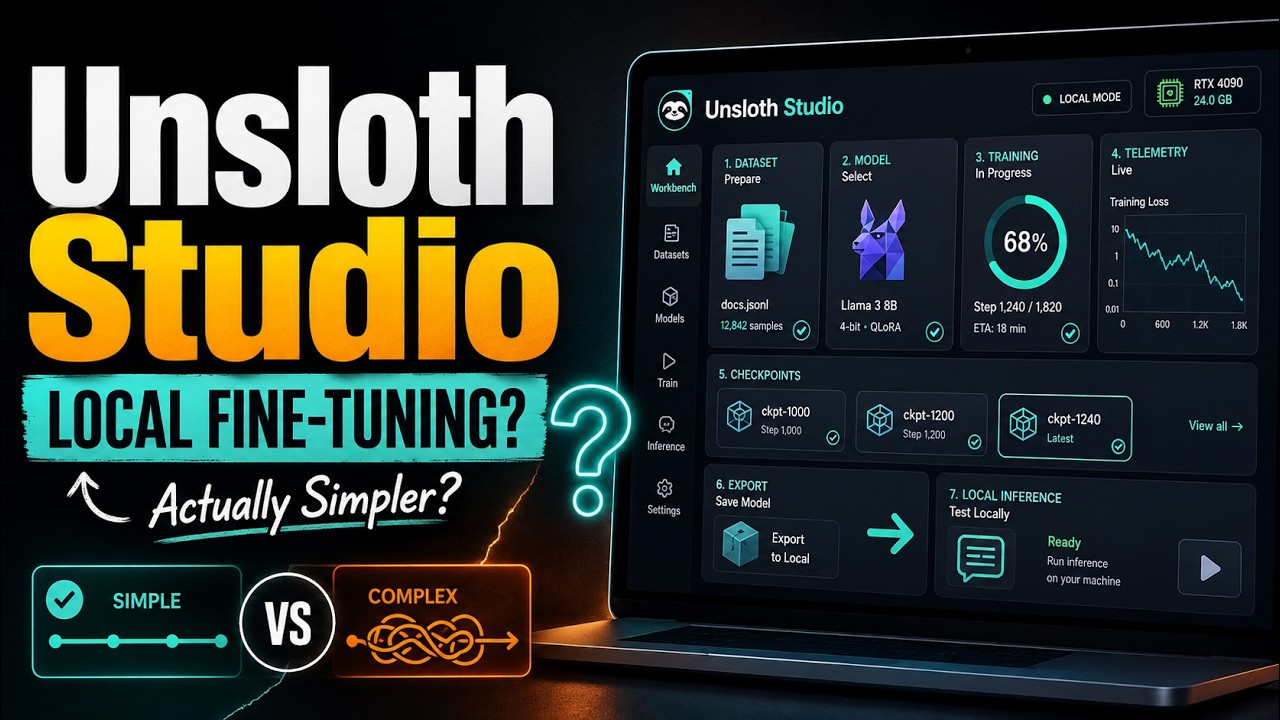
| unsloth studio | $2.57 |
Unsloth Videos on YouTube

Byte Goose AI.



Docker

Unsloth Alternatives
xTuring
xTuring est une bibliothèque Python open-source conçue pour simplifier le processus de construction, de réglage fin et de contrôle des Grands Modèles de Langage (LLM). Elle offre une interface conviviale aux développeurs et chercheurs pour personnaliser les modèles d'IA pour des données et applications spécifiques avec une grande efficacité et personnalisation.
Entraînement de modèle
thundercompute
Thunder Compute propose une plateforme cloud GPU à très bas coût conçue pour les développeurs en IA et en machine learning. Elle fournit des instances GPU à la demande comme les NVIDIA A100 et T4 à des prix jusqu'à 80 % inférieurs à ceux des principaux fournisseurs de cloud. Avec des fonctionnalités telles que la configuration en un clic, l'intégration à VS Code et une scalabilité transparente, elle simplifie considérablement le flux de travail de développement, du prototypage à la production, permettant aux développeurs de se concentrer sur la création de modèles plutôt que sur la gestion de l'infrastructure.
Apprentissage automatique
Predibase
Predibase est une plateforme de développement de bout en bout pour l'ajustement fin et le service efficaces de grands modèles de langage (LLM) open source. Elle permet aux utilisateurs de créer des modèles d'IA personnalisés qui surpassent les grands modèles propriétaires comme GPT-4 sur des tâches spécifiques, tout en réduisant considérablement les coûts et la latence d'inférence. La plateforme propose des techniques avancées comme l'ajustement fin par renforcement (RFT) et LoRAX pour un service multi-modèles à haute vitesse.
Apprentissage automatique
Fluidstack
Fluidstack est une plateforme cloud IA de premier plan fournissant des clusters GPU dédiés et haute performance pour l'entraînement et le déploiement de modèles d'IA de pointe. Elle offre un déploiement rapide de milliers de GPU, des services entièrement gérés avec un support expert 24/7, et une tarification transparente sans frais de sortie de données, permettant aux équipes IA de se développer sans friction d'infrastructure.
Solutions d'entreprise
Nebius
Nebius est une plateforme cloud haute performance spécialement conçue pour les charges de travail exigeantes en IA et en Machine Learning. Elle offre un accès évolutif aux derniers GPU NVIDIA, des instances uniques aux clusters massifs, complété par une suite de services gérés et un AI Studio intégré pour rationaliser l'ensemble du cycle de vie du ML, de la formation à l'inférence.
Cloud GPUUnsloth Categories
Unsloth Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
xTuring
xTuring est une bibliothèque Python open-source conçue pour simplifier le processus de construction, de réglage fin et de contrôle des Grands Modèles de Langage (LLM). Elle offre une interface conviviale aux développeurs et chercheurs pour personnaliser les modèles d'IA pour des données et applications spécifiques avec une grande efficacité et personnalisation.
Entraînement de modèle
Ludwig
Ludwig est un framework de deep learning open-source et low-code qui simplifie la création et l'entraînement de modèles d'IA personnalisés. En utilisant des configurations déclaratives YAML, les utilisateurs peuvent facilement créer des modèles complexes, y compris des LLM, pour l'apprentissage multimodal et multi-tâches sans code répétitif. Il est conçu pour la scalabilité, la mise en production et s'intègre avec des outils populaires comme HuggingFace et MLFlow.
Entraînement de modèle
FinetuneDB
FinetuneDB est une plateforme tout-en-un de fine-tuning d'IA pour les développeurs. Elle simplifie l'ensemble du flux de travail de création de grands modèles de langage (LLM) personnalisés, de la construction de jeux de données de haute qualité et du fine-tuning de modèles comme Llama 3 et GPT-4o mini, jusqu'au déploiement et à l'évaluation continue sur une seule plateforme sécurisée.
Llmopsthundercompute
Thunder Compute propose une plateforme cloud GPU à très bas coût conçue pour les développeurs en IA et en machine learning. Elle fournit des instances GPU à la demande comme les NVIDIA A100 et T4 à des prix jusqu'à 80 % inférieurs à ceux des principaux fournisseurs de cloud. Avec des fonctionnalités telles que la configuration en un clic, l'intégration à VS Code et une scalabilité transparente, elle simplifie considérablement le flux de travail de développement, du prototypage à la production, permettant aux développeurs de se concentrer sur la création de modèles plutôt que sur la gestion de l'infrastructure.
Apprentissage automatiquePredibase
Predibase est une plateforme de développement de bout en bout pour l'ajustement fin et le service efficaces de grands modèles de langage (LLM) open source. Elle permet aux utilisateurs de créer des modèles d'IA personnalisés qui surpassent les grands modèles propriétaires comme GPT-4 sur des tâches spécifiques, tout en réduisant considérablement les coûts et la latence d'inférence. La plateforme propose des techniques avancées comme l'ajustement fin par renforcement (RFT) et LoRAX pour un service multi-modèles à haute vitesse.
Apprentissage automatique
Ollama
Ollama est un puissant framework open-source pour exécuter localement de grands modèles de langage (LLM) comme Llama 3, Mistral et Gemma sur votre propre matériel. Disponible pour macOS, Windows et Linux, il simplifie la configuration et la gestion des modèles open-source, permettant un développement et une utilisation de l'IA privés, hors ligne et rentables.
Apprentissage automatique
Jyek
Jyek est une plateforme d'agent IA qui comprend les objectifs, crée des plans d'exécution, utilise des outils et fournit des résultats vérifiables pour les tâches complexes à étapes multiples.
Automatisation
GPT4All
GPT4All est un chatbot IA gratuit, open-source et axé sur la confidentialité qui exécute de puissants modèles de langage localement sur votre bureau. Il fonctionne hors ligne, garantissant que vos données ne quittent jamais votre appareil, et vous permet de discuter avec vos propres documents en toute sécurité.
Apprentissage automatique
GreenNode
GreenNode est un fournisseur d'infrastructure cloud IA tout-en-un, offrant des solutions GPU NVIDIA haute performance pour les startups et les entreprises. Il fournit un accès instantané à des ressources de pointe comme les GPU H100, une infrastructure évolutive et le soutien d'experts de l'AI Lab. Axé sur la rentabilité et la performance, GreenNode aide à accélérer l'entraînement, l'ajustement fin et l'inférence des modèles, avec une forte présence en Asie du Sud-Est.
Entraînement de modèle
EntryPoint AI
EntryPoint AI est une plateforme sans code conçue pour simplifier l'ajustement fin (fine-tuning) des grands modèles de langage (LLM). Elle permet aux utilisateurs de gérer des ensembles de données, d'entraîner, d'évaluer et de déployer des modèles d'IA personnalisés de fournisseurs comme OpenAI sans écrire de code. La plateforme aide à améliorer la qualité, la vitesse et la prévisibilité des modèles pour des tâches métier spécifiques, rendant la personnalisation avancée de l'IA accessible aux équipes de toute taille.
Gestion des Données
Metrics Help
Metrics Help est un outil web open source pour les praticiens du machine learning. Il sert à la fois de guide complet et d'analyseur interactif pour les métriques d'entraînement ML. Les utilisateurs peuvent coller des journaux d'entraînement pour obtenir des explications instantanées sur des métriques clés comme la précision, la perte et la perplexité, facilitant l'analyse des performances et le débogage des modèles.
Entraînement de modèle
hyperficient
hyperficient est un outil d'IA open source pour les développeurs et les ingénieurs ML qui automatise la recherche des stratégies d'ajustement fin (fine-tuning) les plus efficaces pour les réseaux de neurones. Il réduit considérablement les coûts de calcul, le temps GPU et l'effort manuel, permettant des performances de modèle optimales avec des ressources limitées.
Bibliothèques
TensorFlow
TensorFlow est une plateforme open-source de bout en bout pour l'apprentissage automatique développée par Google. Elle fournit un écosystème complet et flexible d'outils, de bibliothèques et de ressources communautaires qui permet aux chercheurs et aux développeurs de créer et de déployer des applications basées sur le ML. Des débutants aux experts, TensorFlow offre des API intuitives de haut niveau pour une construction de modèles facile et des API puissantes de bas niveau pour la recherche avancée, permettant un déploiement sur des serveurs, des appareils de périphérie et des navigateurs.
Frameworks
Label Studio
Label Studio est une plateforme polyvalente d'étiquetage de données open source conçue pour une large gamme de types de données. Elle permet aux utilisateurs d'annoter des images, du texte, de l'audio, de la vidéo et des données de séries chronologiques pour affiner les LLM, préparer des données d'entraînement pour l'apprentissage automatique et valider les modèles d'IA avec une rétroaction humaine dans la boucle.
Données d'entraînement
Forefront
Forefront est une plateforme de développement pour construire avec l'IA open-source. Elle simplifie l'exécution, l'affinage et le déploiement de grands modèles de langage (LLM) sur vos données privées, offrant une alternative évolutive, sécurisée et rentable aux plateformes à code source fermé. Possédez vos données, vos modèles et votre IA.
Grands Modèles Linguistiques
Unsloth Comments (0)
Sign in to comment.
ConnexionNo comments yet.