
Free
Quick, Draw!
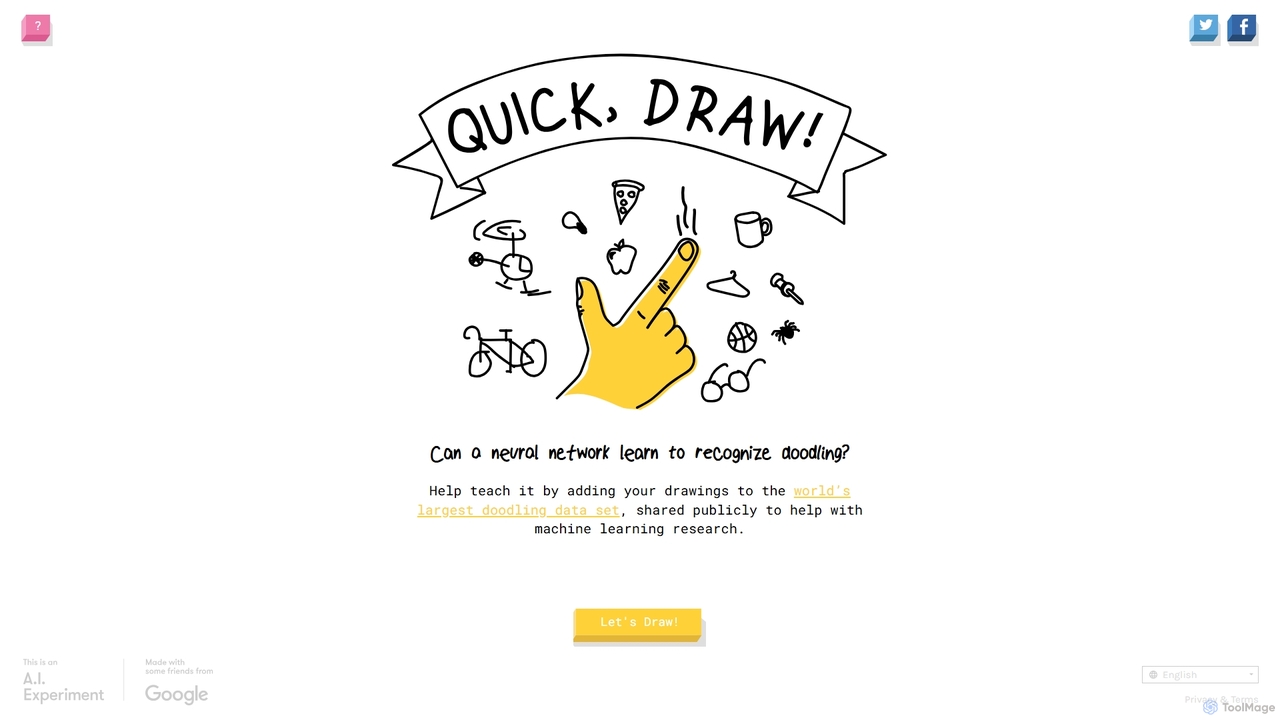
Quick, Draw!は、Googleが開発したインタラクティブなAI実験ゲームです。オブジェクトを描くと、ニューラルネットワークがそれが何かを推測しようとします。これは、機械学習と楽しく対話しながら、研究用の世界最大の落書きデータセットに貢献できる素晴らしい方法です。
データセットVisits 2.2MFavorites 167Likes 164
Popular データセット AI tools in データ include Hugging Face、Quick, Draw!、gts.ai、David AI, helping you work more efficiently.
Quick, Draw!は、Googleが開発したインタラクティブなAI実験ゲームです。オブジェクトを描くと、ニューラルネットワークがそれが何かを推測しようとします。これは、機械学習と楽しく対話しながら、研究用の世界最大の落書きデータセットに貢献できる素晴らしい方法です。
データセット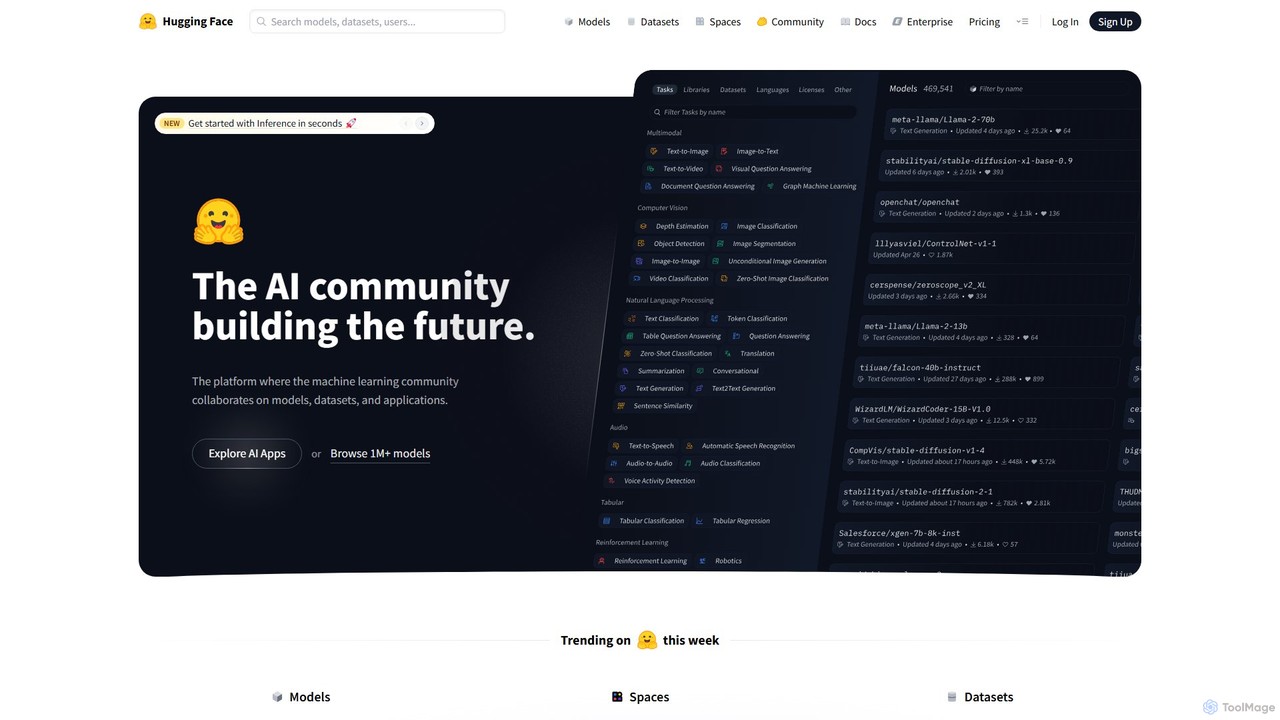
Hugging Faceは、主要なオープンソースの機械学習プラットフォームおよびコミュニティです。開発者や研究者が最先端のモデルを構築、トレーニング、デプロイするためのツールを提供し、膨大な事前学習済みモデル、データセット、デモアプリケーションのハブを提供します。
データセット
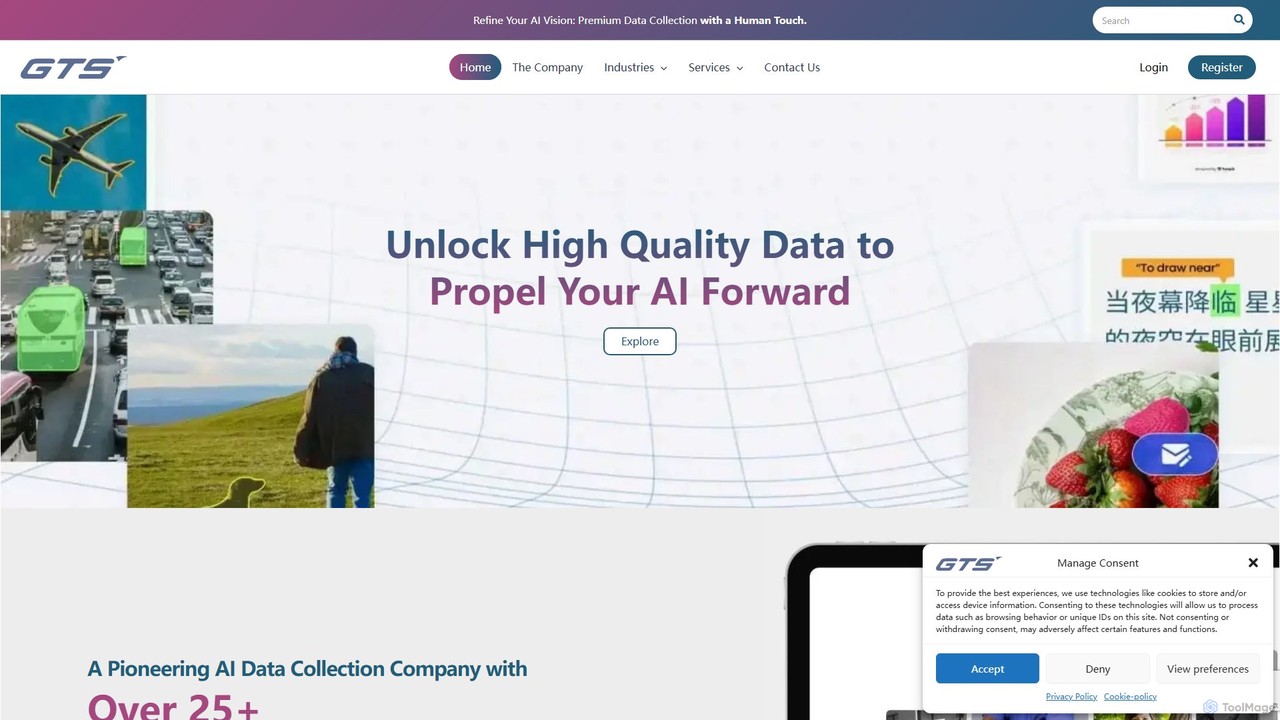
gts.aiは25年以上の経験を持つ、業界をリードするAIデータソリューションプロバイダーです。画像、動画、音声、テキストデータなど、機械学習向けの高品質なカスタムデータセットを提供しています。450万人以上のグローバルな人材を活用し、データ収集やアノテーションから文字起こし、データ管理まで包括的なサービスを展開。データの正確性、セキュリティ(ISO、GDPR、HIPAA準拠)、スケーラビリティを保証し、様々な業界の企業が信頼性の高いデータでAIプロジェクトを推進できるよう支援します。
データアノテーションデータセットツールは、人工知能および機械学習モデル用のデータコレクションを作成、管理、最適化するために設計された専門的なプラットフォームおよびサービスです。これらのツールは、データ取得、アノテーション、クリーニング、拡張といった重要なプロセスを促進し、モデルトレーニングのための高品質な入力を保証します。これらは、さまざまな分野で堅牢で正確なAIシステムを構築しようとする開発者、研究者、データサイエンティストにとって不可欠です。
データセットツールは、テクノロジー企業、研究機関、スタートアップのAI開発チームにとって不可欠です。データサイエンティスト、機械学習エンジニア、AI研究者が、AIモデルのトレーニングと検証に必要な基盤データを準備するために使用します。これには、新しいAIアプリケーションの開発から既存のアプリケーションの継続的な改善まで、さまざまなタスクが含まれます。
データセットツールを選択する際は、扱うデータの種類(例:画像、テキスト、表形式)、必要なアノテーションの複雑さ、大量のデータを処理するためのスケーラビリティを考慮してください。既存のMLパイプラインやクラウドプラットフォームとの統合機能、データ品質保証、コラボレーション、アノテーションサービスの費用対効果に関する機能を評価します。
AIエンジニアはデータセットツールを活用し、車両、歩行者、交通標識、車線などを詳細にアノテーションした大量の画像やビデオフレームを準備します。この正確にラベル付けされたデータは、自動運転システムの高精度な知覚モデルをトレーニングするために使用され、車両が複雑な道路環境を安全に走行し、情報に基づいた意思決定を行うことを可能にします。
データサイエンティストはデータセットプラットフォームを活用し、ソーシャルメディア、顧客レビュー、フォーラムから多言語のテキストデータを収集・アノテーションします。これらのテキストの感情(肯定的、否定的、中立的)をラベル付けすることで、自然言語処理(NLP)モデルをトレーニングするための堅牢なデータセットを作成します。これにより、企業は世論を正確に把握し、多言語にわたる顧客サービス戦略を改善できます。
Eコマースのデータチームはデータセットツールを使用して、数百万点の商品画像と説明を分類し、関連するタグと属性を割り当てます。この構造化されたデータは、商品検索、パーソナライズされたレコメンデーション、在庫管理システムを動かすAIモデルのトレーニングに不可欠です。正確なデータセットは、ユーザーエクスペリエンスの向上と販売コンバージョン率の増加につながります。
医療研究者は臨床医と協力し、データセットツールを使用してX線、CTスキャン、MRI画像に腫瘍や異常などの関心領域を正確にアノテーションします。この高度に専門化され、慎重にキュレーションされたデータセットは、早期疾患検出と診断を支援するAIモデルのトレーニングに使用され、精度を大幅に向上させ、命を救う可能性を秘めています。
金融機関はデータセットツールを活用し、過去の取引データを綿密にアノテーションし、不正行為や異常のパターンを特定します。データアナリストは疑わしい取引にラベルを付け、AIモデルがリアルタイムで金融詐欺を検出・防止するための堅牢なデータセットを作成します。この積極的なアプローチは顧客資産を保護し、銀行サービスへの信頼を維持します。
スマート音声製品チームはデータセットツールを活用し、さまざまなアクセント、方言、話速を考慮した多様な多言語音声データを収集・転写します。このデータはノイズ除去と正確なアノテーションを経て、高品質なデータセットが作成され、音声アシスタントの認識精度とユーザーエクスペリエンスを大幅に向上させ、グローバルなユーザーにとってより効果的なものにします。
データセットツールは、AIおよび機械学習に使用されるデータのライフサイクル全体を促進するために設計された専門的なソフトウェアおよびサービスです。これらは、生データの効率的な収集、正確なアノテーション、徹底的なクリーニング、戦略的な拡張を可能にします。主な目的は、非構造化または生情報を、AIモデルのトレーニング、検証、テストにすぐに使用できる高品質でラベル付けされたデータセットに変換し、最適なモデル性能と信頼性を確保することです。
高品質なデータセットはAIモデルにとって極めて重要です。なぜなら、あらゆる機械学習モデルの性能、精度、汎化能力は、それがトレーニングされるデータに直接依存するからです。不正確さ、偏り、不十分な量を含む低品質なデータは、パフォーマンスの低いモデル、誤った予測、または不公平な偏りを引き起こす可能性があります。適切にキュレーションされたデータセットは、モデルが堅牢なパターンを学習することを保証し、信頼性が高く効果的なAIアプリケーションにつながります。
データセットにはさまざまな形式があり、それぞれ異なるAIタスクに適しています。一般的な種類には、画像データセット(例:物体検出などのコンピュータビジョンタスク用)、テキストデータセット(例:感情分析や言語翻訳などのNLPタスク用)、音声データセット(例:音声認識や話者識別用)、ビデオデータセット(例:行動認識や自動運転用)、そして表形式データセット(行と列で構成される構造化データで、予測分析によく使用されます)があります。各種類には特定のアノテーションおよび前処理技術が必要です。
AI向けデータセットの構築と管理にはいくつかの課題があります。これには、特に大規模で複雑なデータセットの場合、データ取得と手動アノテーションにかかる高コストと時間が必要です。データの品質、一貫性、正確性を確保することは困難であり、不公平なモデル結果につながる可能性のあるデータバイアスに対処することも同様です。その他の課題には、データプライバシーとセキュリティ、ストレージと処理のスケーラビリティ、開発サイクル全体での変更を追跡し再現性を確保するための効果的なバージョン管理が含まれます。
どちらもデータを扱いますが、データセットツールはAIおよび機械学習ワークフローの独自の要件に合わせて特別に調整されているのに対し、一般的なデータ管理ツールはより広範な組織のデータニーズに焦点を当てています。データセットツールは、高度なデータアノテーションインターフェース、データ拡張機能、反復的なモデルトレーニングに最適化されたバージョン管理システムなどの専門機能を提供します。一方、一般的なデータ管理ツールは、AIモデル開発のための深い統合や特定の機能なしに、データストレージ、ETLプロセス、レポート作成、ビジネスインテリジェンスを優先します。