
Free
JSON Formatter
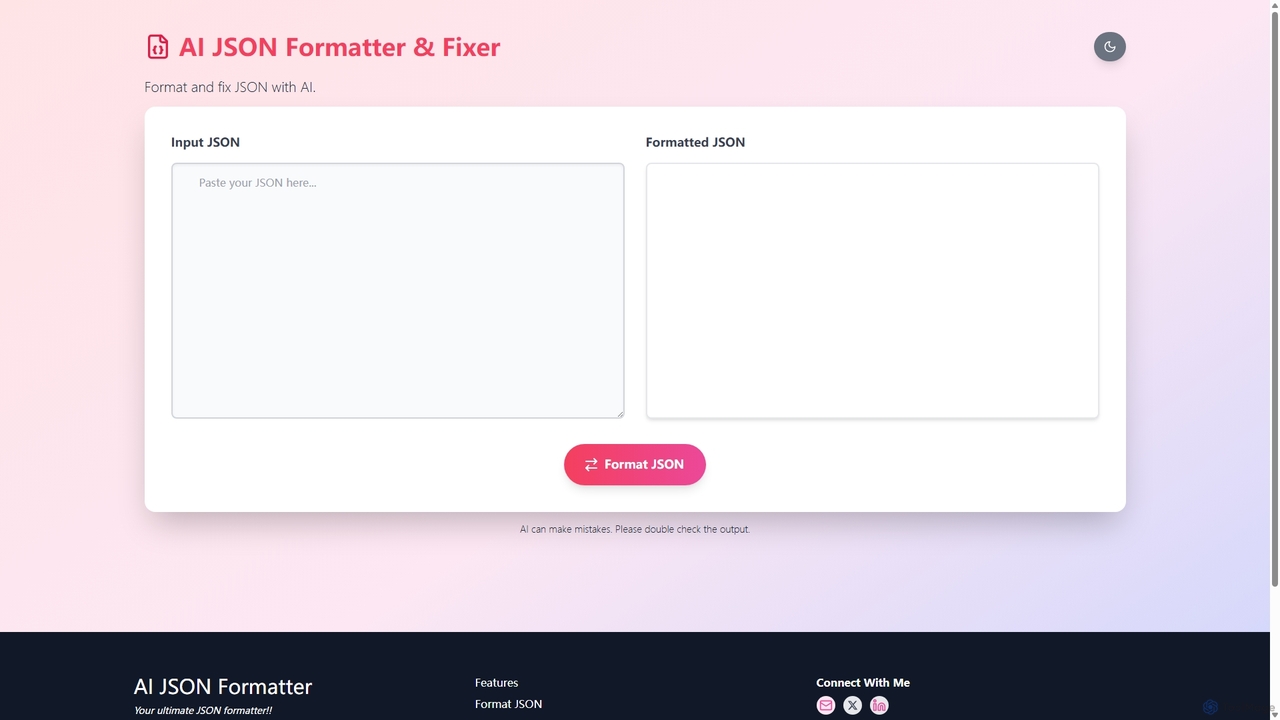
AIを搭載したオンラインツールで、JSONデータのフォーマット、バリデーション、修正を行います。即時フォーマット、インテリジェントなエラー修正、ファイルアップロード機能を提供し、開発者がJSONを効率的にデバッグ・管理するために不可欠です。
コードアシスタントVisits 9.8KFavorites 164Likes 151
Popular データ処理 AI tools in 開発者ツール include JSON Formatter, helping you work more efficiently.
AIを搭載したオンラインツールで、JSONデータのフォーマット、バリデーション、修正を行います。即時フォーマット、インテリジェントなエラー修正、ファイルアップロード機能を提供し、開発者がJSONを効率的にデバッグ・管理するために不可欠です。
コードアシスタントAIデータ処理ツールは、複雑なデータセットの処理を自動化および合理化するために設計された、開発者向けの専門的なユーティリティカテゴリです。これらは機械学習アルゴリズムを活用して、データクリーニング、変換、特徴量エンジニアリング、検証などのタスクを実行し、MLOpsライフサイクルの重要な部分を形成します。これらのツールは、機械学習モデル用の高品質なデータを準備し、開発サイクルを加速させ、AI駆動アプリケーションにおけるデータの完全性を確保するために不可欠です。パターンと異常をインテリジェントに識別することで、データ準備に通常必要とされる手作業を大幅に削減します。
これらのツールは主に、データサイエンティスト、機械学習エンジニア、データエンジニアによって使用されます。一般的なシナリオには、新しい予測モデルのためのトレーニングデータの準備、リアルタイムアプリケーションのための堅牢で適応性のあるデータパイプラインの構築、または自然言語処理(NLP)タスクのための大規模な非構造化テキストデータのクリーニングなどがあります。
AIデータ処理ツールを選択する際は、データソースの互換性(データベース、API、ファイル形式)、データ量を処理するスケーラビリティ、既存のMLOpsスタック(例:TensorFlow、PyTorch、クラウドプラットフォーム)との統合能力を考慮してください。また、チームのワークフローと技術的専門知識に適合するかどうかを確認するために、自動化のレベルとカスタムルール定義の必要性のバランスを評価することも重要です。
ある機械学習エンジニアが、不正検出モデルの構築を担当しています。生の取引データは、欠損値、様々な通貨形式、ノイズの多いテキストフィールドなど、一貫性がありません。AIデータ処理ツールを使用することで、エンジニアは統計的パターンに基づいて欠損値を補完し、すべての金額を単一通貨に標準化し、テキスト記述をクリーンにするプロセスを自動化します。ツールはまた、「1時間あたりの取引頻度」などの新しい特徴量を提案・生成します。これにより、数日かかっていた作業が数時間で完了し、クリーンで高品質なデータセットが作成され、最終的なモデルの精度が大幅に向上し、手動での前処理作業が80%以上削減されます。
データエンジニアは、様々なサードパーティAPIからデータウェアハウスにデータを取り込むETL/ELTパイプラインの維持を担当しています。これらのAPIは頻繁にスキーマが変更されたり、予期しない形式のデータが配信されたりします。エンジニアは、脆弱なルールベースのスクリプトを作成する代わりに、AIデータ処理ツールを導入します。このツールはスキーマの変更を自動的に検出し、変換ロジックをその場で適応させ、異常検出を使用して不良データがウェアハウスを汚染する前に隔離します。これにより、手動介入が大幅に少なく、下流の分析におけるデータ信頼性が高い、より回復力のある自己修復型のパイプラインが構築されます。
データサイエンティストは、感情と主要なトピックを抽出するために、何千もの顧客レビューを分析する必要があります。生のテキストは、タイプミス、俗語、無関係なHTMLタグでいっぱいです。このデータを手動でクリーニングするのは非常に時間がかかります。AIデータ処理ツールを使用することで、スペル修正、ストップワードの削除、固有表現抽出などのタスクに事前構築されたモデルを適用します。ツールはレビューのコーパス全体を処理し、感情分析モデルへの入力準備が整った、構造化されたクリーンなテキストを出力します。これにより、プロジェクトのタイムラインが数週間から数日に短縮され、NLPインサイトの精度が向上します。
ヘルスケアテクノロジー企業の開発チームは、新しい患者管理ソフトウェアをテストする必要があります。HIPAAのような厳格なプライバシー規制のため、実際の患者データを使用することはできません。チームは、合成データ生成機能を備えたAIデータ処理ツールを使用します。彼らはツールに実データのスキーマと統計的特性を提供します。すると、ツールは実際の個人情報を一切含まない、現実世界の分布と関係を模倣した患者記録の大きな人工データセットを生成します。これにより、QAチームはプライバシー法を完全に遵守しながら、堅牢な大規模テストを実施できます。
Eコマースのデータアナリストは、複数のサプライヤーからの製品カタログを統合する必要があります。各サプライヤーは異なる形式でデータを提供し、命名規則(例:「Color」対「Colour」)や属性構造も一貫していません。AIデータ処理ツールを使用することで、アナリストはこれらの異なるフィールドをインテリジェントにマッピングし、標準化できます。ツールのAIは意味的な類似性を認識して属性を正しく統合し、クラスタリングアルゴリズムを使用して類似製品をグループ化し、潜在的な重複を特定します。このプロセスにより、統一されたクリーンなマスター製品カタログが作成され、サイト内検索の精度が直接向上し、顧客のブラウジング体験が向上します。
IoT開発者は、産業機械向けの予知保全システムを構築しており、これはセンサーデータ(温度、振動、圧力)の定常的なストリームに依存しています。このデータは、センサーの誤動作によりノイズが含まれたり、誤った測定値を含んだりすることがあります。データストリームにAIデータ処理ツールを実装し、リアルタイム検証を実行します。訓練済みモデルを使用して、期待される動作範囲やパターンから外れた異常な測定値を特定します。このツールは、これらの外れ値を予測モデルに供給する前に自動的にフラグを立て、フィルタリングし、あるいは修正することさえ可能で、誤報を防ぎ、保全アラートの信頼性を確保します。
AIデータ処理ツールは、人工知能を使用してデータ準備タスクを自動化および強化する、開発者向けの特殊なソフトウェアです。明示的なルールに依存する従来のスクリプトやETLツールとは異なり、これらのツールはデータパターンを学習して、複雑なデータセットをインテリジェントにクリーニング、変換、検証し、さらには特徴量を生成することができます。これらは、機械学習ワークフローで最も時間のかかる部分である高品質なデータの準備を加速させるために設計されています。
主な違いは、インテリジェンスと適応性にあります。従来のETL(抽出、変換、読み込み)ツールは、開発者が設定した固定的で事前定義されたルールに基づいて動作します。データ形式が変更されると、ルールは機能しなくなります。AIデータ処理ツールはより動的です。機械学習を使用して次のことを行います:
主なユーザーは、アプリケーションやモデルを構築するために直接データを扱う技術専門家です。これには以下が含まれます:
適切なツールを選ぶには、特定のニーズによります。以下の主要な要素を考慮してください:
はい、多くの高度なAIデータ処理ツールは、非構造化データや半構造化データを処理するために特別に設計されています。テキストについては、NLPベースのクリーニング(タイプミス修正、ストップワード除去)、エンティティ認識、トピックモデリングなどの機能を提供します。画像については、自動タギング、リサイズ、品質問題(例:ぼやけ)の特定などのタスクを支援することがあります。この能力は、構造化された表形式データに限定されがちな従来のデータツールに対する大きな利点です。ツールを選択する際は、扱う非構造化データの種類に対する具体的な機能を確認してください。