Freemium
Spice AI
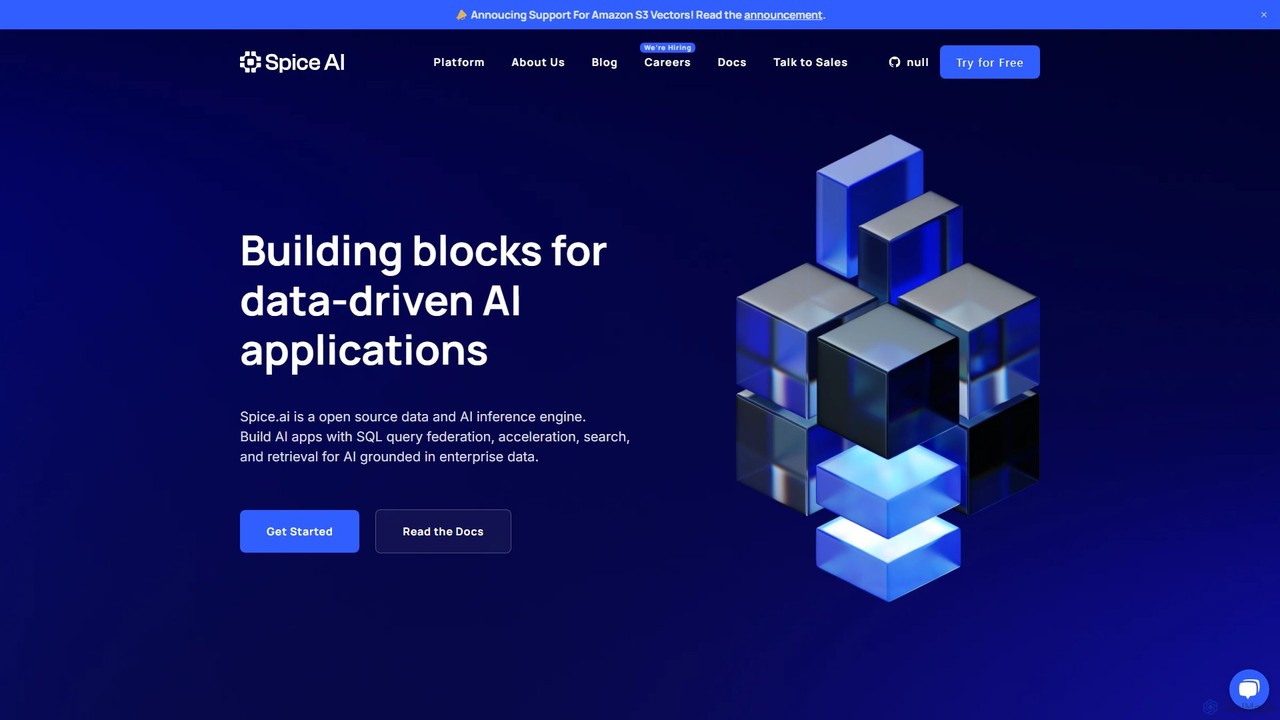
Spice AIは、開発者向けのオープンソースでポータブルなデータおよびAIコンピュートエンジンです。あらゆるソースからのデータを統合し、Apache Arrowでクエリを高速化し、AIモデルのサービングとベクトル検索を統合して、高性能なデータ駆動型アプリケーションの構築を簡素化します。
モデルデプロイメントVisits 34.7KFavorites 161Likes 153
Popular データベース AI tools in 開発者ツール include MongoDB、Databricks、Elastic、Pinecone、Milvus、InfluxData、Chroma、Navicat、Vectorize、MotherDuck, helping you work more efficiently.
Spice AIは、開発者向けのオープンソースでポータブルなデータおよびAIコンピュートエンジンです。あらゆるソースからのデータを統合し、Apache Arrowでクエリを高速化し、AIモデルのサービングとベクトル検索を統合して、高性能なデータ駆動型アプリケーションの構築を簡素化します。
モデルデプロイメント
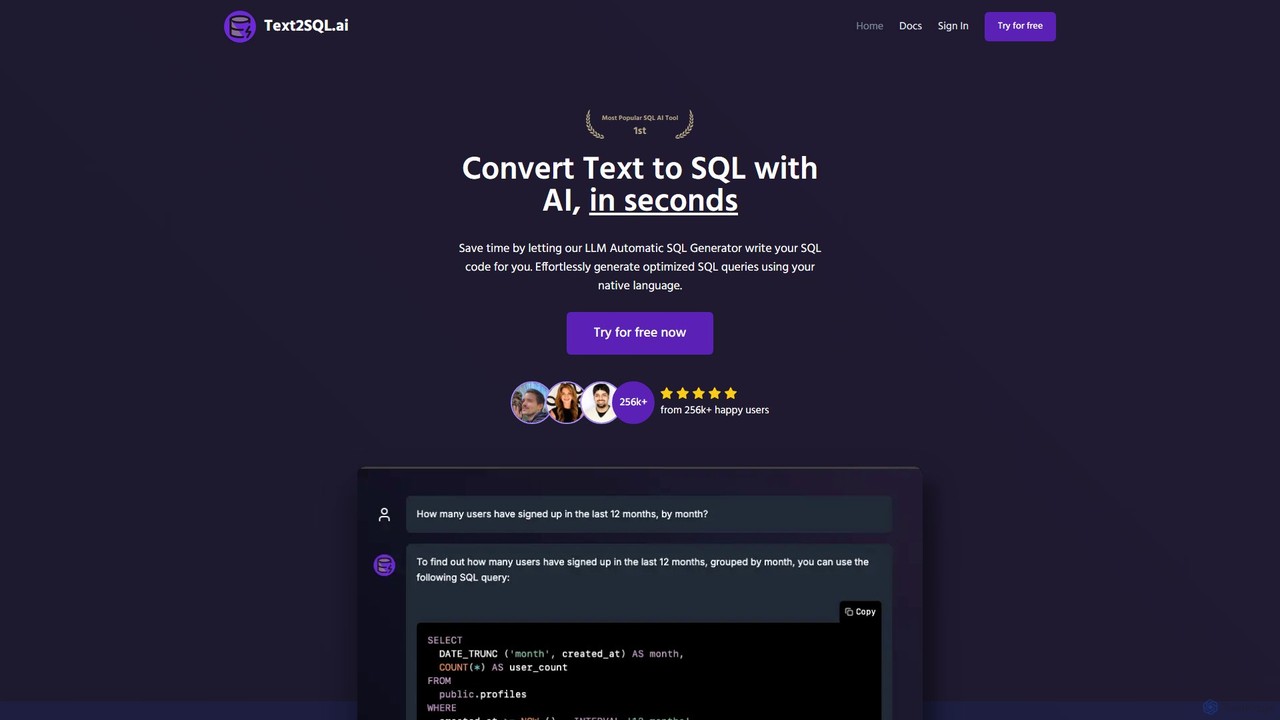
Text2SQL.aiは、自然言語のテキストを複雑なSQLクエリや正規表現パターンに即座に変換するAI搭載ツールです。12種類以上のSQLおよびNoSQLデータベースをサポートし、より高い精度のためにスキーマ統合を可能にし、コードの説明、修正、最適化を行う包括的なAIアシスタントとして機能します。開発者、データアナリスト、初心者を対象に設計されており、時間を節約し、エラーを削減し、データベースとの対話をよりアクセスしやすくします。また、カスタム統合のための公開APIも提供しています。
クエリ
AIデータベースは、人工知能を統合してデータ操作を自動化・強化する高度なデータ管理システムです。自然言語クエリ、パフォーマンスの自動チューニング、ベクトル検索などのタスクに機械学習を活用し、より直感的で強力なデータ操作を可能にします。これらのツールは、セマンティック検索、リアルタイム分析、予測モデリングを必要とする次世代アプリケーションの構築に不可欠です。その主な価値は、手動でのデータベース管理を削減し、複雑な非構造化データセットからより深い洞察を引き出す点にあります。
AIデータベースは、インテリジェントなアプリケーションを構築する開発者やデータサイエンティストに広く利用されています。一般的なシナリオには、Eコマース向けの高度な推薦エンジンの作成、金融分野でのリアルタイム不正検知システムの開発、社内ナレッジベースや顧客向け製品のための強力なセマンティック検索機能の実装などがあります。
AIデータベースを選ぶ際は、ベクトル検索や自然言語処理など、必要な特定のAI機能を考慮してください。予想されるワークロードに対するスケーラビリティとパフォーマンスを評価します。また、既存の技術スタックや機械学習フレームワークとの互換性を確認し、開発者とデータアナリスト双方にとっての使いやすさも検討しましょう。
Eコマースの開発者は、キーワードだけでなくユーザーの意図を理解する製品検索機能を開発する必要があります。「赤い靴」をマッチングするのではなく、「夏のパーティー用の履物」のようなクエリを理解する必要があります。ベクトル検索が組み込まれたAIデータベースを使用し、開発者は製品の説明と画像をベクトル埋め込みに変換します。ユーザーが検索すると、そのクエリもベクトルに変換され、データベースは意味的に最も類似した製品を見つけ出します。これにより、より関連性の高い検索結果、改善されたユーザーエクスペリエンス、そしてより高いコンバージョン率が実現します。
金融機関のデータサイエンティストは、不正取引を防止する任務を負っています。彼らは、インデータベース機械学習機能を備えたAIデータベースを使用します。取引データは直接データベースにストリーミングされ、そこで事前に訓練された異常検知モデルがリアルタイムで実行されます。モデルは、取引額、場所、頻度などのパターンを分析します。取引がユーザーの通常の行動から著しく逸脱した場合、データベースは即座にそれをフラグ付けし、機関が取引をブロックして顧客に警告することを可能にし、金銭的損失を最小限に抑えます。
ビジネスアナリストは、複雑なSQLクエリを作成するためにIT部門に頼ることなく、迅速にレポートを生成する必要があります。BIツールをAIデータベースに接続することで、「前四半期の製品Xと製品Yの売上を地域別に比較して」といった平易な英語で質問することができます。AIデータベースの自然言語処理(NLP)エンジンがこの質問を正式なクエリに変換し、実行してデータを返します。これにより、技術者でないユーザーもセルフサービス分析を実行でき、意思決定を加速し、開発者のリソースを解放します。
DevOpsエンジニアは、急成長しているソーシャルメディアアプリケーションのデータベースを管理しています。ユーザートラフィックが変動すると、データベースのパフォーマンスが低下する可能性があります。手動でインデックスを作成・削除したり、クエリパラメータを調整したりする代わりに、自動チューニングを実行するAIデータベースを使用します。データベースのAIコンポーネントは、ワークロードのパターンを継続的に監視し、将来のクエリニーズを予測します。最適なインデックスを積極的に作成し、メモリ割り当てを調整し、非効率なクエリをその場で書き換えます。これにより、常に手動で介入することなく一貫した高性能が保証され、運用上のオーバーヘッドが削減されます。
ストリーミングプラットフォームのコンテンツ制作者は、関連性の高い動画を提案することでユーザーエンゲージメントを高めたいと考えています。彼らはAIデータベースを使用して、動画コンテンツ(タイトル、説明、字幕に基づく)のベクトル表現を保存します。ユーザーが動画を視聴すると、システムはデータベースにクエリを実行し、最も類似したベクトルを持つ他の動画を見つけます。これは単純なタグベースのマッチングを超え、コンテンツのニュアンスやトピックを捉えます。その結果、真にパーソナライズされた「あなたへのおすすめ」セクションが生まれ、視聴時間の延長とユーザー維持率の向上につながります。
サイト信頼性エンジニア(SRE)は、数百万のログエントリに直面しながら本番環境の問題を調査しています。複雑なgrepコマンドや厳格なログクエリ言語を使用する代わりに、ログをAIデータベースに取り込みます。そして、「過去1時間にEUクラスターで発生した支払い失敗に関連するすべてのエラーログを表示して」のような質問をすることができます。データベースはNLPを使用してクエリを理解し、セマンティック検索を使用して関連するログエントリを見つけます。たとえそれらが正確なキーワードを含んでいなくてもです。これにより、根本原因分析プロセスが劇的に高速化され、システムのダウンタイムが短縮されます。
AIデータベースは、人工知能機能で強化されたデータ管理システムです。単にデータを保存・取得する従来のデータベースとは異なり、AIデータベースはデータに対する操作を理解、分析、自動化することができます。主な機能には、自然言語クエリ(平易な言葉での質問)、パフォーマンスの自動チューニング、意味的な意味に基づいてデータを見つけるための統合ベクトル検索などが含まれます。これらは、インテリジェントなアプリケーションを強化し、複雑なデータ分析を簡素化するために設計されています。
主な違いは、その中核となる能力にあります。従来のデータベースは、完全一致(SQL)またはキー・バリュー検索(NoSQL)に基づく構造化ストレージと効率的な取得に焦点を当てています。AIデータベースは、ストレージの上に知能の層を追加します。主な違いは次のとおりです。
ベクトル検索は、完全なキーワード一致ではなく、意味的な類似性に基づいてデータを見つける方法です。テキスト、画像、音声などのデータをベクトルと呼ばれる数値表現に変換することで機能します。データベースは、多次元空間でベクトルが最も近いアイテムを見つけます。これはAIデータベースにとって非常に重要です。なぜなら、ユーザーのクエリの背後にある文脈や意味を理解する推薦エンジン、画像検索、質疑応答システムなどのアプリケーションを可能にし、従来の検索方法よりもはるかに適切な結果を提供できるからです。
適切なAIデータベースを選ぶには、特定のニーズによります。以下の要素を考慮してください。
はい、多くのAIデータベースの主要な強みの一つは、さまざまなデータ型を扱える能力です。従来の構造化データ(テーブル内のユーザープロファイルなど)を管理できる一方で、非構造化データ(製品レビュー、画像、サポートチケットなど)の処理にも優れています。これは、非構造化コンテンツに対してベクトル埋め込みを作成し、構造化データと一緒にクエリや分析を可能にすることで実現され、すべての情報の統一されたビューを提供します。