
Trainloop AI
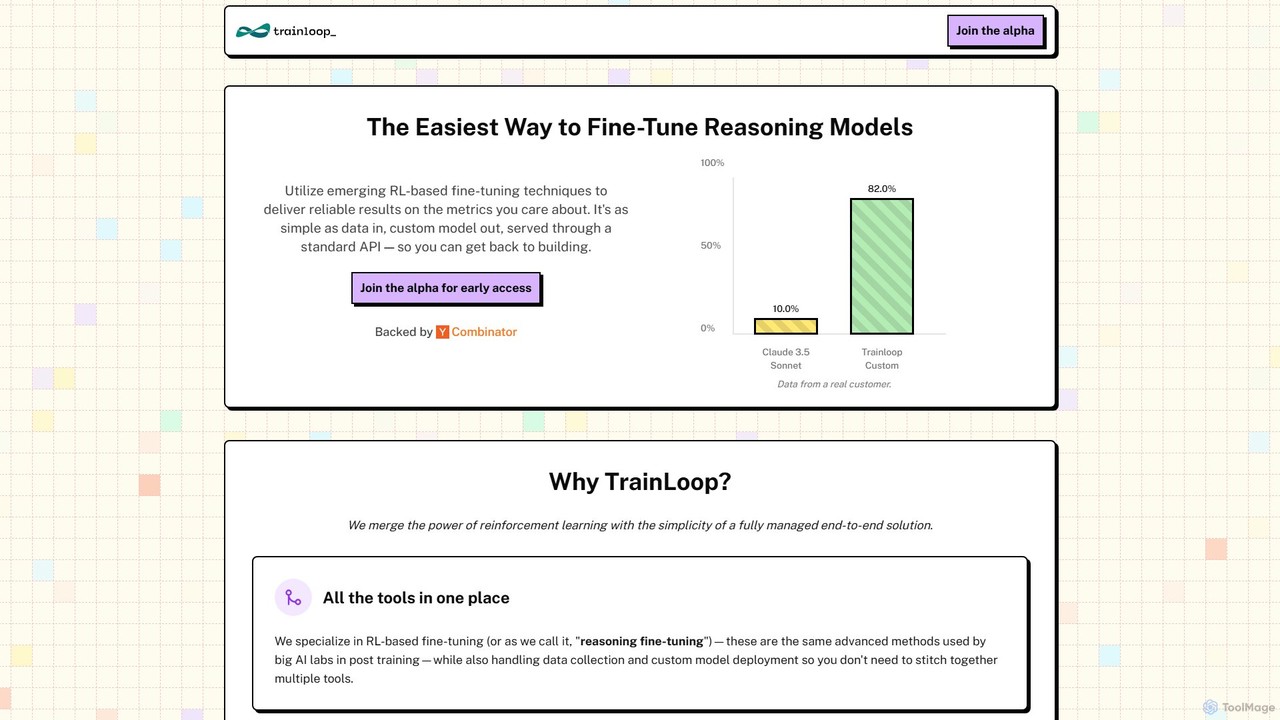
Trainloop AIは、高度な強化学習(RL)技術を用いてAI推論モデルのファインチューニングを簡素化するエンドツーエンドのプラットフォームです。データ収集からモデル展開までの完全なソリューションを提供し、開発者が少ないデータで、複雑なプロンプトエンジニアリングなしに、信頼性の高いドメイン専門AIモデルを構築できるようにします。
機械学習Visits 10.4KFavorites 151Likes 170
Popular モデルのファインチューニング AI tools in 開発者ツール include Trainloop AI, helping you work more efficiently.
Trainloop AIは、高度な強化学習(RL)技術を用いてAI推論モデルのファインチューニングを簡素化するエンドツーエンドのプラットフォームです。データ収集からモデル展開までの完全なソリューションを提供し、開発者が少ないデータで、複雑なプロンプトエンジニアリングなしに、信頼性の高いドメイン専門AIモデルを構築できるようにします。
機械学習モデルのファインチューニングは、AI開発における専門的なプロセスであり、事前学習済みの人工知能モデルを特定のタスクでより高い精度と関連性で実行できるように適応させます。この技術は、大規模な汎用モデルの基礎知識を活用し、より小規模なタスク固有のデータセットを使用してそれを洗練させます。開発者ツールの重要なコンポーネントとして、モデルのファインチューニングにより、エンジニアやデータサイエンティストは、ゼロから広範な計算リソースや大量のトレーニングデータを必要とせずに、ニッチなアプリケーション向けに強力なAI機能をカスタマイズできます。
モデルのファインチューニングは、AIエンジニアや製品開発者によって広く採用されており、汎用AIモデルを特定のビジネスニーズに合わせて調整します。医療から金融まで、さまざまな業界で、特定のデータ特性と運用要件にモデルを適応させることで、高精度でコンテキストを認識するAIソリューションを作成するために不可欠です。
モデルのファインチューニングツールを選択する際には、サポートされているモデルアーキテクチャ(例:LLM、ビジョンモデル)、データ準備とアノテーションの容易さ、ハイパーパラメータチューニングの柔軟性、および既存のMLOpsパイプラインとの統合を考慮してください。費用対効果、スケーラビリティ、およびターゲットドメインとタスクに合致する事前学習済みベースモデルの利用可能性を評価します。
企業のAIエンジニアは、社内文書、ポリシー、および独自のデータに基づいて質問に正確に回答できるように、大規模言語モデル(LLM)を適応させる必要があります。社内文書と対応するQ&Aペアの厳選されたデータセットでLLMをファインチューニングすることにより、エンジニアはドメイン固有の用語に対するモデルの理解を大幅に向上させ、幻覚を減らすことができます。これにより、従業員に正確で文脈を認識した応答を提供する、より信頼性の高い社内チャットボットまたはナレッジ検索システムが実現します。
製造会社の品質保証チームは、組立ラインでの製品欠陥検査を自動化することを目指しています。一般的な画像認識モデルは存在するものの、製品固有の微妙な欠陥の種類には対応が難しい場合があります。そこで、自社の製品画像(完璧なサンプルと欠陥のあるサンプルの両方を含む)のデータセットで事前学習済みのビジョンモデルをファインチューニングすることにより、チームは微細な欠陥でも正確に識別するようにモデルを訓練でき、手動検査時間を70%削減し、製品品質の一貫性を全体的に向上させることができます。
金融サービス企業は、さまざまなチャネルからの顧客フィードバックを分析して感情を評価したいと考えています。一般的な感情分析モデルは、業界固有の用語(例:「弱気相場」と「強気相場」)や略語を誤解することが多く、不正確な感情スコアにつながります。事前学習済みの自然言語処理(NLP)モデルを、正しい感情が注釈付けされた金融テキストのデータセットでファインチューニングすることにより、企業は金融言語のニュアンスを理解する高精度な感情分析ツールを実現でき、より良い顧客インサイトとリスク評価を可能にします。
職人技の工芸品に特化したeコマースプラットフォームは、多様な顧客層に非常に適切な商品を提案するレコメンデーションエンジンを必要としています。一般的なレコメンデーションモデルは存在するものの、ニッチな商品に必要な特異性が不足していることがよくあります。独自の顧客購入履歴と商品メタデータで協調フィルタリングまたはコンテンツベースのレコメンデーションモデルをファインチューニングすることにより、プラットフォームは個々の顧客の好みに深く響くパーソナライズされたレコメンデーションを生成でき、コンバージョン率を15%向上させ、顧客満足度を高めます。
医療提供者は、医療の口述筆記に対して非常に正確な音声テキスト変換を必要としますが、一般的な音声認識モデルは、複雑な医療専門用語、薬剤名、特定の患者の状態に対応するのが難しい場合があります。事前学習済みの自動音声認識(ASR)モデルを、転写された医療会話や臨床記録の大規模なデータセットでファインチューニングすることにより、開発者は医療用語に対するモデルの精度を大幅に向上させ、95%以上の精度を達成できます。これにより、より迅速かつ正確な文書作成が可能になり、エラーが減り、臨床医の貴重な時間を節約できます。
ソフトウェア開発チームはAIコード生成ツールを頻繁に利用しますが、これらのツールは通常、会社の特定のコーディング標準、内部ライブラリ、または独自のフレームワークに準拠しない汎用コードを生成します。独自のコードベースのデータセット(推奨されるコーディングスタイルやフレームワークの使用例を含む)で大規模なコード生成モデルをファインチューニングすることにより、開発者はAIが直接使用可能なコードを生成するように訓練でき、広範な手動リファクタリングの必要性を減らし、開発サイクルを最大30%加速させることができます。
モデルのファインチューニングとは、膨大なデータセットから一般的な特徴を学習した事前学習済みのAIモデルを、より小規模なタスク固有のデータセットでさらに学習させる技術です。このプロセスにより、モデルの既存の知識が新しい関連タスクやドメインに適応され、その特定のアプリケーションに対して高度に専門化され、正確になります。これは、ゼロからのトレーニングに大量のデータや計算リソースを必要とせずに、最先端のモデルを活用するための強力な手法です。
モデルをゼロからトレーニングする場合、事前の知識なしに新しいデータセットを使用してAIモデルを構築およびトレーニングするため、膨大なデータと計算能力が必要です。対照的に、モデルのファインチューニングは、すでに一般的なパターンと特徴を学習した事前学習済みモデルから開始します。その後、モデルの既存の知識を適応させるために、より小規模なタスク固有のデータセットのみが必要となるため、データ、時間、計算リソースの面で大幅に効率的です。ファインチューニングは、ドメイン固有のデータが限られているが、高いパフォーマンスを達成したい場合に最適です。
深層学習アーキテクチャに基づくAIモデルは、ファインチューニングから恩恵を受けることができます。これには、テキスト生成、要約、質問応答などの自然言語処理タスク用の大規模言語モデル(LLM)が含まれます。画像分類、物体検出、セグメンテーションに使用されるビジョンモデル(例:CNN、Transformer)も一般的にファインチューニングされます。さらに、音声認識モデル、レコメンデーションシステム、さらには一部の強化学習エージェントも、特定のデータ分布やタスク要件に適応するためにファインチューニングを受けることができ、専門的なコンテキストでのパフォーマンスを向上させます。
モデルのファインチューニングのプロセスには、通常、いくつかの主要なステップが含まれます。まず、ターゲットタスクに合致する適切な事前学習済みベースモデルを選択します。次に、データクリーニング、アノテーション、データ拡張などを含む、高品質なタスク固有のデータセットを準備します。第三に、学習率、バッチサイズ、トレーニングエポック数などのファインチューニングパラメータを設定します。第四に、通常、初期の事前学習よりもはるかに小さい学習率で、新しいデータセットでモデルをトレーニングします。最後に、ファインチューニングされたモデルのパフォーマンスを別の検証セットで評価し、特定のアプリケーションに必要な精度と汎化能力を満たしていることを確認します。
モデルのファインチューニングは、AI開発にいくつかの大きな利点をもたらします。ゼロからトレーニングする場合と比較して、必要なデータ量と計算リソースを大幅に削減し、高度なAIをより利用しやすくします。既存の強力なモデルを活用することで、開発サイクルを加速します。ファインチューニングは、モデルが特定のドメインのニュアンスに合わせて調整されるため、特定のタスクに対する精度と関連性も向上させます。これにより、さまざまな業界の専門アプリケーションで、より堅牢で効果的なAIソリューションをより迅速かつ高い信頼性で展開できます。
高精度を必要とするが、ドメイン固有のデータが限られている特定のAIタスクがある場合に、モデルのファインチューニングを検討すべきです。これは、より広範なタスクに適した事前学習済みモデルがすでに存在する場合(例:テキスト用の汎用言語モデル、画像用の汎用ビジョンモデル)に特に役立ちます。ファインチューニングは、AIモデルを新しいデータ分布、独自の専門用語、または独自のデータセットに適応させる必要がある場合にも有益であり、ゼロからモデルをトレーニングする法外なコストと時間をかけずに、専門的なパフォーマンスを達成できます。