Foxscrape
データ抽出
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
FoxScrapeは、開発者向けのAI搭載ウェブスクレイピングREST APIです。平易な英語によるAI駆動の解析、動的サイト向けのJavaScriptレンダリング、ブロックを回避するための自動プロキシローテーションなどの機能を使用して、あらゆるウェブサイトを構造化されたJSONデータに変換し、データ抽出を簡素化します。
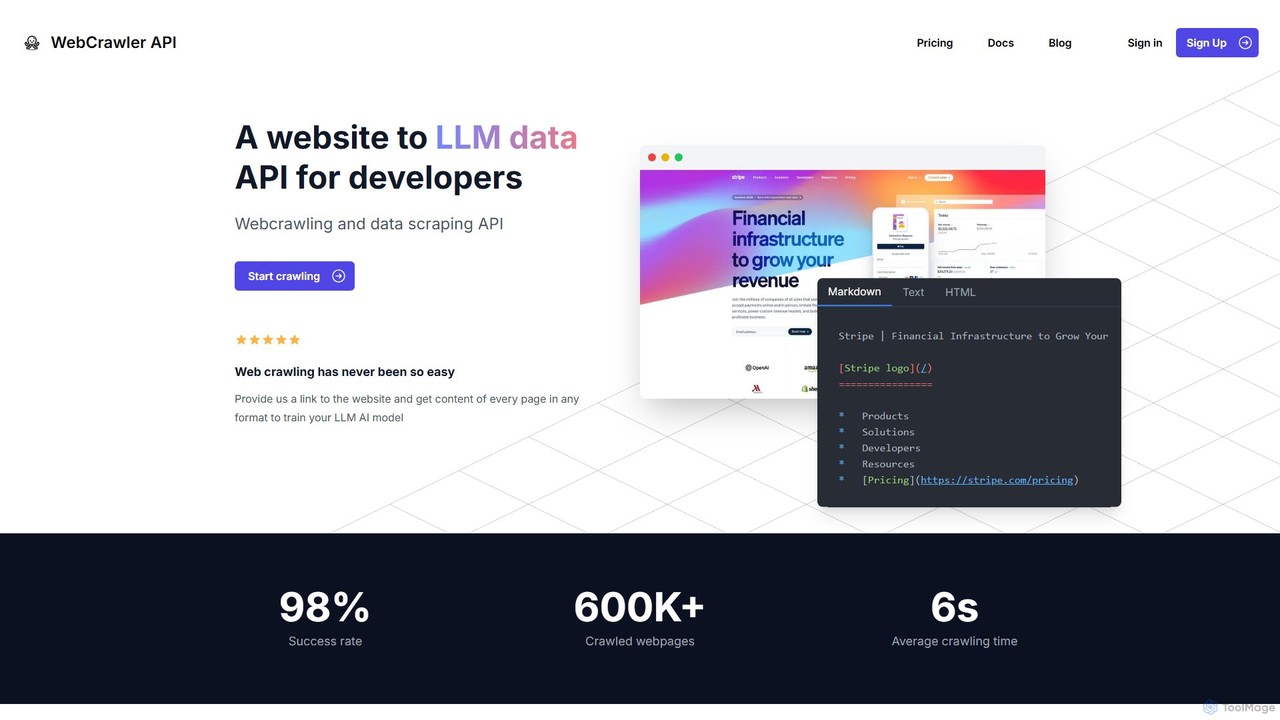
Webcrawlerapiは、開発者が簡単にウェブサイトをクロールし、クリーンなデータを抽出できるように設計された強力なAPIです。JavaScriptのレンダリング、アンチボット対策、データ解析を処理することで、複雑なウェブスクレイピングプロセスを簡素化します。LLM AIモデルのトレーニングや検索拡張生成(RAG)システムのために、Markdownやテキストなどの構造化コンテンツを収集するのに最適で、高い成功率とシンプルな従量課金制の価格モデルを提供します。
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| 基本情報 | Foxscrape | Webcrawlerapi |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | データ抽出 | データ抽出 |
| 対象ユーザーと職種 | ビジネスアナリスト · データアナリスト · データサイエンティスト · マーケティングマネージャー · プロダクトマネージャー · ソフトウェア開発者 | 未確認 |
| カテゴリー | データ抽出 · API · 自動化 | データ抽出 · API · 自動化 |
| Added | 2025/11/05 | 2025/08/02 |
| 更新 | 2026/11/19 | 2026/11/19 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
FoxScrapeは、開発者向けのウェブスクレイピングプロセスを効率化するために設計されたプロフェッショナルなREST APIを提供します。これにより、ユーザーはあらゆるウェブサイトから構造化データを抽出し、クリーンなJSON形式で受け取ることができます。このプラットフォームは、初心者から経験豊富なプロフェッショナルまで対応できるよう、パワフルでありながら使いやすく構築されています。何千ものヘッドレスChromeインスタンスを活用して、APIリクエストが実際のユーザーのように振る舞うことを保証し、一般的なアンチボット対策を回避して、大規模なデータ抽出を確実に行います。
開発者は、1,000クレジットが含まれた無料のAPIキーを取得してFoxScrapeの使用を開始できます。統合は簡単です。FoxScrapeのエンドポイントにREST APIコールを行い、「Authorization」ヘッダーにAPIキーを含め、ターゲットURLをパラメータとして渡します。ReactやVueなどのフレームワークで構築された動的なウェブサイトの場合は、「render_js」パラメータを有効にするだけです。インテリジェントな抽出のためには、必要なデータを平易な英語で記述すれば、AIがCSSセレクタやXPathを必要とせずに解析を処理します。
FoxScrapeは、さまざまなデータ抽出タスクに最適です。開発者やデータアナリストは、eコマースサイトの価格監視、不動産情報の収集、顧客レビューの集約、競合データのスクレイピングによる市場調査、SEO分析のための検索エンジン結果の抽出などに使用できます。複雑なサイトを処理する能力により、金融ポータル、ソーシャルメディア、ニュースサイトからのデータ抽出にも適しています。
FoxScrapeの主な利点は、そのインテリジェンスと信頼性です。AIによる抽出は、壊れやすいCSSセレクタの必要性をなくし、スクレイパーをウェブサイトの更新に対してより回復力のあるものにします。組み込みのプロキシローテーションとブラウザレベルのレンダリングにより、高い成功率が保証され、ブロックが防止されます。スクレイパー、レンダラー、プロキシマネージャーを単一のスケーラブルなAPIに統合したオールインワンソリューションを提供し、開発者がDIYセットアップを構築・維持するのに比べて大幅な時間と労力を節約します。
FoxScrapeは、透明性の高い料金モデルと無料トライアルを提供しています。新規ユーザーはクレジットカードなしで1,000の無料APIクレジットを受け取れます。
Webcrawlerapiは、開発者向けにウェブクローリングとデータ抽出のプロセスを合理化するために設計された専門APIです。データが大規模言語モデル(LLM)のトレーニングやAIアプリケーションの動力源として不可欠な時代において、従来のウェブスクレイピングは大きな課題を抱えています。これには、動的なJavaScriptレンダリングコンテンツの処理、高度なアンチボットシステムの回避、プロキシの管理、乱雑なHTMLを使用可能な形式にクリーニングすることが含まれます。Webcrawlerapiは、これらすべての複雑さを抽象化し、あらゆるウェブサイトを構造化されたデータソースに変えるためのシンプルかつ強力なインターフェースを提供します。
報告されている98%の成功率と平均6秒のクロール時間により、このサービスは効率性と信頼性のために構築されています。これにより、開発者はスケーラブルなクローリングインフラの構築と維持の複雑さにとらわれることなく、コアアプリケーションのロジックに集中できます。リンクを提供するだけで、開発者はMarkdown、テキスト、または生のHTMLなどのクリーンですぐに使えるコンテンツを受け取ることができ、AIモデルのトレーニングパイプラインやRAGシステムのナレッジベースに供給するのに最適です。
Webcrawlerapiをプロジェクトに統合するのは非常に簡単です。プロセスは通常、数行のコードで完了します。まず、Webcrawlerapiのウェブサイトでサインアップして、一意のAPIアクセスキーを取得する必要があります。次に、人気のあるプログラミング言語用に提供されているクライアントライブラリのいずれかを使用できます。
たとえば、NodeJS環境では、まずnpmを介してクライアントライブラリをインストールします:npm i webcrawlerapi-js。次に、コードでライブラリをインポートし、APIキーを使用して新しいクライアントインスタンスを作成し、`crawl`メソッドを呼び出します。このメソッドは、ターゲット`url`、希望する`scrape_type`(例:「markdown」)、および`items_limit`などのオプションの制限などのパラメータを取ります。その後、APIはバックグラウンドでクローリングプロセス全体を処理し、抽出されたデータを含む構造化されたJSONレスポンスを返します。Python、PHP、.NETでも同様の簡単な統合パターンが利用可能で、幅広い開発者がアクセスしやすくなっています。
Webcrawlerapiは多用途であり、さまざまなデータ集約型のタスクに適用できます。その主な使用例は、AIとデータ分析を中心に展開されます。
Webcrawlerapiの主な利点は、そのシンプルさと効率性です。これにより、開発チームはウェブクローリングのインフラ全体とメンテナンスの負担を外部に委託できます。これは、データ駆動型製品の市場投入までの時間を短縮することを意味します。高い成功率(98%)と堅牢なアンチボット機能により、データパイプラインの信頼性が確保されます。さらに、透明性の高い従量課金制の価格モデルは非常に費用対効果が高く、成功したリクエストに対してのみ支払うため、サブスクリプションや自社ソリューションの構築に関連するリスクとオーバーヘッドを排除します。
Webcrawlerapiは、サブスクリプションや隠れた料金を完全に排除した、直接的で透明性の高い「使用量に応じた支払い」の価格モデルを採用しています。コストは、毎月正常にクロールしたページの数に基づいて計算されます。このサービスの価格には、無制限のクロールジョブ、無制限で自動管理されるプロキシネットワーク、およびメールサポートが含まれています。明確なコスト見積もりのために、ウェブサイトは計算機を提供しています。たとえば、1か月に10,000ページをクロールすると、約20ドルかかります。このモデルは、コストが使用量に正比例するため、小規模な実験から大規模なデータ操作まで、あらゆる規模のプロジェクトに最適です。また、プラットフォームでは、ユーザーが購入前にサービスを試すことができ、これはおそらく新規アカウントへの無料クレジットの割り当てを通じて行われます。
分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。
市場での可視性の差を正しく示すため、同じ尺度で比較しています。
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇧🇷Brazil | 27.03% | 439 |
| 🇨🇭Switzerland | 25.81% | 419 |
| 🇮🇳India | 25.7% | 417 |
| 🇦🇹Austria | 15.65% | 254 |
| 🇺🇸United States | 5.81% | 94 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 49.13% | 2.7K |
| 🇩🇪Germany | 20.9% | 1.1K |
| 🇮🇳India | 14.85% | 809 |
| 🇻🇳Vietnam | 12.23% | 666 |
| 🇦🇺Australia | 2.89% | 157 |
評価や反応は参考指標であり、製品適合性そのものではありません。
はい、Foxscrapeは最新のウェブサイトをスクレイピングするように設計されています。APIリクエストで`render_js`パラメータを有効にすると、サービスはヘッドレスChromeインスタンスを使用して、React、Vue、Angularなどのフレームワークで構築されたサイトを完全にレンダリングし、動的コンテンツを抽出できます。
REST APIエンドポイントにHTTPリクエストを送信することでFoxscrapeを統合できます。ドキュメントによると、`Authorization`ヘッダーにAPIキーをBearerトークンとして含める必要があります(例:`Authorization: Bearer YOUR_API_KEY`)。ドキュメントには、cURLおよびJavaScriptの`fetch` APIの例が提供されており、迅速に開始できます。
Foxscrapeは、大規模で地理的に分散したプレミアムプロキシプールを活用する自動プロキシローテーションシステムを採用しています。この機能はリクエストのIPアドレスを自動的にローテーションし、ターゲットウェブサイトからのレート制限、CAPTCHA、IP禁止に遭遇する可能性を大幅に低減します。
Foxscrape APIは、標準のHTTPステータスコードを使用してリクエストの結果を示します。ドキュメントによると、成功したリクエストは`200`ステータスコードを返します。エラーは、`400`(不正なリクエスト - パラメータの欠落/無効)、`401`(無効なAPIキー)、または`500`(内部サーバーエラー)などのコードで示されます。
Foxscrapeは2つの主要な有料プランを提供しています。Starterプランは月額20ドルで150,000 APIクレジットと20の同時リクエスト、Proプランは月額79ドルで1,000,000 APIクレジットと100の同時リクエストです。また、クレジットカード不要で新規ユーザーに1,000 APIクレジットを提供する無料トライアルもあります。
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.