ToolMage
ログイン

AI TOOL COMPARISON

UseScraper vs Webcrawlerapi

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

UseScraper 製品概要

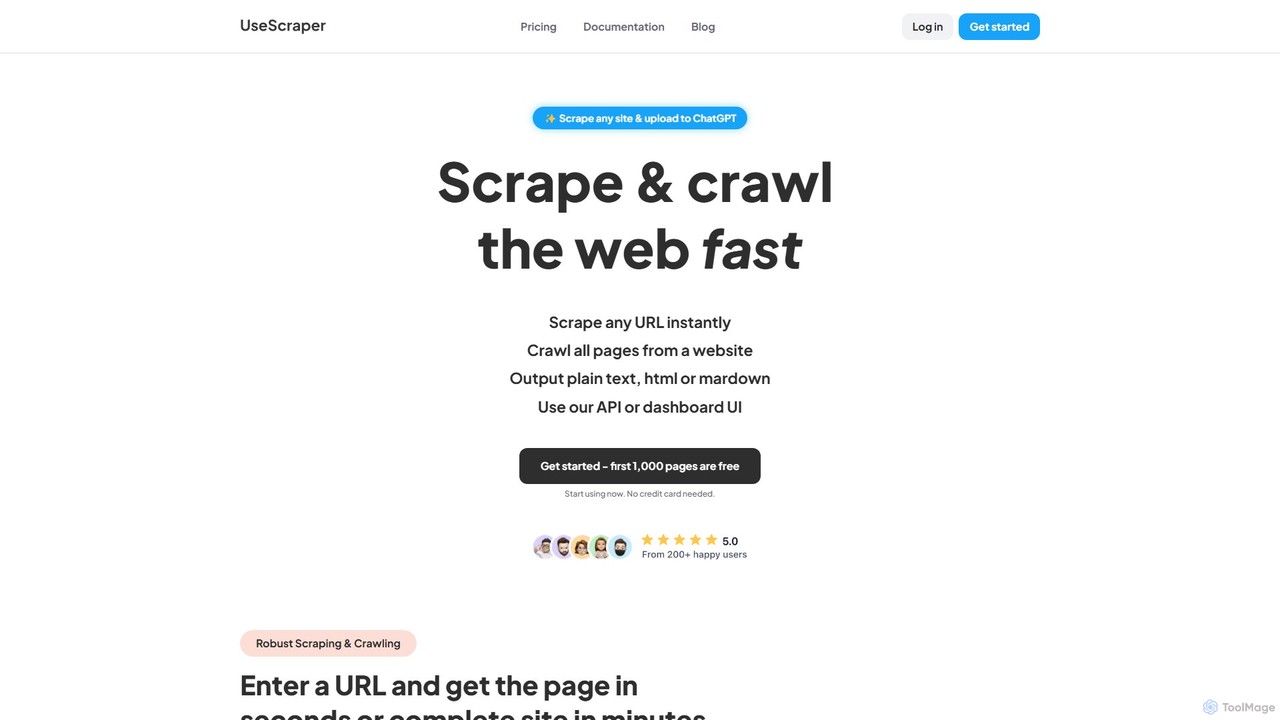
UseScraperは、開発者やAIアプリケーション向けに設計された強力なウェブクローラーおよびスクレイパーAPIです。あらゆるウェブサイトから効率的にデータを抽出し、完全なJavaScriptレンダリング、自動スケーリングインフラ、そしてChatGPTのようなLLMへのデータ供給に最適なクリーンなMarkdownなどの出力形式を特長としています。

Preview

Webcrawlerapi 製品概要

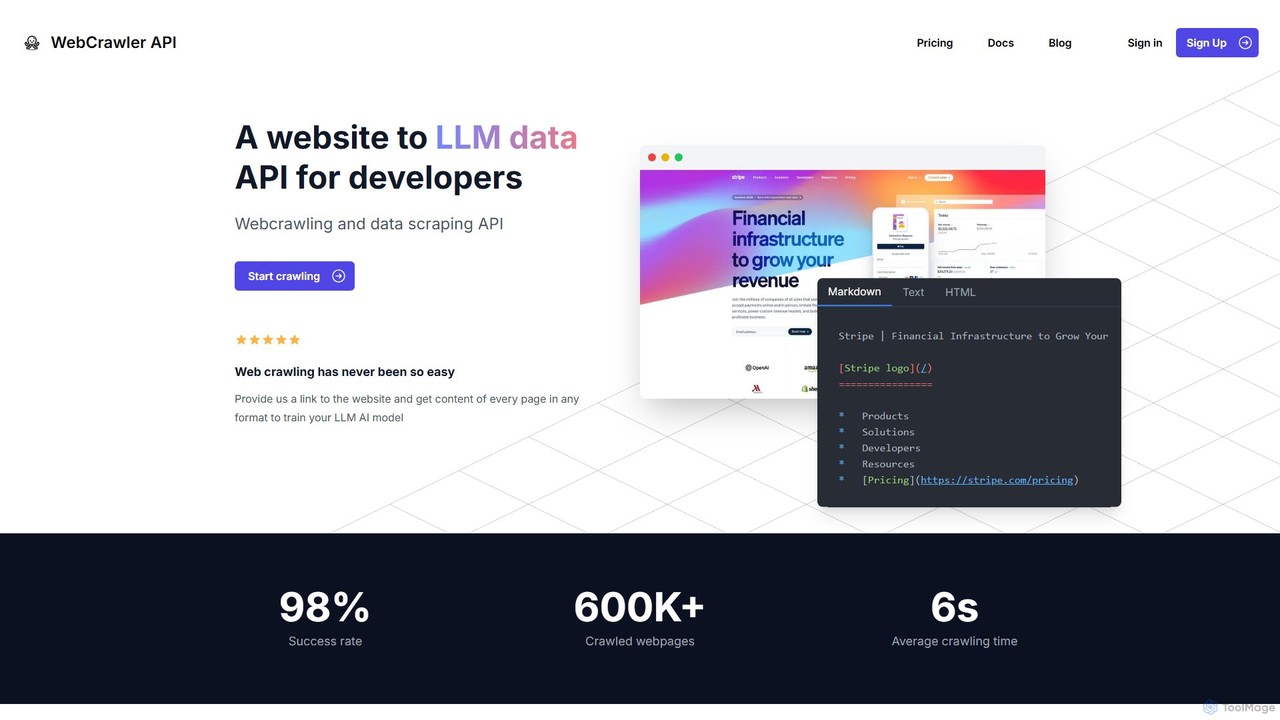
Webcrawlerapiは、開発者が簡単にウェブサイトをクロールし、クリーンなデータを抽出できるように設計された強力なAPIです。JavaScriptのレンダリング、アンチボット対策、データ解析を処理することで、複雑なウェブスクレイピングプロセスを簡素化します。LLM AIモデルのトレーニングや検索拡張生成(RAG)システムのために、Markdownやテキストなどの構造化コンテンツを収集するのに最適で、高い成功率とシンプルな従量課金制の価格モデルを提供します。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

UseScraper VS Webcrawlerapi — 基本情報
基本情報UseScraperWebcrawlerapi
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusデータ抽出データ抽出
対象ユーザーと職種未確認未確認
カテゴリーデータ抽出 · API · 自動化データ抽出 · API · 自動化
Added2025/08/052025/08/02
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

UseScraper

UseScraperは、シンプルかつ強力なAPIを通じて提供される、堅牢でスケーラブルなウェブスクレイピングおよびクローリングサービスです。速度と信頼性を重視してゼロから設計されており、ユーザーは数秒であらゆるウェブページからデータを抽出したり、数分でウェブサイト全体をクロールしたりすることができます。このツールは、市場調査、リードジェネレーション、価格監視、またはAIモデルのトレーニングのためにウェブデータを収集する必要がある開発者、データサイエンティスト、および企業にとって特に価値があります。

このプラットフォームは、現代のウェブの複雑さを処理するように設計されています。実際のChromeブラウザを使用して完全なJavaScriptレンダリングを行い、動的なシングルページアプリケーション(SPA)上のコンテンツが正確にキャプチャされることを保証します。この機能により、静的なHTMLのみを取得する多くの従来のスクレイパーよりも優れています。出力は、生のHTML、プレーンテキスト、そして特にAIシステムや大規模言語モデル(LLM)による処理に理想的な形式である、クリーンで構造化されたMarkdownを含むいくつかの形式で提供できます。

UseScraperの使い方

UseScraperの使用は、あらゆるスキルレベルの開発者にとって簡単です。プロセスはいくつかの簡単なステップで構成されています:

  1. サインアップ: 無料アカウントを作成して開始します。クレジットカードは不要で、サインアップ時に1,000ページの無料スクレイプと25ドルのクレジットが付与されます。
  2. ツールの選択: 単一のURLをスクレイピングするか、ウェブサイト全体をクロールするかを決定します。UseScraperは両方のタスクに専用のAPI(Scraper APIとCrawler API)を提供しています。
  3. APIリクエストの作成: お好みのプログラミング言語(Python、JavaScript、C#など)を使用して、UseScraper APIエンドポイントにリクエストを送信します。ターゲットURLを提供するだけです。
  4. オプションの設定: 特定のURLやCSS要素の除外、通知用のWebhookの設定、希望する出力形式(markdown、text、またはhtml)の選択など、高度なオプションでリクエストをカスタマイズできます。
  5. データの受信: スクレイピングされたコンテンツはAPIレスポンスで返されます。大規模なクロールジョブの場合、結果はAPIを介してアクセスできる専用のデータストアに保存されます。データの自動有効期限を設定してストレージを管理することもできます。

UseScraperの主な機能

  • スクレイパー&クローラーAPI: 単一のページを即座にスクレイピングしたり、ウェブサイトから数千ページをクロールしたりするための専用API。
  • 完全なJavaScriptレンダリング: 実際のChromeブラウザを使用してJavaScriptをレンダリングし、動的なウェブサイトやSPAからの正確なデータ抽出を保証します。
  • AI対応のMarkdown出力: AIアプリケーション、RAGシステム、およびChatGPTなどのLLMへの知識提供に最適な、クリーンで構造化されたMarkdown出力を提供します。プレーンテキストとHTMLも利用可能です。
  • 高速でスケーラブルなインフラ: 毎分何千ものページを超高速で並列にスクレイピングおよびクローリングできる自動スケーリングインフラ上に構築されています。
  • 高度なクローリング制御: 1つのジョブでのマルチサイトクローリング、globパターンによる特定URLの除外、CSSセレクタを使用した反復コンテンツ(ヘッダー/フッターなど)の削除などの機能が含まれます。
  • 自動プロキシローテーション: (近日公開)プロキシを自動的にローテーションして、スクレイピング対策を回避し、レート制限を防ぎ、高い成功率を保証します。
  • Webhook通知: Webhookを介して、クロールジョブのステータスと完了に関するリアルタイムの更新を取得します。
  • 統合データストア: スクレイピングされたデータは、APIを介してアクセス可能なデータストアに保存され、データの自動有効期限を設定するオプションがあります。

UseScraperの使用例

UseScraperは多目的であり、幅広いデータ抽出タスクに適用できます:

  • AIモデルのトレーニング: 大量のウェブコンテンツをスクレイピングして、機械学習モデルのトレーニング用データセットを作成したり、LLMを使用した検索拡張生成(RAG)の知識ベースを構築したりします。
  • 市場および競合分析: 競合他社のウェブサイトから製品情報、価格、レビュー、ニュースを集約して、ビジネス戦略に役立てます。
  • リードジェネレーション: オンラインディレクトリや専門家ネットワークから連絡先の詳細やビジネス情報を抽出します。
  • コンテンツ集約: 複数のソースから自動的にデータを収集して、ニュースポータル、求人掲示板、または不動産リスティングサイトを強化します。
  • SEOおよびマーケティング: SERPやウェブサイトをクロールして、検索エンジンのランキングを監視し、ブランドの言及を追跡し、バックリンクプロファイルを分析します。

UseScraperの利点

UseScraperは、パフォーマンス、現代のウェブとの互換性、および開発者エクスペリエンスに重点を置いている点で際立っています。その主な利点には、JavaScriptを多用するサイトを簡単に処理する能力、AI向けに調整されたクリーンなMarkdown出力の提供、およびスケーラブルで高速なアーキテクチャが含まれます。寛大な無料利用枠を含む柔軟な価格設定モデルにより、小規模なスクリプトから大規模なエンタープライズデータ操作まで、あらゆる規模のプロジェクトで利用しやすくなっています。

料金プラン

UseScraperは、透明でスケーラブルな料金体系を提供しています:

  • 従量課金プラン: 月額0ドル。使用した分だけ、ウェブページ1,000ページあたり1ドルの料金で支払います。このプランには、10の同時ジョブ、スクレイパー&クローラーAPI、JavaScriptレンダリングが含まれ、小規模プロジェクトに最適です。最初の1,000ページは無料です。
  • プロプラン: 月額99ドル、加えてウェブページ1,000ページあたり1ドルの使用料。このプランは大規模な運用向けに設計されており、無料プランのすべてに加えて、無制限の同時ジョブ、ウェブサイトごとの無制限のページクロール、高度なプロキシ(近日公開)、および優先サポートが含まれます。

新規ユーザーはサインアップ時に25ドルの無料クレジットを受け取り、テストと開発のための十分な出発点を提供します。

Webcrawlerapi

Webcrawlerapiは、開発者向けにウェブクローリングとデータ抽出のプロセスを合理化するために設計された専門APIです。データが大規模言語モデル(LLM)のトレーニングやAIアプリケーションの動力源として不可欠な時代において、従来のウェブスクレイピングは大きな課題を抱えています。これには、動的なJavaScriptレンダリングコンテンツの処理、高度なアンチボットシステムの回避、プロキシの管理、乱雑なHTMLを使用可能な形式にクリーニングすることが含まれます。Webcrawlerapiは、これらすべての複雑さを抽象化し、あらゆるウェブサイトを構造化されたデータソースに変えるためのシンプルかつ強力なインターフェースを提供します。

報告されている98%の成功率と平均6秒のクロール時間により、このサービスは効率性と信頼性のために構築されています。これにより、開発者はスケーラブルなクローリングインフラの構築と維持の複雑さにとらわれることなく、コアアプリケーションのロジックに集中できます。リンクを提供するだけで、開発者はMarkdown、テキスト、または生のHTMLなどのクリーンですぐに使えるコンテンツを受け取ることができ、AIモデルのトレーニングパイプラインやRAGシステムのナレッジベースに供給するのに最適です。

Webcrawlerapiの使い方

Webcrawlerapiをプロジェクトに統合するのは非常に簡単です。プロセスは通常、数行のコードで完了します。まず、Webcrawlerapiのウェブサイトでサインアップして、一意のAPIアクセスキーを取得する必要があります。次に、人気のあるプログラミング言語用に提供されているクライアントライブラリのいずれかを使用できます。

たとえば、NodeJS環境では、まずnpmを介してクライアントライブラリをインストールします:npm i webcrawlerapi-js。次に、コードでライブラリをインポートし、APIキーを使用して新しいクライアントインスタンスを作成し、`crawl`メソッドを呼び出します。このメソッドは、ターゲット`url`、希望する`scrape_type`(例:「markdown」)、および`items_limit`などのオプションの制限などのパラメータを取ります。その後、APIはバックグラウンドでクローリングプロセス全体を処理し、抽出されたデータを含む構造化されたJSONレスポンスを返します。Python、PHP、.NETでも同様の簡単な統合パターンが利用可能で、幅広い開発者がアクセスしやすくなっています。

Webcrawlerapiの主な機能

  • 自動リンク処理: APIはウェブサイト上のすべての内部リンクをインテリジェントに検出し管理し、重複を自動的に処理しURLをクリーニングしながら、包括的なクローリングを保証します。
  • 高度なJavaScriptレンダリング: 安定した堅牢なシステムを使用して動的なクライアントサイドコンテンツを効果的にレンダリングし、PuppeteerやPlaywrightなどのツールにしばしば関連する不安定性やメモリの問題を克服します。
  • 堅牢なアンチボット回避: Webcrawlerapiには、CAPTCHA、IPブロック、レート制限、その他の一般的なアンチボット防御に対処するための組み込みメカニズムがあり、高い成功率を保証します。
  • 自動データクリーニング: 生の複雑なHTMLをMarkdownやプレーンテキストなどのクリーンで構造化された形式に変換する強力な解析ルールが含まれており、開発者の後処理時間を大幅に節約します。
  • スケーラブルなインフラストラクチャ: このサービスは、分散されたクローラーとプロキシのインフラストラクチャを管理し、基盤となるハードウェアやネットワーク管理を心配することなく、データ抽出作業を数ページから数百万ページにスケールアップできます。
  • 開発者フレンドリーなAPIとSDK: NodeJS、Python、PHP、.NETなどの主要言語向けのシンプルなAPIと公式クライアントライブラリを、明確なドキュメントとともに提供します。

Webcrawlerapiの使用例

Webcrawlerapiは多用途であり、さまざまなデータ集約型のタスクに適用できます。その主な使用例は、AIとデータ分析を中心に展開されます。

  • LLMトレーニングデータ収集: ウェブサイト、ブログ、フォーラムを体系的にクロールし、カスタム大規模言語モデルのトレーニングやファインチューニングのために、大量の高品質でドメイン固有のテキストデータを収集します。
  • 検索拡張生成(RAG): RAGシステムの最新のナレッジベースを構築および維持します。製品ドキュメント、ヘルプセンター、ニュースサイトをクロールして、ユーザーのクエリに回答するための正確でリアルタイムの情報をLLMに提供します。
  • 市場調査と競合分析: 競合他社のウェブサイトから製品詳細、価格情報、顧客レビュー、マーケティングコンテンツを自動的に抽出し、戦略的な洞察を得ます。
  • コンテンツ集約: 複数のソースを定期的にクロールし、データを統一プラットフォームに統合することで、ニュースアグリゲーター、求人掲示板、不動産リスティングサイトを強化します。

Webcrawlerapiの利点

Webcrawlerapiの主な利点は、そのシンプルさと効率性です。これにより、開発チームはウェブクローリングのインフラ全体とメンテナンスの負担を外部に委託できます。これは、データ駆動型製品の市場投入までの時間を短縮することを意味します。高い成功率(98%)と堅牢なアンチボット機能により、データパイプラインの信頼性が確保されます。さらに、透明性の高い従量課金制の価格モデルは非常に費用対効果が高く、成功したリクエストに対してのみ支払うため、サブスクリプションや自社ソリューションの構築に関連するリスクとオーバーヘッドを排除します。

料金プラン

Webcrawlerapiは、サブスクリプションや隠れた料金を完全に排除した、直接的で透明性の高い「使用量に応じた支払い」の価格モデルを採用しています。コストは、毎月正常にクロールしたページの数に基づいて計算されます。このサービスの価格には、無制限のクロールジョブ、無制限で自動管理されるプロキシネットワーク、およびメールサポートが含まれています。明確なコスト見積もりのために、ウェブサイトは計算機を提供しています。たとえば、1か月に10,000ページをクロールすると、約20ドルかかります。このモデルは、コストが使用量に正比例するため、小規模な実験から大規模なデータ操作まで、あらゆる規模のプロジェクトに最適です。また、プラットフォームでは、ユーザーが購入前にサービスを試すことができ、これはおそらく新規アカウントへの無料クレジットの割り当てを通じて行われます。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
データ抽出API自動化
のみ UseScraper
確認済みデータなし
のみ Webcrawlerapi
確認済みデータなし

タグ

共通
API自動化データ収集データ抽出JavaScript レンダリング検索拡張生成
のみ UseScraper
AIデータChatGPT開発者ツールマークダウンウェブクローラーWebスクレイピング
のみ Webcrawlerapi
データスクレイピング開発者ツールLLMトレーニングウェブクローリング

対象ユーザーと職種

共通
確認済みデータなし
のみ UseScraper
確認済みデータなし
のみ Webcrawlerapi
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

UseScraper

未確認

Webcrawlerapi monthly traffic:

Latest traffic · 2026-05

月間訪問数
5.4K
平均滞在時間
0:46
訪問あたりページ数
1.95
直帰率
41.65%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.1K
  • 2026-01: 4.5K
  • 2026-02: 4K
  • 2026-03: 4.3K
  • 2026-04: 5.6K
  • 2026-05: 5.4K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States49.13%2.7K
🇩🇪Germany20.9%1.1K
🇮🇳India14.85%809
🇻🇳Vietnam12.23%666
🇦🇺Australia2.89%157

検索キーワード

better to save as an html or md file packing more informationdata scraping law casesfirecrawl alternativesllms txt generator onlinesubmit website to chatgpt

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

UseScraper

評価
未確認
コメント
0
お気に入り
188
いいね
166

Webcrawlerapi

評価
未確認
コメント
0
お気に入り
182
いいね
179

UseScraper vs Webcrawlerapi · 比較 FAQ

What do UseScraper and Webcrawlerapi have in common?
Both tools are listed under データ抽出、API、自動化. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are UseScraper and Webcrawlerapi free?
Listed pricing models: UseScraper — Freemium; Webcrawlerapi — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between UseScraper and Webcrawlerapi?
The primary listed category is データ抽出 for UseScraper, and データ抽出 for Webcrawlerapi. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較