

Webcrawlerapi Overview
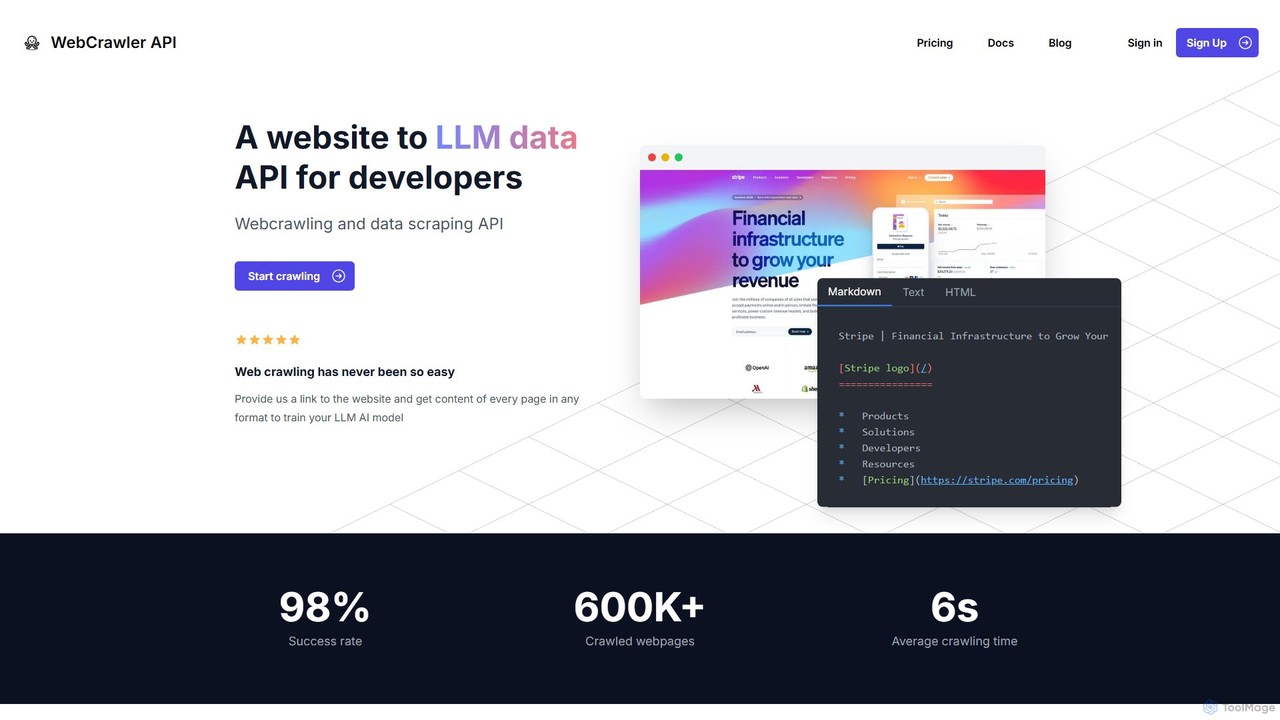
Webcrawlerapiは、開発者向けにウェブクローリングとデータ抽出のプロセスを合理化するために設計された専門APIです。データが大規模言語モデル(LLM)のトレーニングやAIアプリケーションの動力源として不可欠な時代において、従来のウェブスクレイピングは大きな課題を抱えています。これには、動的なJavaScriptレンダリングコンテンツの処理、高度なアンチボットシステムの回避、プロキシの管理、乱雑なHTMLを使用可能な形式にクリーニングすることが含まれます。Webcrawlerapiは、これらすべての複雑さを抽象化し、あらゆるウェブサイトを構造化されたデータソースに変えるためのシンプルかつ強力なインターフェースを提供します。
報告されている98%の成功率と平均6秒のクロール時間により、このサービスは効率性と信頼性のために構築されています。これにより、開発者はスケーラブルなクローリングインフラの構築と維持の複雑さにとらわれることなく、コアアプリケーションのロジックに集中できます。リンクを提供するだけで、開発者はMarkdown、テキスト、または生のHTMLなどのクリーンですぐに使えるコンテンツを受け取ることができ、AIモデルのトレーニングパイプラインやRAGシステムのナレッジベースに供給するのに最適です。
Webcrawlerapiの使い方
Webcrawlerapiをプロジェクトに統合するのは非常に簡単です。プロセスは通常、数行のコードで完了します。まず、Webcrawlerapiのウェブサイトでサインアップして、一意のAPIアクセスキーを取得する必要があります。次に、人気のあるプログラミング言語用に提供されているクライアントライブラリのいずれかを使用できます。
たとえば、NodeJS環境では、まずnpmを介してクライアントライブラリをインストールします:npm i webcrawlerapi-js。次に、コードでライブラリをインポートし、APIキーを使用して新しいクライアントインスタンスを作成し、`crawl`メソッドを呼び出します。このメソッドは、ターゲット`url`、希望する`scrape_type`(例:「markdown」)、および`items_limit`などのオプションの制限などのパラメータを取ります。その後、APIはバックグラウンドでクローリングプロセス全体を処理し、抽出されたデータを含む構造化されたJSONレスポンスを返します。Python、PHP、.NETでも同様の簡単な統合パターンが利用可能で、幅広い開発者がアクセスしやすくなっています。
Webcrawlerapiの主な機能
- 自動リンク処理: APIはウェブサイト上のすべての内部リンクをインテリジェントに検出し管理し、重複を自動的に処理しURLをクリーニングしながら、包括的なクローリングを保証します。
- 高度なJavaScriptレンダリング: 安定した堅牢なシステムを使用して動的なクライアントサイドコンテンツを効果的にレンダリングし、PuppeteerやPlaywrightなどのツールにしばしば関連する不安定性やメモリの問題を克服します。
- 堅牢なアンチボット回避: Webcrawlerapiには、CAPTCHA、IPブロック、レート制限、その他の一般的なアンチボット防御に対処するための組み込みメカニズムがあり、高い成功率を保証します。
- 自動データクリーニング: 生の複雑なHTMLをMarkdownやプレーンテキストなどのクリーンで構造化された形式に変換する強力な解析ルールが含まれており、開発者の後処理時間を大幅に節約します。
- スケーラブルなインフラストラクチャ: このサービスは、分散されたクローラーとプロキシのインフラストラクチャを管理し、基盤となるハードウェアやネットワーク管理を心配することなく、データ抽出作業を数ページから数百万ページにスケールアップできます。
- 開発者フレンドリーなAPIとSDK: NodeJS、Python、PHP、.NETなどの主要言語向けのシンプルなAPIと公式クライアントライブラリを、明確なドキュメントとともに提供します。
Webcrawlerapiの使用例
Webcrawlerapiは多用途であり、さまざまなデータ集約型のタスクに適用できます。その主な使用例は、AIとデータ分析を中心に展開されます。
- LLMトレーニングデータ収集: ウェブサイト、ブログ、フォーラムを体系的にクロールし、カスタム大規模言語モデルのトレーニングやファインチューニングのために、大量の高品質でドメイン固有のテキストデータを収集します。
- 検索拡張生成(RAG): RAGシステムの最新のナレッジベースを構築および維持します。製品ドキュメント、ヘルプセンター、ニュースサイトをクロールして、ユーザーのクエリに回答するための正確でリアルタイムの情報をLLMに提供します。
- 市場調査と競合分析: 競合他社のウェブサイトから製品詳細、価格情報、顧客レビュー、マーケティングコンテンツを自動的に抽出し、戦略的な洞察を得ます。
- コンテンツ集約: 複数のソースを定期的にクロールし、データを統一プラットフォームに統合することで、ニュースアグリゲーター、求人掲示板、不動産リスティングサイトを強化します。
Webcrawlerapiの利点
Webcrawlerapiの主な利点は、そのシンプルさと効率性です。これにより、開発チームはウェブクローリングのインフラ全体とメンテナンスの負担を外部に委託できます。これは、データ駆動型製品の市場投入までの時間を短縮することを意味します。高い成功率(98%)と堅牢なアンチボット機能により、データパイプラインの信頼性が確保されます。さらに、透明性の高い従量課金制の価格モデルは非常に費用対効果が高く、成功したリクエストに対してのみ支払うため、サブスクリプションや自社ソリューションの構築に関連するリスクとオーバーヘッドを排除します。
料金プラン
Webcrawlerapiは、サブスクリプションや隠れた料金を完全に排除した、直接的で透明性の高い「使用量に応じた支払い」の価格モデルを採用しています。コストは、毎月正常にクロールしたページの数に基づいて計算されます。このサービスの価格には、無制限のクロールジョブ、無制限で自動管理されるプロキシネットワーク、およびメールサポートが含まれています。明確なコスト見積もりのために、ウェブサイトは計算機を提供しています。たとえば、1か月に10,000ページをクロールすると、約20ドルかかります。このモデルは、コストが使用量に正比例するため、小規模な実験から大規模なデータ操作まで、あらゆる規模のプロジェクトに最適です。また、プラットフォームでは、ユーザーが購入前にサービスを試すことができ、これはおそらく新規アカウントへの無料クレジットの割り当てを通じて行われます。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 5.1K
- 2026-1: 4.5K
- 2026-2: 4.0K
- 2026-3: 4.3K
- 2026-4: 5.6K
- 2026-5: 5.4K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国49.1%
- 🇩🇪ドイツ20.9%
- 🇮🇳インド14.8%
- 🇻🇳ベトナム12.2%
- 🇦🇺オーストラリア2.9%
Top keywords
| Keyword | Cost per click |
|---|---|
| better to save as an html or md file packing more information | $0.00 |
| data scraping law cases | $0.00 |
| firecrawl alternatives | $11.71 |
| llms txt generator online | $0.00 |
| submit website to chatgpt | $0.00 |
Webcrawlerapi Alternatives
UseScraper
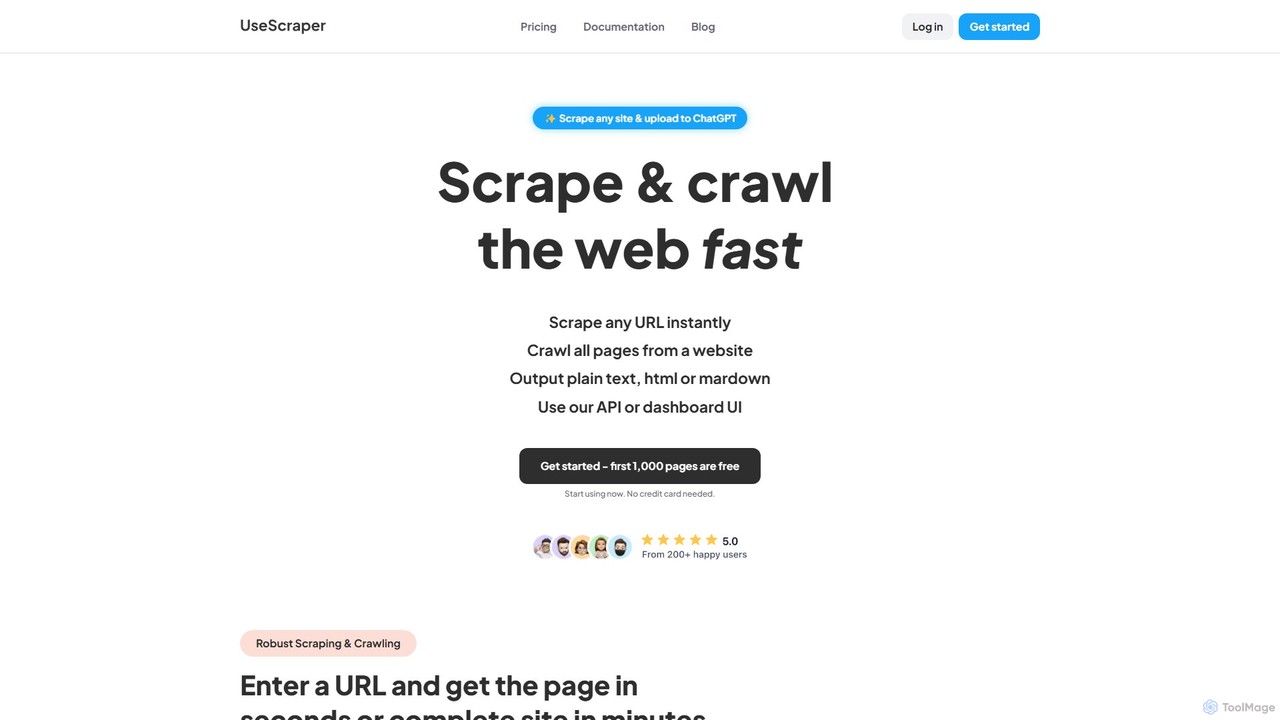
UseScraperは、開発者やAIアプリケーション向けに設計された強力なウェブクローラーおよびスクレイパーAPIです。あらゆるウェブサイトから効率的にデータを抽出し、完全なJavaScriptレンダリング、自動スケーリングインフラ、そしてChatGPTのようなLLMへのデータ供給に最適なクリーンなMarkdownなどの出力形式を特長としています。
データ抽出
instantapi
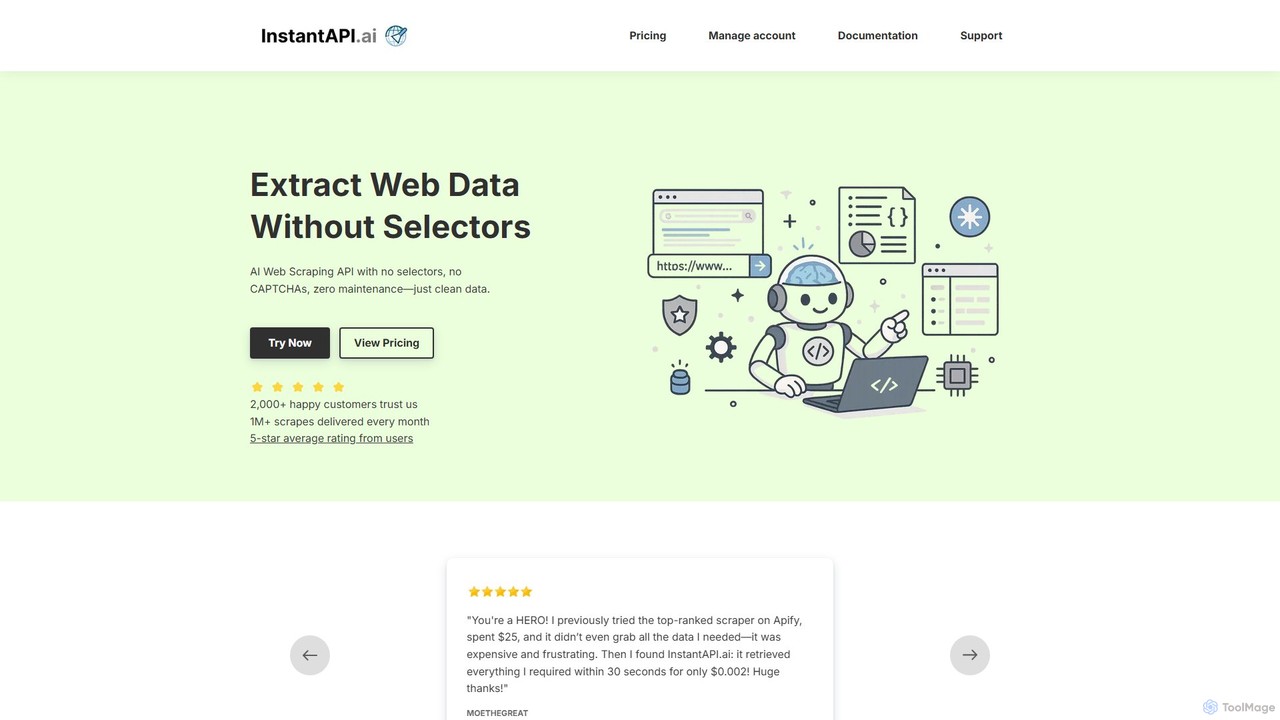
instantapiは、シンプルさとスピードを追求して設計されたAI搭載のウェブスクレイピングAPIです。ユーザーは複雑なコーディングや手動設定なしに、単一のAPIコールで任何のウェブサイトから構造化データを抽出できます。従来のウェブスクレイパーの手間をかけずに、高速で手頃な価格の信頼性の高いデータ抽出を必要とする開発者、データアナリスト、ビジネスに最適です。
データ抽出
Webcrawlerapi Categories
Webcrawlerapi Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
UseScraper
UseScraperは、開発者やAIアプリケーション向けに設計された強力なウェブクローラーおよびスクレイパーAPIです。あらゆるウェブサイトから効率的にデータを抽出し、完全なJavaScriptレンダリング、自動スケーリングインフラ、そしてChatGPTのようなLLMへのデータ供給に最適なクリーンなMarkdownなどの出力形式を特長としています。
データ抽出
Scrapeless
開発者やビジネス向けのAI搭載ウェブスクレイピングツールキットです。スクレイピングブラウザ、ユニバーサルスクレイピングAPI、ディープSERP APIなどの一連のツールを提供し、大規模な公開ウェブデータを簡単に抽出します。アンチボット対策の回避に特化し、Eコマース、市場調査、AIモデルのトレーニング用に構造化データを提供し、信頼性と使いやすさを重視しています。
スクレイピング
URLtoText
URLtoTextは、あらゆるウェブサイトやPDFからクリーンで構造化されたテキストを抽出するAI搭載ツールです。広告、サイドバー、その他の不要な要素をインテリジェントに除去し、主要なコンテンツのみを提供します。JavaScriptレンダリング、住宅用IPプロキシ、開発者APIを備え、静的および動的なウェブページから信頼性の高いデータ抽出を必要とする研究者、開発者、ビジネス向けに設計されています。
コンテンツキュレーション
WebScraping.AI
WebScraping.AIは、AIを活用してウェブスクレイピングを簡素化する開発者向けの高度なAPIです。ローテーションプロキシ、JavaScriptレンダリング、ジオターゲティング機能を備え、ブロックを回避して動的コンテンツにアクセスします。その中核的な強みはLLM搭載ツールにあり、非構造化データを抽出し、要約を生成し、ウェブページから直接質問に答えることで、あらゆるプロジェクトのデータ収集を効率化します。
データ抽出
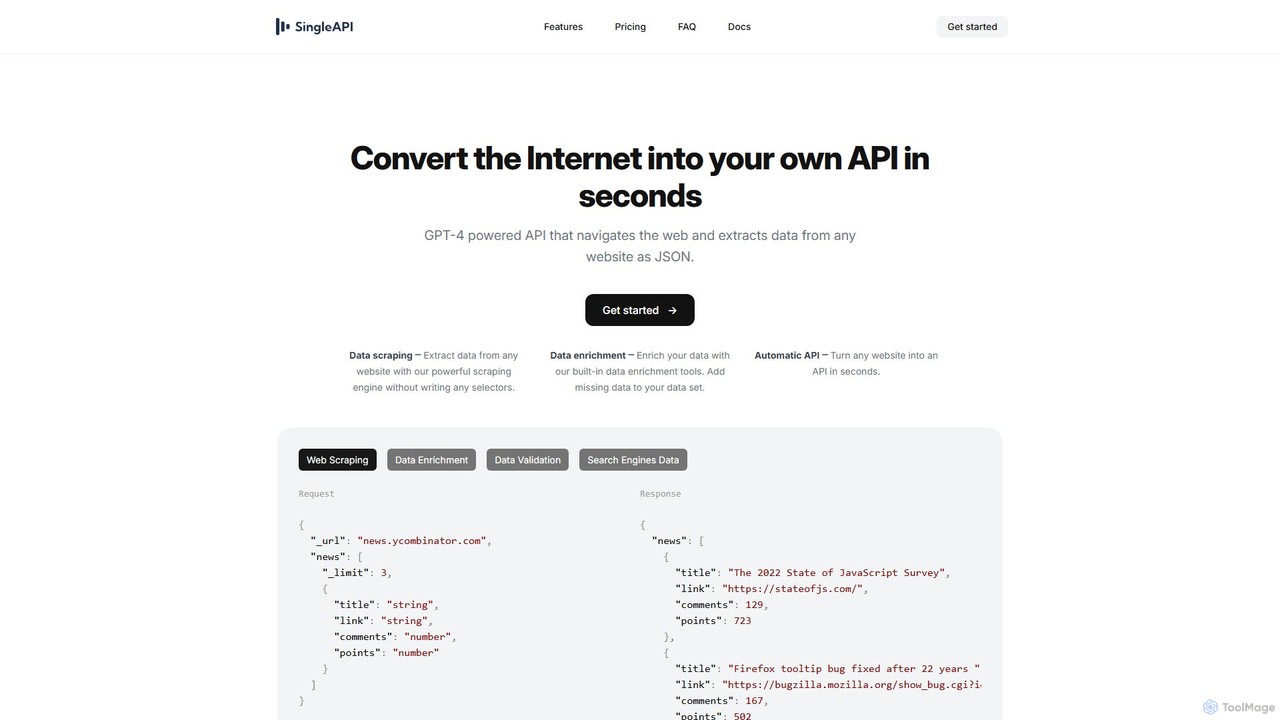
SingleAPI
SingleAPIは、GPT-4を搭載したツールで、あらゆるウェブサイトを即座に構造化されたJSON APIに変換します。コードやセレクタを記述することなく、ウェブスクレイピング、データ抽出、データエンリッチメントを簡素化し、ユーザーが様々なアプリケーションのためにウェブデータに簡単にアクセスできるようにします。
ウェブスクレイピング
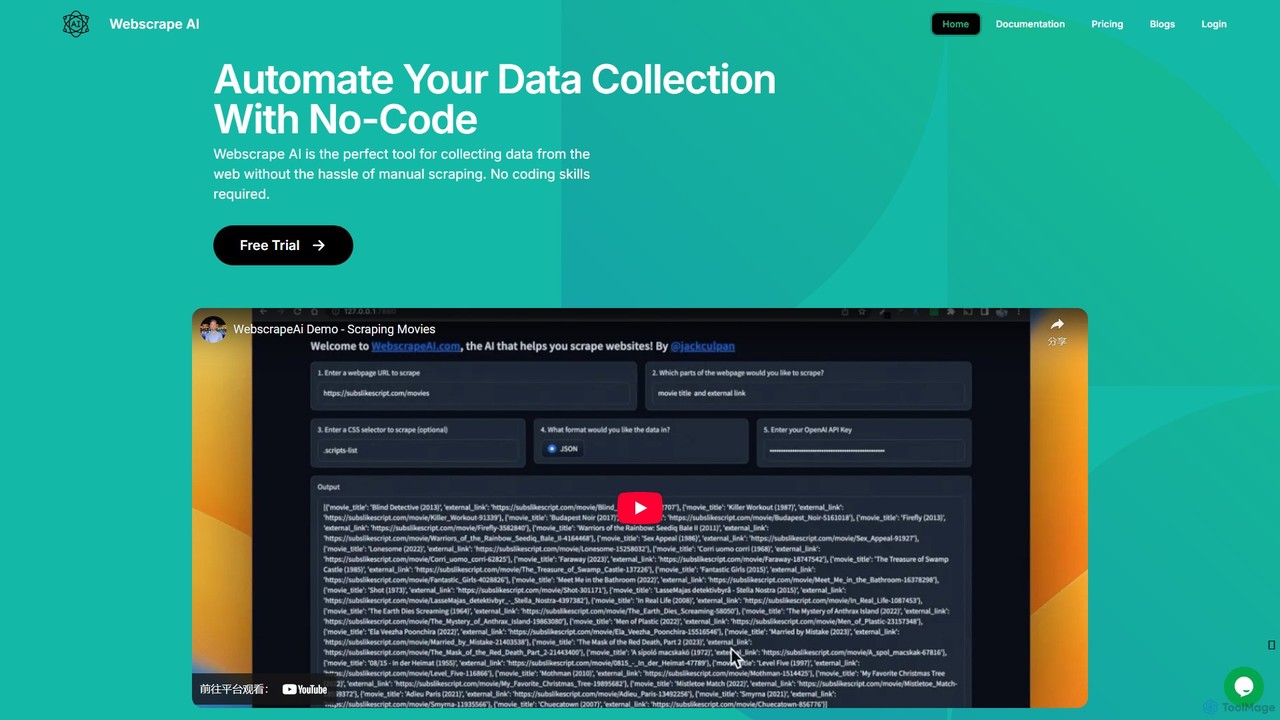
webscrapeai
WebscrapeAIは、ウェブデータ収集を自動化するために設計された、ノーコードのAI搭載プラットフォームです。URLを提供し、必要なデータを指定するだけで、AIがスクレイピングプロセス全体を処理します。動的ウェブサイト、一括スクレイピング、プロキシ統合をサポートし、開発者向けのAPIも提供しており、データ抽出を迅速、正確、そして誰にでも利用可能にします。
ウェブスクレイピング
Webcrawlerapi Comments (0)
Sign in to comment.
ログインNo comments yet.