

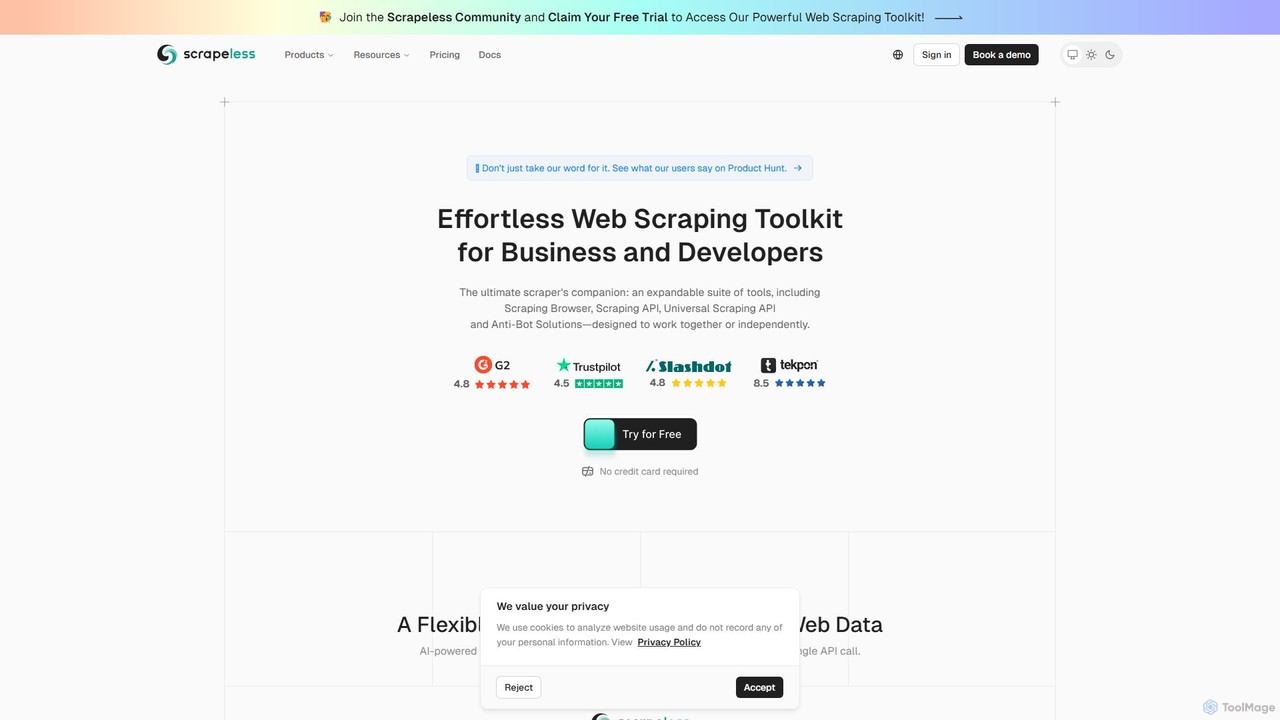
Scrapeless Overview
Scrapelessは、企業や開発者のためのデータ抽出を簡素化し、スケールさせるために設計された、先進的なAI駆動のウェブスクレイピングプラットフォームです。単一のツールではなく、スクレイピングブラウザ、ユニバーサルスクレイピングAPI、および専門のディープSERP APIからなる柔軟なツールキットです。このスイートは、単純なデータ収集から複雑なアンチボット対策まで、あらゆるものに対応できるように設計されており、公開ウェブデータへのシームレスなアクセスを保証します。AIを活用することで、Scrapelessはブロックの回避、コンテンツの解析、構造化された実用的なデータの提供プロセスを自動化し、信頼性の高いウェブ情報を必要とするすべての人にとって不可欠なパートナーとなります。
Scrapelessの使い方
Scrapelessの使用は、シンプルなAPIインターフェースを通じて強力なスクレイピング機能を統合するように設計されており、直感的なプロセスです。典型的なワークフローは次のとおりです。
1. サインアップしてAPIキーを取得: Scrapelessのウェブサイトで無料アカウントに登録します。トライアルにクレジットカードは不要で、ダッシュボードからすぐに個人用のAPIキーにアクセスできます。
2. 適切なツールを選択: ニーズに応じて適切なサービスを選択します。一般的なウェブサイトの汎用スクレイピングにはユニバーサルスクレイピングAPIを使用します。ターゲットを絞ったリアルタイムの構造化された検索エンジン結果の抽出には、ディープSERP APIを選択します。JavaScriptが多用され、複雑なアンチボット対策が施されているウェブサイトには、スクレイピングブラウザが理想的な選択肢です。
3. コードに統合: ダッシュボードで提供されているコード例を使用して、Scrapelessをアプリケーションに統合します。Python、Node.js、Java、Goなど、すべての主要なプログラミング言語と完全に互換性があります。
4. APIコールを実行: ターゲットURLと、SERPクエリの地理的位置やセッション管理設定など、必要な特定のパラメータを含むAPIリクエストを作成します。
5. Scrapelessに任せる: リクエストが送信されると、Scrapelessがバックグラウンドですべての複雑な処理を行います。これには、広大なプロキシネットワークの管理、IPアドレスのローテーション、CAPTCHAの解決、人間の行動を模倣してブロックを回避するための実際のブラウザフィンガープリントの使用が含まれます。
6. 構造化データを受信: アプリケーション、データベース、またはAIモデルですぐに使用できる、クリーンで構造化されたJSON形式のデータを受け取ります。成功したリクエストに対してのみ料金が発生するため、コスト効率が保証されます。
Scrapelessの主な機能
- AI搭載ユニバーサルスクレイピングAPI: 単一のAPIコールで、あらゆる公開ウェブサイトを大規模にスクレイピングします。JavaScriptのレンダリング、セッションの永続化、カスタムTLSフィンガープリントをインテリジェントに処理し、動的コンテンツにアクセスします。
- スクレイピングブラウザ: 組み込みの実際のユーザーフィンガープリントと人間のようなインタラクションパターンを備えたヘッドレスブラウザサービスで、検出されることなく最も困難なウェブサイトをナビゲートしてスクレイピングします。Chrome DevTools Protocol(CDP)を介して制御できます。
- ディープSERP API: Googleやその他の検索エンジンからリアルタイムで構造化されたデータを抽出するための専門の高速APIです。正確な検索のために20以上のカスタムパラメータをサポートし、SEOモニタリング、ランキング追跡、LLMおよびRAGアプリケーションへのデータ提供に最適です。
- 高度なアンチボット回避: CAPTCHA、IPブロック、ブラウザフィンガープリントなど、一般的および高度なアンチスクレイピング技術を自動的にバイパスするための洗練されたAI駆動システムを使用する、プラットフォームの核となる強みです。
- エンタープライズ級ソリューション: カスタマイズされたデータスクレイピングソリューション、高並行性インフラ、データクリーニングおよび変換サービス、APIを介したリアルタイムデータプッシュ、ミッションクリティカルなプロジェクト向けのエンタープライズレベルのサービスレベルアグリーメント(SLA)を提供します。
- 開発者フレンドリーなエコシステム: すべての主要なプログラミング言語およびツールと完全に互換性があります。プラットフォームは、スムーズな統合体験を保証するために、ユーザーダッシュボードで直接、包括的なドキュメントとすぐに使えるコード例を提供します。
Scrapelessの使用例
Scrapelessは、さまざまな業界や機能に適用できる多目的なツールです。
• Eコマース&市場インテリジェンス: 競合他社の製品価格の追跡、在庫レベルの監視、価格戦略の分析、あらゆるEコマースプラットフォームやマーケットプレイスからの顧客レビューの集約。
• SEO&コンテンツ戦略: ディープSERP APIを利用して、リアルタイムでキーワードのランキングを監視し、SERPの機能を分析し、ブランドの言及を追跡し、コンテンツの機会を発見します。
• AIと機械学習: 大規模言語モデル(LLM)および検索拡張生成(RAG)システムに、ウェブ全体から新鮮で構造化された関連データを提供し、AI駆動の洞察の正確性と適時性を向上させます。
• リードジェネレーション: ビジネスディレクトリ、専門家ネットワーク、企業ウェブサイトから連絡先情報、会社詳細、その他の関連データを体系的に抽出し、ターゲットを絞ったリードリストを作成します。
• 金融データ分析: さまざまなオンラインソースからリアルタイムの株式市場データ、金融ニュース、経済指標を収集し、市場動向分析を行い、投資戦略に情報を提供します。
Scrapelessの利点
このプラットフォームは、いくつかの主要な利点を通じて明確な競争優位性を提供します。
• シンプルさとスピード: 単一の統一されたAPIは、プロキシ、ヘッドレスブラウザ、パーサーの複雑なインフラストラクチャを構築および維持する必要性をなくし、大幅な開発時間と運用オーバーヘッドを節約します。
• 高い成功率: インテリジェントなAI駆動のアンチボット技術は、一貫して高い成功リクエスト率を保証し、失敗、再試行、データギャップを最小限に抑えます。
• コスト効率: 「成功報酬型」モデルにより、ユーザーは正常に取得されたデータに対してのみ課金されるため、投資収益率が最大化され、失敗した試みによる予算の無駄がなくなります。
• 比類のないスケーラビリティ: 堅牢なインフラストラクチャは数百万のリクエストを処理するように設計されており、データ操作を小規模プロジェクトからエンタープライズレベルのワークロードまで簡単にスケールさせることができます。
• 保証されたデータ品質: オプションのデータクリーニングおよび変換サービスにより、受け取るデータが正確で構造化されており、即時の分析と統合に利用できることが保証されます。
• 倫理的で安全: Scrapelessは、データプライバシー、GDPRコンプライアンス、およびウェブスクレイピング技術の倫理的な使用に対する強いコミットメントを示し、信頼できるサービスを提供します。
料金プラン
Scrapelessは、個人の開発者から大企業まで、幅広いユーザーに対応するように設計された、柔軟なフリーミアムおよび使用量ベースの料金モデルで運営されています。
• 無料トライアル: 新規ユーザーはクレジットカードなしでサインアップして無料トライアルを受けることができます。このトライアルでは、ユニバーサルAPIやSERP APIを含むツールスイート全体を完全にテストするための十分なクレジットが提供されます。
• 従量課金制: このプランは、小規模プロジェクトや断続的なスクレイピングニーズを持つユーザーに最適です。必要に応じてクレジットを購入し、成功したAPIコールに対してのみ支払うことができます。APIごとに複雑さに応じてクレジットコストが異なる場合があります。
• サブスクリプションプラン(例:スターター、プロ、ビジネス): 一貫して大量のニーズを持つユーザー向けに、Scrapelessは月額サブスクリプションプランを提供しています。これらのプランは、従量課金制と比較して割引価格で大量のクレジットを提供し、より高い並行性制限、より迅速なサポート、高度な機能などの追加の利点があります。
• エンタープライズプラン: 大規模または独自のデータ要件を持つ企業向けに、エンタープライズプランは完全にカスタマイズされたソリューションを提供します。これには、専用インフラ、カスタムビルドのスクレイパー、データ処理とクリーニング、リアルタイムデータ配信パイプライン、およびパフォーマンスと稼働時間を保証するための包括的なサービスレベルアグリーメント(SLA)が含まれます。
料金は透明で、コストは多くの場合、成功した1,000リクエストごとに計算されるため(例:ディープSERP APIは1,000クエリあたり0.1ドルで宣伝されています)、費用を簡単に予測および管理できます。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2026-1: 167.1K
- 2026-2: 96.1K
- 2026-3: 106.1K
- 2026-4: 91.7K
- 2026-5: 77.0K
Geography
Top 5 countries / regions
- 🇻🇳ベトナム33.2%
- 🇮🇳インド20.8%
- 🇺🇸アメリカ合衆国18.4%
- 🇳🇬ナイジェリア14.7%
- 🇧🇷ブラジル12.9%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 60.2% |
Referral | 39.8% |
Top keywords
| Keyword | Cost per click |
|---|---|
| google ads transparency center | $4.74 |
| scrapeless | $11.04 |
| tamilblasters proxy | $0.43 |
| tamilmv proxy | $2.38 |
| tamilmv unblock | $0.00 |
Scrapeless Videos on YouTube
Scrapeless
Scrapeless Alternatives
Simplescraper
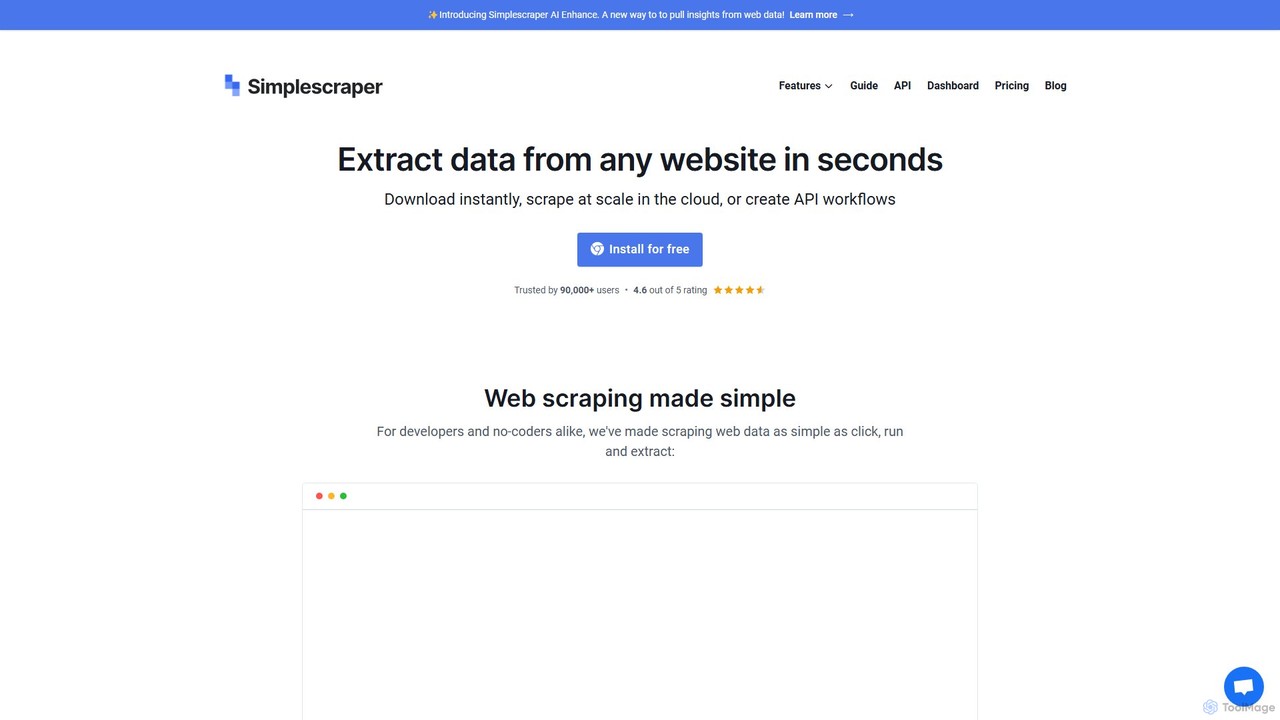
Simplescraperは、あらゆるウェブサイトから数秒でデータを抽出する強力なウェブスクレイピングツールです。コード不要のデータ選択が可能な使いやすいChrome拡張機能、大規模スクレイピングのためのクラウドベースの自動化、簡単なプロンプトで洞察を引き出す革新的なAI Enhance機能を提供します。ウェブサイトを構造化データ(CSV、JSON)や即時APIに変換し、Google SheetsやAirtableなどのツールと連携できます。
ウェブスクレイピング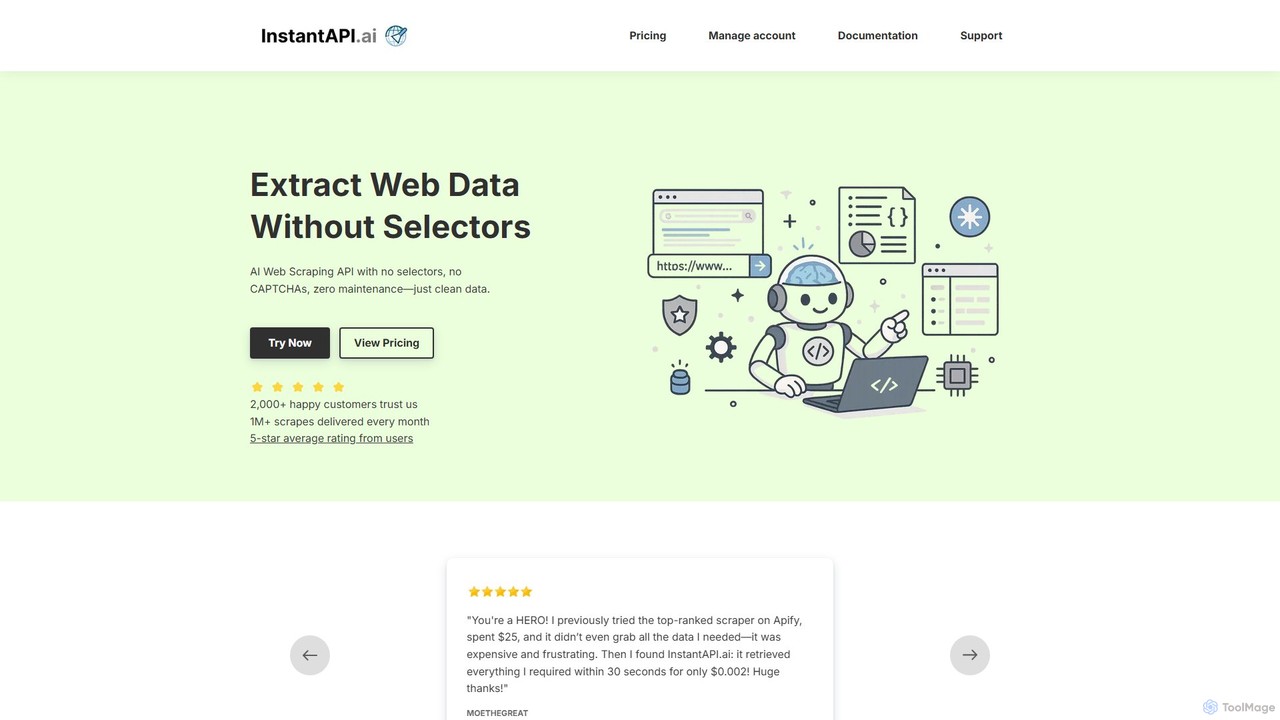
instantapi
instantapiは、シンプルさとスピードを追求して設計されたAI搭載のウェブスクレイピングAPIです。ユーザーは複雑なコーディングや手動設定なしに、単一のAPIコールで任何のウェブサイトから構造化データを抽出できます。従来のウェブスクレイパーの手間をかけずに、高速で手頃な価格の信頼性の高いデータ抽出を必要とする開発者、データアナリスト、ビジネスに最適です。
データ抽出Scrapeless Categories
Scrapeless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

Simplescraper
Simplescraperは、あらゆるウェブサイトから数秒でデータを抽出する強力なウェブスクレイピングツールです。コード不要のデータ選択が可能な使いやすいChrome拡張機能、大規模スクレイピングのためのクラウドベースの自動化、簡単なプロンプトで洞察を引き出す革新的なAI Enhance機能を提供します。ウェブサイトを構造化データ(CSV、JSON)や即時APIに変換し、Google SheetsやAirtableなどのツールと連携できます。
ウェブスクレイピング
instantapi
instantapiは、シンプルさとスピードを追求して設計されたAI搭載のウェブスクレイピングAPIです。ユーザーは複雑なコーディングや手動設定なしに、単一のAPIコールで任何のウェブサイトから構造化データを抽出できます。従来のウェブスクレイパーの手間をかけずに、高速で手頃な価格の信頼性の高いデータ抽出を必要とする開発者、データアナリスト、ビジネスに最適です。
データ抽出
Octoparse
Octoparseは、プログラミング不要で誰でもウェブサイトからデータを抽出できる、強力なノーコードのウェブスクレイピングツールです。視覚的なワークフローデザイナー、簡単な設定を支援するAIアシスタント、人気サイト向けの数百の構築済みテンプレートを備えています。クラウドベースの自動化、IPローテーション、CAPTCHA解決機能により、複雑なスクレイピングタスクを効率的に処理し、ウェブページを見込み客発掘や市場調査のための構造化データに変換します。
ウェブスクレイピング
Kadoa
Kadoaは、AIを搭載したノーコードのウェブスクレイピングプラットフォームで、あらゆるウェブサイトやドキュメントからのデータ抽出を自動化します。ユーザーは数分でスケーラブルで自己修復型のデータパイプラインを構築し、エンジニアリングのボトルネックを解消し、金融、小売、市場インテリジェンスのためのリアルタイムな洞察を得ることができます。
ウェブスクレイピング
Webcrawlerapi
Webcrawlerapiは、開発者が簡単にウェブサイトをクロールし、クリーンなデータを抽出できるように設計された強力なAPIです。JavaScriptのレンダリング、アンチボット対策、データ解析を処理することで、複雑なウェブスクレイピングプロセスを簡素化します。LLM AIモデルのトレーニングや検索拡張生成(RAG)システムのために、Markdownやテキストなどの構造化コンテンツを収集するのに最適で、高い成功率とシンプルな従量課金制の価格モデルを提供します。
データ抽出
Scrapeless Comments (0)
Sign in to comment.
ログインNo comments yet.