

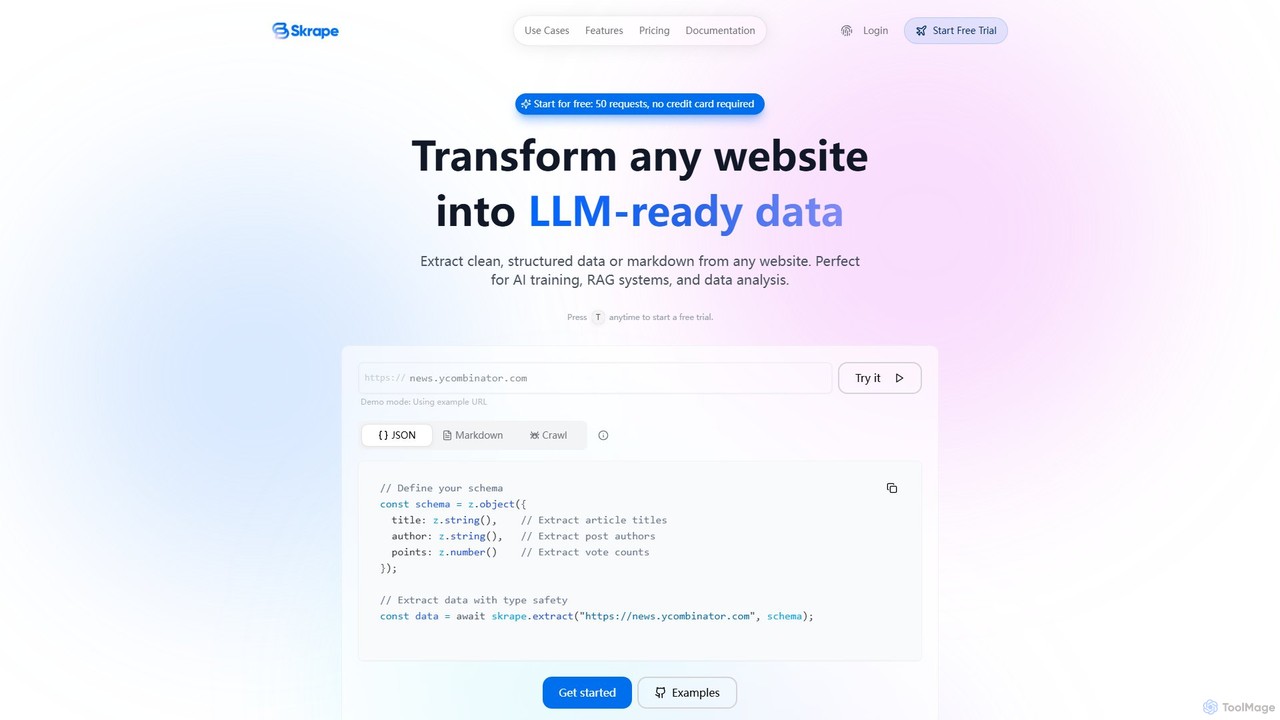
Skrape Overview
Skrapeは、大規模言語モデル(LLM)を活用して、あらゆるウェブサイトからクリーンで構造化されたデータを抽出する、強力で開発者フレンドリーなWebスクレイピングAPIです。検索拡張生成(RAG)システム、モデルのファインチューニング、詳細なデータ分析といった最新のAIアプリケーション向けのデータ収集プロセスを合理化するために特別に設計されています。このサービスは、動的なJavaScriptでレンダリングされたコンテンツを含む複雑なWebページを、きれいにフォーマットされたマークダウンや、ユーザーが定義したスキーマに従った構造化JSONデータに変換することができます。
Skrapeの核心的な哲学は、Webデータ抽出を簡素化することです。開発者は、複雑なHTML解析、スクレイピング対策、プロキシ管理に対処する代わりに、簡単なAPIコールで必要なデータを取得できます。このプラットフォームは信頼性とスケーラビリティを重視して構築されており、ユーザーが常にキャッシュなしで新鮮なリアルタイムデータを確実に受け取れるようにしています。
Skrapeの使い方
Skrapeの使い方は簡単で、シームレスな開発者体験を提供するように設計されています。一般的なワークフローは以下の通りです。
- サインアップとAPIキーの取得:まず、Skrapeのウェブサイトでアカウントを作成します。クレジットカード不要で50クレジットが提供される無料トライアルから始めることができます。サインアップ後、ダッシュボードからAPIキーを取得します。
- 認証:すべてのAPIリクエストはBearerトークンを使用して認証する必要があります。リクエストの`Authorization`ヘッダーにAPIキーを含める必要があります(例:`Authorization: Bearer YOUR_API_KEY`)。
- エンドポイントの選択:Skrapeは、ニーズに応じて複数のAPIエンドポイントを提供しています。
/api/markdown:単一のWebページをクリーンなマークダウンに変換します。/api/extract:提供されたZodスキーマに基づいて、Webページから構造化JSONデータを抽出します。これにより、型安全で正確なデータ抽出が可能になります。/api/crawl:ウェブサイト全体をクロールし、リンクをたどって複数のページから効率的にデータを収集します。
- APIコールの実行:お好みのHTTPクライアントまたはSkrapeの公式SDK(Node.jsおよびPython用)を使用してAPIにリクエストを送信します。たとえば、データを抽出するには、目的のデータ構造をスキーマとして定義し、ターゲットURLとともに`/api/extract`エンドポイントに渡します。
- 結果の処理:APIは、リクエストした形式(クリーンなマークダウンまたは構造化JSON)で抽出されたデータを返します。このサービスは、長時間実行されるタスクのバックグラウンドジョブ処理もサポートしており、`/api/get-job`エンドポイントを介してジョブのステータスを確認できます。
Skrapeの主な機能
- LLMによるスマート抽出:スキーマを使用して目的のデータ構造を定義すると、AIがインテリジェントに情報を抽出し、構造化JSONにフォーマットします。
- スマートクローリング:サイトマップがないウェブサイトでも自動的にクロールし、倫理的なスクレイピングを保証するために`robots.txt`ルールを尊重します。
- 動的コンテンツ処理:JavaScriptレンダリングを完全にサポートし、シングルページアプリケーション(SPA)や従来のスクレイパーでは扱いにくい他の動的コンテンツを処理できます。
- クリーンなマークダウン変換:あらゆるWebページを完璧にフォーマットされたクリーンなマークダウンに変換し、RAGシステムやナレッジベースに最適です。
- APIアクション:抽出前に、ボタンのクリック、スクロール、特定のコンテンツの読み込み待機などのページ上のアクションを実行できます。
- リアルタイムデータ:Skrapeはコンテンツをキャッシュしないため、常にソースから直接、最新のデータを取得できます。
- 開発者フレンドリー:Node.jsおよびPython用の公式SDK、包括的なAPIドキュメント、一貫したエラー処理形式を提供します。
Skrapeの使用例
Skrapeは多目的であり、幅広いデータ収集タスクに適用できます。
- RAG対応データ収集:自動メタデータ抽出により、ウェブサイトをクリーンで構造化されたデータセットに変換し、検索拡張生成アプリケーションへの入力に最適です。
- AIトレーニングデータパイプライン:言語モデルや他のAIアプリケーションのファインチューニングのために、多様で高品質な多言語データセットの収集を自動化します。
- ナレッジベースの構築:複数のソースから技術文書、APIリファレンス、チュートリアル、研究論文をスクレイピングして、包括的なナレッジベースを作成します。
- AIコンテンツモニタリング:AI関連のニュース、研究、技術ブログを追跡・収集し、最新の業界トレンドを把握します。
- モデル評価データ:さまざまなドメインから実世界のデータを収集し、LLMのパフォーマンスをベンチマークおよび評価します。
Skrapeの利点
Skrapeは、従来のWebスクレイピング手法に比べて大きな利点を提供します。その主な利点は、シンプルさ、パワー、信頼性です。APIファーストのアプローチは、Webスクレイピングの複雑さを抽象化し、開発者がデータの利用に集中できるようにします。抽出にLLMを使用することで、脆弱なCSSセレクタベースの方法よりも優れた精度と柔軟性を提供します。さらに、動的コンテンツを処理し、すぐに使えるクリーンな出力を提供する能力は、開発時間と労力を大幅に節約します。
料金プラン
Skrapeは、ニーズに応じてスケールできるように設計された、透明性の高いクレジットベースの料金モデルを提供しています。
- 無料トライアル:50の無料クレジットでサービスをテストできます。クレジットカードは不要です。
- スタータープラン:月額15ドルで3,000クレジット。小規模プロジェクトや個人開発者に最適です。
- グロースプラン:月額50ドルで10,000クレジット。利用量が増加している成長中のチームに適しています。優先サポートが含まれます。
- プロプラン:月額250ドルで50,000クレジット。大量の要件を持つ企業やチーム向けに設計されています。優先サポートとカスタムレート制限が含まれます。
クレジット使用量:
- HTMLからマークダウンへ:1ページあたり1クレジット
- Webクローリング:1ページあたり1クレジット
- AIデータ抽出:1ページあたり5クレジット
Skrape Alternatives
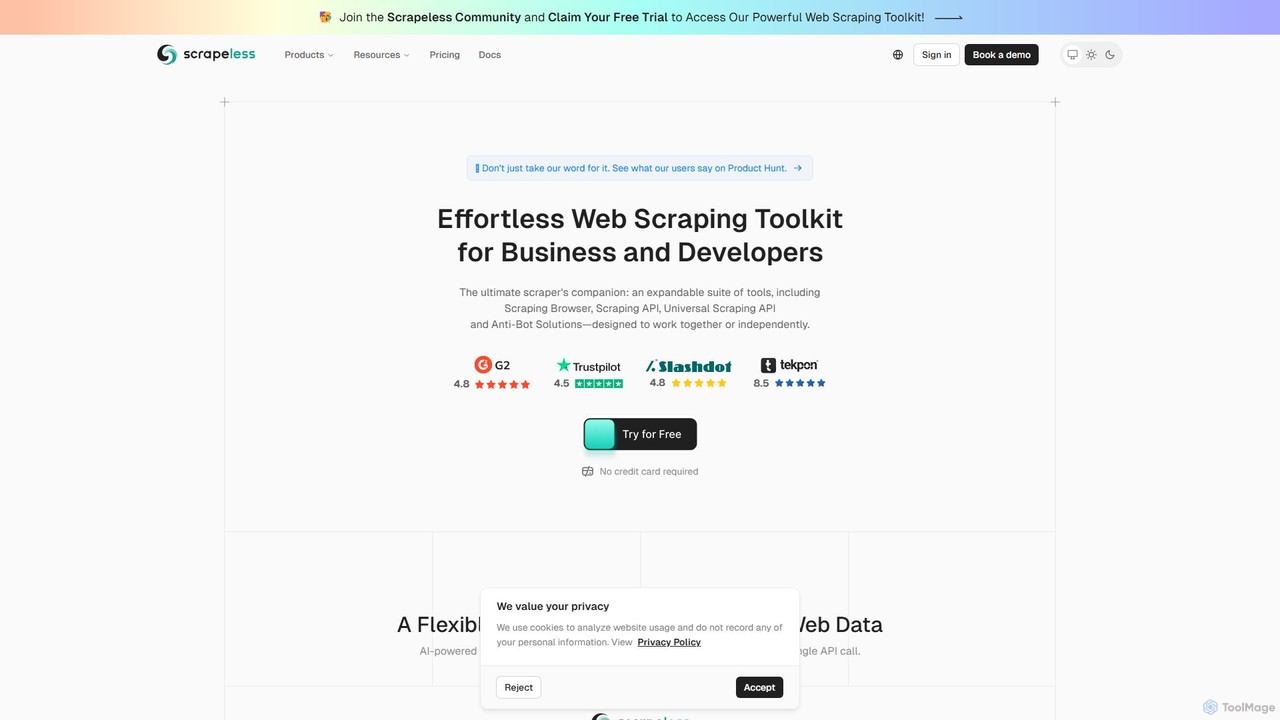
Scrapeless
開発者やビジネス向けのAI搭載ウェブスクレイピングツールキットです。スクレイピングブラウザ、ユニバーサルスクレイピングAPI、ディープSERP APIなどの一連のツールを提供し、大規模な公開ウェブデータを簡単に抽出します。アンチボット対策の回避に特化し、Eコマース、市場調査、AIモデルのトレーニング用に構造化データを提供し、信頼性と使いやすさを重視しています。
スクレイピング
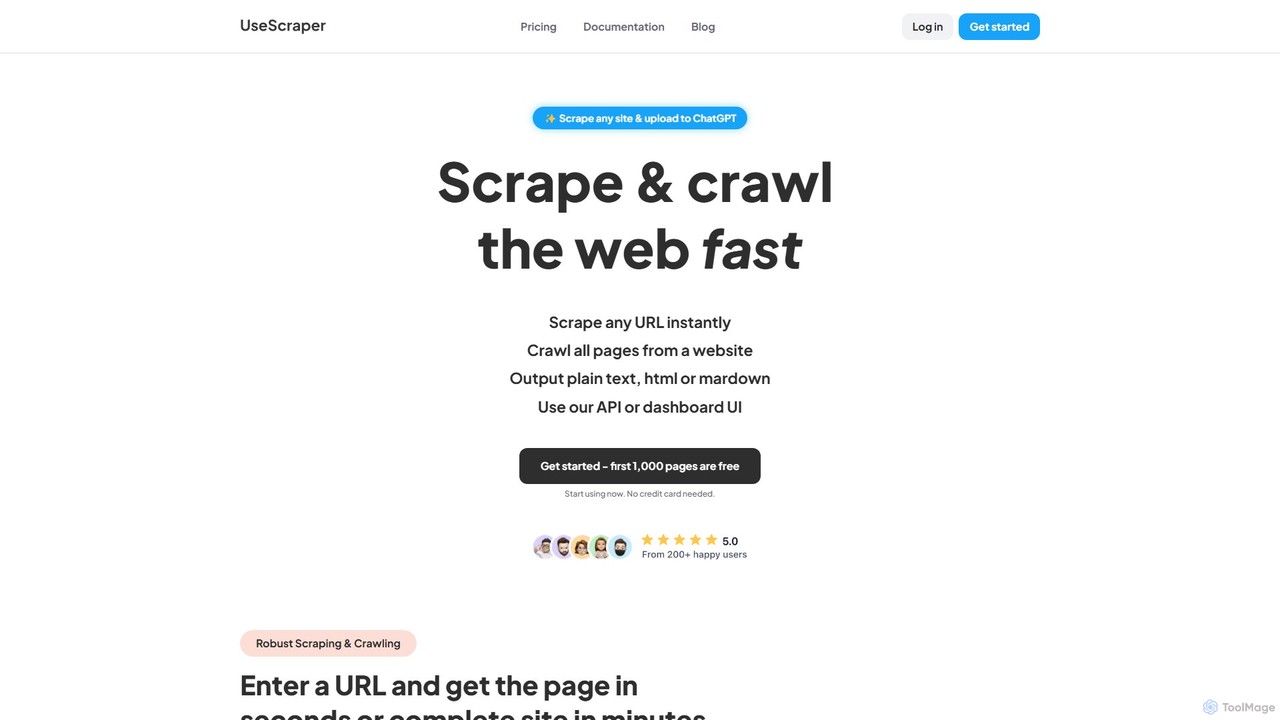
UseScraper
UseScraperは、開発者やAIアプリケーション向けに設計された強力なウェブクローラーおよびスクレイパーAPIです。あらゆるウェブサイトから効率的にデータを抽出し、完全なJavaScriptレンダリング、自動スケーリングインフラ、そしてChatGPTのようなLLMへのデータ供給に最適なクリーンなMarkdownなどの出力形式を特長としています。
データ抽出
Webcrawlerapi
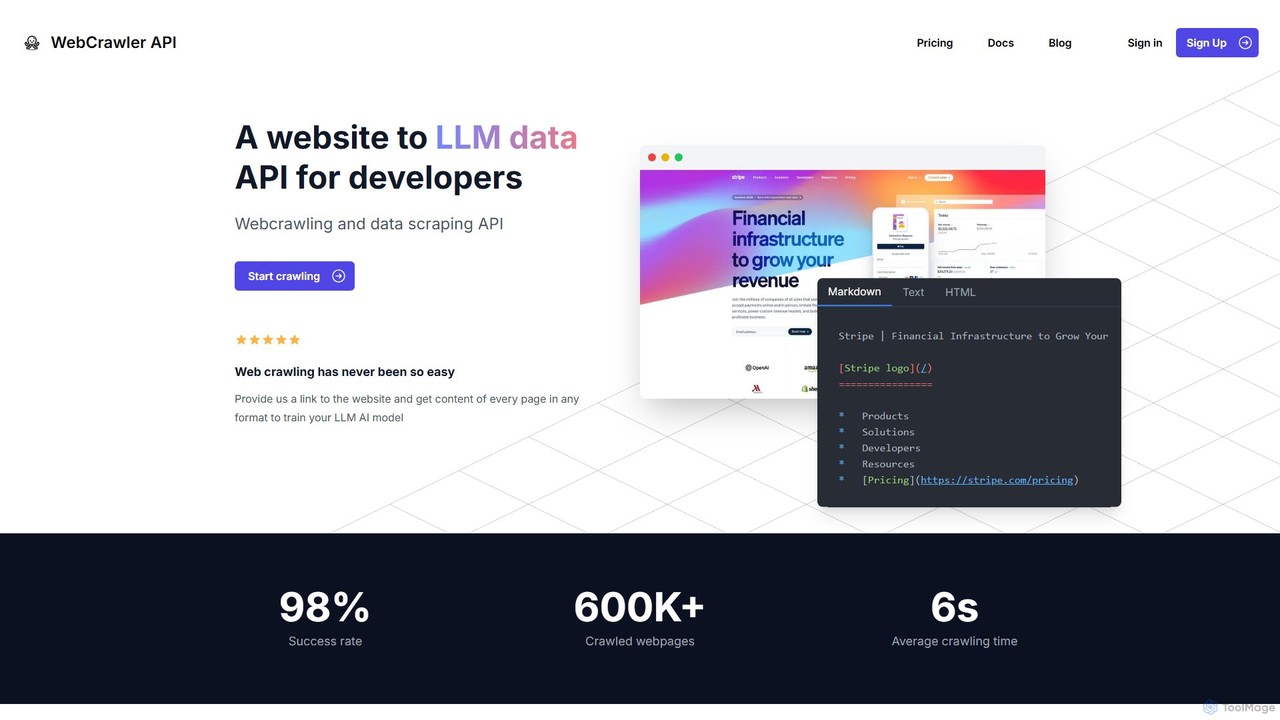
Webcrawlerapiは、開発者が簡単にウェブサイトをクロールし、クリーンなデータを抽出できるように設計された強力なAPIです。JavaScriptのレンダリング、アンチボット対策、データ解析を処理することで、複雑なウェブスクレイピングプロセスを簡素化します。LLM AIモデルのトレーニングや検索拡張生成(RAG)システムのために、Markdownやテキストなどの構造化コンテンツを収集するのに最適で、高い成功率とシンプルな従量課金制の価格モデルを提供します。
データ抽出Skrape Categories
Skrape Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
UseScraper
UseScraperは、開発者やAIアプリケーション向けに設計された強力なウェブクローラーおよびスクレイパーAPIです。あらゆるウェブサイトから効率的にデータを抽出し、完全なJavaScriptレンダリング、自動スケーリングインフラ、そしてChatGPTのようなLLMへのデータ供給に最適なクリーンなMarkdownなどの出力形式を特長としています。
データ抽出
Scrapeless
開発者やビジネス向けのAI搭載ウェブスクレイピングツールキットです。スクレイピングブラウザ、ユニバーサルスクレイピングAPI、ディープSERP APIなどの一連のツールを提供し、大規模な公開ウェブデータを簡単に抽出します。アンチボット対策の回避に特化し、Eコマース、市場調査、AIモデルのトレーニング用に構造化データを提供し、信頼性と使いやすさを重視しています。
スクレイピング
Webcrawlerapi
Webcrawlerapiは、開発者が簡単にウェブサイトをクロールし、クリーンなデータを抽出できるように設計された強力なAPIです。JavaScriptのレンダリング、アンチボット対策、データ解析を処理することで、複雑なウェブスクレイピングプロセスを簡素化します。LLM AIモデルのトレーニングや検索拡張生成(RAG)システムのために、Markdownやテキストなどの構造化コンテンツを収集するのに最適で、高い成功率とシンプルな従量課金制の価格モデルを提供します。
データ抽出
webscrapeai
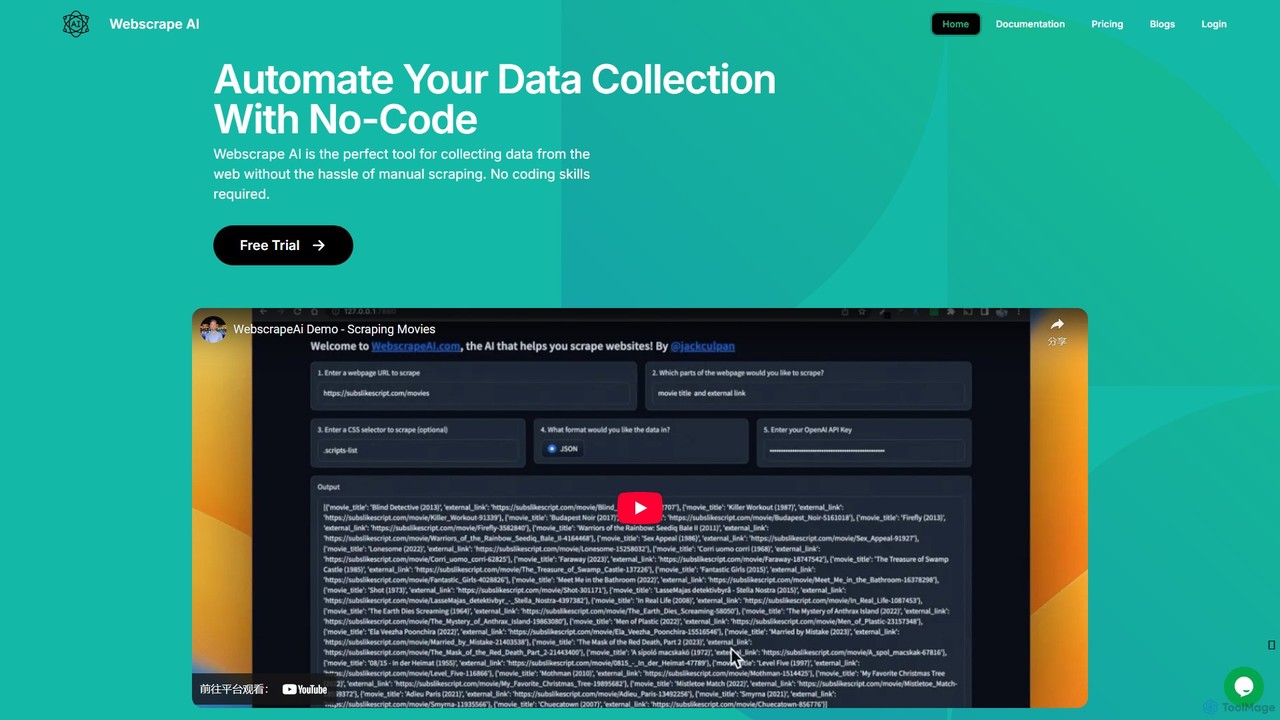
WebscrapeAIは、ウェブデータ収集を自動化するために設計された、ノーコードのAI搭載プラットフォームです。URLを提供し、必要なデータを指定するだけで、AIがスクレイピングプロセス全体を処理します。動的ウェブサイト、一括スクレイピング、プロキシ統合をサポートし、開発者向けのAPIも提供しており、データ抽出を迅速、正確、そして誰にでも利用可能にします。
ウェブスクレイピング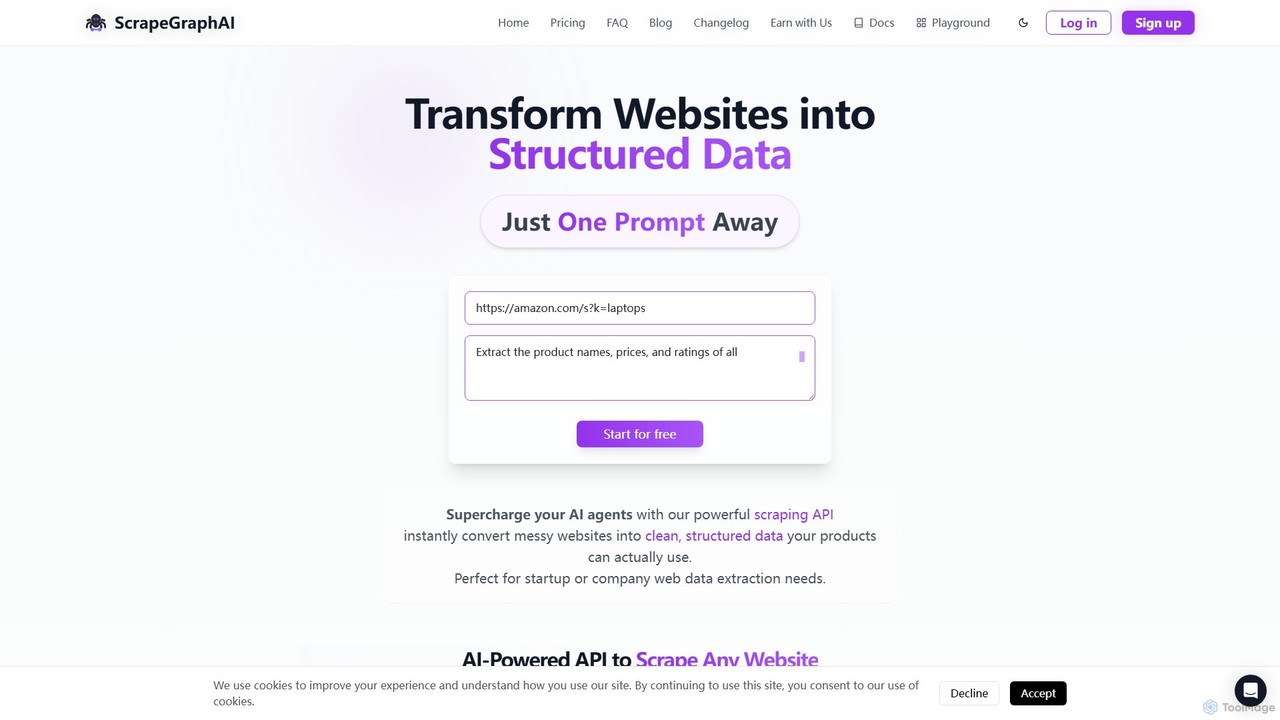
ScrapeGraphAI
ScrapeGraphAIは、AIを活用したウェブスクレイピングAPIで、簡単な自然言語プロンプトを使って非構造化ウェブサイトをクリーンで構造化されたJSONデータに変換します。開発者、AIエージェント、自動化ワークフロー向けに設計されており、複雑なコードなしでデータ抽出を簡素化します。
分析
Crawly
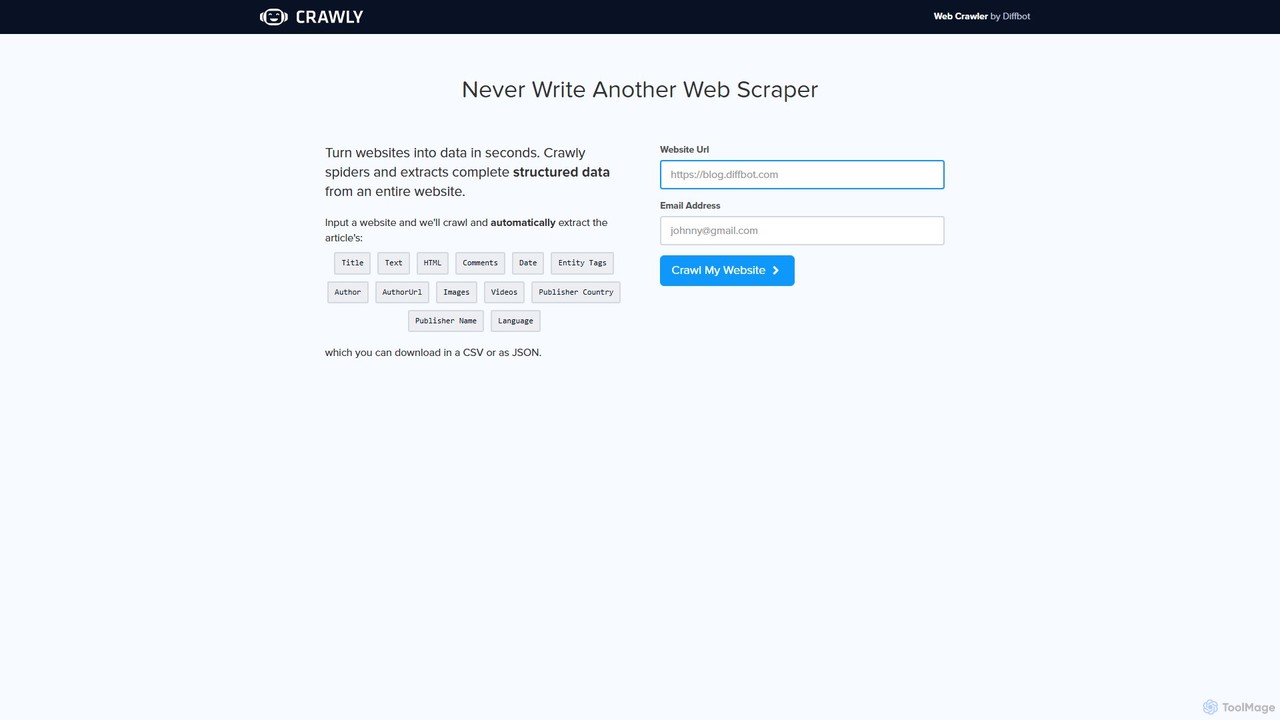
CrawlyはDiffbotが開発したAI搭載のウェブクローラーで、ウェブサイト全体から構造化データを自動的に抽出します。URLを入力するだけで、Crawlyがサイトをスパイダーし、記事、製品、ディスカッションなどの重要な情報を取得し、コーディング不要でクリーンなJSONまたはCSVデータに変換します。
ウェブスクレイピング
Skrape Comments (0)
Sign in to comment.
ログインNo comments yet.