ToolMage
ログイン

AI TOOL COMPARISON

Runpod vs Tensorfuse

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

製品概要

Runpod 製品概要

Runpodは、AIと機械学習向けに設計されたクラウドプラットフォームで、AIモデルのデプロイ、トレーニング、実行のためのスケーラブルなGPUコンピューティングを提供します。サーバーレスGPU、構築済みテンプレート、コスト効率の高い価格設定により、アイデアから本番環境までのAI開発ワークフロー全体を簡素化します。

Preview

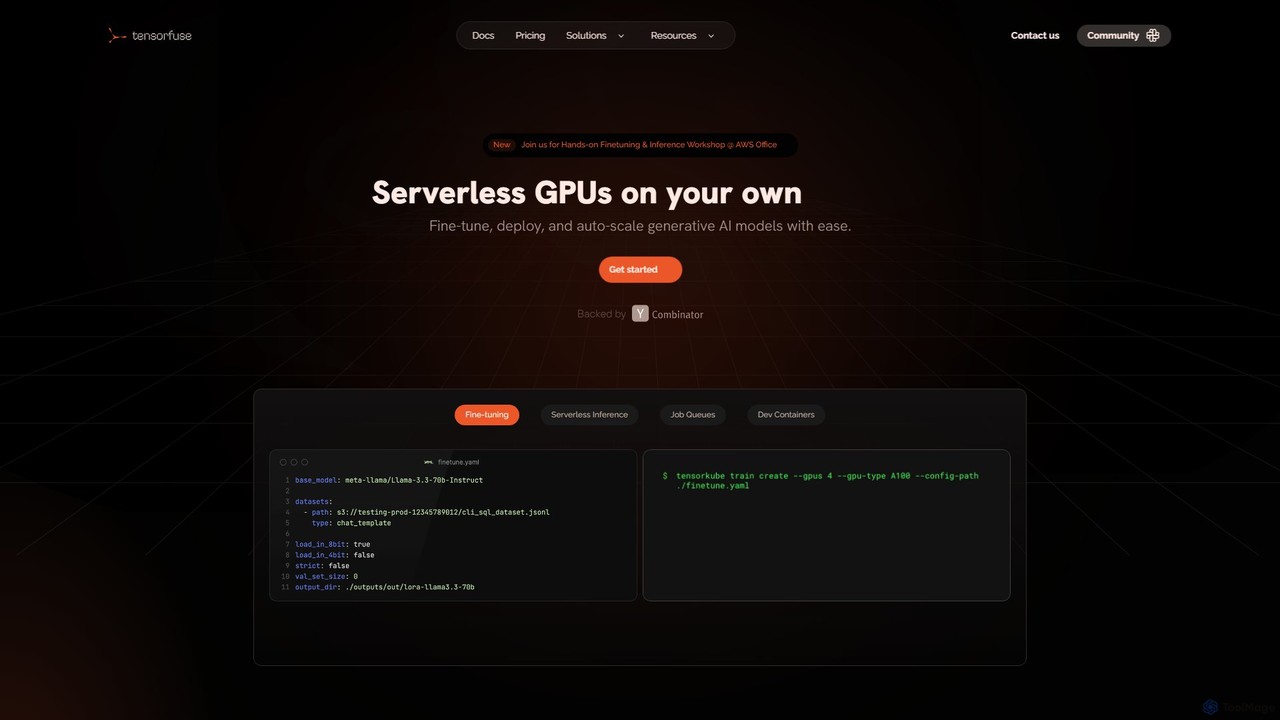
Tensorfuse 製品概要

Tensorfuseは、開発者が自身のAWSクラウド上で生成AIモデルのファインチューニング、デプロイ、オートスケーリングを行えるようにするサーバーレスGPUプラットフォームです。インフラ管理を簡素化し、サーバーレス推論、ジョブキュー、開発コンテナなどの機能を提供して、開発を加速し、コストを削減し、DevOpsのオーバーヘッドをなくします。

Preview

基本情報

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Runpod VS Tensorfuse — 基本情報
基本情報RunpodTensorfuse
Pricing modelPaidFreemium
Product typeWebWeb
Primary focus機械学習デプロイメント
対象ユーザーと職種未確認未確認
カテゴリー機械学習 · クラウドコンピューティング · 自動化デプロイメント · MLOps · クラウドコンピューティング
Added2025/08/062025/08/15
更新2026/11/192026/11/19

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Runpod

Runpodは、AIモデルの構築、トレーニング、デプロイの複雑さを解消するために設計されたエンドツーエンドのAIクラウドプラットフォームです。開発者、研究者、企業に、すべてのAI/MLコンピューティングニーズに対応する、合理化された強力でコスト効率の高いソリューションを提供します。世界中のデータセンターネットワークを介して多種多様なGPUへのオンデマンドアクセスを提供することで、Runpodはユーザーがインフラ管理、スケーリング、高コストといった典型的な悩みを抱えることなく、アイデアから本番環境対応のアプリケーションへと進むことを可能にします。

このプラットフォームはビルダー向けに構築されており、スピード、柔軟性、効率性に重点を置いています。大規模言語モデルのファインチューニング、アプリケーション向けのリアルタイム推論の提供、計算集約型のシミュレーションの実行など、Runpodはそれらを大規模に実行するために必要なツールとインフラを提供します。次世代のAI企業の計算基盤となり、彼らがインフラではなくイノベーションに集中できるようにすることを目指しています。

Runpodの使い方

Runpodの使用は、迅速な開発とデプロイのために設計された簡単なワークフローを含みます:

  1. サービスの選択:インタラクティブな開発や長時間実行タスクにはGPU Cloudを、スケーラブルなオンデマンド推論エンドポイントにはServerlessを選択します。
  2. テンプレートの選択:PyTorch、TensorFlow、Stable Diffusion、さまざまなLLMなどの人気のあるフレームワークやアプリケーション向けの幅広い構築済みテンプレートから選択して、プロジェクトを迅速に開始します。
  3. Podの起動:「Pod」として知られるGPU対応環境を1分以内に起動します。特定のニーズに合わせてGPUタイプ、vCPU、RAM、ストレージをカスタマイズできます。
  4. 接続と構築:SSHまたはJupyter Labを介してPodにアクセスし、依存関係をインストールし、コードをアップロードして、アプリケーションのトレーニングまたは構築を開始します。
  5. データの管理:永続ボリュームまたはS3互換のネットワークボリュームを利用して、データセット、モデル、コンテナデータを保存します。主な利点は、データ転送に入出力料金がかからないことです。
  6. デプロイとスケーリング:本番ワークロードの場合、モデルをサーバーレスエンドポイントとしてデプロイします。Runpodの自動スケーリング機能は、リアルタイムの需要に基づいてGPUワーカーの数(0から数千まで)を自動的に管理し、使用したコンピューティングに対してのみ支払うことを保証します。

Runpodの主な機能

  • スケーラブルなGPUコンピューティング:コスト効率の高いコミュニティクラウドと高セキュリティのセキュアクラウドの両方で、コンシューマーグレードのRTX 4090からエンタープライズレベルのH100やB200まで、多種多様なGPUにアクセスできます。
  • サーバーレスGPU:モデルをAPIエンドポイントとしてデプロイし、ゼロから自動的にスケーリングしてあらゆるワークロードを処理し、アイドルコストを排除します。
  • FlashBootテクノロジー:200ms未満のコールドスタート時間で超高速スケーリングを実現し、アプリケーションが常にレスポンシブであることを保証します。
  • 永続ストレージ:入出力料金がゼロのS3互換ストレージで、データ取り込みからデプロイまでの完全なAIパイプラインをシームレスに実行できます。
  • 構築済みテンプレート:トレーニングや推論などの環境を即座にセットアップするための豊富なテンプレートライブラリで、セットアップ時間を大幅に短縮します。
  • グローバルインフラ:世界中の8つ以上の地域にワークロードをデプロイし、低遅延のパフォーマンスとグローバルな信頼性を実現します。
  • 組み込みのオーケストレーションとモニタリング:プラットフォームがタスクのキューイングと分散を自動的に処理し、カスタムフレームワークを必要とせずにリアルタイムのログ、モニタリング、メトリクスを提供します。

Runpodの使用例

Runpodは多用途で、幅広いアプリケーションをサポートします:

  • 推論サービング:画像、テキスト、音声生成モデルの推論を低遅延であらゆる規模でデプロイおよび提供します。
  • モデルのファインチューニング:特定のデータセットでカスタムモデルを効率的かつコスト効率よくトレーニングおよびファインチューニングします。
  • AIエージェント:インテリジェントで自律的なエージェントベースのシステムと複雑なワークフローを構築およびホストします。
  • 計算集約型タスク:3Dレンダリング、科学シミュレーション、大規模データ処理などの要求の厳しいワークロードを実行します。

Runpodの利点

Runpodは、従来のクラウドプロバイダーに比べて大きな利点を提供します:

  • コスト効率:秒単位の課金、競争力のあるGPU価格、データ出力料金ゼロにより、ユーザーはインフラ費用を最大90%節約したと報告しています。
  • スピードと俊敏性:アイデアから実行まで数秒で。プラットフォームの迅速なプロビジョニング、最小限のコールドスタート、自動スケーリング機能が開発ライフサイクルを加速します。
  • シンプルさ:インフラの複雑さを抽象化することで、チームはDevOpsではなく、コア製品と機能に集中できます。
  • 柔軟性:GPUモデル、スケーリング動作、アイドル時間制限、データセンターの場所など、高度にカスタマイズ可能な環境。
  • 信頼性:99.9%の稼働時間、組み込みのフェイルオーバー、堅牢なセキュリティ(SOC2、HIPAA、GDPRは進行中)を備えたエンタープライズグレードのサービス。

料金プラン

Runpodの価格は透明性が高く、コスト効率が良いように設計されています。

  • GPU Cloud:時間単位で課金され、価格はGPUタイプと、セキュアクラウドか、より手頃なコミュニティクラウドかによって異なります。たとえば、RTX 4090は1時間あたり0.69ドルから、ハイエンドのH100 SXMは約2.69ドル/時間です。
  • Serverless(推論):処理時間の秒単位で課金されます。価格はGPUパフォーマンスによって階層化されており、「Flex」(予熱済み)ワーカーと「Active」ワーカーで料金が異なります。このモデルは変動するトラフィックに非常に効率的です。
  • ストレージ:永続Podストレージは月額0.10ドル/GBです。S3互換のネットワークボリュームストレージはさらに安く、1TB未満で月額0.07ドル/GBです。入出力料金はありません。
  • 予約:長期的なワークロードの場合、ユーザーは営業チームと相談して割引料金で容量を予約できます。

Tensorfuse

Tensorfuseは、開発者や組織が自身のAWSクラウドインフラストラクチャ上で直接サーバーレスGPUを管理するための強力なプラットフォームを提供します。生成AIモデルのライフサイクル全体、つまりファインチューニングや実験から本番環境でのデプロイやオートスケーリングまでを効率化するように設計されています。Kubernetes、Docker、インフラプロビジョニングの複雑さを抽象化することで、TensorfuseはチームがAIアプリケーションの構築に集中できるようにし、市場投入までの時間を大幅に短縮し、運用コストを削減します。

このプラットフォームは、サーバーレスアーキテクチャのシンプルさと、プライベートクラウド上での実行によるセキュリティと制御という、両方の長所を提供するように構築されています。これにより、独自のデータとモデルの重みはプライベートS3バケットから出ることがなく、最大限のセキュリティとコンプライアンスが保証されます。Tensorfuseは効率性を追求して設計されており、最適化されたコンテナランタイムにより、重いGPUワークロードでも高速なコールドスタートが可能になり、サービスを数秒でゼロからスケールアップできます。

Tensorfuseの使い方

Tensorfuseの利用開始は、簡単なプロセスになるように設計されています:

  1. サインアップとAWS接続: まず、プラン(無料の「Hacker」ティアを含む)にサインアップし、AWSアカウントを接続します。その後、Tensorfuseがクラウド環境内に必要なリソースをセットアップします。
  2. 開発コンテナを使用した実験: Tensorfuseの開発コンテナを使用して、ローカルIDE(VS Codeなど)をクラウドGPUに直接接続します。これにより、SSH、コードのコピー、依存関係の管理が不要になります。ローカルコードへの変更は即座に同期され、迅速なリアルタイム実験が可能になります。
  3. モデルのファインチューニング: Axolotl、Unsloth、Hugging Faceなどの一般的なトレーニングライブラリを利用して、独自のデータセットでオープンソースモデルをファインチューニングします。カスタムのトレーニングループを作成することもできます。プラットフォームが基盤となるGPUのプロビジョニングと管理を処理します。
  4. 推論のためのデプロイ: トレーニング済みまたは事前トレーニング済みのモデルをサーバーレスエンドポイントとしてデプロイします。これらのエンドポイントは、受信トラフィックに基づいて自動的にスケーリングし、ゼロから高同時実行性を処理するように拡張されるため、コスト効率とパフォーマンスが保証されます。モデルはOpenAI互換のAPIとして公開できます。
  5. ジョブキューによる管理: バッチ処理やオフライン推論などの非同期タスクには、ジョブキュー機能を使用します。プログラムでジョブをキューに入れ、効率的なリソース割り当てのために最小および最大スケーリングパラメータを定義し、簡単なCLIコマンドでステータスを監視できます。

Tensorfuseの主な機能

  • サーバーレス推論: トラフィックに応じてGPUデプロイメントを自動的にスケーリングし、高速なコールドスタート(数秒でコンテナを起動)とコスト削減のためにゼロにスケールダウンする機能を備えています。
  • 効率的なファインチューニング: クラウドのS3を使用して、プライベートデータでモデルを安全にファインチューニングします。AxolotlやHuggingfaceなどの一般的なフレームワークとの柔軟な統合を提供します。
  • ジョブキュー: バッチ処理のためにプログラムでジョブをデプロイおよびキューに入れ、設定可能なスケーリングにより効率的なリソース割り当てとコスト管理を実現します。
  • 開発コンテナ: SSHなしでローカルコードをクラウドGPUに接続し、お気に入りのIDEから直接、迅速で反復的な開発と実験を行います。
  • マルチLoRA推論: 単一のGPUで数千のLoRAアダプタをトレーニングおよびホットスワップするための標準サポートにより、ハードウェア使用率を最大化し、推論コストを削減します。
  • 幅広いハードウェアサポート: NVIDIA GPU(A10G、A100、H100)、AWS Trainium/Inferentiaチップ、TPU、FPGAなど、さまざまなハードウェアでワークロードを実行します。
  • プライベートクラウドセキュリティ: すべてのデータ、データセット、モデルの重みはプライベートAWS S3バケット内に保持され、完全な制御とセキュリティを保証します。

Tensorfuseの使用例

Tensorfuseは、幅広いAI/MLアプリケーションに最適です:

  • スタートアップと小規模チーム: 専門のDevOpsチームなしでAI搭載機能を迅速に構築・デプロイし、アイデアから本番までを20倍速くします。
  • 大規模推論: スパイクのある、または予測不可能なトラフィックを持つアプリケーション向けに生成AIモデルを提供し、使用した計算量に対してのみ支払います。
  • カスタムモデルのファインチューニング: 企業は、LlamaやMistralなどのベースモデルを独自のデータでファインチューニングし、特定のビジネスニーズに合わせた専門的で高性能なモデルを作成できます。
  • バッチ処理ワークロード: コスト効率の高いジョブキューシステムを使用して、データ分析、レポート生成、大規模なオフライン推論などの非リアルタイムタスクを効率的に実行します。
  • MLの研究と実験: 研究者やMLエンジニアは、開発コンテナを使用して、インフラ設定を待つことなくモデルを迅速に反復できます。

Tensorfuseの利点

ユーザーがTensorfuseを選ぶ理由は、クラウドGPU支出を30%削減し、製品化までの時間を20倍短縮するという大きな利点があるためです。複雑な自己管理のDevOpsソリューションの必要性をなくし、エンジニアリングリソースを解放します。このプラットフォームは、マネージドサービスのパフォーマンスとスケーラビリティを提供しつつ、自社のクラウドで実行することによるセキュリティとコストの利点も兼ね備えています。顧客の声では、移行や継続的な問題を支援する卓越した迅速なサポートチームが強調されており、オンボーディングプロセスがスムーズかつ効率的になります。

料金プラン

Tensorfuseは、さまざまなニーズに合わせて階層化された料金体系を提供しています:

  • Hacker(無料): 個人開発者やサイドプロジェクト向け。100 MGH(管理GPU時間)、サーバーレス推論、開発コンテナ、コミュニティサポートが含まれます。
  • Starter(月額$249): 小規模チーム向け。2,000 MGH、すべてのHacker機能に加え、ファインチューニング、GitHub Actions、カスタムドメイン、プライベートSlackサポートが含まれます。14日間の無料トライアルが利用可能です。
  • Growth(月額$799): 成長中のスタートアップ向け。5,000 MGH、すべてのStarter機能に加え、バッチジョブ&ジョブキュー、環境、マルチLoRA推論、プレミアムサポートが含まれます。14日間の無料トライアルが利用可能です。
  • Enterprise(カスタム): 高度な機能を必要とする大企業向け。ボリュームディスカウント付きのカスタムMGH、すべてのGrowth機能に加え、ロールベースのアクセス制御(RBAC)、SSO、エンタープライズグレードのセキュリティ(SOC2、HIPAA)、専任のエンジニアリングサポートが含まれます。
  • スタートアップディール: 資金調達額が50万ドル未満の初期段階のスタートアップは、6か月間10,000時間の無料GPUコンピューティング管理の対象となる場合があります。

ポジショニング

分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。

カテゴリー

共通
クラウドコンピューティング
のみ Runpod
機械学習自動化
のみ Tensorfuse
デプロイメントMLOps

タグ

共通
AIモデルデプロイメントクラウドコンピューティングファインチューニング推論
のみ Runpod
オートスケーリング開発者ツールGPUインフラ機械学習サーバーレス
のみ Tensorfuse
AWSドッカー生成AIKubernetesMLOpsサーバーレスGPU

対象ユーザーと職種

共通
確認済みデータなし
のみ Runpod
確認済みデータなし
のみ Tensorfuse
確認済みデータなし

トラフィック比較

市場での可視性の差を正しく示すため、同じ尺度で比較しています。

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Runpod monthly traffic:

Latest traffic · 2026-05

月間訪問数
2.3M
平均滞在時間
9:26
訪問あたりページ数
7.98
直帰率
31.98%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 1.6M
  • 2026-01: 1.9M
  • 2026-02: 1.9M
  • 2026-03: 2.4M
  • 2026-04: 2.3M
  • 2026-05: 2.3M

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States58.83%1.4M
🇮🇳India13.6%317.4K
🇩🇪Germany13.56%316.5K
🇧🇷Brazil7.44%173.7K
🇳🇬Nigeria6.57%153.3K

流入元

Source typePercentageEstimated visits
ダイレクト78.77%1.8M
参照元20.03%467.5K
Eメール1.2%28K

検索キーワード

run podrunpodrunpod passwordrunpod pricingrunpod serverless

Tensorfuse monthly traffic:

Latest traffic · 2026-05

月間訪問数
6.7K
平均滞在時間
1:01
訪問あたりページ数
1.8
直帰率
44.71%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 10.1K
  • 2026-01: 5.4K
  • 2026-02: 4.2K
  • 2026-03: 4.9K
  • 2026-04: 5.3K
  • 2026-05: 6.7K

主要地域

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States38.24%2.6K
🇻🇳Vietnam36.56%2.5K
🇮🇳India25.2%1.7K

検索キーワード

aws serverless gpubrew install aws clillama.cpp serverlessllm inference servers compared: vllm vs tgi vs sglang vs tritontensorfuse

コミュニティ指標

評価や反応は参考指標であり、製品適合性そのものではありません。

Runpod

評価
未確認
コメント
0
お気に入り
146
いいね
166

Tensorfuse

評価
未確認
コメント
0
お気に入り
170
いいね
144

Runpod vs Tensorfuse · 比較 FAQ

What do Runpod and Tensorfuse have in common?
Both tools are listed under クラウドコンピューティング. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Runpod and Tensorfuse free?
Listed pricing models: Runpod — Paid; Tensorfuse — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Runpod and Tensorfuse?
The primary listed category is 機械学習 for Runpod, and デプロイメント for Tensorfuse. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

関連比較