Baseten
デプロイメント
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
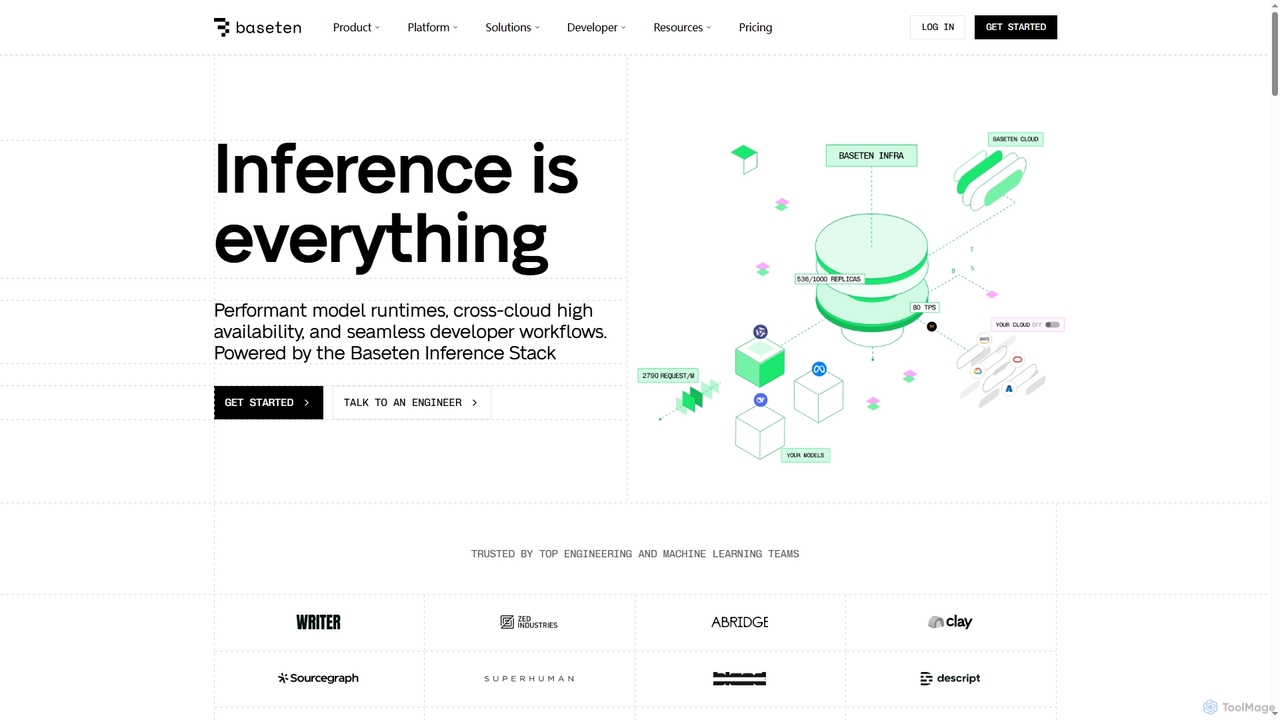
Basetenは、AIモデルのデプロイ、スケーリング、管理を行うための本番環境グレードの推論プラットフォームです。高性能なランタイム、シームレスな開発者ワークフロー、柔軟なデプロイオプション(クラウド、セルフホスト、ハイブリッド)を提供します。ミッションクリティカルなAIアプリケーションを構築するエンジニアリングおよびMLチームに最適です。
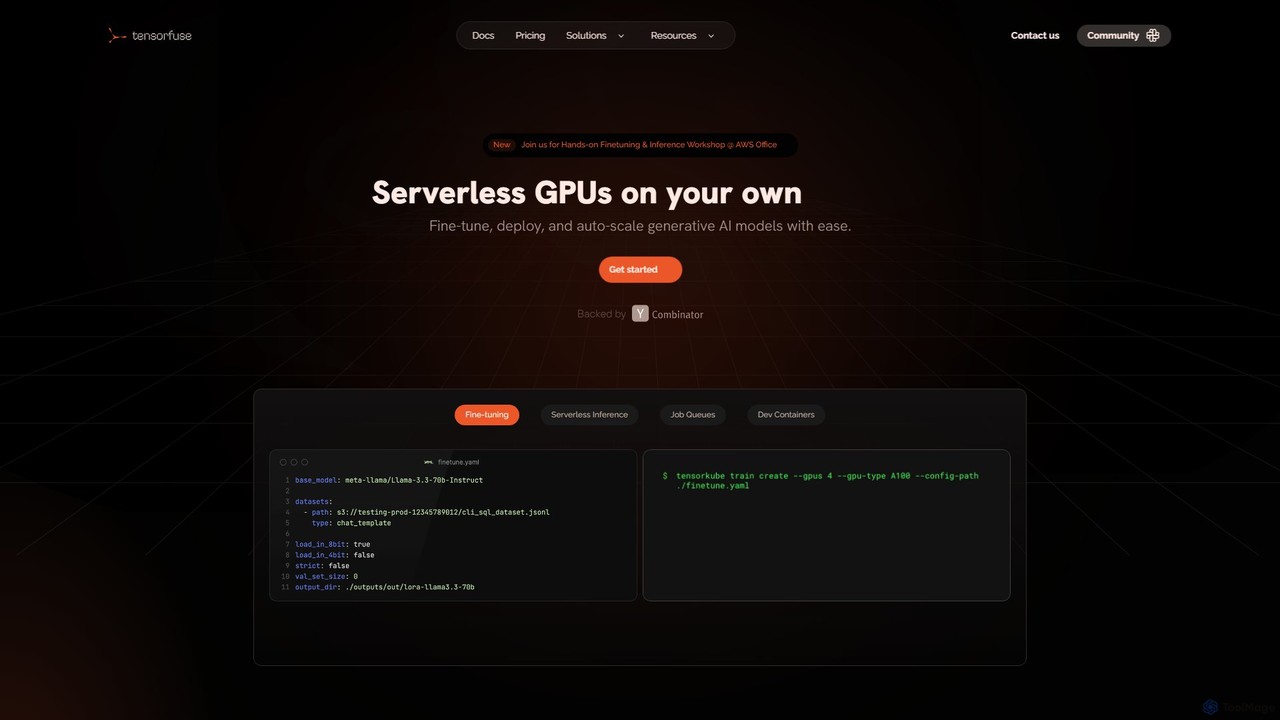
Tensorfuseは、開発者が自身のAWSクラウド上で生成AIモデルのファインチューニング、デプロイ、オートスケーリングを行えるようにするサーバーレスGPUプラットフォームです。インフラ管理を簡素化し、サーバーレス推論、ジョブキュー、開発コンテナなどの機能を提供して、開発を加速し、コストを削減し、DevOpsのオーバーヘッドをなくします。
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| 基本情報 | Baseten | Tensorfuse |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | デプロイメント | デプロイメント |
| 対象ユーザーと職種 | AI研究者 · 最高技術責任者 · データサイエンティスト · 機械学習エンジニア · プロダクトマネージャー · ソフトウェア開発者 | 未確認 |
| カテゴリー | デプロイメント · 機械学習 · クラウドコンピューティング | デプロイメント · MLOps · クラウドコンピューティング |
| Added | 2025/11/01 | 2025/08/15 |
| 更新 | 2026/11/19 | 2026/11/19 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Basetenは、本番環境でAIモデルをデプロイ、提供、スケーリングするために設計された包括的なプラットフォームです。AI製品を迅速かつ効率的に市場に投入するために必要なインフラ、ツール、専門知識を提供します。Baseten Inference Stackを搭載し、ミッションクリティカルな推論ワークロード向けに、高性能なモデルランタイム、クロスクラウドの高可用性、開発者中心のエクスペリエンスを提供します。
1. デプロイ方法を選択:プロトタイピングのために事前最適化されたモデルに即座にアクセスできるModel APIを利用するか、カスタム、ファインチューニング、またはオープンソースモデル用のDedicated Deploymentを作成します。
2. Trussでモデルをパッケージ化:Trussは、あらゆる機械学習フレームワークをサポートするBasetenのオープンソース標準です。
3. 好みの環境にデプロイ:Basetenのフルマネージドクラウド、セルフホスティング用の独自のVPC、または両方を組み合わせたハイブリッドセットアップにデプロイします。
4. トラフィックに基づいてアプリケーションを自動スケーリング:高速なコールドスタートや99.99%のアップタイムなどの機能を活用します。
5. (オプション)Basetenの推論に最適化されたインフラを活用して、最高の生産性能を得るためにモデルをトレーニングします。
Basetenは、要求の厳しいリアルタイムAIアプリケーションの構築に最適です。使用例には、低レイテンシーのAI電話エージェントの強化、画像やテキスト作成のための生成AI製品の開発、検索や取得のための高スループットの埋め込みモデルの提供、金融やヘルスケアなどの専門業界向けのカスタムビルドLLMのデプロイなどがあります。
Basetenの主な利点は、その卓越したパフォーマンス、コスト効率、スケーラビリティです。推論スタック全体を最適化することで、レイテンシーを大幅に削減し、スループットを向上させます。これは、Bland AIなどのクライアントが400ms未満の応答時間を達成するのを助けたことからも明らかです。従量課金モデルによりアイドル時間のコストが不要になり、トラフィックベースの自動スケーリングにより急成長中の信頼性が確保されます。また、このプラットフォームはSOC 2 Type II認定およびHIPAAに準拠しており、エンタープライズグレードのセキュリティを保証します。
Basetenは、成長に合わせて設計された階層的な料金体系を提供しています。
- Basic:月額0ドルからの従量課金プラン。Dedicated Deployments、Model API、高速コールドスタートへのアクセスが含まれ、SOC 2 Type IIおよびHIPAAに準拠しています。
- Pro:需要の高いGPUへの優先アクセス、専用コンピュート、より高いレート制限、SlackおよびZoomによるハンズオンサポートを追加するカスタム見積もりプラン。
- Enterprise:VPC内でのセルフホスティング、カスタムSLA、高度なセキュリティ、既存のクラウドコミットメントの使用機能を提供する、完全な制御のためのカスタム見積もりプラン。
利用料金は2つのモデルに基づいて請求されます。
- Model API:100万入力および出力トークンごとに価格設定されます。例えば、Kimi K2は100万入力トークンあたり0.60ドル、100万出力トークンあたり2.50ドルです。
- Dedicated Deployments:コンピュート時間の分単位で請求されます。例えば、A10G GPUインスタンスは分あたり0.02012ドル、H100 GPUは分あたり0.10833ドルです。
Tensorfuseは、開発者や組織が自身のAWSクラウドインフラストラクチャ上で直接サーバーレスGPUを管理するための強力なプラットフォームを提供します。生成AIモデルのライフサイクル全体、つまりファインチューニングや実験から本番環境でのデプロイやオートスケーリングまでを効率化するように設計されています。Kubernetes、Docker、インフラプロビジョニングの複雑さを抽象化することで、TensorfuseはチームがAIアプリケーションの構築に集中できるようにし、市場投入までの時間を大幅に短縮し、運用コストを削減します。
このプラットフォームは、サーバーレスアーキテクチャのシンプルさと、プライベートクラウド上での実行によるセキュリティと制御という、両方の長所を提供するように構築されています。これにより、独自のデータとモデルの重みはプライベートS3バケットから出ることがなく、最大限のセキュリティとコンプライアンスが保証されます。Tensorfuseは効率性を追求して設計されており、最適化されたコンテナランタイムにより、重いGPUワークロードでも高速なコールドスタートが可能になり、サービスを数秒でゼロからスケールアップできます。
Tensorfuseの利用開始は、簡単なプロセスになるように設計されています:
Tensorfuseは、幅広いAI/MLアプリケーションに最適です:
ユーザーがTensorfuseを選ぶ理由は、クラウドGPU支出を30%削減し、製品化までの時間を20倍短縮するという大きな利点があるためです。複雑な自己管理のDevOpsソリューションの必要性をなくし、エンジニアリングリソースを解放します。このプラットフォームは、マネージドサービスのパフォーマンスとスケーラビリティを提供しつつ、自社のクラウドで実行することによるセキュリティとコストの利点も兼ね備えています。顧客の声では、移行や継続的な問題を支援する卓越した迅速なサポートチームが強調されており、オンボーディングプロセスがスムーズかつ効率的になります。
Tensorfuseは、さまざまなニーズに合わせて階層化された料金体系を提供しています:
分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。
市場での可視性の差を正しく示すため、同じ尺度で比較しています。
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 70.97% | 188.5K |
| 🇨🇦Canada | 8.11% | 21.5K |
| 🇻🇳Vietnam | 7.87% | 20.9K |
| 🇮🇳India | 7% | 18.6K |
| 🇩🇪Germany | 6.05% | 16.1K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| ダイレクト | 85.63% | 227.4K |
| 参照元 | 10.77% | 28.6K |
| Eメール | 3.6% | 9.6K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 38.24% | 2.6K |
| 🇻🇳Vietnam | 36.56% | 2.5K |
| 🇮🇳India | 25.2% | 1.7K |
評価や反応は参考指標であり、製品適合性そのものではありません。
Basetenでは、オープンソースモデルとカスタムモデルの両方をデプロイできます。このプラットフォームは、モデルのパッケージングと提供のためのオープンソース標準であるTrussを通じて、あらゆるフレームワークで構築されたモデルをサポートします。また、Basetenモデルライブラリの既製モデルから始めることもできます。
モデルが使用するGPUを完全に制御できます。Basetenは、インスタンスタイプリファレンスで現在利用可能なGPUの完全なリストを提供しています。リストにない特定のGPUタイプが必要な場合は、チームに連絡してリクエストできます。
いいえ、アイドル時間に対して料金は発生しません。モデルがデプロイ、スケールアップまたはダウン、予測を行っているなど、Basetenでコンピューティングをアクティブに使用している時間に対してのみ料金が発生します。モデルのスケーリング動作は完全に制御できます。
はい、BasetenはSOC 2 Type II認定を受けており、HIPAAに準拠しているため、エンタープライズおよびヘルスケアアプリケーションに適した高水準のセキュリティとデータ保護基準を満たしています。
はい、Enterpriseプランを利用すると、独自のVPCでBasetenをセルフホストできます。これにより、セキュリティ、データ所在地を完全に制御し、既存のクラウドコミットメントを使用できます。
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.