

Baseten Overview
Basetenは、本番環境でAIモデルをデプロイ、提供、スケーリングするために設計された包括的なプラットフォームです。AI製品を迅速かつ効率的に市場に投入するために必要なインフラ、ツール、専門知識を提供します。Baseten Inference Stackを搭載し、ミッションクリティカルな推論ワークロード向けに、高性能なモデルランタイム、クロスクラウドの高可用性、開発者中心のエクスペリエンスを提供します。
Basetenの使い方
1. デプロイ方法を選択:プロトタイピングのために事前最適化されたモデルに即座にアクセスできるModel APIを利用するか、カスタム、ファインチューニング、またはオープンソースモデル用のDedicated Deploymentを作成します。
2. Trussでモデルをパッケージ化:Trussは、あらゆる機械学習フレームワークをサポートするBasetenのオープンソース標準です。
3. 好みの環境にデプロイ:Basetenのフルマネージドクラウド、セルフホスティング用の独自のVPC、または両方を組み合わせたハイブリッドセットアップにデプロイします。
4. トラフィックに基づいてアプリケーションを自動スケーリング:高速なコールドスタートや99.99%のアップタイムなどの機能を活用します。
5. (オプション)Basetenの推論に最適化されたインフラを活用して、最高の生産性能を得るためにモデルをトレーニングします。
Basetenの主な機能
- Baseten Inference Stack:カスタムカーネル、高度なキャッシング、最新のデコーディング技術を備えた高性能エンジンで、低レイテンシーと高スループットを実現します。
- 柔軟なデプロイオプション:セキュリティとパフォーマンスのニーズに合わせて、Baseten Cloud(フルマネージド)、Self-hosted(VPC内)、Hybridデプロイメントから選択できます。
- 幅広いモデルサポート:LLM、画像生成モデル(ComfyUIワークフローなど)、文字起こし、テキスト読み上げなど、あらゆるカスタム、プロプライエタリ、またはオープンソースモデルをデプロイします。
- 本番環境対応のModel API:DeepSeek、Kimi、Qwenなどの人気モデルのライブラリに即座にアクセスし、本番環境グレードのパフォーマンスで評価します。
- クラウドネイティブインフラストラクチャ:自動スケーリング、あらゆるクラウドプロバイダーにわたるグローバルリージョンサポート、超高速のコールドスタート、99.99%のアップタイム保証を特徴とします。
- 複合AIチェーン:複雑なマルチモデルAIワークフローに対して、きめ細かいハードウェア制御と自動スケーリングを可能にし、GPU使用率を向上させ、レイテンシーを削減します。
- 専門的なエンジニアリングサポート:プロトタイプから本番環境まで、ハンズオンでの支援を提供するフォワードデプロイドエンジニアへのアクセスが可能です。
Basetenの使用例
Basetenは、要求の厳しいリアルタイムAIアプリケーションの構築に最適です。使用例には、低レイテンシーのAI電話エージェントの強化、画像やテキスト作成のための生成AI製品の開発、検索や取得のための高スループットの埋め込みモデルの提供、金融やヘルスケアなどの専門業界向けのカスタムビルドLLMのデプロイなどがあります。
Basetenの利点
Basetenの主な利点は、その卓越したパフォーマンス、コスト効率、スケーラビリティです。推論スタック全体を最適化することで、レイテンシーを大幅に削減し、スループットを向上させます。これは、Bland AIなどのクライアントが400ms未満の応答時間を達成するのを助けたことからも明らかです。従量課金モデルによりアイドル時間のコストが不要になり、トラフィックベースの自動スケーリングにより急成長中の信頼性が確保されます。また、このプラットフォームはSOC 2 Type II認定およびHIPAAに準拠しており、エンタープライズグレードのセキュリティを保証します。
料金プラン
Basetenは、成長に合わせて設計された階層的な料金体系を提供しています。
- Basic:月額0ドルからの従量課金プラン。Dedicated Deployments、Model API、高速コールドスタートへのアクセスが含まれ、SOC 2 Type IIおよびHIPAAに準拠しています。
- Pro:需要の高いGPUへの優先アクセス、専用コンピュート、より高いレート制限、SlackおよびZoomによるハンズオンサポートを追加するカスタム見積もりプラン。
- Enterprise:VPC内でのセルフホスティング、カスタムSLA、高度なセキュリティ、既存のクラウドコミットメントの使用機能を提供する、完全な制御のためのカスタム見積もりプラン。
利用料金は2つのモデルに基づいて請求されます。
- Model API:100万入力および出力トークンごとに価格設定されます。例えば、Kimi K2は100万入力トークンあたり0.60ドル、100万出力トークンあたり2.50ドルです。
- Dedicated Deployments:コンピュート時間の分単位で請求されます。例えば、A10G GPUインスタンスは分あたり0.02012ドル、H100 GPUは分あたり0.10833ドルです。
Baseten FAQ
Traffic
Latest traffic
Status
Monthly traffic trend
- 2026-1: 197.3K
- 2026-2: 205.0K
- 2026-3: 246.2K
- 2026-4: 247.6K
- 2026-5: 265.6K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国71.0%
- 🇨🇦カナダ8.1%
- 🇻🇳ベトナム7.9%
- 🇮🇳インド7.0%
- 🇩🇪ドイツ6.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.6% |
Referral | 10.8% |
Email | 3.6% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| baseten careers | $0.29 |
| fireworks ai | $0.00 |
| kimi ai | $0.38 |
| together ai | $3.77 |
Baseten Videos on YouTube

Baseten


Vatsal Bajaj
No Priors: AI, Machine Learning, Tech, & Startups

Google Cloud
Baseten Alternatives
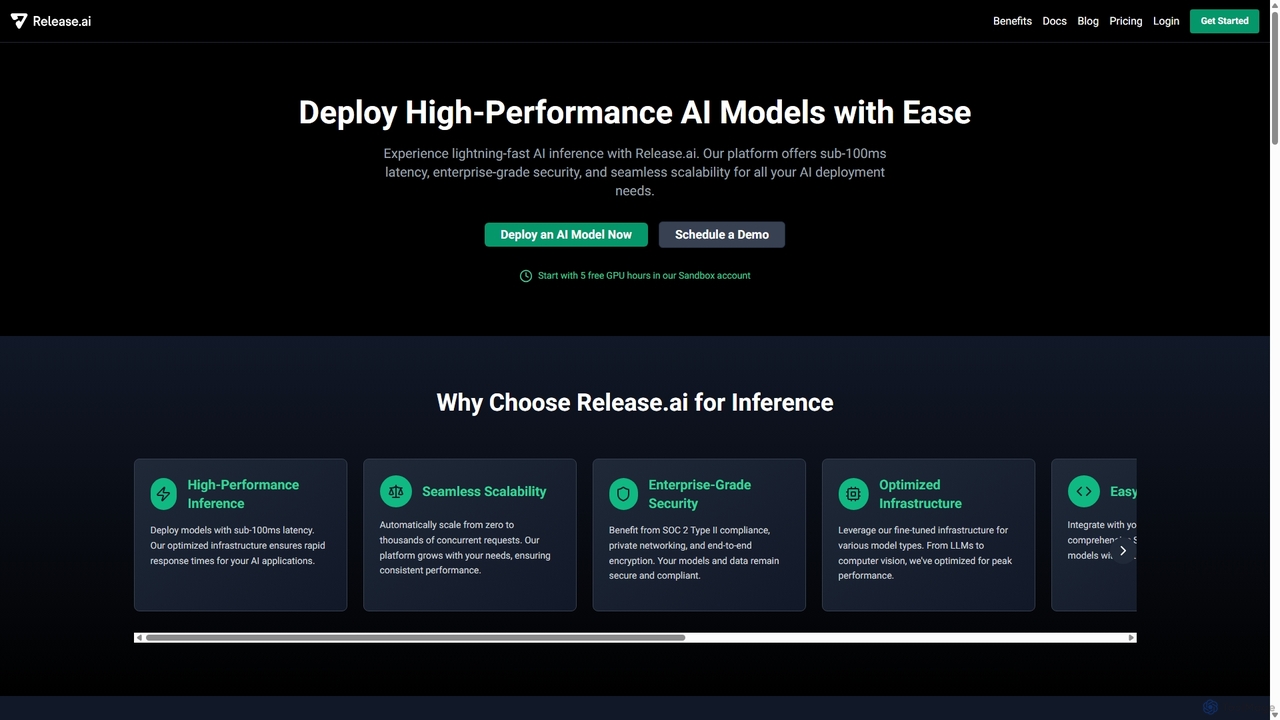
Release.ai
Release.aiは、開発者が高性能AIモデルを容易にデプロイ、管理、スケールさせるためのエンタープライズグレードのプラットフォームです。100ms未満の推論レイテンシ、シームレスな自動スケーリング、堅牢なセキュリティ、および事前最適化されたモデルの広範なライブラリを提供し、わずか数行のコードで任何の開発ワークフローに迅速に統合できます。
サービスとしてのプラットフォーム (PaaS)

Tensorfuse
Tensorfuseは、開発者が自身のAWSクラウド上で生成AIモデルのファインチューニング、デプロイ、オートスケーリングを行えるようにするサーバーレスGPUプラットフォームです。インフラ管理を簡素化し、サーバーレス推論、ジョブキュー、開発コンテナなどの機能を提供して、開発を加速し、コストを削減し、DevOpsのオーバーヘッドをなくします。
デプロイメントBaseten Categories
Baseten Jobs
Baseten Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Release.ai
Release.aiは、開発者が高性能AIモデルを容易にデプロイ、管理、スケールさせるためのエンタープライズグレードのプラットフォームです。100ms未満の推論レイテンシ、シームレスな自動スケーリング、堅牢なセキュリティ、および事前最適化されたモデルの広範なライブラリを提供し、わずか数行のコードで任何の開発ワークフローに迅速に統合できます。
サービスとしてのプラットフォーム (PaaS)
AI News Hub
AI News Hubは、エージェントAI、RAG、およびプロダクションツールに関するリアルタイムのAI発表と厳選されたブログ更新を提供する包括的なプラットフォームです。パーソナライズされたフィード、ブックマーク機能、そしてロードマップ、コース、ビデオなどの豊富な学習リソースを提供し、開発者や愛好家が急速に進化するAI分野で情報とスキルを維持できるよう支援します。
Aggregation

Tensorfuse
Tensorfuseは、開発者が自身のAWSクラウド上で生成AIモデルのファインチューニング、デプロイ、オートスケーリングを行えるようにするサーバーレスGPUプラットフォームです。インフラ管理を簡素化し、サーバーレス推論、ジョブキュー、開発コンテナなどの機能を提供して、開発を加速し、コストを削減し、DevOpsのオーバーヘッドをなくします。
デプロイメント
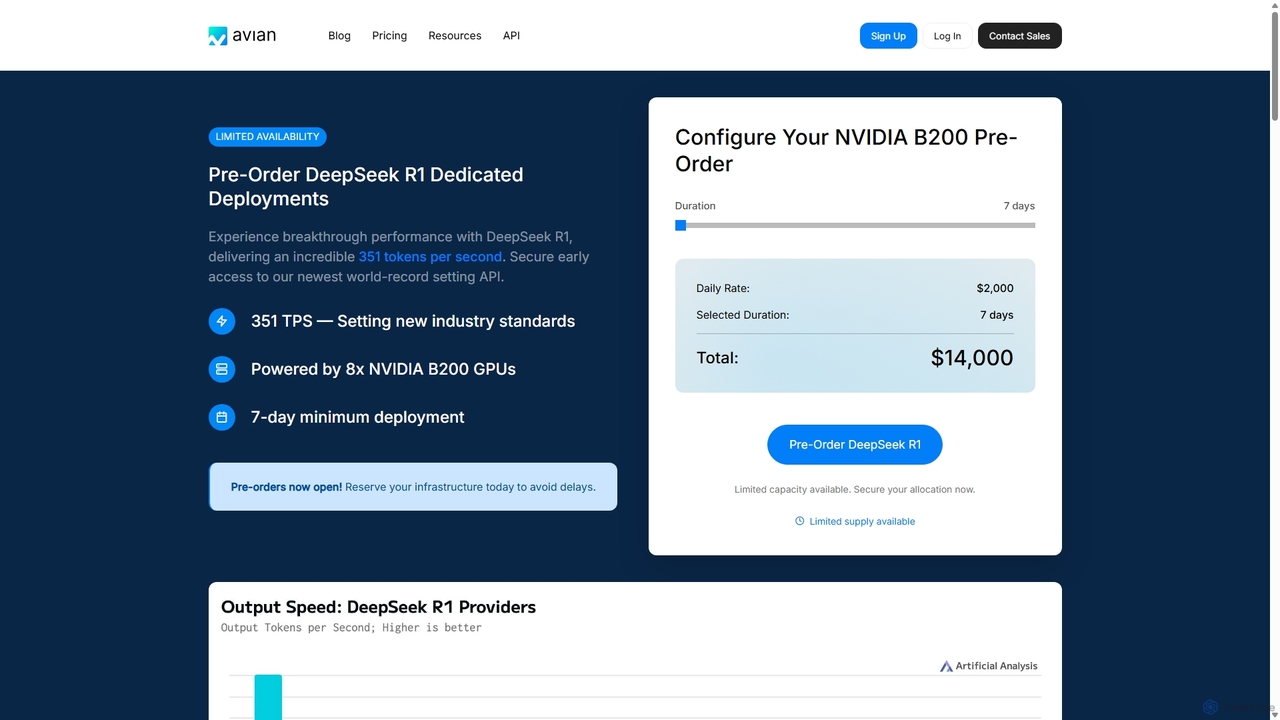
Avian
Avianは、大規模言語モデル(LLM)向けに世界記録レベルの速度を提供する高性能AI推論プラットフォームです。人気のモデル向けのサーバーレスAPIと、HuggingFaceのカスタムモデル向けの専用GPUデプロイメントの両方を提供します。スケーラビリティと本番ワークロード向けに設計されており、業界平均の3〜10倍の推論速度を実現し、エンタープライズレベルのセキュリティと競争力のある価格設定を特徴としています。
モデルデプロイメント
UltiHash
UltiHashは、AIおよびビッグデータワークロード向けに特別に構築された、高性能なKubernetesネイティブのオブジェクトストレージプラットフォームです。高度なバイトレベルの重複排除により、超高速のデータアクセスと大幅なコスト削減を実現し、クラウド、オンプレミス、ハイブリッド環境での柔軟なデプロイをサポートします。S3互換APIにより、既存のデータスタックやAIワークフローとのシームレスな統合が保証されます。
機械学習オペレーション
Shakespeare
Shakespeareは、開発者がカスタムAIアプリケーションを作成するために設計されたオープンソースのAIビルダーです。様々なAIモデルを選択して活用できるプラットフォームを提供し、インテリジェントなソリューションの迅速な開発と展開を可能にします。
AI開発
Custom Vision
Microsoft AzureのAIサービスで、独自のカスタム画像分類器や物体検出器を構築、デプロイ、改善できます。専門的な機械学習の知識がなくても、使いやすいインターフェースと強力なREST APIで、特定のニーズに合わせた最先端のコンピュータービジョンモデルを簡単に作成できます。
機械学習
AIGoMarket
AIGoMarketは、エッジAI開発を民主化するために設計されたエッジAIファウンドリおよびマーケットプレイスです。クリエイターは最適化されたAIモデルをアップロードして収益化でき、開発者にはさまざまなエッジデバイスやアプリケーション向けに高性能AIソリューションを発見、ライセンス、デプロイするためのプラットフォームを提供します。
Model Marketplace
Baseten Comments (0)
Sign in to comment.
ログインNo comments yet.