

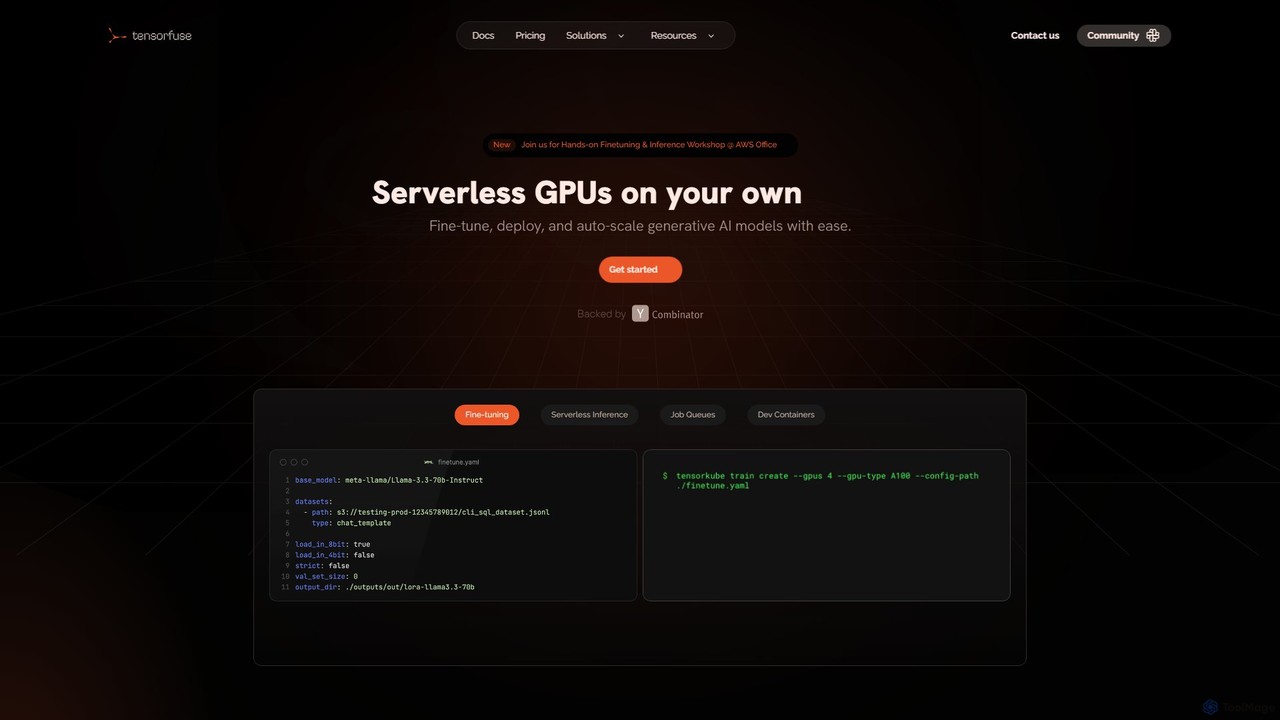
Tensorfuse Overview
Tensorfuseは、開発者や組織が自身のAWSクラウドインフラストラクチャ上で直接サーバーレスGPUを管理するための強力なプラットフォームを提供します。生成AIモデルのライフサイクル全体、つまりファインチューニングや実験から本番環境でのデプロイやオートスケーリングまでを効率化するように設計されています。Kubernetes、Docker、インフラプロビジョニングの複雑さを抽象化することで、TensorfuseはチームがAIアプリケーションの構築に集中できるようにし、市場投入までの時間を大幅に短縮し、運用コストを削減します。
このプラットフォームは、サーバーレスアーキテクチャのシンプルさと、プライベートクラウド上での実行によるセキュリティと制御という、両方の長所を提供するように構築されています。これにより、独自のデータとモデルの重みはプライベートS3バケットから出ることがなく、最大限のセキュリティとコンプライアンスが保証されます。Tensorfuseは効率性を追求して設計されており、最適化されたコンテナランタイムにより、重いGPUワークロードでも高速なコールドスタートが可能になり、サービスを数秒でゼロからスケールアップできます。
Tensorfuseの使い方
Tensorfuseの利用開始は、簡単なプロセスになるように設計されています:
- サインアップとAWS接続: まず、プラン(無料の「Hacker」ティアを含む)にサインアップし、AWSアカウントを接続します。その後、Tensorfuseがクラウド環境内に必要なリソースをセットアップします。
- 開発コンテナを使用した実験: Tensorfuseの開発コンテナを使用して、ローカルIDE(VS Codeなど)をクラウドGPUに直接接続します。これにより、SSH、コードのコピー、依存関係の管理が不要になります。ローカルコードへの変更は即座に同期され、迅速なリアルタイム実験が可能になります。
- モデルのファインチューニング: Axolotl、Unsloth、Hugging Faceなどの一般的なトレーニングライブラリを利用して、独自のデータセットでオープンソースモデルをファインチューニングします。カスタムのトレーニングループを作成することもできます。プラットフォームが基盤となるGPUのプロビジョニングと管理を処理します。
- 推論のためのデプロイ: トレーニング済みまたは事前トレーニング済みのモデルをサーバーレスエンドポイントとしてデプロイします。これらのエンドポイントは、受信トラフィックに基づいて自動的にスケーリングし、ゼロから高同時実行性を処理するように拡張されるため、コスト効率とパフォーマンスが保証されます。モデルはOpenAI互換のAPIとして公開できます。
- ジョブキューによる管理: バッチ処理やオフライン推論などの非同期タスクには、ジョブキュー機能を使用します。プログラムでジョブをキューに入れ、効率的なリソース割り当てのために最小および最大スケーリングパラメータを定義し、簡単なCLIコマンドでステータスを監視できます。
Tensorfuseの主な機能
- サーバーレス推論: トラフィックに応じてGPUデプロイメントを自動的にスケーリングし、高速なコールドスタート(数秒でコンテナを起動)とコスト削減のためにゼロにスケールダウンする機能を備えています。
- 効率的なファインチューニング: クラウドのS3を使用して、プライベートデータでモデルを安全にファインチューニングします。AxolotlやHuggingfaceなどの一般的なフレームワークとの柔軟な統合を提供します。
- ジョブキュー: バッチ処理のためにプログラムでジョブをデプロイおよびキューに入れ、設定可能なスケーリングにより効率的なリソース割り当てとコスト管理を実現します。
- 開発コンテナ: SSHなしでローカルコードをクラウドGPUに接続し、お気に入りのIDEから直接、迅速で反復的な開発と実験を行います。
- マルチLoRA推論: 単一のGPUで数千のLoRAアダプタをトレーニングおよびホットスワップするための標準サポートにより、ハードウェア使用率を最大化し、推論コストを削減します。
- 幅広いハードウェアサポート: NVIDIA GPU(A10G、A100、H100)、AWS Trainium/Inferentiaチップ、TPU、FPGAなど、さまざまなハードウェアでワークロードを実行します。
- プライベートクラウドセキュリティ: すべてのデータ、データセット、モデルの重みはプライベートAWS S3バケット内に保持され、完全な制御とセキュリティを保証します。
Tensorfuseの使用例
Tensorfuseは、幅広いAI/MLアプリケーションに最適です:
- スタートアップと小規模チーム: 専門のDevOpsチームなしでAI搭載機能を迅速に構築・デプロイし、アイデアから本番までを20倍速くします。
- 大規模推論: スパイクのある、または予測不可能なトラフィックを持つアプリケーション向けに生成AIモデルを提供し、使用した計算量に対してのみ支払います。
- カスタムモデルのファインチューニング: 企業は、LlamaやMistralなどのベースモデルを独自のデータでファインチューニングし、特定のビジネスニーズに合わせた専門的で高性能なモデルを作成できます。
- バッチ処理ワークロード: コスト効率の高いジョブキューシステムを使用して、データ分析、レポート生成、大規模なオフライン推論などの非リアルタイムタスクを効率的に実行します。
- MLの研究と実験: 研究者やMLエンジニアは、開発コンテナを使用して、インフラ設定を待つことなくモデルを迅速に反復できます。
Tensorfuseの利点
ユーザーがTensorfuseを選ぶ理由は、クラウドGPU支出を30%削減し、製品化までの時間を20倍短縮するという大きな利点があるためです。複雑な自己管理のDevOpsソリューションの必要性をなくし、エンジニアリングリソースを解放します。このプラットフォームは、マネージドサービスのパフォーマンスとスケーラビリティを提供しつつ、自社のクラウドで実行することによるセキュリティとコストの利点も兼ね備えています。顧客の声では、移行や継続的な問題を支援する卓越した迅速なサポートチームが強調されており、オンボーディングプロセスがスムーズかつ効率的になります。
料金プラン
Tensorfuseは、さまざまなニーズに合わせて階層化された料金体系を提供しています:
- Hacker(無料): 個人開発者やサイドプロジェクト向け。100 MGH(管理GPU時間)、サーバーレス推論、開発コンテナ、コミュニティサポートが含まれます。
- Starter(月額$249): 小規模チーム向け。2,000 MGH、すべてのHacker機能に加え、ファインチューニング、GitHub Actions、カスタムドメイン、プライベートSlackサポートが含まれます。14日間の無料トライアルが利用可能です。
- Growth(月額$799): 成長中のスタートアップ向け。5,000 MGH、すべてのStarter機能に加え、バッチジョブ&ジョブキュー、環境、マルチLoRA推論、プレミアムサポートが含まれます。14日間の無料トライアルが利用可能です。
- Enterprise(カスタム): 高度な機能を必要とする大企業向け。ボリュームディスカウント付きのカスタムMGH、すべてのGrowth機能に加え、ロールベースのアクセス制御(RBAC)、SSO、エンタープライズグレードのセキュリティ(SOC2、HIPAA)、専任のエンジニアリングサポートが含まれます。
- スタートアップディール: 資金調達額が50万ドル未満の初期段階のスタートアップは、6か月間10,000時間の無料GPUコンピューティング管理の対象となる場合があります。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 10.1K
- 2026-1: 5.4K
- 2026-2: 4.2K
- 2026-3: 4.9K
- 2026-4: 5.3K
- 2026-5: 6.7K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国38.2%
- 🇻🇳ベトナム36.6%
- 🇮🇳インド25.2%
Top keywords
| Keyword | Cost per click |
|---|---|
| aws serverless gpu | $0.00 |
| brew install aws cli | $4.38 |
| llama.cpp serverless | $0.00 |
| llm inference servers compared: vllm vs tgi vs sglang vs triton | $0.00 |
| tensorfuse | $18.26 |
Tensorfuse Alternatives
Tensorfuse Categories
Tensorfuse Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools



dstack
dstackは、AIおよびMLチーム向けに設計されたオープンソースのコンテナオーケストレーターです。ワークロードのオーケストレーションを簡素化し、あらゆるクラウドプロバイダー、オンプレミスクラスター、または高速化されたハードウェアでGPUの利用率を最大化します。統一されたコンピューティングレイヤーを提供し、開発、トレーニング、モデルのデプロイを効率化します。
オーケストレーション
GPUX
GPUXは、高速で手頃なAIモデルの推論を実現するサーバーレス・分散型GPUクラウドプラットフォームです。開発者はAPI経由でモデルを実行でき、GPU所有者はP2Pネットワークにハードウェアを提供することで収益を得ることができます。
モデルデプロイメント
CircleCI
CircleCIは、ソフトウェア開発プロセスを自動化する、業界をリードする継続的インテグレーションおよび継続的デリバリー(CI/CD)プラットフォームです。エンジニアリングチームがコードを迅速、確実、かつ大規模にビルド、テスト、デプロイできるようにし、すべてのリリースで生産性と信頼性を向上させます。
インフラストラクチャ管理
Together AI
Together AIは、開発者向けの主要なクラウドプラットフォームであり、オープンソースの生成AIモデルを実行、ファインチューニング、トレーニングするための高速でコスト効率の高いインフラストラクチャを提供します。200以上のモデルの広範なライブラリ、サーバーレス推論API、カスタマイズ可能なファインチューニング、専用GPUクラスタを提供し、AIアプリケーションの構築とスケーリングのためのエンドツーエンドソリューションを構築します。
GPUインフラ
ComfyOnline
高価なハードウェアなしでComfyUIワークフローをオンラインで実行するためのクラウドベースのプラットフォームです。サーバーレス環境、AIアプリケーション向けのワンクリックAPIデプロイ、H100やA100などの高性能GPUへの従量課金制アクセスを提供します。ワークフロー作成からスケーラブルなデプロイまでの全プロセスを簡素化します。
API & インフラ
ComfyDeploy
ComfyDeployは、チームがComfyUIワークフローを構築、共有、スケールするためのクラウドプラットフォームです。ワンクリックでの本番APIデプロイ、自動スケーリングGPUインフラ、非技術者向けの簡素化されたインターフェースを提供します。エンジニアリングのオーバーヘッドなしで、シームレスに協力し、カスタムノードやモデルを管理し、複雑なクリエイティブプロセスをスケーラブルなアプリケーションに変えます。
モデルデプロイメント
Release.ai
Release.aiは、開発者が高性能AIモデルを容易にデプロイ、管理、スケールさせるためのエンタープライズグレードのプラットフォームです。100ms未満の推論レイテンシ、シームレスな自動スケーリング、堅牢なセキュリティ、および事前最適化されたモデルの広範なライブラリを提供し、わずか数行のコードで任何の開発ワークフローに迅速に統合できます。
サービスとしてのプラットフォーム (PaaS)
LastMile AI
LastMile AIは、生成AIアプリケーションをテスト、評価、監視するためのエンタープライズグレードの開発者プラットフォームです。カスタム評価器のファインチューニング、合成データ生成、リアルタイム監視のためのAutoEvalなどのツールを提供し、AIシステムの信頼性と本番環境への準備を確実にします。
モデル評価
MonsterAPI
MonsterAPIは、オープンソースの生成AIモデルのファインチューニングとデプロイを簡素化する開発者中心のプラットフォームです。Llama、SDXL、Whisperなどのモデルをサポートするノーコードのチャットインターフェース「MonsterGPT」を提供します。このプラットフォームは、スケーラブルなAPIエンドポイントとエンタープライズ級のGPUインフラを、従来の数分の一のコストと時間で提供し、高度なAIをすべての開発者が利用できるようにします。
サービスとしてのプラットフォーム (PaaS)
Tensorfuse Comments (0)
Sign in to comment.
ログインNo comments yet.