
Dagster Overview
Dagsterは、データ開発ライフサイクル全体を対象とした次世代のオープンソースオーケストレーターです。データおよびAIパイプラインの統一されたコントロールプレーンとして機能し、チームが前例のない自信を持ってワークフローを構築、スケーリング、監視できるようにします。従来のタスクベースのスケジューラを超え、Dagsterはデータアウェアなアセットベースのアプローチを導入しています。これは、テーブル、ファイル、レポート、機械学習モデルなどの計算の出力を第一級の市民として扱うことを意味します。この根本的な転換により、データプラットフォーム全体でより直感的な開発、強力なデバッグ、包括的な可観測性が可能になります。
現代のデータエンジニアリング向けに設計されたDagsterは、ソフトウェアエンジニアリングのベストプラクティスをデータワークフローに直接統合します。開発者はパイプラインをローカルでテストし、ステージング環境のためにブランチベースのデプロイメントを活用し、再利用可能なコンポーネントで構築することができ、開発速度と信頼性を劇的に向上させます。異なるツールやチームを統一し、ガバナンスや品質を犠牲にすることなくプラットフォーム全体の可視性を提供するように構築されており、データのサイロ化を解消しようとするハイパフォーマンスな組織にとって理想的なソリューションです。
Dagsterの使い方
Dagsterの使用には、開発から本番までベストプラクティスを推進する開発者中心のワークフローが含まれます:
- Pythonでアセットを定義する:まず、DagsterのPython APIを使用してデータアセットを宣言的に定義します。アセットはデータベーステーブル、S3ファイル、またはMLモデルなどです。アセットを計算する関数とその上流のアセット依存関係を定義します。
- ローカルでの開発とテスト:Dagsterのアーキテクチャはローカル開発のために構築されています。本番同様の環境にデプロイすることなく、ローカルマシンでパイプライン全体または個々のアセットを実行・テストし、迅速にイテレーションできます。
- スタックの統合:豊富な統合ライブラリを使用して、Dagsterを既存のデータスタックに接続します。Snowflake、dbt、Spark、Databricks、またはAWSやAzureなどのクラウドサービスを使用していても、Dagsterは中央のオーケストレーションレイヤーとして機能します。
- 自信を持ったデプロイ:ブランチデプロイメントのような最新のデプロイメントパターンを活用して、変更のための隔離されたステージング環境を作成します。DagsterのCI/CDネイティブなワークフローにより、自信を持ってコードを本番環境にデプロイできます。
- 監視と保守:Dagster UIを使用して、データプラットフォームの全体像を把握します。エンドツーエンドのデータリネージを視覚化し、アセットの鮮度と健全性を監視し、実行履歴を調査し、障害をデバッグします。プラットフォームはまた、データインフラストラクチャの支出を管理・最適化するためのコストインサイトも提供します。
Dagsterの主な機能
- データアウェアなオーケストレーション:単にスケジュールに従ってタスクを実行するのではなく、Dagsterはそれらが生成するデータアセットを理解します。データ更新に基づいてインテリジェントに実行をトリガーし、パーティション化されたデータを管理し、増分更新を効率的に実行できます。
- 統合されたデータカタログとリネージ:Dagsterはコードからリッチなリアルタイムのデータカタログを自動的に生成します。すべてのアセット、そのメタデータ、および上流/下流の関係の統一されたビューを提供し、データディスカバリと影響分析を簡素化します。
- 組み込みのデータ品質と可観測性:データ品質チェックをアセット定義内に直接埋め込みます。アセットの鮮度を監視してデータが最新であることを確認し、組み込みツールを使用して各データセットの整合性、コンプライアンス、透明性を追跡します。
- 開発者第一の体験:Dagsterの核となる原則は、開発者が愛する体験を提供することです。これには、ローカルテスト、型チェック、クリーンなPython API、デバッグを容易にするツールが含まれます。
- コストインサイト:データおよびAIパイプラインのコストに対する可視性を得ます。Dagsterは各アセットに関連する計算およびストレージコストを追跡し、非効率性を特定して予算を最適化するのに役立ちます。
- 豊富な統合:豊富な統合エコシステムにより、Dagsterはdbt、Snowflake、Databricks、Spark、Kubernetesなど、スタック全体のジョブをオーケストレーションできます。
- スケーラブルで再利用可能なコンポーネント:モジュール式で再利用可能なコンポーネント(「ops」および「graphs」として知られる)からパイプラインを構築し、ボイラープレートコードを回避し、チームが新しいデータ製品をより迅速に構築できるようにします。
Dagsterの使用例
Dagsterは多用途であり、幅広いシナリオに適用できます:
- 現代のデータプラットフォーム:分析、ビジネスインテリジェンス、運用レポートのための堅牢なエンドツーエンドのデータプラットフォームを構築・管理します。
- AIおよび機械学習パイプライン:データインジェストや特徴量エンジニアリングからモデルのトレーニング、検証、デプロイまで、完全なMLライフサイクルをオーケストレーションします。
- レガシースタックの近代化:cronジョブや古いオーケストレーター(例:Airflow)のような脆弱で保守が困難なシステムから、現代的で信頼性が高く、スケーラブルなプラットフォームに移行します。
- データセルフサービスの実現:再利用可能なコンポーネントを備えた中央集権的なプラットフォームを作成し、さまざまなチーム(例:分析、データサイエンス)が深いインフラ知識を必要とせずに独自のデータパイプラインを構築・管理できるようにします。
- データガバナンスとコンプライアンス:自動化されたリネージとメタデータ追跡を使用して、データの整合性を確保し、データ使用を監査し、GDPRなどの規制に準拠します。
Dagsterの利点
Dagsterは、従来のデータオーケストレーターに比べて大きな利点を提供します:
- 開発速度の向上:ローカル開発、テスト、再利用性に重点を置くことで、チームはより迅速にイテレーションとリリースができます。
- 信頼性の向上:アセットベースのアプローチと組み込みのデータ品質チェックにより、より堅牢で信頼性の高いパイプラインが実現します。
- 統一された可視性:リネージ、健全性、メタデータのための単一の画面がサイロを打破し、データプラットフォームの全体像を提供します。
- 認知負荷の軽減:データアセットのモデリングはタスクのモデリングよりも直感的であり、複雑なパイプラインの理解、デバッグ、保守が容易になります。
- 未来志向のアーキテクチャ:Dagsterの柔軟で統合しやすい設計により、特定のベンダーや技術にロックインされることなく、データスタックを進化させることができます。
料金プラン
Dagsterはフリーミアムモデルで運営されています。Dagsterオープンソースは、セルフホストしてカスタマイズできる強力で無料のフレームワークです。マネージドでエンタープライズ対応のソリューションを求めるユーザー向けに、Dagster+は商用のクラウドサービスです。Dagster+は、フルマネージドのコントロールプレーン、サーバーレスデプロイメントオプション、コストインサイトやアセットヘルスモニタリングなどの高度な機能、エンタープライズグレードのセキュリティ、専用サポートを提供します。Dagster+は通常、個人や小規模チーム向けの無料トライアルまたは無料ティアを提供し、大規模組織向けのスケーラブルな料金設定があります。最も正確で詳細な料金情報については、Dagsterの公式ウェブサイトを訪れることをお勧めします。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 186.0K
- 2026-1: 178.3K
- 2026-2: 157.2K
- 2026-3: 174.0K
- 2026-4: 182.3K
- 2026-5: 152.3K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国42.9%
- 🇨🇳中国29.1%
- 🇬🇧イギリス12.4%
- 🇻🇳ベトナム8.5%
- 🇨🇭スイス7.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 70.2% |
Referral | 25.8% |
Email | 4.0% |
Top keywords
| Keyword | Cost per click |
|---|---|
| airflow | $1.60 |
| dagster | $1.72 |
| dagster dashboard | $0.00 |
| prefect | $2.14 |
| rdd | $2.58 |
Dagster Videos on YouTube

Dagster



Dagster Alternatives
Orchestra
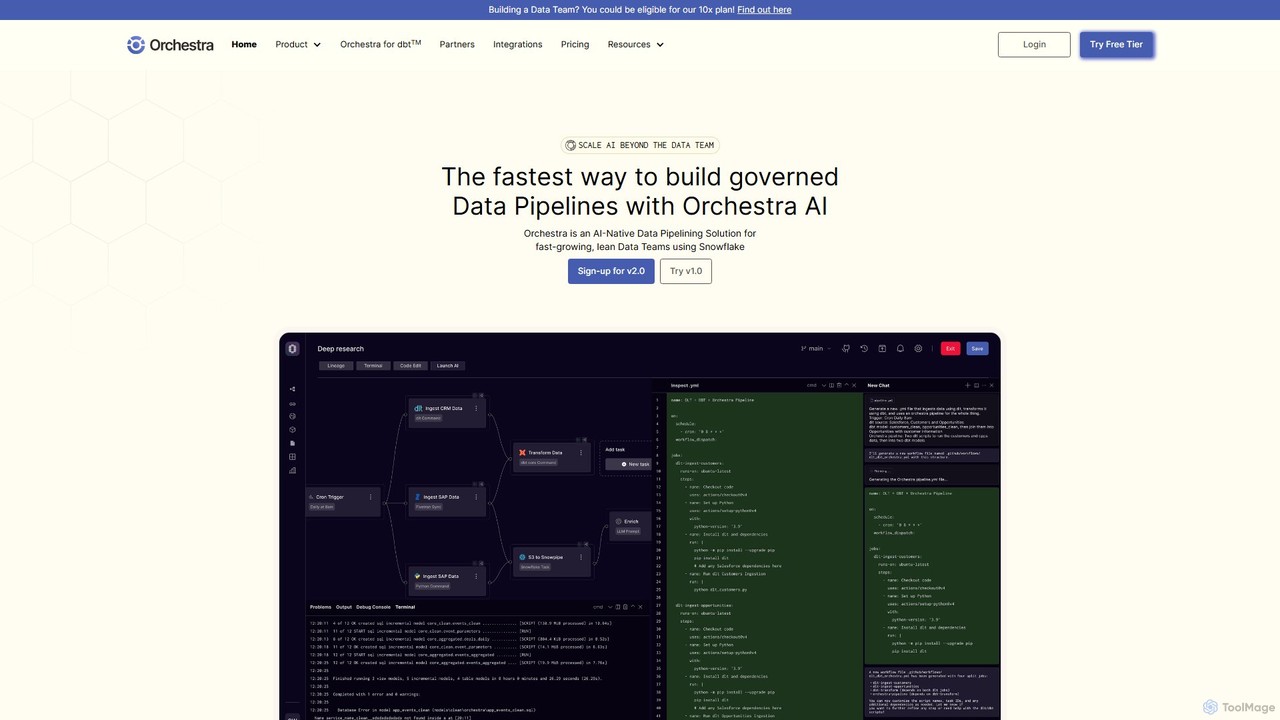
Orchestraは、リーンなデータチーム向けに設計された、データオーケストレーションとパイプライン化のための統合管理プレーンです。エンドツーエンドの可観測性、プロアクティブなアラート、広範な統合を備えた、ガバナンスの効いたデータパイプラインを構築、監視、管理するためのAIネイティブソリューションを提供します。複雑なデータワークフローを簡素化し、メンテナンス時間を削減し、データの信頼性とAI対応を保証します。
ビジネスインテリジェンス

Flyte
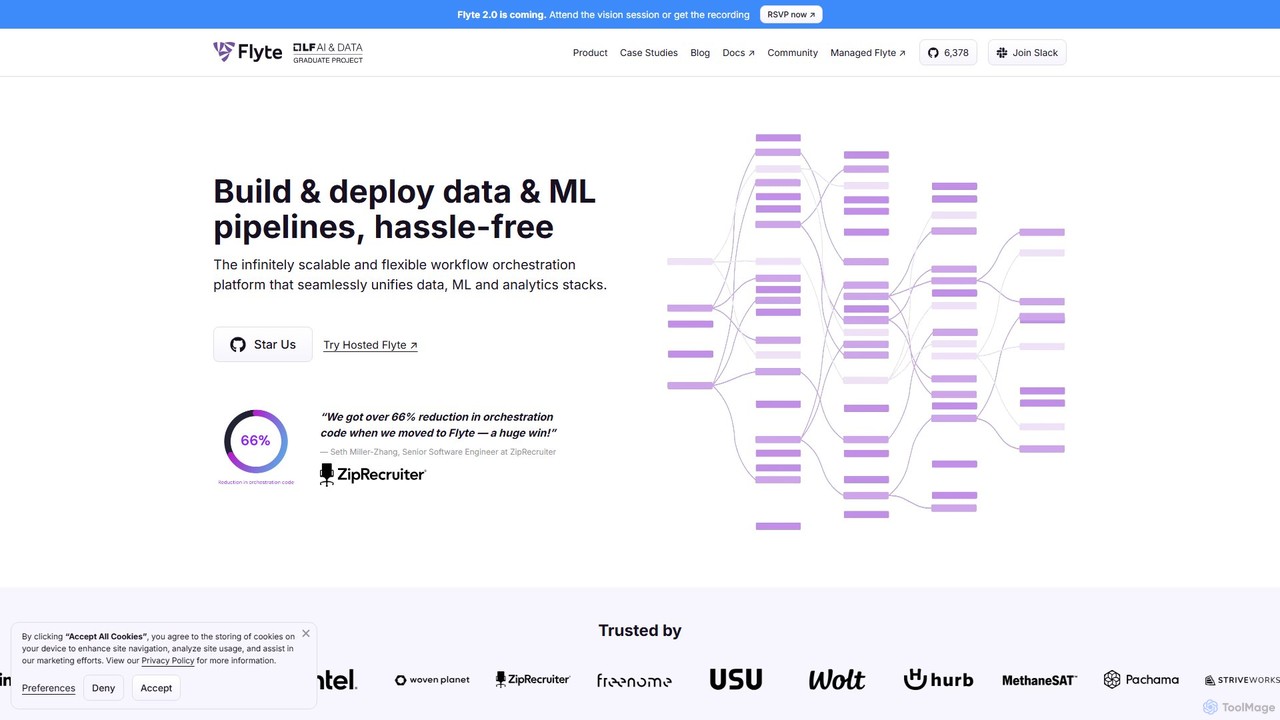
Flyteは、本番環境グレードのデータ、機械学習、分析パイプラインを構築、デプロイ、管理するために設計された、オープンソースのクラウドネイティブなワークフローオーケストレーションプラットフォームです。スケーラビリティ、再現性、使いやすさを重視しており、チームがローカル開発から大規模な本番環境へシームレスに移行できるようにします。PythonファーストのSDKと多言語サポートにより、Flyteはデータサイエンティストやエンジニアが複雑でバージョン管理された、保守性の高いワークフローを作成することを可能にします。
MLOpsDagster Categories
Dagster Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Orchestra
Orchestraは、リーンなデータチーム向けに設計された、データオーケストレーションとパイプライン化のための統合管理プレーンです。エンドツーエンドの可観測性、プロアクティブなアラート、広範な統合を備えた、ガバナンスの効いたデータパイプラインを構築、監視、管理するためのAIネイティブソリューションを提供します。複雑なデータワークフローを簡素化し、メンテナンス時間を削減し、データの信頼性とAI対応を保証します。
ビジネスインテリジェンスFlyte
Flyteは、本番環境グレードのデータ、機械学習、分析パイプラインを構築、デプロイ、管理するために設計された、オープンソースのクラウドネイティブなワークフローオーケストレーションプラットフォームです。スケーラビリティ、再現性、使いやすさを重視しており、チームがローカル開発から大規模な本番環境へシームレスに移行できるようにします。PythonファーストのSDKと多言語サポートにより、Flyteはデータサイエンティストやエンジニアが複雑でバージョン管理された、保守性の高いワークフローを作成することを可能にします。
MLOps
Ask On Data
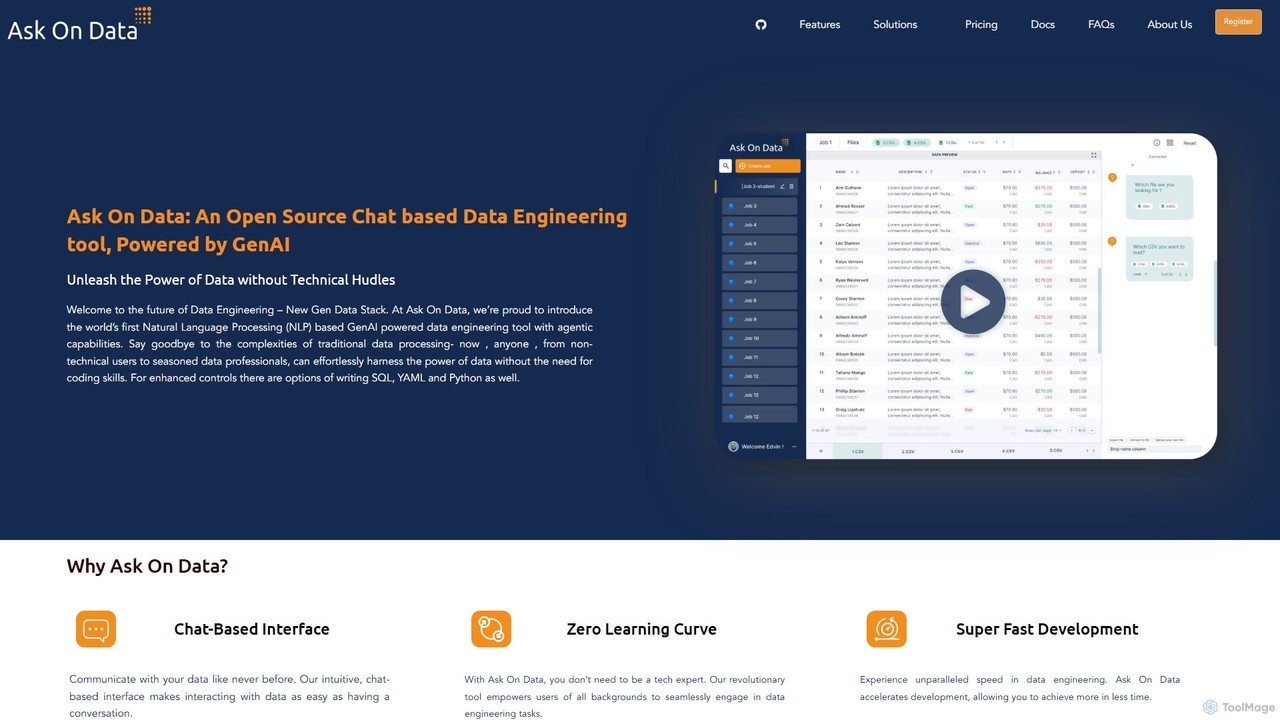
Ask On Dataは、オープンソースの生成AI搭載データエンジニアリングツールで、簡単なチャットインターフェースを使ってデータパイプラインを構築・管理できます。自然言語のコマンドを複雑なデータ操作に変換することで、コーディングの必要性をなくし、誰もがデータエンジニアリングにアクセスできるようにします。多様なデータソースをサポートし、リアルタイムプレビューを提供し、クラウドホスト型とセルフホスト型の両方のオプションを提供します。
ETL
ProjectPro
ProjectProは、データ専門家のキャリアアップを支援するために設計されたプロジェクトベースの学習プラットフォームです。データサイエンス、ビッグデータ、AI、MLOpsの分野で250以上のエンドツーエンドの業界レベルのプロジェクトライブラリを提供しています。各プロジェクトには、検証済みのソリューションコード、詳細な解説ビデオ、クラウド演習環境、専門家によるサポートが含まれており、ユーザーが実際のビジネス問題や最先端技術を通じて実践的な経験を積むことができます。
データサイエンス

Dagster Comments (0)
Sign in to comment.
ログインNo comments yet.