
Fluidstack Overview
Fluidstackは、最先端のスタートアップから確立された大企業まで、世界で最も野心的なAIチームに高性能なGPUインフラストラクチャを提供するために設計された、専門のAIクラウドプラットフォームです。このプラットフォームの核心的な使命は、大規模GPUクラスタの設定と管理に伴う複雑さと遅延を排除し、研究者や開発者がモデル開発とイノベーションに完全に集中できるようにすることです。Fluidstackは、理論性能の95%以上を達成するようにベンチマークされたフルマネージドの専用GPUクラスタを提供し、要求の厳しいAIワークロードに対して最大限のスループットを保証します。
poolsideのような主要なAIラボや企業から信頼されているFluidstackは、従来のハイパースケーラーが数ヶ月かかるのとは対照的に、NVIDIA H100やA100などの数千台のGPUを数日で展開できる能力を証明しています。このプラットフォームは、高速なプロビジョニングを実現するAtlas OSや、問題の事前検知と自動修復を行うLighthouse監視システムなど、専用に構築されたスタック上で動作し、高い稼働率と信頼性を保証します。
Fluidstackの使い方
Fluidstackの利用開始は、本格的なAI開発のために設計された、合理的なコンサルティングプロセスです。
- コンサルテーション:まず、ウェブサイトを通じてFluidstackの専門家チームに連絡し、必要なGPUの数と種類、プロジェクトのタイムライン、規模など、特定の計算ニーズについて相談します。
- クラスタ設計:Fluidstackのエンジニアが協力し、大規模なモデルトレーニングや高スループットの推論など、お客様のワークロードに最適化されたカスタムの専用GPUクラスタを設計します。
- 迅速な展開:契約が締結されると、Fluidstackが専用クラスタをプロビジョニングします。このプロセスは非常に速く、数千台のGPUの展開が48時間以内に可能です。
- アクセスと統合:SLURMやKubernetesなどの標準的なオーケストレーションツールを介して、フルマネージドのクラスタにアクセスします。Fluidstackがすべての設定、メンテナンス、アップグレードを処理するため、既存のワークフローにシームレスに統合できます。
- 継続的な管理:Fluidstackの24時間365日のハンズオンサポートとLighthouse監視プラットフォームを活用します。システムが問題を自動的に検出・解決し、複雑な問題に対してはエンジニアが15分の応答SLAで対応します。
Fluidstackの主な機能
- 専用GPUクラスタ:NVIDIA H100, H200, B200, GB200を含む最新のGPUアーキテクチャへのアクセスと、単一のファブリック上で12,000台以上のGPUにスケールする能力。
- Atlas OS:高速なプロビジョニング、スムーズなオーケストレーション、完全な所有権を可能にするAIインフラストラクチャ向けの独自のベアメタルOS。
- Lighthouse監視:ワークロードを監視、修復、最適化し、パフォーマンスに影響が出る前に問題をキャッチするプロアクティブな監視・自動修復プラットフォーム。
- フルマネージドサービス:設定、オーケストレーション(SLURMまたはKubernetes)、メンテナンス、アップグレードを含むクラスタのエンドツーエンド管理。
- 24時間365日の専門家によるエンジニアリングサポート:Slackを介して本物のエンジニアに直接アクセスでき、15分の応答時間SLAを保証し、専門的な回答とハンズオンサポートを提供。
- 高いセキュリティとコンプライアンス:インフラはデフォルトでシングルテナントであり、完全な分離を保証。プラットフォームはHIPAA, GDPR, ISO27001, SOC 2 Type I基準に準拠。
- 透明な価格設定:データ転送(egress/ingress)料金ゼロを含む隠れた費用がなく、ノード上のNVMeストレージも含まれています。
Fluidstackの使用例
Fluidstackは、要求が厳しく大規模なAI要件を持つ組織に最適です。
- 研究所:トップクラスの研究者がインフラの遅延をスキップし、AIモデル開発の限界を押し広げることに完全に集中できるようにします。
- エンタープライズAIチーム:ビジネスクリティカルなAIアプリケーションを大規模に実行するための、信頼性が高く、高性能で、コンプライアンスに準拠したクラスタを提供します。
- ソブリンAIイニシアチブ:国のAI能力を構築するために、完全な物理的および運用上のセキュリティを備えた、安全な地域固有の展開を提供します。
- 金融サービス:高速で安全な推論、定量的モデリング、リスク分析ワークロードを強化します。
- AIスタートアップ:poolsideのケーススタディが示すように、Fluidstackは動きの速いスタートアップが大規模なクラスタを迅速に展開し、市場投入までの時間を短縮し、多額の初期資本や長期契約なしで効率的にスケールアップすることを可能にします。
Fluidstackの利点
Fluidstackは、従来のクラウドプロバイダーに比べて大きな利点を提供します。
- 比類なきスピード:数千台のGPUクラスタを数ヶ月ではなく数日で展開。
- ピークパフォーマンス:クラスタは完全にバーンインされ、初日から理論性能の95%以上を発揮するようにベンチマークされています。
- 運用のシンプルさ:ハードウェア設定からKubernetesの設定まで、インフラ管理の複雑さからチームを解放します。
- コスト効率:予期せぬデータ転送料金のない透明な包括的価格設定により、より予測可能で、多くの場合、総所有コストが低くなります。
- 優れたサポート:階層化されたチケットシステムではなく、経験豊富なエンジニアによる直接的でパートナーシップスタイルのサポート。
料金プラン
Fluidstackは、さまざまなニーズに合わせて柔軟な価格モデルを提供しており、すべて透明で包括的な条件です。
- リザーブドクラスタ:30日以上の期間で大規模なトレーニングと推論用に設計されています。256台から10,000台以上のGPUに対して割引料金と保証されたリソースを提供します。価格は要問い合わせ。
- オンデマンド:柔軟なスケーリングニーズに対応し、5分以内にGPUインスタンスを起動し、8台から4,000台以上のGPUにスケールできます。時間単位で課金されます。
- プライベートクラウド:複雑なニーズ、特定の地域、またはカスタムスタック向けのカスタムビルドの専用クラスタ。
オンデマンドの時間料金例:
- NVIDIA H200 SXM:$2.30 / GPU / 時間
- NVIDIA H100 SXM:$2.10 / GPU / 時間
- NVIDIA A100 80GB SXM:$1.30 / GPU / 時間
すべてのプランには、24時間365日のエンジニアリングサポート、15分の応答SLA、マネージドSLURMまたはK8s、プロアクティブな監視、およびデータ転送(egress/ingress)料金ゼロが含まれています。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 28.9K
- 2026-1: 91.6K
- 2026-2: 69.4K
- 2026-3: 95.5K
- 2026-4: 101.0K
- 2026-5: 101.4K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国87.3%
- 🇬🇧イギリス7.0%
- 🇮🇳インド2.3%
- 🇨🇦カナダ1.8%
- 🇻🇳ベトナム1.6%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 77.9% |
Referral | 16.4% |
Email | 5.7% |
Top keywords
| Keyword | Cost per click |
|---|---|
| fluid stack | $5.80 |
| fluidstack | $4.65 |
| fluidstack careers | $3.31 |
| fluidstack jobs | $0.00 |
| fluidstack technical program manager, deployments | $0.00 |
Fluidstack Videos on YouTube

Vincent Private Markets
Cloud Computing Insider

BNN Bloomberg

AI INFRASTRUCTURE MEDIA

Fluidstack Alternatives
thundercompute
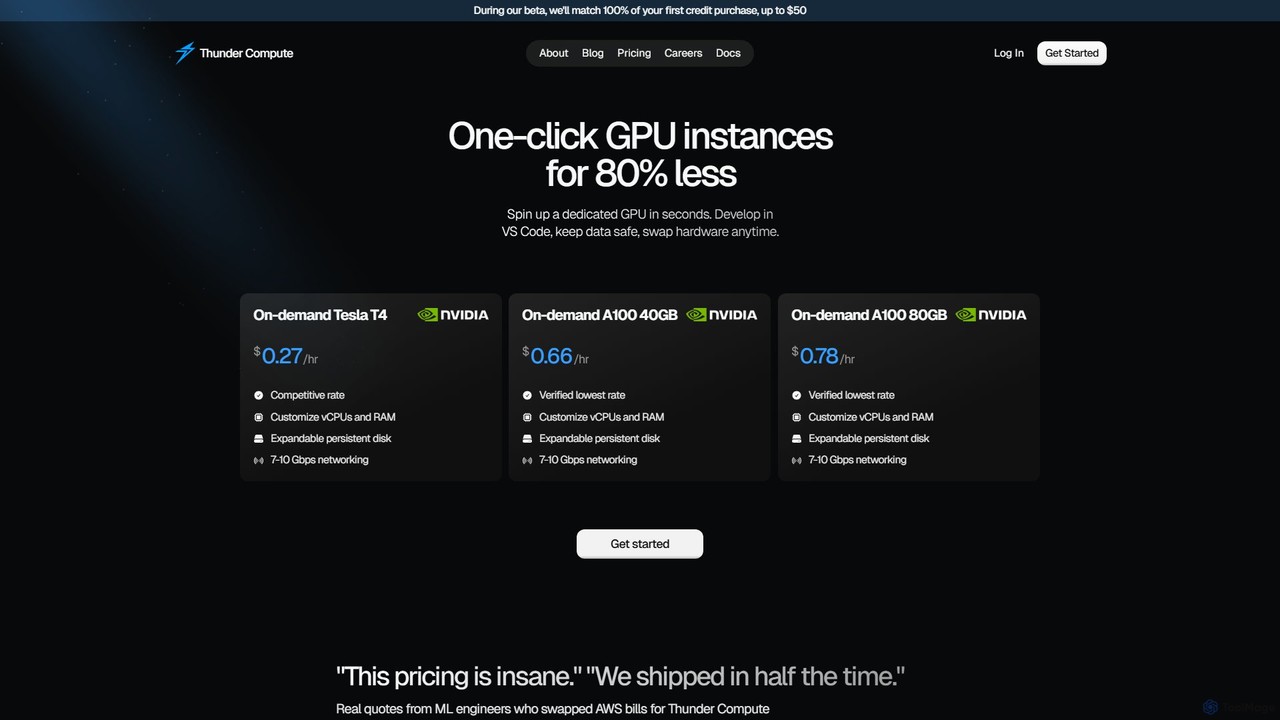
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習
massedcompute
Massed Computeは、オンデマンドで高性能なNVIDIA GPUとCPUを提供するクラウドプラットフォームです。AI開発、機械学習、ビッグデータ分析向けに、長期契約なしで柔軟かつスケーラブルで手頃なコンピューティングパワーを提供し、イノベーターや開発者を対象としています。
機械学習
HyperAI
HyperAIは、エンタープライズグレードのAIコンピューティングを誰もが利用できるように設計された、ヨーロッパを拠点とするハイパーローカルGPUクラウドプラットフォームです。スポットインスタンスや専用サーバーなどの柔軟なプランを通じて、高性能なNVIDIA A100およびH100 GPUを提供します。低遅延、データコンプライアンス、そしてプリインストールされたNvidia AI SDKを備えた開発者フレンドリーな環境に重点を置き、開発者や企業が複雑なAIモデルを効率的かつ安全に構築、トレーニング、デプロイできるよう支援します。
機械学習Fluidstack Categories
Fluidstack Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
thundercompute
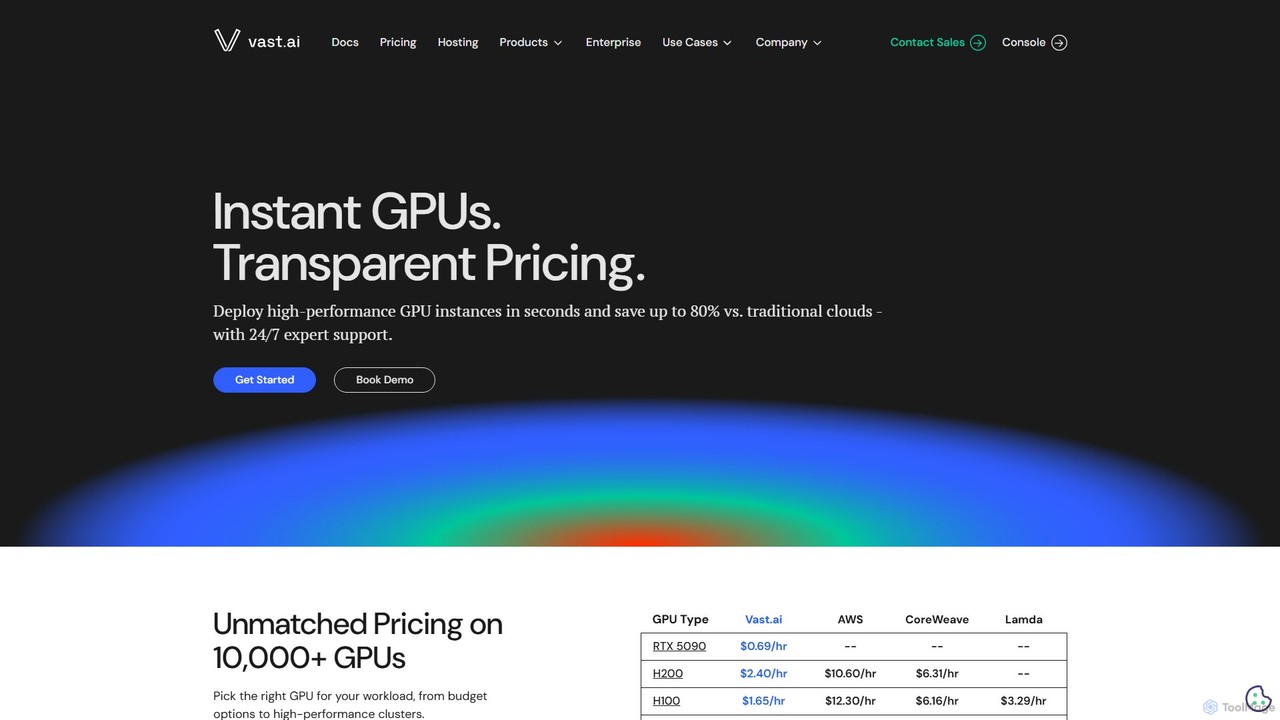
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習
Cirrascale Cloud Services
Cirrascaleは、大規模AI、ディープラーニング、およびハイパフォーマンスコンピューティング(HPC)向けに特化した高性能な専用GPUクラウドサービスを提供します。最新のNVIDIA GPUハードウェアとスケーラブルなインフラストラクチャへのアクセスを提供し、組織が巨大なモデルを効率的にトレーニングし、複雑な計算ワークロードを実行できるようにします。
モデルトレーニング
NeocloudX
NeocloudXは、GPUコンピューティング容量を商品化する革新的なマーケットプレイスであり、ユーザーはNVIDIA H100 SXM GPUのような高性能コンピューティングリソースを真の市場価格で売買・取引できます。ブラウザベースのコンソールを通じてベアメタル性能に即座にアクセスでき、従来のクラウドプロバイダーと比較して大幅なコスト削減を実現します。
機械学習インフラストラクチャmassedcompute
Massed Computeは、オンデマンドで高性能なNVIDIA GPUとCPUを提供するクラウドプラットフォームです。AI開発、機械学習、ビッグデータ分析向けに、長期契約なしで柔軟かつスケーラブルで手頃なコンピューティングパワーを提供し、イノベーターや開発者を対象としています。
機械学習
HyperAI
HyperAIは、エンタープライズグレードのAIコンピューティングを誰もが利用できるように設計された、ヨーロッパを拠点とするハイパーローカルGPUクラウドプラットフォームです。スポットインスタンスや専用サーバーなどの柔軟なプランを通じて、高性能なNVIDIA A100およびH100 GPUを提供します。低遅延、データコンプライアンス、そしてプリインストールされたNvidia AI SDKを備えた開発者フレンドリーな環境に重点を置き、開発者や企業が複雑なAIモデルを効率的かつ安全に構築、トレーニング、デプロイできるよう支援します。
機械学習
HIVE Digital Technologies
HIVE Digital Technologiesは、持続可能なデータセンターインフラのグローバルリーダーであり、大規模なビットコインマイニングとAIアプリケーション向けのハイパフォーマンスコンピューティング(HPC)の提供を専門としています。HIVEはNVIDIA GPUのフリートを活用し、カナダ、スウェーデン、パラグアイにある地理的に多様なデータセンターからの効率的なグリーンエネルギーで革新的な技術を支えています。
機械学習インフラ

Inferless
Inferlessは、開発者が数分で機械学習モデルをデプロイできるように設計されたサーバーレスGPUプラットフォームです。インフラ管理を不要にし、急増するワークロードに対応するためにゼロからの自動スケーリングを提供します。このプラットフォームは、超高速のコールドスタートとコスト効率に最適化されており、ユーザーは使用した分だけを支払い、GPU費用を最大90%節約できます。
機械学習のデプロイメント
Fluidstack Comments (0)
Sign in to comment.
ログインNo comments yet.