ToolMage
Entrar

AI TOOL COMPARISON

Baseten vs Tensorfuse

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

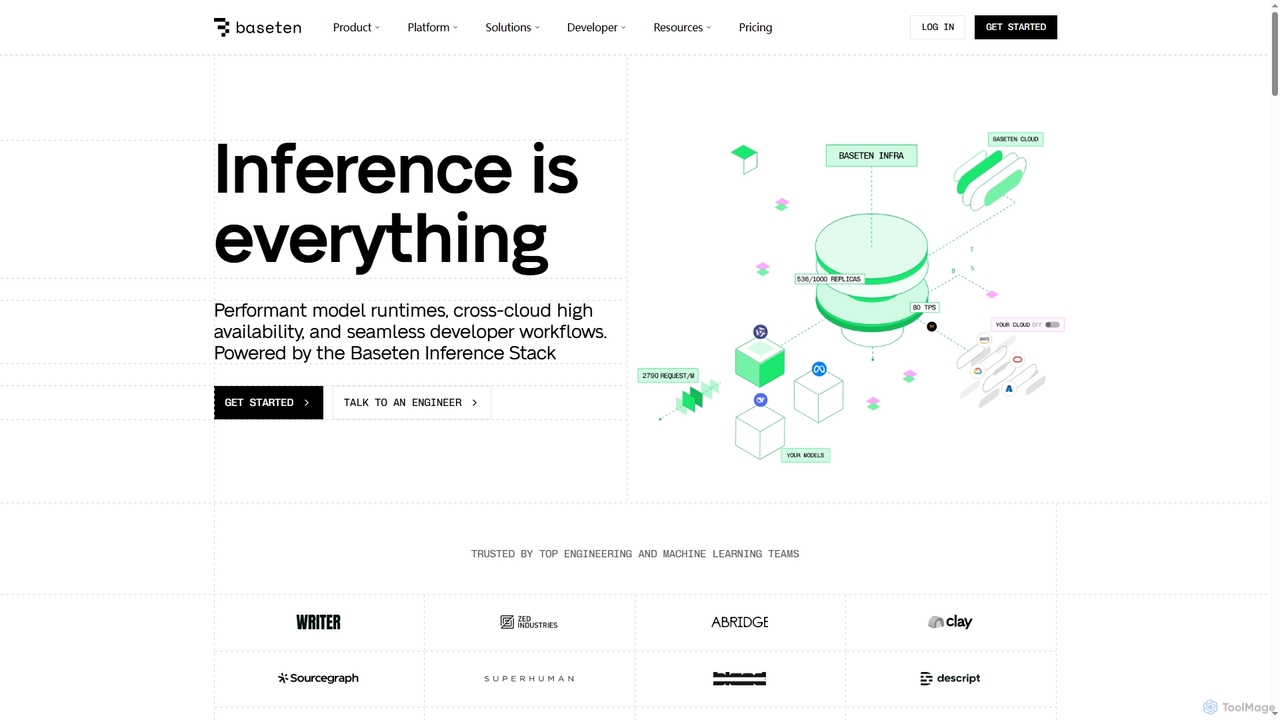
Baseten Visão geral

Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.

Preview

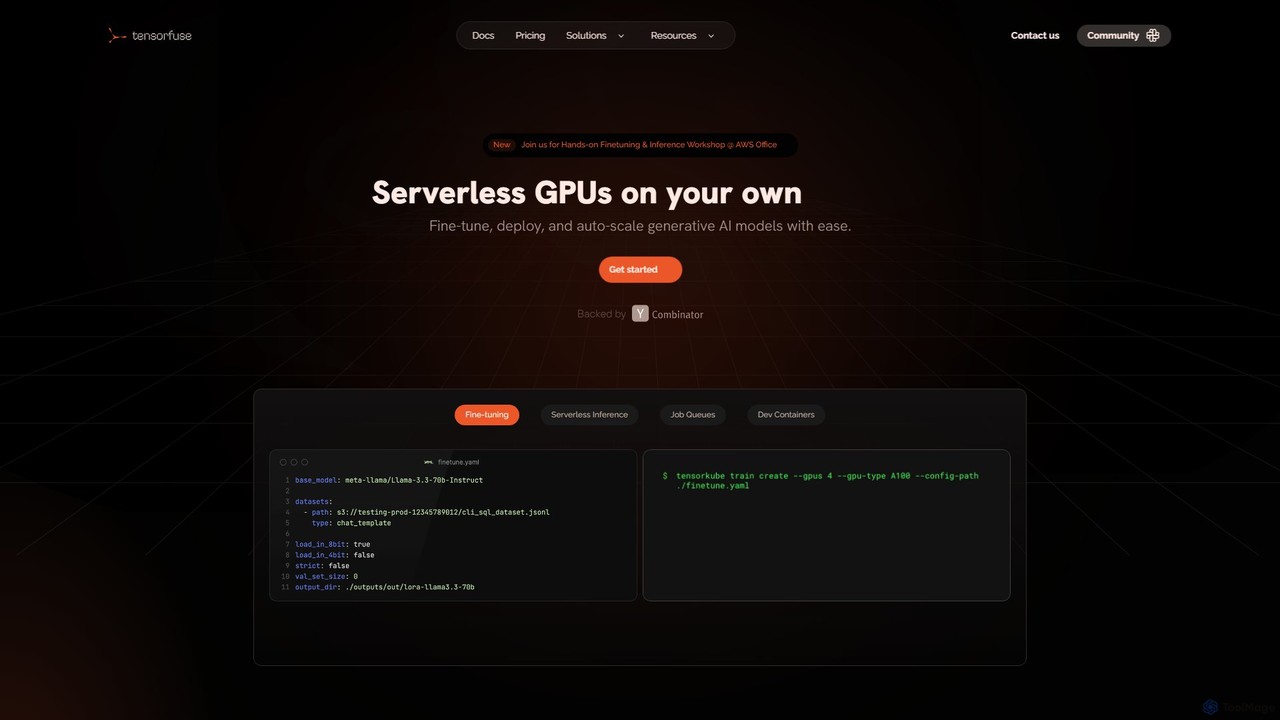
Tensorfuse Visão geral

O Tensorfuse é uma plataforma de GPU sem servidor que permite aos desenvolvedores ajustar, implantar e escalar automaticamente modelos de IA generativa em sua própria nuvem AWS. Ele simplifica o gerenciamento de infraestrutura, oferecendo recursos como inferência sem servidor, filas de trabalho e contêineres de desenvolvimento para acelerar o desenvolvimento, reduzir custos e eliminar a sobrecarga de DevOps.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Baseten VS Tensorfuse — Dados principais
Dados principaisBasetenTensorfuse
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusImplantaçãoImplantação
Público e funçõesPesquisador de IA · Diretor de Tecnologia · Cientista de Dados · Engenheiro de Machine Learning · Gerente de Produto · Desenvolvedor de SoftwareNão verificado
CategoriasImplantação · Aprendizado de Máquina · Computação em NuvemImplantação · MLOps · Computação em Nuvem
Added1 de nov. de 202515 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Baseten

Baseten é uma plataforma abrangente projetada para implantar, servir e escalar modelos de IA em ambientes de produção. Ela fornece a infraestrutura, as ferramentas e a experiência necessárias para levar produtos de IA ao mercado de forma rápida e eficiente. Alimentada pelo Baseten Inference Stack, oferece runtimes de modelo de alto desempenho, alta disponibilidade entre nuvens e uma experiência centrada no desenvolvedor para cargas de trabalho de inferência de missão crítica.

Como usar Baseten

1. Escolha seu método de implantação: Utilize as APIs de Modelo para acesso instantâneo a modelos pré-otimizados para prototipagem, ou crie uma Implantação Dedicada para modelos personalizados, ajustados ou de código aberto.
2. Empacote seu modelo usando o Truss, o padrão de código aberto da Baseten, que suporta qualquer framework de aprendizado de máquina.
3. Implante seu modelo em seu ambiente preferido: a nuvem totalmente gerenciada da Baseten, seu próprio VPC para auto-hospedagem ou uma configuração híbrida que combina ambos.
4. Escale sua aplicação automaticamente com base no tráfego, beneficiando-se de recursos como partidas a frio rápidas e 99,99% de tempo de atividade.
5. Opcionalmente, aproveite a infraestrutura otimizada para inferência da Baseten para treinar seus modelos para o melhor desempenho de produção possível.

Recursos principais do Baseten

  • Baseten Inference Stack: Um motor de alto desempenho com kernels personalizados, cache avançado e as mais recentes técnicas de decodificação para menor latência e maior rendimento.
  • Opções de Implantação Flexíveis: Escolha entre Baseten Cloud (totalmente gerenciado), Auto-hospedado (em seu VPC) e implantações Híbridas para atender às necessidades de segurança e desempenho.
  • Amplo Suporte a Modelos: Implante qualquer modelo personalizado, proprietário ou de código aberto, incluindo LLMs, modelos de geração de imagem (como fluxos de trabalho ComfyUI), transcrição e texto para fala.
  • APIs de Modelo Prontas para Produção: Acesse e avalie instantaneamente uma biblioteca de modelos populares como DeepSeek, Kimi e Qwen com desempenho de nível de produção.
  • Infraestrutura Nativa da Nuvem: Apresenta escalonamento automático, suporte a regiões globais em qualquer provedor de nuvem, partidas a frio ultrarrápidas e uma garantia de 99,99% de tempo de atividade.
  • Cadeias de IA Compostas: Permite controle granular de hardware e escalonamento automático para fluxos de trabalho de IA complexos e multi-modelo, melhorando a utilização da GPU e reduzindo a latência.
  • Suporte de Engenharia Especializado: Acesso a engenheiros de implantação avançada para assistência prática do protótipo à produção.

Casos de uso para Baseten

Baseten é ideal para construir aplicações de IA exigentes e em tempo real. Os casos de uso incluem alimentar agentes de telefone de IA de baixa latência, desenvolver produtos de IA generativa para criação de imagens e texto, servir modelos de embedding de alto rendimento para busca e recuperação, e implantar LLMs personalizados para indústrias especializadas como finanças e saúde.

Vantagens do Baseten

As principais vantagens do Baseten são seu desempenho excepcional, eficiência de custos e escalabilidade. Ao otimizar toda a pilha de inferência, ele reduz significativamente a latência e aumenta o rendimento, como demonstrado ao ajudar clientes como a Bland AI a alcançar tempos de resposta abaixo de 400ms. Seu modelo de pagamento pelo uso elimina custos por tempo ocioso, enquanto o escalonamento automático baseado no tráfego garante confiabilidade durante o crescimento rápido. A plataforma também é certificada SOC 2 Tipo II e compatível com HIPAA, garantindo segurança de nível empresarial.

Preços e planos

Baseten oferece uma estrutura de preços em camadas projetada para o crescimento:
- Basic: Um plano pague-conforme-o-uso a partir de $0 por mês. Inclui acesso a Implantações Dedicadas, APIs de Modelo, partidas a frio rápidas e é compatível com SOC 2 Tipo II e HIPAA.
- Pro: Um plano com cotação personalizada que adiciona acesso prioritário a GPUs de alta demanda, computação dedicada, limites de taxa mais altos e suporte prático via Slack e Zoom.
- Enterprise: Um plano com cotação personalizada para controle total, oferecendo auto-hospedagem em seu VPC, SLAs personalizados, segurança avançada e a capacidade de usar compromissos de nuvem existentes.

O uso é cobrado com base em dois modelos:
- APIs de Modelo: Preço por 1 milhão de tokens de entrada e saída. Por exemplo, o Kimi K2 custa $0,60/1M de tokens de entrada e $2,50/1M de tokens de saída.
- Implantações Dedicadas: Cobrado por minuto de tempo de computação. Por exemplo, uma instância de GPU A10G custa $0,02012 por minuto, e uma GPU H100 custa $0,10833 por minuto.

Tensorfuse

O Tensorfuse oferece uma plataforma poderosa para desenvolvedores e organizações gerenciarem GPUs sem servidor diretamente em sua própria infraestrutura de nuvem AWS. Ele foi projetado para otimizar todo o ciclo de vida de modelos de IA generativa, desde o ajuste fino e a experimentação até a implantação e o escalonamento automático em produção. Ao abstrair as complexidades do Kubernetes, Docker e provisionamento de infraestrutura, o Tensorfuse permite que as equipes se concentrem na construção de aplicativos de IA, reduzindo significativamente o tempo de lançamento no mercado e os custos operacionais.

A plataforma foi construída para oferecer o melhor dos dois mundos: a simplicidade de uma arquitetura sem servidor e a segurança e o controle de executar em sua nuvem privada. Isso significa que seus dados proprietários e pesos de modelo nunca saem de seus buckets S3 privados, garantindo máxima segurança e conformidade. O Tensorfuse foi projetado para eficiência, com um tempo de execução de contêiner otimizado que permite partidas a frio rápidas para cargas de trabalho pesadas de GPU, permitindo que os serviços escalem de zero em segundos.

Como usar o Tensorfuse

Começar a usar o Tensorfuse foi projetado para ser um processo simples:

  1. Inscreva-se e conecte a AWS: Comece inscrevendo-se em um plano (incluindo um nível gratuito 'Hacker') e conectando sua conta AWS. O Tensorfuse então configurará os recursos necessários em seu ambiente de nuvem.
  2. Use Contêineres de Desenvolvimento para Experimentação: Conecte seu IDE local (como o VS Code) diretamente a uma GPU na nuvem usando os Contêineres de Desenvolvimento do Tensorfuse. Isso elimina a necessidade de SSH, cópia de código e gerenciamento de dependências. Quaisquer alterações em seu código local são sincronizadas instantaneamente, permitindo uma experimentação rápida em tempo real.
  3. Ajuste Fino de Modelos: Utilize bibliotecas de treinamento populares como Axolotl, Unsloth ou Hugging Face para ajustar modelos de código aberto em seus conjuntos de dados proprietários. Você também pode escrever loops de treinamento personalizados. A plataforma lida com o provisionamento e gerenciamento de GPU subjacentes.
  4. Implante para Inferência: Implante seus modelos treinados ou pré-treinados como endpoints sem servidor. Esses endpoints escalam automaticamente com base no tráfego de entrada, de zero para lidar com alta concorrência, garantindo eficiência de custos e desempenho. Os modelos podem ser expostos como APIs compatíveis com OpenAI.
  5. Gerencie com Filas de Trabalho: Para tarefas assíncronas como processamento em lote ou inferência offline, use o recurso de Filas de Trabalho. Você pode enfileirar trabalhos programaticamente, definir parâmetros de escalonamento mínimo e máximo para alocação eficiente de recursos e monitorar seu status por meio de um simples comando CLI.

Recursos principais do Tensorfuse

  • Inferência Sem Servidor: Escala automaticamente as implantações de GPU em resposta ao tráfego, com partidas a frio rápidas (iniciando contêineres em segundos) e a capacidade de escalar para zero para economizar custos.
  • Ajuste Fino Eficiente: Ajuste modelos com segurança em seus dados privados usando o S3 de sua nuvem. Oferece integração flexível com frameworks populares como Axolotl e Huggingface.
  • Filas de Trabalho: Implante e enfileire trabalhos programaticamente para processamento em lote, com alocação eficiente de recursos e controle de custos por meio de escalonamento configurável.
  • Contêineres de Desenvolvimento: Conecte o código local a GPUs na nuvem sem SSH para desenvolvimento e experimentação rápidos e iterativos diretamente do seu IDE favorito.
  • Inferência Multi-LoRA: Suporte pronto para uso para treinar e trocar a quente milhares de adaptadores LoRA em uma única GPU, maximizando a utilização de hardware e reduzindo os custos de inferência.
  • Amplo Suporte de Hardware: Execute cargas de trabalho em uma variedade de hardware, incluindo GPUs NVIDIA (A10G, A100, H100), chips AWS Trainium/Inferentia, TPUs e FPGAs.
  • Segurança na Nuvem Privada: Todos os dados, conjuntos de dados e pesos de modelo permanecem em seus buckets S3 privados da AWS, garantindo controle e segurança totais.

Casos de uso para o Tensorfuse

O Tensorfuse é ideal para uma ampla gama de aplicações de IA/ML:

  • Startups e Pequenas Equipes: Construa e implante rapidamente recursos alimentados por IA sem uma equipe de DevOps dedicada, passando da ideia à produção 20x mais rápido.
  • Inferência em Larga Escala: Sirva modelos de IA generativa para aplicativos com tráfego irregular ou imprevisível, pagando apenas pelo cálculo que você usa.
  • Ajuste Fino de Modelos Personalizados: As empresas podem ajustar modelos base como Llama ou Mistral em seus dados proprietários para criar modelos especializados e de alto desempenho para necessidades de negócios específicas.
  • Cargas de Trabalho de Processamento em Lote: Execute eficientemente tarefas não em tempo real, como análise de dados, geração de relatórios ou inferência offline em larga escala, usando o sistema de fila de trabalho econômico.
  • Pesquisa e Experimentação em ML: Pesquisadores e engenheiros de ML podem usar Contêineres de Desenvolvimento para iterar rapidamente em modelos sem esperar pela configuração da infraestrutura.

Vantagens do Tensorfuse

Os usuários escolhem o Tensorfuse por seus benefícios significativos, incluindo uma redução relatada de 30% nos gastos com GPU na nuvem e um tempo de produção 20x mais rápido. Ele elimina a necessidade de soluções DevOps complexas e autogerenciadas, liberando recursos de engenharia. A plataforma oferece o desempenho e a escalabilidade de um serviço gerenciado com a segurança e os benefícios de custo de executar em sua própria nuvem. Os depoimentos destacam a equipe de suporte excepcional e responsiva, que auxilia na migração e em problemas contínuos, tornando o processo de integração suave e eficiente.

Preços e planos

O Tensorfuse oferece uma estrutura de preços em camadas para atender a diferentes necessidades:

  • Hacker (Gratuito): Para desenvolvedores independentes e projetos paralelos. Inclui 100 Horas de GPU Gerenciadas (MGH), Inferência Sem Servidor, Contêineres de Desenvolvimento e suporte da comunidade.
  • Starter (US$ 249/mês): Para pequenas equipes. Inclui 2.000 MGH, todos os recursos do Hacker, mais Ajuste Fino, GitHub Actions, Domínios Personalizados e suporte privado no Slack. Uma avaliação gratuita de 14 dias está disponível.
  • Growth (US$ 799/mês): Para startups em crescimento. Inclui 5.000 MGH, todos os recursos do Starter, mais Trabalhos em Lote e Filas de Trabalho, Ambientes, inferência Multi-LoRA e suporte premium. Uma avaliação gratuita de 14 dias está disponível.
  • Enterprise (Personalizado): Para grandes organizações que precisam de recursos avançados. Inclui MGH personalizado com descontos por volume, todos os recursos do Growth, mais Controle de Acesso Baseado em Função (RBAC), SSO, segurança de nível empresarial (SOC2, HIPAA) e suporte de engenharia dedicado.
  • Oferta para Startups: Startups em estágio inicial com menos de US$ 500 mil em financiamento podem ser elegíveis para 10.000 horas de gerenciamento de computação de GPU gratuito por 6 meses.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
ImplantaçãoComputação em Nuvem
Só Baseten
Aprendizado de Máquina
Só Tensorfuse
MLOps

Etiquetas

Em comum
Implantação de Modelo de IAcomputação em nuvemInferênciaMLOpsGPU sem servidor
Só Baseten
Ferramentas de desenvolvedorInfraestrutura de GPUHospedagem de LLMaprendizado de máquinaServiço de modelo
Só Tensorfuse
AWSDockerAjuste finoIA generativaKubernetes

Público e funções

Em comum
Sem dados verificados
Só Baseten
Pesquisador de IADiretor de TecnologiaCientista de DadosEngenheiro de Machine LearningGerente de ProdutoDesenvolvedor de Software
Só Tensorfuse
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Baseten monthly traffic:

Latest traffic · 2026-05

Visitas mensais
265.6K
Duração média
2:11
Páginas por visita
4.02
Taxa de rejeição
36%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: Não verificado
  • 2026-01: 197.3K
  • 2026-02: 205K
  • 2026-03: 246.2K
  • 2026-04: 247.6K
  • 2026-05: 265.6K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States70.97%188.5K
🇨🇦Canada8.11%21.5K
🇻🇳Vietnam7.87%20.9K
🇮🇳India7%18.6K
🇩🇪Germany6.05%16.1K

Fontes de tráfego

Source typePercentageEstimated visits
Direto85.63%227.4K
Referência10.77%28.6K
E-mail3.6%9.6K

Palavras-chave

basetenbaseten careersfireworks aikimi aitogether ai

Tensorfuse monthly traffic:

Latest traffic · 2026-05

Visitas mensais
6.7K
Duração média
1:01
Páginas por visita
1.8
Taxa de rejeição
44.71%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 10.1K
  • 2026-01: 5.4K
  • 2026-02: 4.2K
  • 2026-03: 4.9K
  • 2026-04: 5.3K
  • 2026-05: 6.7K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States38.24%2.6K
🇻🇳Vietnam36.56%2.5K
🇮🇳India25.2%1.7K

Palavras-chave

aws serverless gpubrew install aws clillama.cpp serverlessllm inference servers compared: vllm vs tgi vs sglang vs tritontensorfuse

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Baseten

Avaliação
Não verificado
Comentários
0
Favoritos
185
Curtidas
142

Tensorfuse

Avaliação
Não verificado
Comentários
0
Favoritos
170
Curtidas
144

Baseten vs Tensorfuse · FAQ da comparação

What do Baseten and Tensorfuse have in common?
Both tools are listed under Implantação、Computação em Nuvem. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Baseten and Tensorfuse free?
Listed pricing models: Baseten — Freemium; Tensorfuse — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Baseten and Tensorfuse?
The primary listed category is Implantação for Baseten, and Implantação for Tensorfuse. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Baseten · FAQ da comparação

Que tipos de modelos posso implantar na Baseten?

Você pode implantar modelos de código aberto e personalizados na Baseten. A plataforma suporta qualquer modelo construído em qualquer framework através do Truss, seu padrão de código aberto para empacotamento e serviço de modelos. Você também pode começar com modelos prontos da biblioteca de modelos da Baseten.

Quais GPUs estão disponíveis na Baseten?

Você tem controle total sobre quais GPUs seus modelos usam. A Baseten fornece uma lista completa das GPUs atualmente disponíveis em sua referência de tipos de instância. Se você precisar de um tipo de GPU específico que não está listado, pode entrar em contato com a equipe para solicitá-lo.

Eu pago pelo tempo ocioso na Baseten?

Não, você não paga pelo tempo ocioso. Você só paga pelo tempo em que seu modelo está usando ativamente a computação na Baseten, o que inclui quando está implantando, escalando para cima ou para baixo, ou fazendo previsões. Você tem controle total sobre o comportamento de escalonamento do seu modelo.

A Baseten é segura?

Sim, a Baseten é certificada SOC 2 Tipo II e compatível com HIPAA, garantindo que atende a altos padrões de segurança e proteção de dados adequados para aplicações empresariais e de saúde.

Posso implantar a Baseten na minha própria infraestrutura?

Sim, com o plano Enterprise, você pode auto-hospedar a Baseten em seus próprios VPCs. Isso permite que você mantenha controle total sobre a segurança, residência de dados e use seus compromissos de nuvem existentes.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas