

Baseten Overview
Baseten é uma plataforma abrangente projetada para implantar, servir e escalar modelos de IA em ambientes de produção. Ela fornece a infraestrutura, as ferramentas e a experiência necessárias para levar produtos de IA ao mercado de forma rápida e eficiente. Alimentada pelo Baseten Inference Stack, oferece runtimes de modelo de alto desempenho, alta disponibilidade entre nuvens e uma experiência centrada no desenvolvedor para cargas de trabalho de inferência de missão crítica.
Como usar Baseten
1. Escolha seu método de implantação: Utilize as APIs de Modelo para acesso instantâneo a modelos pré-otimizados para prototipagem, ou crie uma Implantação Dedicada para modelos personalizados, ajustados ou de código aberto.
2. Empacote seu modelo usando o Truss, o padrão de código aberto da Baseten, que suporta qualquer framework de aprendizado de máquina.
3. Implante seu modelo em seu ambiente preferido: a nuvem totalmente gerenciada da Baseten, seu próprio VPC para auto-hospedagem ou uma configuração híbrida que combina ambos.
4. Escale sua aplicação automaticamente com base no tráfego, beneficiando-se de recursos como partidas a frio rápidas e 99,99% de tempo de atividade.
5. Opcionalmente, aproveite a infraestrutura otimizada para inferência da Baseten para treinar seus modelos para o melhor desempenho de produção possível.
Recursos principais do Baseten
- Baseten Inference Stack: Um motor de alto desempenho com kernels personalizados, cache avançado e as mais recentes técnicas de decodificação para menor latência e maior rendimento.
- Opções de Implantação Flexíveis: Escolha entre Baseten Cloud (totalmente gerenciado), Auto-hospedado (em seu VPC) e implantações Híbridas para atender às necessidades de segurança e desempenho.
- Amplo Suporte a Modelos: Implante qualquer modelo personalizado, proprietário ou de código aberto, incluindo LLMs, modelos de geração de imagem (como fluxos de trabalho ComfyUI), transcrição e texto para fala.
- APIs de Modelo Prontas para Produção: Acesse e avalie instantaneamente uma biblioteca de modelos populares como DeepSeek, Kimi e Qwen com desempenho de nível de produção.
- Infraestrutura Nativa da Nuvem: Apresenta escalonamento automático, suporte a regiões globais em qualquer provedor de nuvem, partidas a frio ultrarrápidas e uma garantia de 99,99% de tempo de atividade.
- Cadeias de IA Compostas: Permite controle granular de hardware e escalonamento automático para fluxos de trabalho de IA complexos e multi-modelo, melhorando a utilização da GPU e reduzindo a latência.
- Suporte de Engenharia Especializado: Acesso a engenheiros de implantação avançada para assistência prática do protótipo à produção.
Casos de uso para Baseten
Baseten é ideal para construir aplicações de IA exigentes e em tempo real. Os casos de uso incluem alimentar agentes de telefone de IA de baixa latência, desenvolver produtos de IA generativa para criação de imagens e texto, servir modelos de embedding de alto rendimento para busca e recuperação, e implantar LLMs personalizados para indústrias especializadas como finanças e saúde.
Vantagens do Baseten
As principais vantagens do Baseten são seu desempenho excepcional, eficiência de custos e escalabilidade. Ao otimizar toda a pilha de inferência, ele reduz significativamente a latência e aumenta o rendimento, como demonstrado ao ajudar clientes como a Bland AI a alcançar tempos de resposta abaixo de 400ms. Seu modelo de pagamento pelo uso elimina custos por tempo ocioso, enquanto o escalonamento automático baseado no tráfego garante confiabilidade durante o crescimento rápido. A plataforma também é certificada SOC 2 Tipo II e compatível com HIPAA, garantindo segurança de nível empresarial.
Preços e planos
Baseten oferece uma estrutura de preços em camadas projetada para o crescimento:
- Basic: Um plano pague-conforme-o-uso a partir de $0 por mês. Inclui acesso a Implantações Dedicadas, APIs de Modelo, partidas a frio rápidas e é compatível com SOC 2 Tipo II e HIPAA.
- Pro: Um plano com cotação personalizada que adiciona acesso prioritário a GPUs de alta demanda, computação dedicada, limites de taxa mais altos e suporte prático via Slack e Zoom.
- Enterprise: Um plano com cotação personalizada para controle total, oferecendo auto-hospedagem em seu VPC, SLAs personalizados, segurança avançada e a capacidade de usar compromissos de nuvem existentes.
O uso é cobrado com base em dois modelos:
- APIs de Modelo: Preço por 1 milhão de tokens de entrada e saída. Por exemplo, o Kimi K2 custa $0,60/1M de tokens de entrada e $2,50/1M de tokens de saída.
- Implantações Dedicadas: Cobrado por minuto de tempo de computação. Por exemplo, uma instância de GPU A10G custa $0,02012 por minuto, e uma GPU H100 custa $0,10833 por minuto.
Baseten FAQ
Traffic
Latest traffic
Status
Monthly traffic trend
- 2026-1: 197.3K
- 2026-2: 205.0K
- 2026-3: 246.2K
- 2026-4: 247.6K
- 2026-5: 265.6K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos71.0%
- 🇨🇦Canadá8.1%
- 🇻🇳Vietnã7.9%
- 🇮🇳Índia7.0%
- 🇩🇪Alemanha6.0%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.6% |
Referral | 10.8% |
Email | 3.6% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| baseten careers | $0.29 |
| fireworks ai | $0.00 |
| kimi ai | $0.38 |
| together ai | $3.77 |
Baseten Videos on YouTube

Baseten


Vatsal Bajaj
No Priors: AI, Machine Learning, Tech, & Startups

Google Cloud
Baseten Alternatives
Release.ai
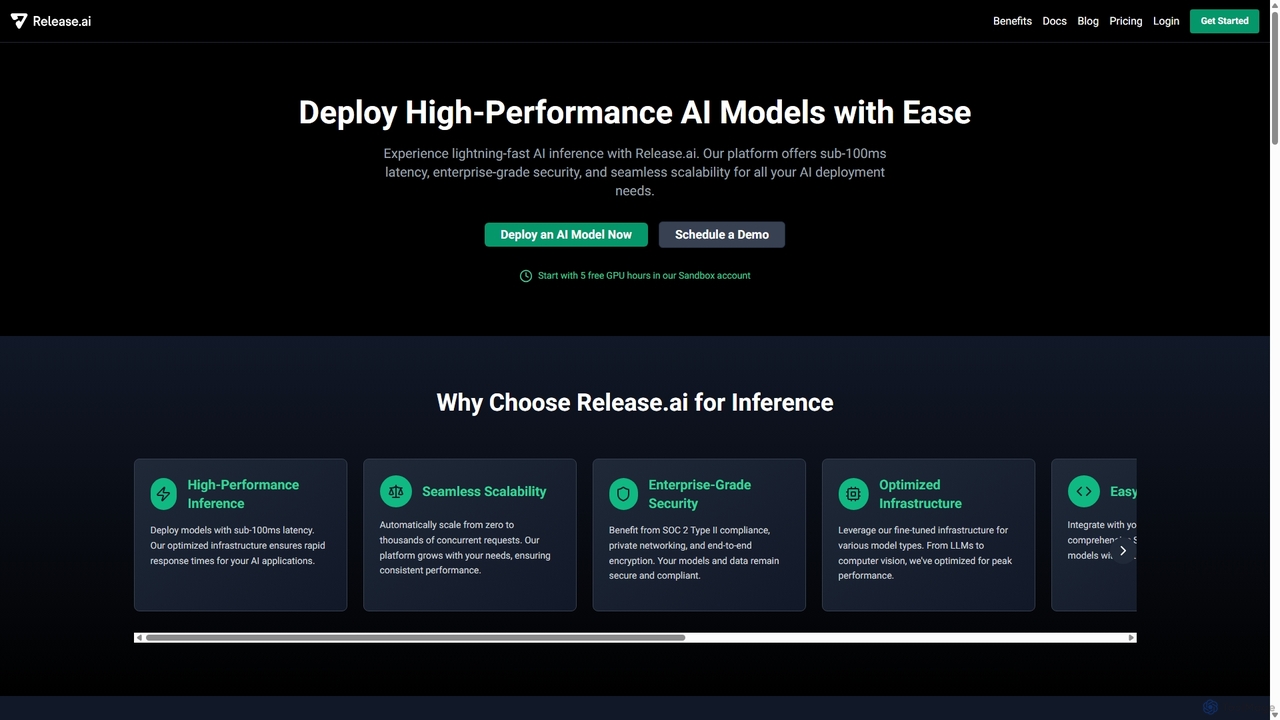
Release.ai é uma plataforma de nível empresarial para desenvolvedores implantarem, gerenciarem e escalarem facilmente modelos de IA de alto desempenho. Oferece latência de inferência abaixo de 100ms, auto-scaling contínuo, segurança robusta e uma vasta biblioteca de modelos pré-otimizados, permitindo uma rápida integração em qualquer fluxo de trabalho de desenvolvimento com apenas algumas linhas de código.
Plataforma como Serviço (PaaS)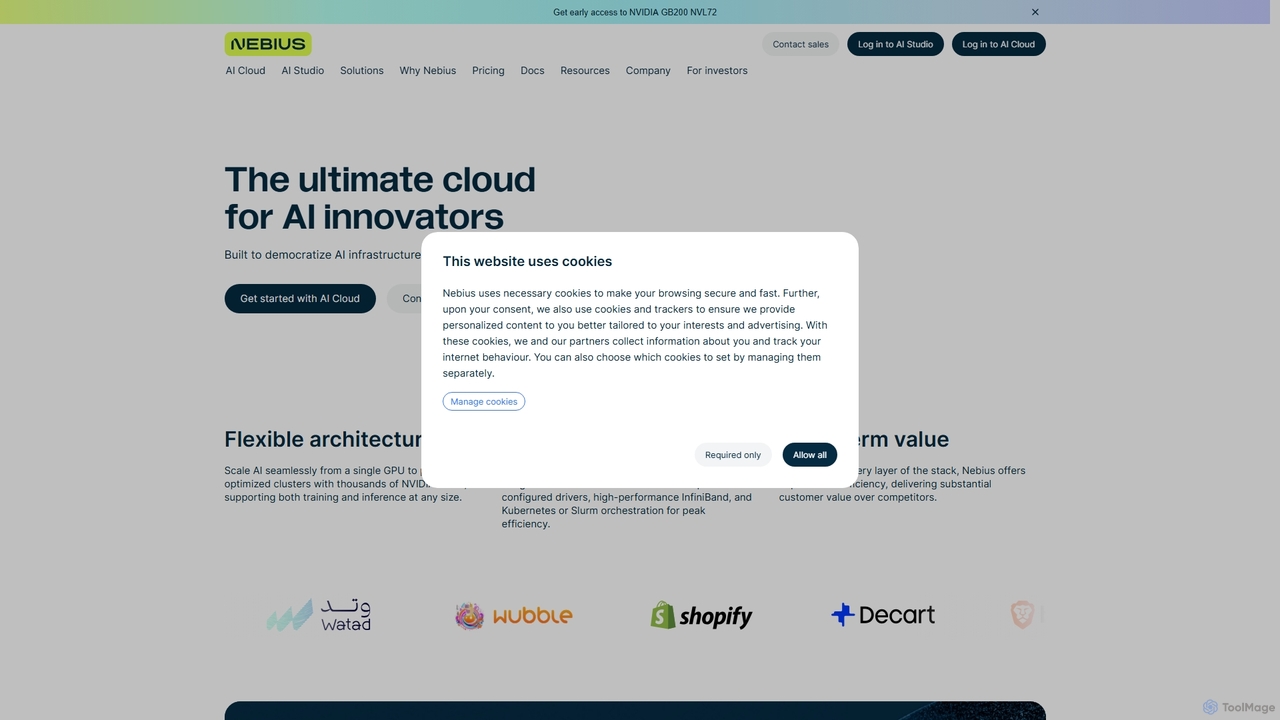
Nebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para cargas de trabalho exigentes de IA e Machine Learning. Oferece acesso escalável às mais recentes GPUs NVIDIA, desde instâncias únicas a clusters massivos, complementado por um conjunto de serviços gerenciados e um AI Studio integrado para otimizar todo o ciclo de vida de ML, do treinamento à inferência.
GPU Cloud
Runpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de Máquina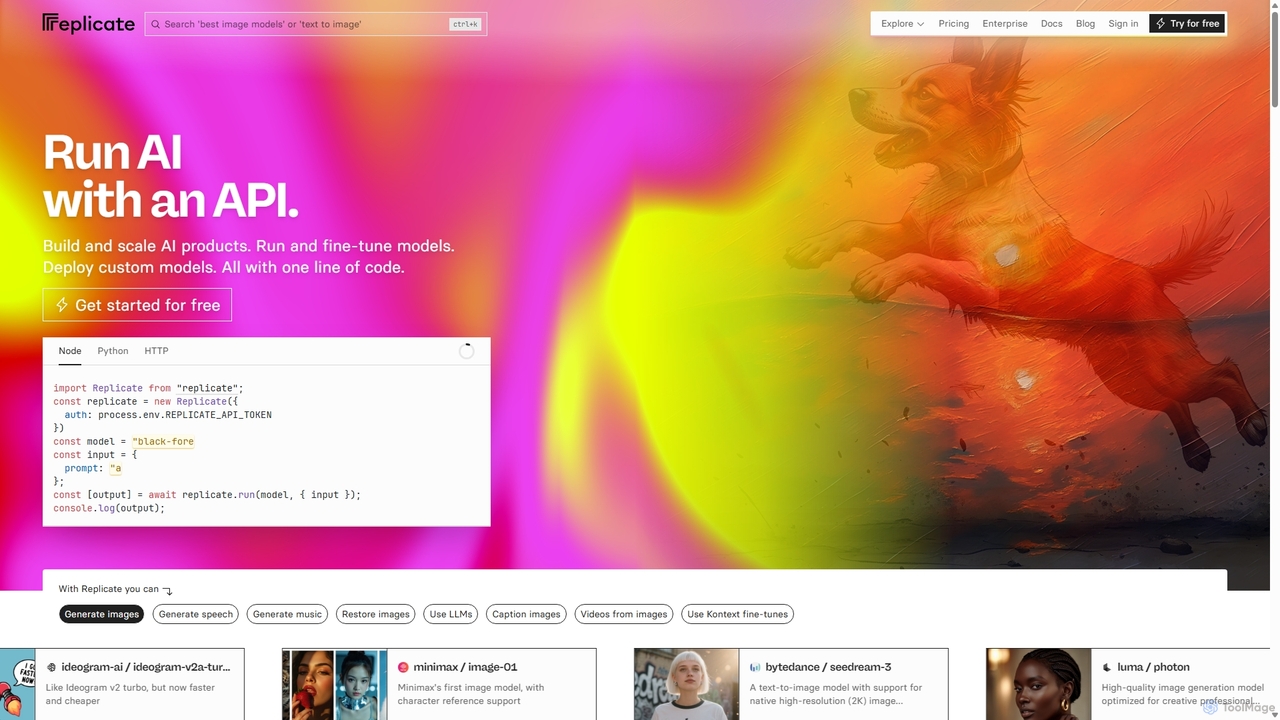
Replicate
Replicate é uma plataforma em nuvem para desenvolvedores executarem, ajustarem e implantarem modelos de IA por meio de uma API simples. Elimina a necessidade de gerenciar infraestrutura complexa, oferecendo acesso a milhares de modelos com preços de pagamento por uso e escalonamento automático.
Aprendizado de Máquina
Tensorfuse
O Tensorfuse é uma plataforma de GPU sem servidor que permite aos desenvolvedores ajustar, implantar e escalar automaticamente modelos de IA generativa em sua própria nuvem AWS. Ele simplifica o gerenciamento de infraestrutura, oferecendo recursos como inferência sem servidor, filas de trabalho e contêineres de desenvolvimento para acelerar o desenvolvimento, reduzir custos e eliminar a sobrecarga de DevOps.
ImplantaçãoBaseten Categories
Baseten Jobs
Baseten Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Release.ai
Release.ai é uma plataforma de nível empresarial para desenvolvedores implantarem, gerenciarem e escalarem facilmente modelos de IA de alto desempenho. Oferece latência de inferência abaixo de 100ms, auto-scaling contínuo, segurança robusta e uma vasta biblioteca de modelos pré-otimizados, permitindo uma rápida integração em qualquer fluxo de trabalho de desenvolvimento com apenas algumas linhas de código.
Plataforma como Serviço (PaaS)Nebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para cargas de trabalho exigentes de IA e Machine Learning. Oferece acesso escalável às mais recentes GPUs NVIDIA, desde instâncias únicas a clusters massivos, complementado por um conjunto de serviços gerenciados e um AI Studio integrado para otimizar todo o ciclo de vida de ML, do treinamento à inferência.
GPU CloudReplicate
Replicate é uma plataforma em nuvem para desenvolvedores executarem, ajustarem e implantarem modelos de IA por meio de uma API simples. Elimina a necessidade de gerenciar infraestrutura complexa, oferecendo acesso a milhares de modelos com preços de pagamento por uso e escalonamento automático.
Aprendizado de Máquina
LangDrive
LangDrive é uma plataforma centrada no desenvolvedor que oferece uma API unificada para ajustar, gerenciar e implantar Modelos de Linguagem de Grande Porte (LLMs) de código aberto. Ele simplifica o complexo pipeline de MLOps, permitindo que as empresas criem modelos de IA personalizados e poderosos para tarefas especializadas com maior controle sobre dados e custos.
Gerenciamento de API
AI News Hub
O AI News Hub é uma plataforma abrangente que oferece anúncios de IA em tempo real, atualizações de blog curadas sobre IA agentic, RAG e ferramentas de produção. Ele oferece um feed personalizado, recursos de favoritos e uma rica coleção de recursos de aprendizado, incluindo roteiros, cursos e vídeos, para manter desenvolvedores e entusiastas informados e qualificados no cenário de IA em rápida evolução.
Aggregation
Ollama
Ollama é um poderoso framework de código aberto para executar grandes modelos de linguagem (LLMs) como Llama 3, Mistral e Gemma localmente em seu próprio hardware. Disponível para macOS, Windows e Linux, simplifica a configuração e o gerenciamento de modelos de código aberto, permitindo o desenvolvimento e uso de IA de forma privada, offline e econômica.
Aprendizado de MáquinaRunpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de MáquinaTensorfuse
O Tensorfuse é uma plataforma de GPU sem servidor que permite aos desenvolvedores ajustar, implantar e escalar automaticamente modelos de IA generativa em sua própria nuvem AWS. Ele simplifica o gerenciamento de infraestrutura, oferecendo recursos como inferência sem servidor, filas de trabalho e contêineres de desenvolvimento para acelerar o desenvolvimento, reduzir custos e eliminar a sobrecarga de DevOps.
Implantação
Grably
Grably é uma rede descentralizada de propriedade de dados (DeDON) que fornece dados de treinamento de IA de alta qualidade e de origem ética. Oferece uma vasta coleção de conjuntos de dados prontos para uso, coleta de dados personalizada, curadoria e serviços de anotação para acelerar o desenvolvimento de IA, permitindo que os usuários monetizem seus dados de forma segura e transparente.
Rotulagem de Dados
Avian
Avian é uma plataforma de inferência de IA de alto desempenho que oferece velocidades recordes para grandes modelos de linguagem (LLMs). Fornece tanto uma API sem servidor para modelos populares quanto implantações de GPU dedicadas para modelos personalizados do HuggingFace. Projetado para escalabilidade e cargas de trabalho de produção, o Avian oferece velocidades de inferência de 3 a 10 vezes mais rápidas que a média da indústria, com segurança de nível empresarial e preços competitivos.
Implantação de Modelo
UltiHash
O UltiHash é uma plataforma de armazenamento de objetos de alto desempenho, nativa do Kubernetes, construída especificamente para cargas de trabalho de IA e big data. Oferece acesso a dados ultrarrápido, economia de custos significativa através de desduplicação avançada em nível de byte e implantação flexível em ambientes de nuvem, on-premises ou híbridos. Sua API compatível com S3 garante integração perfeita com pilhas de dados e fluxos de trabalho de IA existentes.
Operações de Machine Learning
Shakespeare
Shakespeare é um construtor de IA de código aberto projetado para desenvolvedores criarem aplicativos de IA personalizados. Ele fornece uma plataforma para selecionar e utilizar vários modelos de IA, permitindo o rápido desenvolvimento e implantação de soluções inteligentes.
Desenvolvimento de IA
Custom Vision
Um serviço de IA do Microsoft Azure que permite construir, implantar e melhorar seus próprios classificadores de imagem e detectores de objetos personalizados. Crie facilmente modelos de visão computacional de última geração adaptados às suas necessidades específicas com uma interface amigável e uma poderosa API REST, sem a necessidade de conhecimento aprofundado em aprendizado de máquina.
Aprendizado de Máquina
AIGoMarket
AIGoMarket é uma fundição e mercado de IA de ponta (Edge AI Foundry) projetada para democratizar o desenvolvimento de IA de ponta. Ele permite que criadores carreguem e monetizem seus modelos de IA otimizados, enquanto fornece aos desenvolvedores uma plataforma para descobrir, licenciar e implantar soluções de IA de alto desempenho para vários dispositivos e aplicações de ponta.
Model Marketplace
Baseten Comments (0)
Sign in to comment.
EntrarNo comments yet.