

Runpod Overview
Runpod é uma plataforma de nuvem de IA de ponta a ponta projetada para eliminar as complexidades de construir, treinar e implantar modelos de IA. Ela fornece a desenvolvedores, pesquisadores e empresas uma solução simplificada, poderosa e econômica para todas as suas necessidades de computação de IA/ML. Ao oferecer acesso sob demanda a uma vasta gama de GPUs em uma rede global de data centers, o Runpod capacita os usuários a irem da ideia à aplicação pronta para produção sem as dores de cabeça típicas de gerenciamento de infraestrutura, escalonamento e altos custos.
A plataforma é construída para construtores, focando em velocidade, flexibilidade e eficiência. Esteja você ajustando um grande modelo de linguagem, servindo inferência em tempo real para uma aplicação ou executando simulações computacionalmente intensivas, o Runpod fornece as ferramentas e a infraestrutura necessárias para fazê-lo em escala. O objetivo é ser a espinha dorsal computacional para a próxima geração de empresas de IA, permitindo que elas se concentrem na inovação em vez da infraestrutura.
Como usar o Runpod
Usar o Runpod envolve um fluxo de trabalho direto projetado para desenvolvimento e implantação rápidos:
- Escolha um Serviço: Selecione entre GPU Cloud para desenvolvimento interativo e tarefas de longa duração, ou Serverless para endpoints de inferência escaláveis e sob demanda.
- Selecione um Modelo: Inicie seu projeto escolhendo entre uma ampla gama de modelos pré-construídos para frameworks e aplicações populares como PyTorch, TensorFlow, Stable Diffusion e vários LLMs.
- Inicie um Pod: Inicie um ambiente habilitado para GPU, conhecido como 'Pod', em menos de um minuto. Você pode personalizar o tipo de GPU, vCPUs, RAM e armazenamento para atender às suas necessidades específicas.
- Conecte e Construa: Acesse seu Pod via SSH ou Jupyter Lab para instalar dependências, fazer upload do seu código e começar a treinar ou construir sua aplicação.
- Gerencie Dados: Utilize Volumes Persistentes ou Volumes de Rede compatíveis com S3 para armazenar seus conjuntos de dados, modelos e dados de contêiner. Uma vantagem chave é a ausência de taxas de entrada ou saída para transferência de dados.
- Implante e Escale: Para cargas de trabalho de produção, implante seu modelo como um endpoint sem servidor. O recurso de autoescalonamento do Runpod gerenciará automaticamente o número de trabalhadores de GPU (de 0 a milhares) com base na demanda em tempo real, garantindo que você pague apenas pela computação que usa.
Recursos principais do Runpod
- Computação de GPU Escalável: Acesse uma ampla variedade de GPUs, desde RTX 4090s de consumo até H100s e B200s de nível empresarial, disponíveis tanto em uma Nuvem Comunitária econômica quanto em uma Nuvem Segura de alta segurança.
- GPUs Sem Servidor: Implante modelos como endpoints de API que escalam automaticamente de zero para lidar com qualquer carga de trabalho, eliminando custos ociosos.
- Tecnologia FlashBoot: Alcance escalonamento ultrarrápido com tempos de partida a frio abaixo de 200ms, garantindo que sua aplicação esteja sempre responsiva.
- Armazenamento Persistente: Armazenamento compatível com S3 com zero taxas de entrada/saída, permitindo que você execute pipelines de IA completos, da ingestão de dados à implantação, sem interrupções.
- Modelos Pré-construídos: Uma rica biblioteca de modelos para configurar instantaneamente ambientes para treinamento, inferência e mais, reduzindo significativamente o tempo de configuração.
- Infraestrutura Global: Implante cargas de trabalho em mais de 8 regiões em todo o mundo para desempenho de baixa latência e confiabilidade global.
- Orquestração e Monitoramento Integrados: A plataforma lida com o enfileiramento e distribuição de tarefas automaticamente e fornece logs, monitoramento e métricas em tempo real sem a necessidade de frameworks personalizados.
Casos de uso para o Runpod
O Runpod é versátil e suporta uma ampla gama de aplicações:
- Serviço de Inferência: Implante e sirva inferência para modelos de geração de imagem, texto e áudio em qualquer escala com baixa latência.
- Ajuste Fino de Modelos: Treine e ajuste modelos personalizados em seus conjuntos de dados específicos de forma eficiente e econômica.
- Agentes de IA: Construa e hospede sistemas inteligentes e autônomos baseados em agentes e fluxos de trabalho complexos.
- Tarefas Computacionalmente Pesadas: Execute cargas de trabalho exigentes, como renderização 3D, simulações científicas e processamento de dados em grande escala.
Vantagens do Runpod
O Runpod oferece vantagens significativas sobre os provedores de nuvem tradicionais:
- Custo-Benefício: Com faturamento por segundo, preços de GPU competitivos e zero taxas de saída de dados, os usuários relatam economizar até 90% em suas contas de infraestrutura.
- Velocidade e Agilidade: Vá da ideia à execução em segundos. O provisionamento rápido da plataforma, as partidas a frio mínimas e as capacidades de autoescalonamento aceleram o ciclo de vida do desenvolvimento.
- Simplicidade: Abstrair a complexidade da infraestrutura permite que as equipes se concentrem em seu produto e recursos principais, não em DevOps.
- Flexibilidade: Ambientes altamente personalizáveis, incluindo modelos de GPU, comportamentos de escalonamento, limites de tempo ocioso e locais de data center.
- Confiabilidade: Serviço de nível empresarial com 99,9% de tempo de atividade, failovers integrados e segurança robusta (SOC2, HIPAA, GDPR em andamento).
Preços e planos
O preço do Runpod é transparente e projetado para ser econômico.
- GPU Cloud: Cobrado por hora, com preços que variam por tipo de GPU e se está na Nuvem Segura ou na Nuvem Comunitária mais acessível. Por exemplo, uma RTX 4090 pode custar a partir de $0.69/h, enquanto uma H100 SXM de ponta custa cerca de $2.69/h.
- Serverless (Inferência): Cobrado por segundo de tempo de processamento. O preço é escalonado pelo desempenho da GPU, com taxas separadas para trabalhadores 'Flex' (pré-aquecidos) e 'Active'. Este modelo é altamente eficiente para tráfego variável.
- Armazenamento: O armazenamento persistente do Pod custa $0.10/GB/mês. O armazenamento de Volume de Rede compatível com S3 é ainda mais barato, a $0.07/GB/mês para menos de 1TB. Não há taxas de entrada ou saída.
- Reservas: Para cargas de trabalho de longo prazo, os usuários podem reservar capacidade com desconto falando com a equipe de vendas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 1.6M
- 2026-1: 1.9M
- 2026-2: 1.9M
- 2026-3: 2.4M
- 2026-4: 2.3M
- 2026-5: 2.3M
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos58.8%
- 🇮🇳Índia13.6%
- 🇩🇪Alemanha13.6%
- 🇧🇷Brasil7.4%
- 🇳🇬Nigéria6.6%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 78.8% |
Referral | 20.0% |
Email | 1.2% |
Top keywords
| Keyword | Cost per click |
|---|---|
| run pod | $4.13 |
| runpod | $2.14 |
| runpod password | $0.00 |
| runpod pricing | $4.51 |
| runpod serverless | $15.48 |
Runpod Videos on YouTube


Endangered AI


Runpod Alternatives
thundercompute
O Thunder Compute oferece uma plataforma de nuvem GPU de custo ultrabaixo, projetada para desenvolvedores de IA e machine learning. Ele fornece instâncias de GPU sob demanda, como a NVIDIA A100 e T4, a preços até 80% mais baixos que os principais provedores de nuvem. Com recursos como configuração com um clique, integração com o VS Code e escalabilidade perfeita, ele simplifica drasticamente o fluxo de trabalho de desenvolvimento, da prototipagem à produção, permitindo que os desenvolvedores se concentrem na construção de modelos em vez de gerenciar a infraestrutura.
Aprendizado de Máquina
Baseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
Implantação
Predibase
Predibase é uma plataforma de desenvolvedor de ponta a ponta para o ajuste fino e serviço eficientes de Modelos de Linguagem Grandes (LLMs) de código aberto. Permite que os usuários construam modelos de IA personalizados que superam grandes modelos proprietários como o GPT-4 em tarefas específicas, enquanto reduzem significativamente os custos e a latência de inferência. A plataforma apresenta técnicas avançadas como o Ajuste Fino por Reforço (RFT) e o LoRAX para serviço de alta velocidade e múltiplos modelos.
Aprendizado de Máquina
Fluidstack
Fluidstack é uma plataforma de nuvem de IA líder que fornece clusters de GPU dedicados de alto desempenho para treinar e servir modelos de IA de fronteira. Oferece implantação rápida de milhares de GPUs, serviços totalmente gerenciados com suporte especializado 24/7 e preços transparentes com zero taxas de egresso, capacitando equipes de IA a escalar sem atrito de infraestrutura.
Soluções Empresariais
GPUX
GPUX é uma plataforma de nuvem GPU descentralizada e sem servidor para inferência de modelos de IA rápida e acessível. Permite que desenvolvedores executem modelos via API e que proprietários de GPU ganhem dinheiro contribuindo com seu hardware para uma rede P2P.
Implantação de ModeloRunpod Categories
Runpod Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Beam
Beam é uma plataforma de nuvem sem servidor projetada para desenvolvedores executarem, escalarem e implantarem modelos e aplicativos de IA/ML em GPUs com facilidade. Oferece autoescalonamento instantâneo, cobrança por segundo e um fluxo de trabalho simplificado, permitindo que você transforme código em uma API escalável em minutos, sem gerenciar infraestrutura complexa.
Aprendizado de Máquina
Modal
O Modal é uma plataforma de infraestrutura serverless de alto desempenho para desenvolvedores de IA e ML. Ele permite que você execute funções Python na nuvem com uma única linha de código, fornecendo acesso instantâneo a GPUs, escalonamento automático de zero a milhares de contêineres e preços por segundo. Elimine a sobrecarga de infraestrutura e concentre-se na construção e implantação de aplicativos computacionalmente intensivos como IA generativa, processamento em lote e análise de dados.
Implantação de Modelothundercompute
O Thunder Compute oferece uma plataforma de nuvem GPU de custo ultrabaixo, projetada para desenvolvedores de IA e machine learning. Ele fornece instâncias de GPU sob demanda, como a NVIDIA A100 e T4, a preços até 80% mais baixos que os principais provedores de nuvem. Com recursos como configuração com um clique, integração com o VS Code e escalabilidade perfeita, ele simplifica drasticamente o fluxo de trabalho de desenvolvimento, da prototipagem à produção, permitindo que os desenvolvedores se concentrem na construção de modelos em vez de gerenciar a infraestrutura.
Aprendizado de MáquinaGPUX
GPUX é uma plataforma de nuvem GPU descentralizada e sem servidor para inferência de modelos de IA rápida e acessível. Permite que desenvolvedores executem modelos via API e que proprietários de GPU ganhem dinheiro contribuindo com seu hardware para uma rede P2P.
Implantação de Modelo
novita.ai
Novita AI é uma plataforma em nuvem centrada no desenvolvedor que oferece acesso acessível e escalável a mais de 200 modelos de IA através de APIs simples. Fornece GPUs sem servidor, instâncias de GPU dedicadas e implantação de modelos personalizados, permitindo que os desenvolvedores construam e escalem aplicações de IA sem gerenciar infraestrutura.
GPUBaseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
Implantação
DigitalOcean
DigitalOcean é uma plataforma de infraestrutura em nuvem focada em desenvolvedores que simplifica a construção, implantação e escalonamento de aplicações. Oferece um conjunto abrangente de produtos, incluindo máquinas virtuais (Droplets), Kubernetes gerenciado e a plataforma GradientAI, fornecendo recursos de GPU poderosos e ferramentas para criar e hospedar aplicações de IA que mudam o mundo, desde projetos paralelos até grandes empresas.
Hospedagem
Replicate
Replicate é uma plataforma em nuvem para desenvolvedores executarem, ajustarem e implantarem modelos de IA por meio de uma API simples. Elimina a necessidade de gerenciar infraestrutura complexa, oferecendo acesso a milhares de modelos com preços de pagamento por uso e escalonamento automático.
Aprendizado de Máquina
Float16.cloud
O Float16.cloud é uma plataforma de GPU sem servidor projetada para acelerar o desenvolvimento de IA. Ele fornece acesso instantâneo a GPUs H100 de alto desempenho com cobrança por segundo, configuração zero e sem partidas a frio. Os desenvolvedores podem implantar LLMs de código aberto, treinar modelos e executar cargas de trabalho de IA diretamente de scripts Python sem gerenciar a infraestrutura.
Plataforma como Serviço (PaaS)
Together AI
O Together AI é uma plataforma de nuvem líder para desenvolvedores, fornecendo infraestrutura rápida e econômica para executar, ajustar e treinar modelos de IA generativa de código aberto. Oferece uma extensa biblioteca de mais de 200 modelos, APIs de inferência sem servidor, ajuste fino personalizável e clusters de GPU dedicados, criando uma solução de ponta a ponta para construir e escalar aplicações de IA.
Infraestrutura de GPU
Inferless
Inferless é uma plataforma de GPU sem servidor projetada para desenvolvedores implantarem modelos de aprendizado de máquina em minutos. Ela elimina o gerenciamento de infraestrutura, oferecendo escalonamento automático a partir do zero para lidar com cargas de trabalho variáveis. A plataforma é otimizada para partidas a frio ultrarrápidas e eficiência de custos, permitindo que os usuários economizem até 90% nas contas de GPU pagando apenas pelo que usam.
Implantação de Aprendizado de Máquina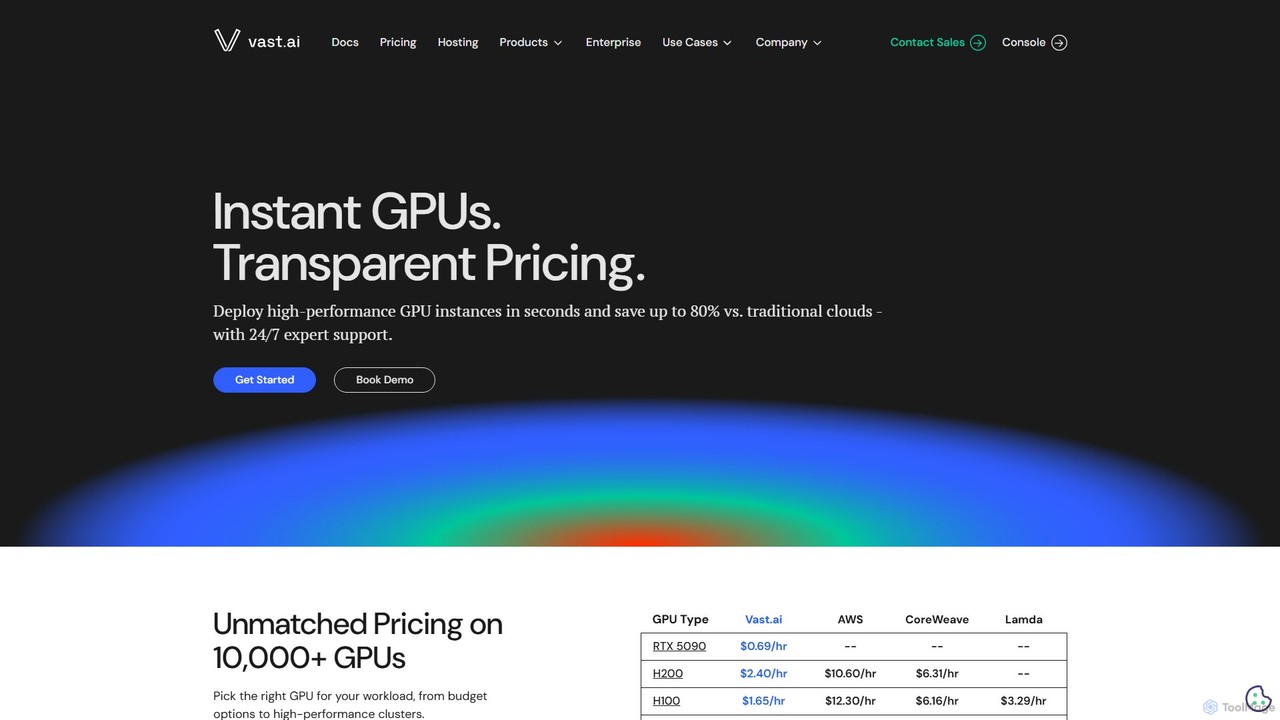
Vast.ai
Vast.ai é uma plataforma líder de nuvem de GPU que oferece acesso sob demanda a uma vasta rede de GPUs para cargas de trabalho de IA e aprendizado de máquina. Ela fornece a desenvolvedores e empresas computação de alto desempenho a custos significativamente mais baixos — até 80% menos que os provedores de nuvem tradicionais — por meio de um mercado transparente e pague-pelo-uso.
Aluguel de GPU
Nebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para IA e aprendizado de máquina. Ela fornece acesso às mais recentes GPUs NVIDIA, clusters escaláveis com rede InfiniBand e serviços totalmente gerenciados como Kubernetes e Slurm, permitindo treinamento, ajuste fino e inferência de modelos de IA em qualquer escala.
Aprendizado de Máquina
Blaxel
Blaxel é uma plataforma de computação sem servidor projetada para desenvolvedores de IA, fornecendo a infraestrutura e as ferramentas para construir, implantar e escalar aplicações de IA agentivas de forma eficiente. Oferece VMs em sandbox, um gateway LLM unificado e observabilidade profunda.
Computação em Nuvem
Runpod Comments (0)
Sign in to comment.
EntrarNo comments yet.