
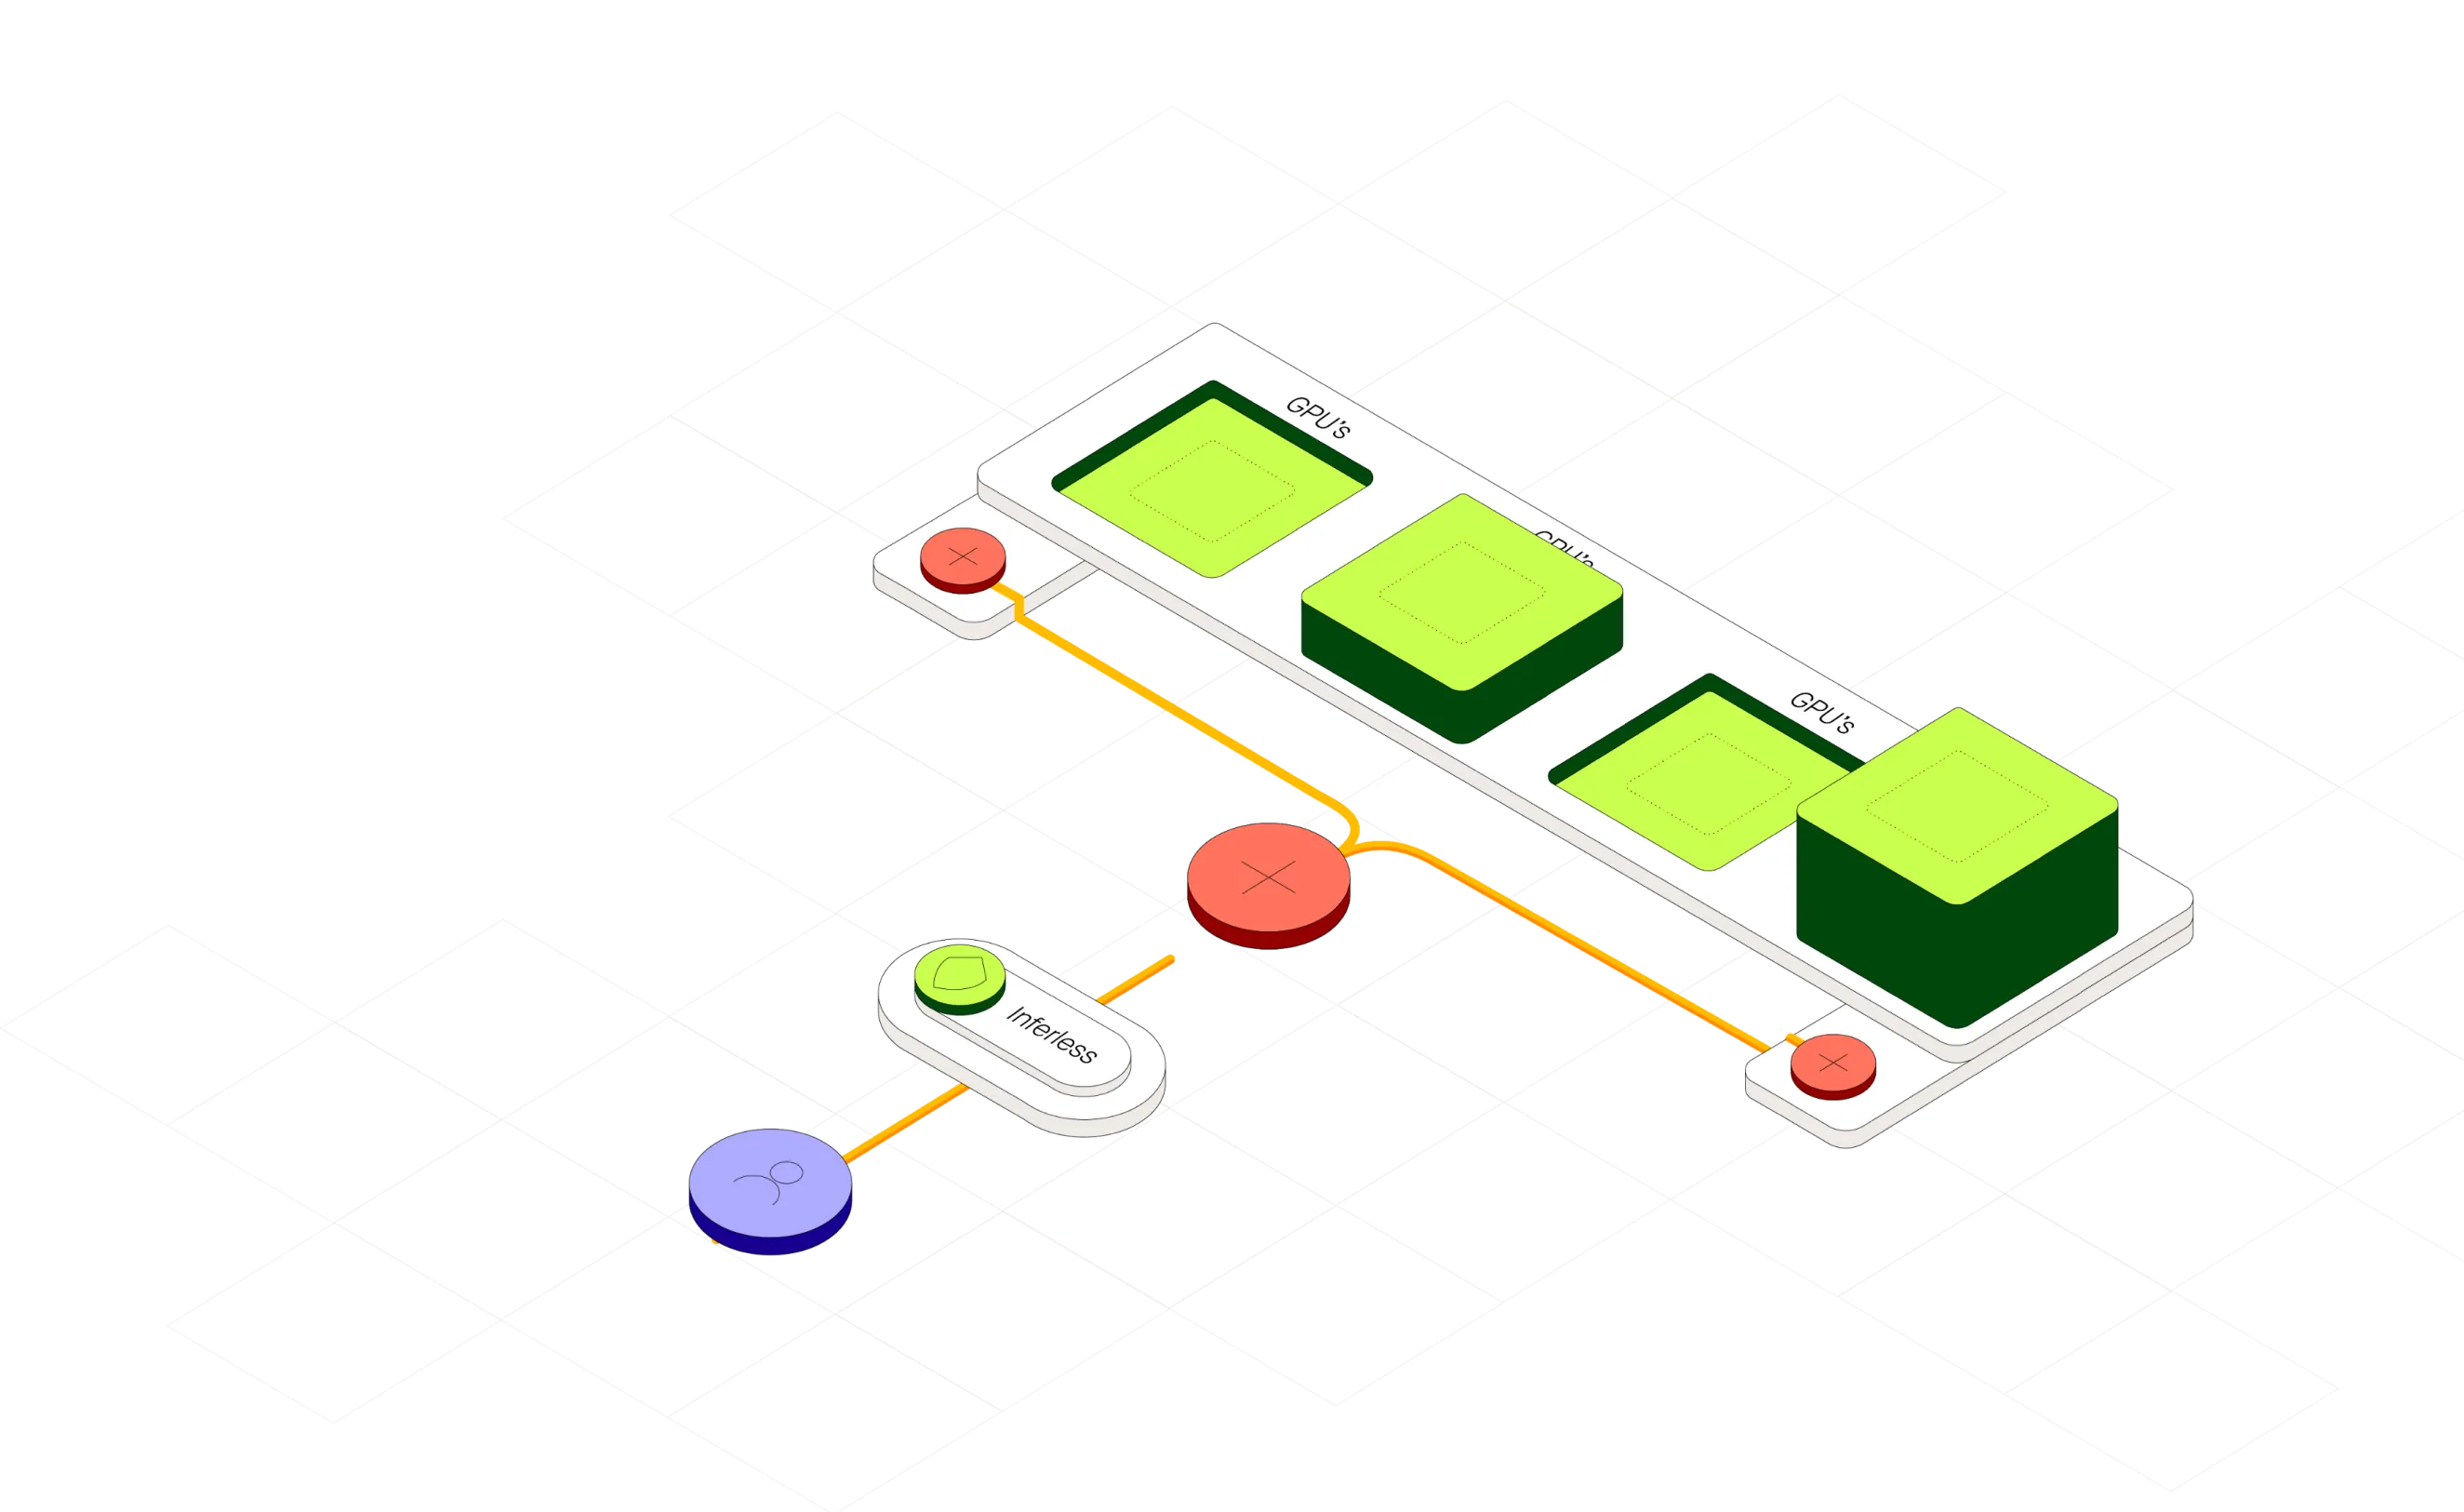

Inferless Overview
Inferless é uma plataforma de GPU sem servidor de ponta, projetada para simplificar a implantação de modelos de aprendizado de máquina para cargas de trabalho de produção. Ela capacita desenvolvedores e cientistas de dados a passar de um arquivo de modelo para um endpoint de API ativo e escalável em apenas alguns minutos, abstraindo completamente as complexidades do gerenciamento de infraestrutura. Ao suportar a implantação direta de fontes como Hugging Face, Git, Docker ou sua própria CLI, a Inferless oferece flexibilidade incomparável e acelera o caminho para a produção.
A plataforma foi construída para lidar com padrões de tráfego imprevisíveis e variáveis com suas robustas capacidades de autoescalonamento, escalando de zero a centenas de GPUs sob demanda. Isso garante alta disponibilidade e desempenho sem o custo de recursos ociosos. Com um forte foco na confiabilidade e segurança de nível empresarial, a Inferless é certificada SOC-2 Tipo II e passa por varreduras de vulnerabilidade regulares, tornando-se uma escolha confiável para empresas de todos os tamanhos.
Como usar Inferless
Implantar um modelo na Inferless é um processo direto, projetado para velocidade e eficiência:
- Cadastre-se e Conecte: Crie uma conta na Inferless e conecte sua fonte de modelo. Você pode integrar diretamente sua conta do Hugging Face, um repositório Git ou um registro Docker.
- Importe seu Modelo: No espaço de trabalho da Inferless, selecione 'Adicionar um Modelo Personalizado'. Escolha seu provedor, insira o nome do modelo e especifique seu tipo (ex: Transformer, Diffuser) e tarefa (ex: Geração de Texto, Texto para Imagem).
- Personalize a Configuração: Adapte a implantação às suas necessidades. Você pode modificar o código de inferência (ex: `app.py`), definir esquemas de entrada personalizados e configurar o ambiente de tempo de execução com dependências de software e bibliotecas específicas.
- Configure Hardware e Escalonamento: Selecione o tipo de GPU apropriado (ex: Nvidia T4, A10, A100). Defina o número mínimo e máximo de réplicas para definir o comportamento do autoescalonamento. Configure definições como tempo limite de inferência, concorrência de contêiner e períodos de redução de escala.
- Implante e Monitore: Clique em 'Implantar' para construir seu modelo e lançar o endpoint. Uma vez ativo, você pode usar os logs detalhados de chamadas e compilação para monitorar o desempenho, depurar problemas e refinar seus modelos eficientemente.
Recursos principais do Inferless
- Infraestrutura de GPU sem Servidor: Zero configuração ou gerenciamento de infraestrutura. A plataforma lida com provisionamento, escalonamento e manutenção automaticamente.
- Partidas a Frio Ultrarrápidas: A arquitetura otimizada garante tempos de resposta abaixo de um segundo, mesmo para modelos grandes, eliminando atrasos de aquecimento.
- Autoescalonamento Dinâmico: Escala recursos automaticamente de zero a centenas de GPUs com base no tráfego em tempo real, garantindo desempenho e custo ideais.
- Agrupamento Dinâmico (Dynamic Batching): Aumenta a taxa de transferência e a utilização da GPU ao combinar automaticamente várias solicitações do lado do servidor em um único lote.
- Tempos de Execução Personalizados: Flexibilidade total para personalizar o ambiente do contêiner com qualquer software e dependências necessários.
- CI/CD Automatizado: Habilite a reconstrução automática para modelos para reimplantar automaticamente após alterações no repositório de origem, simplificando o ciclo de vida do desenvolvimento.
- Volumes Persistentes: Fornece volumes graváveis semelhantes a NFS que suportam conexões simultâneas, permitindo aplicações com estado e compartilhamento eficiente de dados.
- Segurança de Nível Empresarial: Certificado SOC-2 Tipo II, com testes de penetração e varreduras de vulnerabilidade regulares para garantir a segurança dos dados.
Casos de uso para Inferless
A Inferless é ideal para uma ampla gama de aplicações de IA:
- Aplicações de IA Generativa: Implantando grandes modelos de linguagem (LLMs) para chatbots, criação de conteúdo e geração de código com baixa latência.
- APIs em Tempo Real: Potencializando serviços que exigem altas consultas por segundo (QPS) e respostas imediatas, como detecção de fraudes ou motores de recomendação.
- Visão Computacional: Servindo modelos para reconhecimento de imagem, detecção de objetos e geração de imagens em escala.
- Processamento de Áudio e Fala: Hospedando modelos de texto para fala (TTS), fala para texto e outros modelos de IA baseados em áudio.
- Prototipagem e Produção com Custo-Eficiente: Startups e empresas podem reduzir significativamente suas contas de nuvem de GPU (em até 90%) enquanto escalam efetivamente.
Vantagens do Inferless
As principais vantagens de usar a Inferless incluem economias de custo significativas através de seu modelo de pagamento por uso, produtividade aprimorada do desenvolvedor ao eliminar a sobrecarga de DevOps e desempenho superior com latência mínima. Sua capacidade de lidar com cargas de trabalho variáveis de forma confiável a torna uma solução robusta para ambientes de produção. A flexibilidade da plataforma com tempos de execução personalizados e integrações diretas com ferramentas como o Hugging Face a torna uma escolha versátil e poderosa para qualquer equipe de ML.
Preços e planos
A Inferless oferece um modelo de preços transparente de pagamento por uso com um crédito gratuito de $30 para começar.
- Preços de GPU (Pagamento por segundo):
- Nvidia T4: $0.66/hora
- Nvidia A10: $1.22/hora
- Nvidia A100 (80GB): $5.36/hora
- Preços de Volume: Os primeiros 50GB de armazenamento são gratuitos a cada mês. O armazenamento adicional custa $0.3/GB/mês.
- Plano Startup: Projetado para um mínimo de 10.000 solicitações de inferência por mês, inclui uma concorrência de 5 GPUs, retenção de log de 15 dias e suporte via canal Slack privado.
- Plano Enterprise: Para um mínimo de 100.000 solicitações de inferência por mês, com uma concorrência de 50 GPUs, retenção de log de 365 dias e um engenheiro de suporte dedicado.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 31.3K
- 2026-1: 23.7K
- 2026-2: 15.1K
- 2026-3: 20.2K
- 2026-4: 13.3K
- 2026-5: 8.4K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos32.3%
- 🇻🇳Vietnã24.5%
- 🇮🇳Índia22.9%
- 🇧🇷Brasil11.0%
- 🇮🇹Itália9.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| deepseek | $0.45 |
| goel a, borgohain r (2024) exploring llms speed benchmarks: independent analysis | $0.00 |
| kokoro-82m alternative | $0.00 |
| qwen | $0.28 |
| qwen 2.5 3b architecture | $0.00 |
Inferless Alternatives
Supervised.co
Supervised.co é uma plataforma de ponta a ponta para construir, treinar e implantar modelos de aprendizado de máquina supervisionado. Simplifica o ciclo de vida de MLOps com anotação de dados integrada, treinamento de modelo automatizado e implantação de API com um clique, capacitando equipes a criar soluções de IA de alto desempenho de forma eficiente.
Anotação de Dados
Modal
O Modal é uma plataforma de infraestrutura serverless de alto desempenho para desenvolvedores de IA e ML. Ele permite que você execute funções Python na nuvem com uma única linha de código, fornecendo acesso instantâneo a GPUs, escalonamento automático de zero a milhares de contêineres e preços por segundo. Elimine a sobrecarga de infraestrutura e concentre-se na construção e implantação de aplicativos computacionalmente intensivos como IA generativa, processamento em lote e análise de dados.
Implantação de Modelo
Runpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de Máquina
ClearML GenAI App Engine
Uma plataforma de nível empresarial para implantar, gerenciar e escalar rapidamente aplicações de IA Generativa. Fornece um plano de controle de infraestrutura unificado para otimizar a implantação de LLMs, monitorar o desempenho e otimizar os custos de computação, acelerando a adoção de GenAI de forma segura e eficiente.
MLOps
Beam
Beam é uma plataforma de nuvem sem servidor projetada para desenvolvedores executarem, escalarem e implantarem modelos e aplicativos de IA/ML em GPUs com facilidade. Oferece autoescalonamento instantâneo, cobrança por segundo e um fluxo de trabalho simplificado, permitindo que você transforme código em uma API escalável em minutos, sem gerenciar infraestrutura complexa.
Aprendizado de MáquinaInferless Categories
Inferless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Modal
O Modal é uma plataforma de infraestrutura serverless de alto desempenho para desenvolvedores de IA e ML. Ele permite que você execute funções Python na nuvem com uma única linha de código, fornecendo acesso instantâneo a GPUs, escalonamento automático de zero a milhares de contêineres e preços por segundo. Elimine a sobrecarga de infraestrutura e concentre-se na construção e implantação de aplicativos computacionalmente intensivos como IA generativa, processamento em lote e análise de dados.
Implantação de ModeloRunpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de MáquinaBeam
Beam é uma plataforma de nuvem sem servidor projetada para desenvolvedores executarem, escalarem e implantarem modelos e aplicativos de IA/ML em GPUs com facilidade. Oferece autoescalonamento instantâneo, cobrança por segundo e um fluxo de trabalho simplificado, permitindo que você transforme código em uma API escalável em minutos, sem gerenciar infraestrutura complexa.
Aprendizado de Máquina
Cerebrium
Cerebrium é uma plataforma de infraestrutura de IA sem servidor projetada para que desenvolvedores implantem, gerenciem e escalem modelos de aprendizado de máquina com facilidade. Ela abstrai a infraestrutura complexa, oferecendo recursos como auto-scaling, inícios a frio rápidos e acesso a GPU pago por uso, permitindo que as equipes criem aplicativos de IA de alto desempenho sem gerenciar servidores.
Serverless
Vast.ai
Vast.ai é uma plataforma líder de nuvem de GPU que oferece acesso sob demanda a uma vasta rede de GPUs para cargas de trabalho de IA e aprendizado de máquina. Ela fornece a desenvolvedores e empresas computação de alto desempenho a custos significativamente mais baixos — até 80% menos que os provedores de nuvem tradicionais — por meio de um mercado transparente e pague-pelo-uso.
Aluguel de GPU
Nebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para IA e aprendizado de máquina. Ela fornece acesso às mais recentes GPUs NVIDIA, clusters escaláveis com rede InfiniBand e serviços totalmente gerenciados como Kubernetes e Slurm, permitindo treinamento, ajuste fino e inferência de modelos de IA em qualquer escala.
Aprendizado de Máquina
Lightning AI
Lightning AI é uma plataforma na nuvem projetada para construir, treinar e implantar modelos de IA em escala. Combina o popular framework de código aberto PyTorch Lightning com o Lightning AI Studio, um ambiente colaborativo baseado em navegador com configuração zero. Acesse GPUs poderosas, escale de um laptop para a nuvem sem interrupções e acelere todo o seu fluxo de trabalho de desenvolvimento de IA.
Plataforma como Serviço (PaaS)
Fluidstack
Fluidstack é uma plataforma de nuvem de IA líder que fornece clusters de GPU dedicados de alto desempenho para treinar e servir modelos de IA de fronteira. Oferece implantação rápida de milhares de GPUs, serviços totalmente gerenciados com suporte especializado 24/7 e preços transparentes com zero taxas de egresso, capacitando equipes de IA a escalar sem atrito de infraestrutura.
Soluções Empresariais
Gmi Cloud
Gmi Cloud é uma plataforma de nuvem GPU de alto desempenho projetada para treinamento e inferência de IA escaláveis. Fornece acesso sob demanda a GPUs NVIDIA de ponta, um motor de inferência otimizado para baixa latência e um motor de cluster para MLOps simplificado, permitindo que desenvolvedores e empresas construam, implantem e escalem aplicações de IA de forma eficiente e econômica.
MLOps
GreenNode
O GreenNode é um provedor de infraestrutura em nuvem de IA completo, oferecendo soluções de GPU NVIDIA de alto desempenho para startups e empresas. Ele fornece acesso instantâneo a recursos de ponta como GPUs H100, infraestrutura escalável e suporte especializado do AI Lab. Focado em custo-benefício e desempenho, o GreenNode ajuda a acelerar o treinamento, ajuste fino e inferência de modelos, com uma forte presença no Sudeste Asiático.
Treinamento de Modelo
Nebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para cargas de trabalho exigentes de IA e Machine Learning. Oferece acesso escalável às mais recentes GPUs NVIDIA, desde instâncias únicas a clusters massivos, complementado por um conjunto de serviços gerenciados e um AI Studio integrado para otimizar todo o ciclo de vida de ML, do treinamento à inferência.
GPU Cloud
GPUX
GPUX é uma plataforma de nuvem GPU descentralizada e sem servidor para inferência de modelos de IA rápida e acessível. Permite que desenvolvedores executem modelos via API e que proprietários de GPU ganhem dinheiro contribuindo com seu hardware para uma rede P2P.
Implantação de Modelo
Modelbit
Modelbit é uma plataforma MLOps para implantar modelos de aprendizado de máquina diretamente de notebooks Python para produção. Ele fornece um fluxo de trabalho de infraestrutura como código, permitindo que cientistas de dados implantem, hospedem, escalem e gerenciem modelos com uma única linha de código e um git push.
MLOps
PostgresML
PostgresML é uma poderosa extensão de código aberto que integra machine learning e IA diretamente no seu banco de dados PostgreSQL. Ele permite inferência acelerada por GPU, busca vetorial e pipelines RAG completos usando comandos SQL simples, eliminando a movimentação de dados e simplificando a pilha de MLOps para aplicações de IA escaláveis e de alto desempenho.
MLOps
Inferless Comments (0)
Sign in to comment.
EntrarNo comments yet.