
Cerebrium Overview
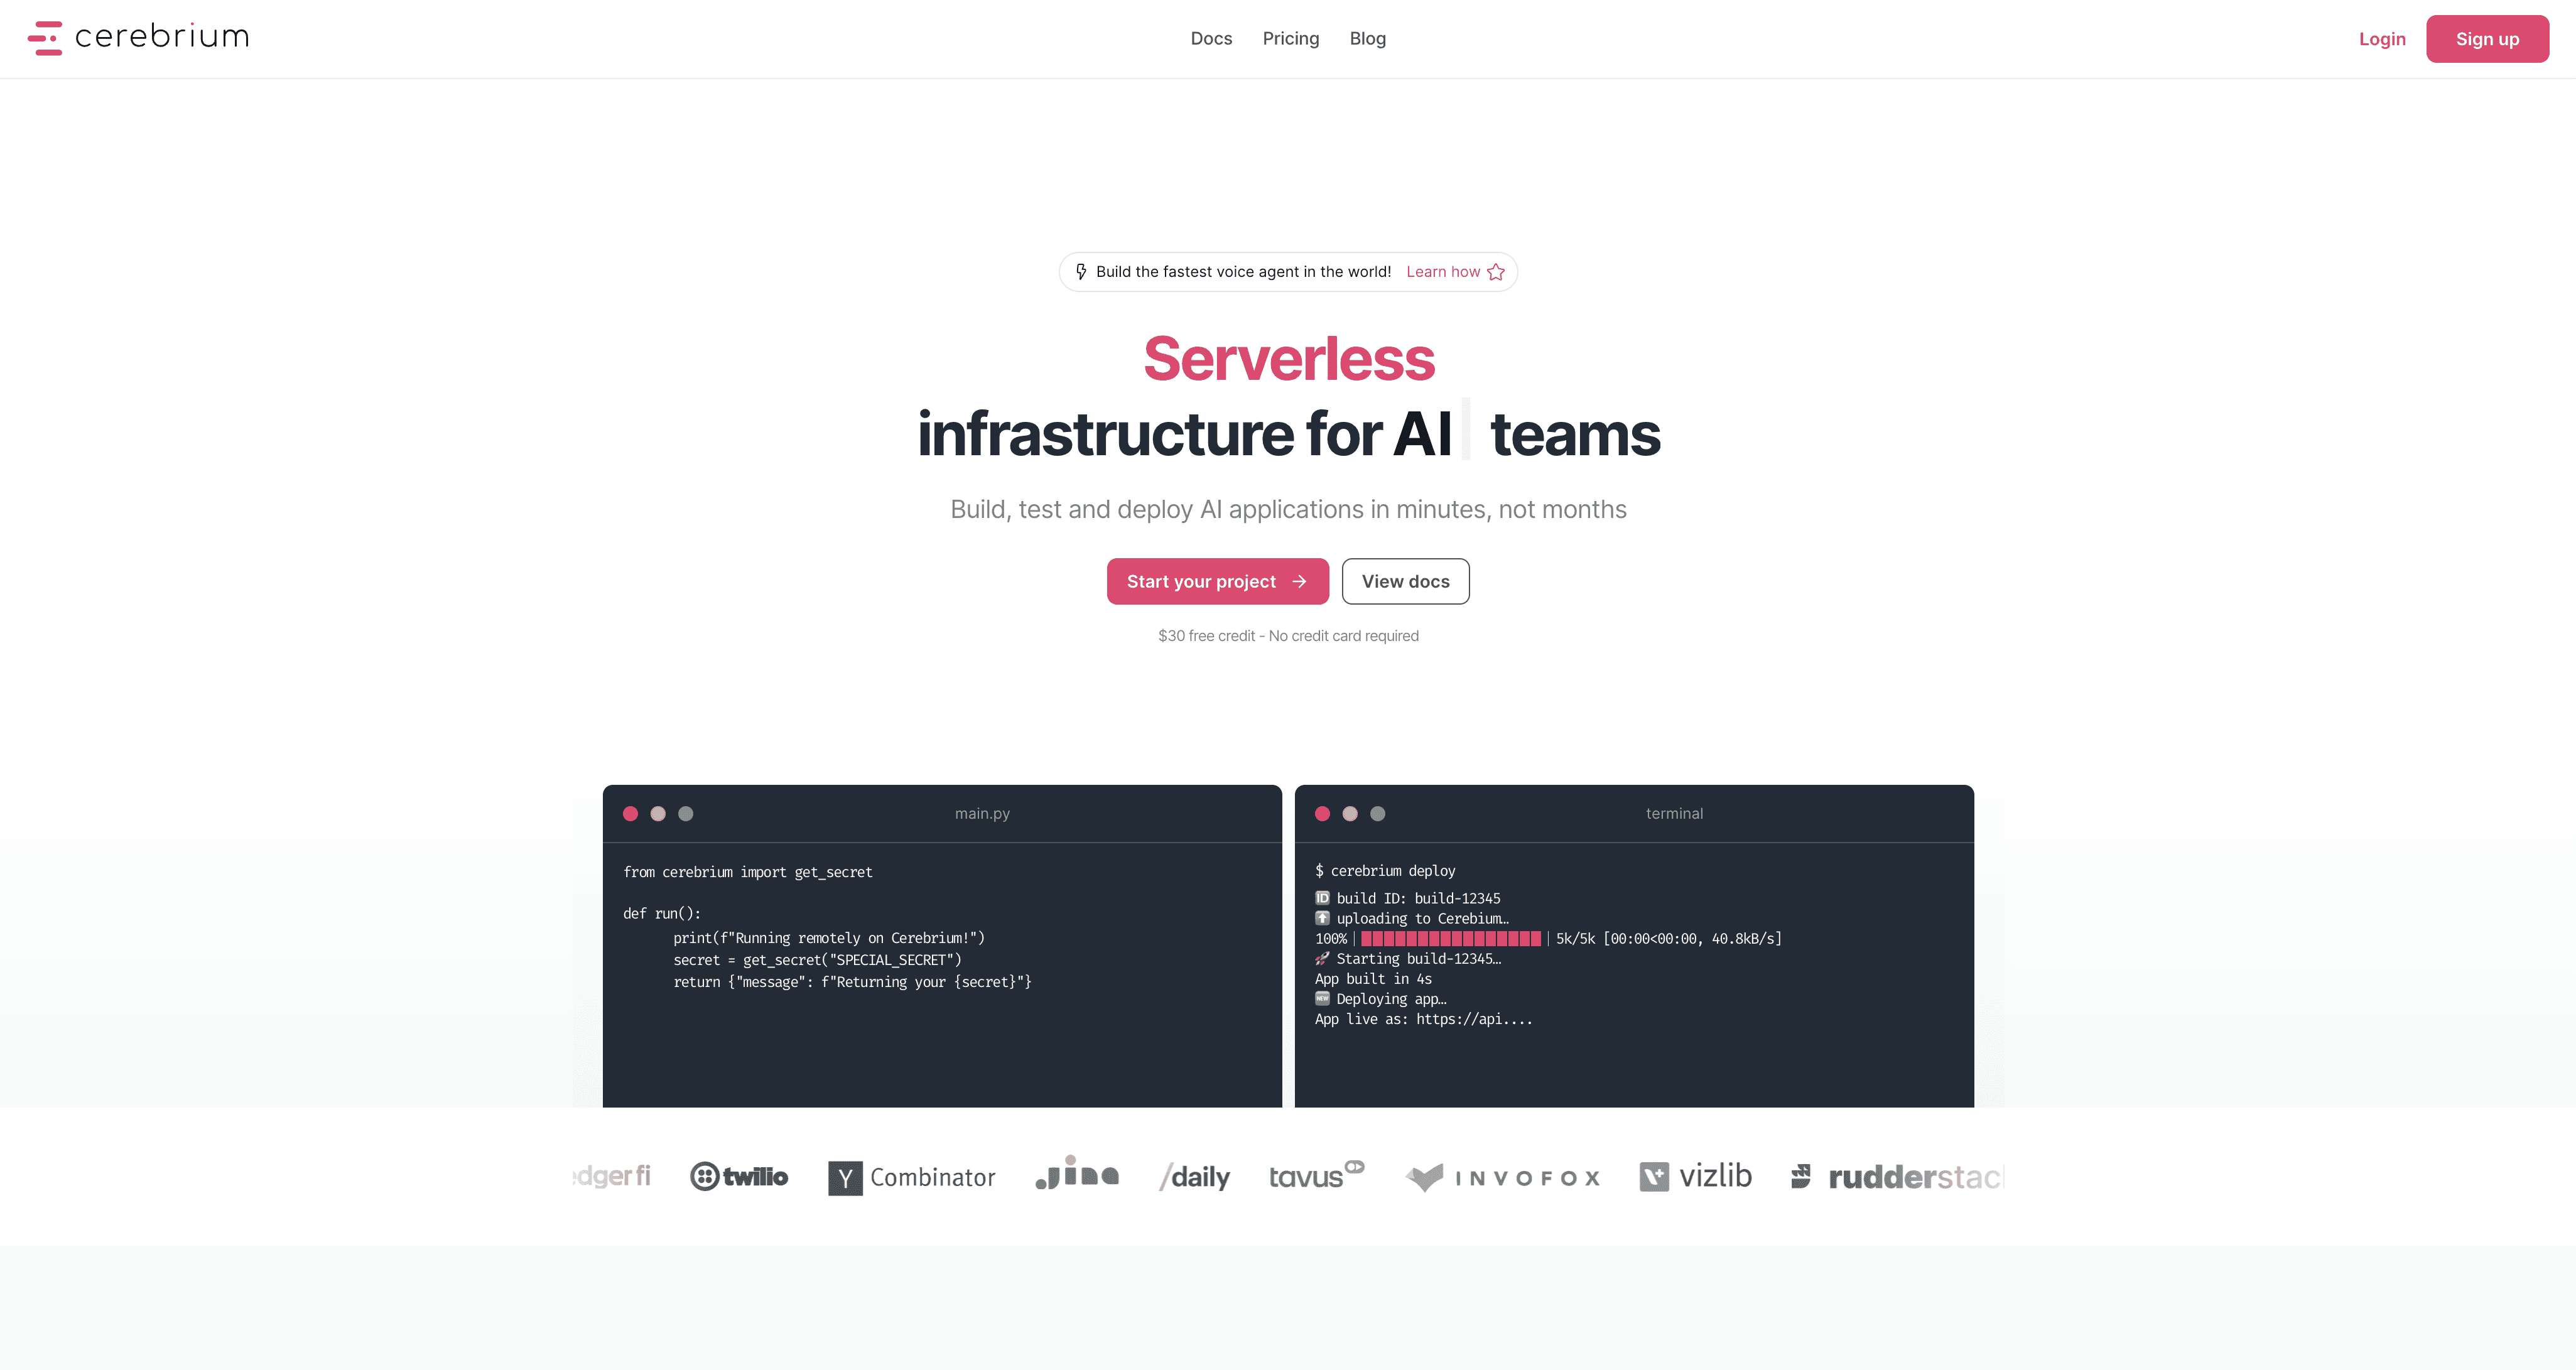
Cerebrium é uma plataforma de infraestrutura de IA sem servidor de ponta, meticulosamente projetada para capacitar desenvolvedores e empresas na implantação, gerenciamento e escalonamento de aplicativos de IA de alto desempenho. Ela simplifica fundamentalmente o fluxo de trabalho de desenvolvimento, abstraindo as complexidades do gerenciamento de infraestrutura, como provisionamento de servidores, configuração e orquestração. Isso permite que as equipes se concentrem inteiramente na construção de produtos de IA inovadores, desde bots de voz em tempo real e IA generativa até trabalhos de processamento em lote em grande escala.
Fundada com a visão de reimaginar a infraestrutura de IA, a Cerebrium fornece um ambiente robusto, confiável e escalável, confiado por startups e empresas. A plataforma é otimizada para velocidade, desempenho e eficiência de custos, garantindo que os modelos de IA possam ser implantados globalmente com baixa latência e alta disponibilidade.
Como usar Cerebrium
Começar a usar o Cerebrium é projetado para ser um processo direto e rápido, permitindo que os desenvolvedores passem do código para um endpoint de API escalável em minutos:
- Inicializar Projeto: Comece usando a CLI ou o painel do Cerebrium para inicializar um novo projeto. Isso configura a configuração básica para sua aplicação.
- Selecionar Hardware: Escolha o hardware ideal para sua carga de trabalho. O Cerebrium oferece uma ampla seleção de mais de 12 tipos de GPU, incluindo NVIDIA T4, A10, A100, H100, bem como CPUs, garantindo que você tenha o poder de computação certo para qualquer tarefa.
- Configurar e Implantar: Configure as definições de sua aplicação sem a necessidade de qualquer sintaxe especial. Você pode usar Dockerfiles personalizados para controle total do ambiente. Um único comando (`cerebrium deploy`) envia seu código e o implanta como uma função sem servidor.
- Escalar e Monitorar: Uma vez implantada, sua aplicação escala automaticamente de zero a milhares de solicitações com base na demanda. Você pode monitorar o desempenho, visualizar logs e rastrear métricas de ponta a ponta através das ferramentas de observabilidade integradas e do suporte ao OpenTelemetry.
Recursos principais do Cerebrium
- Auto-scaling sem servidor: Escala automaticamente as aplicações de zero a milhares de contêineres e vice-versa, garantindo que você pague apenas pela computação que usa.
- Inícios a frio rápidos: As aplicações no Cerebrium têm um tempo médio de início a frio de 2 segundos ou menos, crucial para aplicações em tempo real voltadas para o usuário.
- Amplo Suporte a GPU: Acesso a mais de 12 tipos diferentes de GPU (T4, A10, A100, H100, H200, etc.) para atender a requisitos específicos de desempenho e custo.
- Implantações Multi-Região: Implante aplicações globalmente em várias regiões para reduzir a latência para os usuários e garantir a residência e conformidade dos dados.
- Suporte a Endpoints Avançados: Suporte nativo para APIs REST, endpoints WebSocket para interações em tempo real e endpoints de Streaming para modelos de IA generativa.
- Gerenciamento Eficiente de Carga de Trabalho: Recursos como lote de solicitações para maximizar a taxa de transferência da GPU, controles de concorrência e trabalhos assíncronos para tarefas em segundo plano, como treinamento de modelos.
- Fluxo de Trabalho Amigável ao Desenvolvedor: Integração perfeita com pipelines de CI/CD, lançamentos graduais para atualizações sem tempo de inatividade e gerenciamento seguro de segredos.
- Segurança e Conformidade: A plataforma é compatível com SOC 2 e HIPAA, com uma garantia de tempo de atividade de 99,999%, garantindo que os dados estejam seguros e os serviços sejam confiáveis.
Casos de uso para Cerebrium
O Cerebrium é versátil o suficiente para alimentar uma ampla gama de aplicações de IA, como demonstrado por seus estudos de caso de sucesso:
- Modelos de Linguagem Grandes (LLMs): Implantação e escalonamento de aplicações de IA generativa, como chatbots, ferramentas de criação de conteúdo e assistentes de codificação.
- IA de Voz em Tempo Real: Construção de agentes de voz de IA de latência ultrabaixa e serviços de transcrição em tempo real, como visto com empresas como a Vapi.
- Avatares Digitais e Assistentes Virtuais: Alimentando avatares e assistentes digitais semelhantes a humanos que exigem inferência e interação em tempo real, como usado pela Tavus e bitHuman.
- Processamento de Imagem e Vídeo: Execução de pipelines de inferência em grande escala para reconhecimento de imagem, análise de vídeo e geração de conteúdo.
- Processamento em Lote e Treinamento de Modelos: Execução de grandes trabalhos assíncronos para ajuste fino de modelos ou processamento eficiente de conjuntos de dados massivos.
Vantagens do Cerebrium
O Cerebrium oferece uma vantagem competitiva significativa para equipes que constroem com IA:
- Simplicidade Radical: Elimina a necessidade de uma equipe dedicada de MLOps ou infraestrutura, permitindo que os desenvolvedores implantem modelos de forma independente.
- Custo-Benefício: O modelo de preços por segundo para computação significa que não há custos incorridos por recursos ociosos, levando a economias significativas.
- Alto Desempenho: Otimizado para baixa latência e alta taxa de transferência, tornando-o ideal para serviços de IA exigentes e em tempo real.
- Escalabilidade sob Demanda: Lida sem esforço com picos de tráfego imprevisíveis sem intervenção manual.
- Flexibilidade e Controle: Suporta ambientes personalizados via Docker, dando aos desenvolvedores controle total sobre sua pilha de aplicativos.
Preços e planos
O preço do Cerebrium é transparente e baseado em um modelo de pagamento por uso para recursos de computação, complementado por planos mensais para recursos e suporte adicionais.
- Plano Hobby: $0/mês + custos de computação. Ideal para desenvolvedores e pequenos projetos, inclui 3 assentos de usuário, até 3 aplicativos implantados e suporte da comunidade.
- Plano Standard: $100/mês + custos de computação. Projetado para aplicações de produção, este plano oferece 10 assentos de usuário, 10 aplicativos implantados, 30 GPUs concorrentes e retenção de log de 30 dias.
- Plano Enterprise: Preços personalizados. Para grandes equipes e empresas que exigem escala ilimitada, suporte dedicado, retenção de log ilimitada e recursos avançados de conformidade.
Os custos de computação são cobrados por segundo e variam por hardware (por exemplo, T4 a $0.000164/s, A100 80GB a $0.000694/s). Memória e armazenamento também são cobrados com base no uso, com os primeiros 100GB de armazenamento sendo gratuitos.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 31.5K
- 2026-1: 35.9K
- 2026-2: 25.5K
- 2026-3: 32.1K
- 2026-4: 53.9K
- 2026-5: 42.3K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos86.8%
- 🇳🇬Nigéria5.2%
- 🇻🇳Vietnã4.6%
- 🇮🇳Índia1.9%
- 🇧🇷Brasil1.6%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 97.3% |
Referral | 2.1% |
Email | 0.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| cerebrium | $6.12 |
| cerebrium ai | $0.00 |
| cerebrium careers | $0.00 |
| confidential gpus serverless | $0.00 |
| ultravox-glm-4p7 latency | $0.00 |
Cerebrium Alternatives

Runpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de Máquina
Replicate
Replicate é uma plataforma em nuvem para desenvolvedores executarem, ajustarem e implantarem modelos de IA por meio de uma API simples. Elimina a necessidade de gerenciar infraestrutura complexa, oferecendo acesso a milhares de modelos com preços de pagamento por uso e escalonamento automático.
Aprendizado de Máquina
Baseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
Implantação
ai-rnd.com
Uma plataforma integrada para pesquisa e desenvolvimento de IA, fornecendo um espaço de trabalho unificado, modelos pré-treinados e implantação com um clique para acelerar todo o ciclo de vida da IA. Ideal para desenvolvedores, pesquisadores e empresas.
Gestão de Dados
LangDrive
LangDrive é uma plataforma centrada no desenvolvedor que oferece uma API unificada para ajustar, gerenciar e implantar Modelos de Linguagem de Grande Porte (LLMs) de código aberto. Ele simplifica o complexo pipeline de MLOps, permitindo que as empresas criem modelos de IA personalizados e poderosos para tarefas especializadas com maior controle sobre dados e custos.
Gerenciamento de APICerebrium Categories
Cerebrium Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Modal
O Modal é uma plataforma de infraestrutura serverless de alto desempenho para desenvolvedores de IA e ML. Ele permite que você execute funções Python na nuvem com uma única linha de código, fornecendo acesso instantâneo a GPUs, escalonamento automático de zero a milhares de contêineres e preços por segundo. Elimine a sobrecarga de infraestrutura e concentre-se na construção e implantação de aplicativos computacionalmente intensivos como IA generativa, processamento em lote e análise de dados.
Implantação de Modelo
Beam
Beam é uma plataforma de nuvem sem servidor projetada para desenvolvedores executarem, escalarem e implantarem modelos e aplicativos de IA/ML em GPUs com facilidade. Oferece autoescalonamento instantâneo, cobrança por segundo e um fluxo de trabalho simplificado, permitindo que você transforme código em uma API escalável em minutos, sem gerenciar infraestrutura complexa.
Aprendizado de Máquina
Inferless
Inferless é uma plataforma de GPU sem servidor projetada para desenvolvedores implantarem modelos de aprendizado de máquina em minutos. Ela elimina o gerenciamento de infraestrutura, oferecendo escalonamento automático a partir do zero para lidar com cargas de trabalho variáveis. A plataforma é otimizada para partidas a frio ultrarrápidas e eficiência de custos, permitindo que os usuários economizem até 90% nas contas de GPU pagando apenas pelo que usam.
Implantação de Aprendizado de MáquinaRunpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de MáquinaReplicate
Replicate é uma plataforma em nuvem para desenvolvedores executarem, ajustarem e implantarem modelos de IA por meio de uma API simples. Elimina a necessidade de gerenciar infraestrutura complexa, oferecendo acesso a milhares de modelos com preços de pagamento por uso e escalonamento automático.
Aprendizado de MáquinaBaseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
Implantaçãoai-rnd.com
Uma plataforma integrada para pesquisa e desenvolvimento de IA, fornecendo um espaço de trabalho unificado, modelos pré-treinados e implantação com um clique para acelerar todo o ciclo de vida da IA. Ideal para desenvolvedores, pesquisadores e empresas.
Gestão de DadosLangDrive
LangDrive é uma plataforma centrada no desenvolvedor que oferece uma API unificada para ajustar, gerenciar e implantar Modelos de Linguagem de Grande Porte (LLMs) de código aberto. Ele simplifica o complexo pipeline de MLOps, permitindo que as empresas criem modelos de IA personalizados e poderosos para tarefas especializadas com maior controle sobre dados e custos.
Gerenciamento de API
OctoAI
OctoAI é uma plataforma de computação de alto desempenho para desenvolvedores executarem, ajustarem e escalarem modelos de IA generativa de forma eficiente. Oferece endpoints de API otimizados e prontos para produção para modelos populares de código aberto como Llama, Mixtral e Stable Diffusion. Focando em otimizações profundas do sistema, a OctoAI oferece velocidades de inferência mais rápidas e custos mais baixos, permitindo que as empresas construam e implantem aplicativos de IA escaláveis sem gerenciar infraestrutura complexa.
API
novita.ai
Novita AI é uma plataforma em nuvem centrada no desenvolvedor que oferece acesso acessível e escalável a mais de 200 modelos de IA através de APIs simples. Fornece GPUs sem servidor, instâncias de GPU dedicadas e implantação de modelos personalizados, permitindo que os desenvolvedores construam e escalem aplicações de IA sem gerenciar infraestrutura.
GPU
PPIO
PPIO é uma plataforma líder de computação em nuvem distribuída que fornece poder de computação de IA, APIs de modelo e serviços de computação de borda econômicos e de alto desempenho. Oferece a desenvolvedores e empresas soluções completas para aplicações de IA, vídeo e metaverso, com GPUs sem servidor, instâncias em contêiner e acesso a grandes modelos de linguagem e multimodais populares.
Hospedagem de Modelo
Union.ai
Union.ai é uma plataforma de nível empresarial, pronta para produção, para orquestrar fluxos de trabalho complexos de IA e aprendizado de máquina. Construída sobre o Flyte de código aberto, ela capacita equipes a construir, servir e escalar sistemas de IA compostos com desempenho e eficiência inigualáveis. Ela preenche a lacuna entre dados e ML, otimiza os custos da nuvem com recursos como 'scale-to-zero' e aprimora a velocidade do desenvolvedor por meio de uma experiência integrada e contínua.
Orquestração
Float16.cloud
O Float16.cloud é uma plataforma de GPU sem servidor projetada para acelerar o desenvolvimento de IA. Ele fornece acesso instantâneo a GPUs H100 de alto desempenho com cobrança por segundo, configuração zero e sem partidas a frio. Os desenvolvedores podem implantar LLMs de código aberto, treinar modelos e executar cargas de trabalho de IA diretamente de scripts Python sem gerenciar a infraestrutura.
Plataforma como Serviço (PaaS)
Nexlayer
Nexlayer é a primeira plataforma de nuvem nativa de agentes, projetada para capacitar agentes de codificação de IA a implantar aplicativos prontos para produção rapidamente. Ela automatiza infraestruturas complexas, permitindo que desenvolvedores e fundadores lancem aplicativos full-stack, APIs e bancos de dados em minutos, sem sobrecarga de DevOps.
Application Development
Cerebrium Comments (0)
Sign in to comment.
EntrarNo comments yet.