

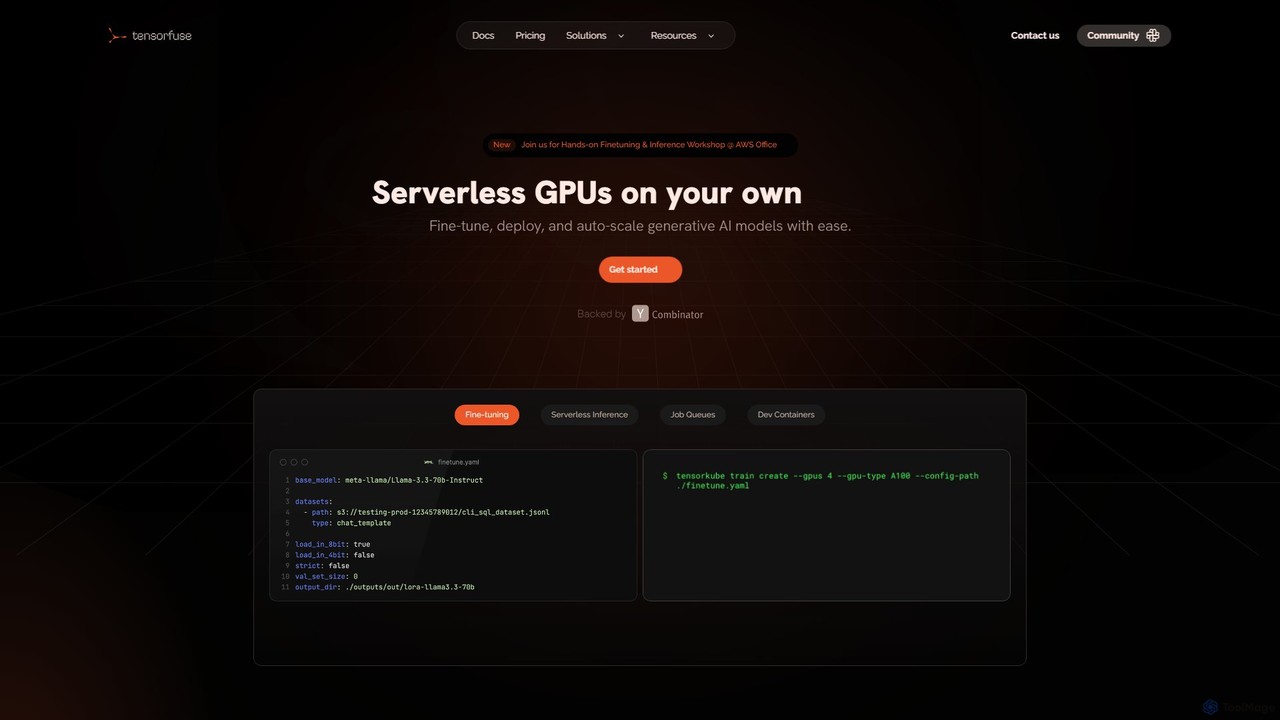
Tensorfuse Overview
O Tensorfuse oferece uma plataforma poderosa para desenvolvedores e organizações gerenciarem GPUs sem servidor diretamente em sua própria infraestrutura de nuvem AWS. Ele foi projetado para otimizar todo o ciclo de vida de modelos de IA generativa, desde o ajuste fino e a experimentação até a implantação e o escalonamento automático em produção. Ao abstrair as complexidades do Kubernetes, Docker e provisionamento de infraestrutura, o Tensorfuse permite que as equipes se concentrem na construção de aplicativos de IA, reduzindo significativamente o tempo de lançamento no mercado e os custos operacionais.
A plataforma foi construída para oferecer o melhor dos dois mundos: a simplicidade de uma arquitetura sem servidor e a segurança e o controle de executar em sua nuvem privada. Isso significa que seus dados proprietários e pesos de modelo nunca saem de seus buckets S3 privados, garantindo máxima segurança e conformidade. O Tensorfuse foi projetado para eficiência, com um tempo de execução de contêiner otimizado que permite partidas a frio rápidas para cargas de trabalho pesadas de GPU, permitindo que os serviços escalem de zero em segundos.
Como usar o Tensorfuse
Começar a usar o Tensorfuse foi projetado para ser um processo simples:
- Inscreva-se e conecte a AWS: Comece inscrevendo-se em um plano (incluindo um nível gratuito 'Hacker') e conectando sua conta AWS. O Tensorfuse então configurará os recursos necessários em seu ambiente de nuvem.
- Use Contêineres de Desenvolvimento para Experimentação: Conecte seu IDE local (como o VS Code) diretamente a uma GPU na nuvem usando os Contêineres de Desenvolvimento do Tensorfuse. Isso elimina a necessidade de SSH, cópia de código e gerenciamento de dependências. Quaisquer alterações em seu código local são sincronizadas instantaneamente, permitindo uma experimentação rápida em tempo real.
- Ajuste Fino de Modelos: Utilize bibliotecas de treinamento populares como Axolotl, Unsloth ou Hugging Face para ajustar modelos de código aberto em seus conjuntos de dados proprietários. Você também pode escrever loops de treinamento personalizados. A plataforma lida com o provisionamento e gerenciamento de GPU subjacentes.
- Implante para Inferência: Implante seus modelos treinados ou pré-treinados como endpoints sem servidor. Esses endpoints escalam automaticamente com base no tráfego de entrada, de zero para lidar com alta concorrência, garantindo eficiência de custos e desempenho. Os modelos podem ser expostos como APIs compatíveis com OpenAI.
- Gerencie com Filas de Trabalho: Para tarefas assíncronas como processamento em lote ou inferência offline, use o recurso de Filas de Trabalho. Você pode enfileirar trabalhos programaticamente, definir parâmetros de escalonamento mínimo e máximo para alocação eficiente de recursos e monitorar seu status por meio de um simples comando CLI.
Recursos principais do Tensorfuse
- Inferência Sem Servidor: Escala automaticamente as implantações de GPU em resposta ao tráfego, com partidas a frio rápidas (iniciando contêineres em segundos) e a capacidade de escalar para zero para economizar custos.
- Ajuste Fino Eficiente: Ajuste modelos com segurança em seus dados privados usando o S3 de sua nuvem. Oferece integração flexível com frameworks populares como Axolotl e Huggingface.
- Filas de Trabalho: Implante e enfileire trabalhos programaticamente para processamento em lote, com alocação eficiente de recursos e controle de custos por meio de escalonamento configurável.
- Contêineres de Desenvolvimento: Conecte o código local a GPUs na nuvem sem SSH para desenvolvimento e experimentação rápidos e iterativos diretamente do seu IDE favorito.
- Inferência Multi-LoRA: Suporte pronto para uso para treinar e trocar a quente milhares de adaptadores LoRA em uma única GPU, maximizando a utilização de hardware e reduzindo os custos de inferência.
- Amplo Suporte de Hardware: Execute cargas de trabalho em uma variedade de hardware, incluindo GPUs NVIDIA (A10G, A100, H100), chips AWS Trainium/Inferentia, TPUs e FPGAs.
- Segurança na Nuvem Privada: Todos os dados, conjuntos de dados e pesos de modelo permanecem em seus buckets S3 privados da AWS, garantindo controle e segurança totais.
Casos de uso para o Tensorfuse
O Tensorfuse é ideal para uma ampla gama de aplicações de IA/ML:
- Startups e Pequenas Equipes: Construa e implante rapidamente recursos alimentados por IA sem uma equipe de DevOps dedicada, passando da ideia à produção 20x mais rápido.
- Inferência em Larga Escala: Sirva modelos de IA generativa para aplicativos com tráfego irregular ou imprevisível, pagando apenas pelo cálculo que você usa.
- Ajuste Fino de Modelos Personalizados: As empresas podem ajustar modelos base como Llama ou Mistral em seus dados proprietários para criar modelos especializados e de alto desempenho para necessidades de negócios específicas.
- Cargas de Trabalho de Processamento em Lote: Execute eficientemente tarefas não em tempo real, como análise de dados, geração de relatórios ou inferência offline em larga escala, usando o sistema de fila de trabalho econômico.
- Pesquisa e Experimentação em ML: Pesquisadores e engenheiros de ML podem usar Contêineres de Desenvolvimento para iterar rapidamente em modelos sem esperar pela configuração da infraestrutura.
Vantagens do Tensorfuse
Os usuários escolhem o Tensorfuse por seus benefícios significativos, incluindo uma redução relatada de 30% nos gastos com GPU na nuvem e um tempo de produção 20x mais rápido. Ele elimina a necessidade de soluções DevOps complexas e autogerenciadas, liberando recursos de engenharia. A plataforma oferece o desempenho e a escalabilidade de um serviço gerenciado com a segurança e os benefícios de custo de executar em sua própria nuvem. Os depoimentos destacam a equipe de suporte excepcional e responsiva, que auxilia na migração e em problemas contínuos, tornando o processo de integração suave e eficiente.
Preços e planos
O Tensorfuse oferece uma estrutura de preços em camadas para atender a diferentes necessidades:
- Hacker (Gratuito): Para desenvolvedores independentes e projetos paralelos. Inclui 100 Horas de GPU Gerenciadas (MGH), Inferência Sem Servidor, Contêineres de Desenvolvimento e suporte da comunidade.
- Starter (US$ 249/mês): Para pequenas equipes. Inclui 2.000 MGH, todos os recursos do Hacker, mais Ajuste Fino, GitHub Actions, Domínios Personalizados e suporte privado no Slack. Uma avaliação gratuita de 14 dias está disponível.
- Growth (US$ 799/mês): Para startups em crescimento. Inclui 5.000 MGH, todos os recursos do Starter, mais Trabalhos em Lote e Filas de Trabalho, Ambientes, inferência Multi-LoRA e suporte premium. Uma avaliação gratuita de 14 dias está disponível.
- Enterprise (Personalizado): Para grandes organizações que precisam de recursos avançados. Inclui MGH personalizado com descontos por volume, todos os recursos do Growth, mais Controle de Acesso Baseado em Função (RBAC), SSO, segurança de nível empresarial (SOC2, HIPAA) e suporte de engenharia dedicado.
- Oferta para Startups: Startups em estágio inicial com menos de US$ 500 mil em financiamento podem ser elegíveis para 10.000 horas de gerenciamento de computação de GPU gratuito por 6 meses.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 10.1K
- 2026-1: 5.4K
- 2026-2: 4.2K
- 2026-3: 4.9K
- 2026-4: 5.3K
- 2026-5: 6.7K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos38.2%
- 🇻🇳Vietnã36.6%
- 🇮🇳Índia25.2%
Top keywords
| Keyword | Cost per click |
|---|---|
| aws serverless gpu | $0.00 |
| brew install aws cli | $4.38 |
| llama.cpp serverless | $0.00 |
| llm inference servers compared: vllm vs tgi vs sglang vs triton | $0.00 |
| tensorfuse | $18.26 |
Tensorfuse Alternatives

Baseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
Implantação
Hopsworks
Hopsworks é um AI Lakehouse em tempo real e o Feature Store mais avançado da indústria. Foi projetado para MLOps, unificando dados e computação para construir e operar sistemas de IA confiáveis e em tempo real. Suporta qualquer framework, nuvem ou ambiente on-premises, permitindo um desenvolvimento de modelos mais rápido e uma redução de custos significativa.
Banco de dados
Runpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de Máquina
Nebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para IA e aprendizado de máquina. Ela fornece acesso às mais recentes GPUs NVIDIA, clusters escaláveis com rede InfiniBand e serviços totalmente gerenciados como Kubernetes e Slurm, permitindo treinamento, ajuste fino e inferência de modelos de IA em qualquer escala.
Aprendizado de Máquina
dstack
dstack é um orquestrador de contêineres de código aberto projetado para equipes de IA e ML. Ele simplifica a orquestração de cargas de trabalho e maximiza a utilização de GPUs em qualquer provedor de nuvem, cluster local ou hardware acelerado. Ele fornece uma camada de computação unificada, otimizando o desenvolvimento, treinamento e implantação de modelos.
OrquestraçãoTensorfuse Categories
Tensorfuse Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Baseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
ImplantaçãoRunpod
Runpod é uma plataforma de nuvem projetada para IA e aprendizado de máquina, oferecendo computação de GPU escalável para implantar, treinar e executar modelos de IA. Ele fornece GPUs sem servidor, modelos pré-construídos e preços econômicos para simplificar todo o fluxo de trabalho de desenvolvimento de IA, da ideia à produção.
Aprendizado de MáquinaNebius
Nebius é uma plataforma de nuvem de alto desempenho projetada especificamente para IA e aprendizado de máquina. Ela fornece acesso às mais recentes GPUs NVIDIA, clusters escaláveis com rede InfiniBand e serviços totalmente gerenciados como Kubernetes e Slurm, permitindo treinamento, ajuste fino e inferência de modelos de IA em qualquer escala.
Aprendizado de Máquina
dstack
dstack é um orquestrador de contêineres de código aberto projetado para equipes de IA e ML. Ele simplifica a orquestração de cargas de trabalho e maximiza a utilização de GPUs em qualquer provedor de nuvem, cluster local ou hardware acelerado. Ele fornece uma camada de computação unificada, otimizando o desenvolvimento, treinamento e implantação de modelos.
Orquestração
GPUX
GPUX é uma plataforma de nuvem GPU descentralizada e sem servidor para inferência de modelos de IA rápida e acessível. Permite que desenvolvedores executem modelos via API e que proprietários de GPU ganhem dinheiro contribuindo com seu hardware para uma rede P2P.
Implantação de Modelo
CircleCI
O CircleCI é uma plataforma líder de integração contínua e entrega contínua (CI/CD) que automatiza o processo de desenvolvimento de software. Ele permite que equipes de engenharia construam, testem e implantem código de forma rápida, confiável e em escala, aumentando a produtividade e a confiança em cada lançamento.
Gerenciamento de Infraestrutura
Together AI
O Together AI é uma plataforma de nuvem líder para desenvolvedores, fornecendo infraestrutura rápida e econômica para executar, ajustar e treinar modelos de IA generativa de código aberto. Oferece uma extensa biblioteca de mais de 200 modelos, APIs de inferência sem servidor, ajuste fino personalizável e clusters de GPU dedicados, criando uma solução de ponta a ponta para construir e escalar aplicações de IA.
Infraestrutura de GPU
ComfyOnline
Uma plataforma baseada em nuvem para executar fluxos de trabalho do ComfyUI online sem hardware caro. Oferece um ambiente sem servidor, implantação de API com um clique para aplicações de IA e acesso pago conforme o uso a GPUs de alto desempenho como H100 e A100. Simplifica todo o processo, desde a criação do fluxo de trabalho até a implantação escalável.
API e Infraestrutura
Beam
Beam é uma plataforma de nuvem sem servidor projetada para desenvolvedores executarem, escalarem e implantarem modelos e aplicativos de IA/ML em GPUs com facilidade. Oferece autoescalonamento instantâneo, cobrança por segundo e um fluxo de trabalho simplificado, permitindo que você transforme código em uma API escalável em minutos, sem gerenciar infraestrutura complexa.
Aprendizado de Máquina
Addepto
A Addepto é uma empresa líder em desenvolvimento de IA e consultoria de Big Data que capacita empresas com soluções de IA personalizadas. Eles se especializam em ciência de dados, aprendizado de máquina, MLOps e estratégia de IA generativa, ajudando os clientes a transformar dados complexos em insights acionáveis e uma vantagem competitiva. A Addepto oferece serviços de ponta a ponta, desde a consulta inicial e estratégia até o desenvolvimento, implantação e suporte contínuo, garantindo soluções sob medida que impulsionam resultados de negócios tangíveis.
Consultoria
ComfyDeploy
O ComfyDeploy é uma plataforma na nuvem para equipes construírem, compartilharem e escalarem fluxos de trabalho do ComfyUI. Ele permite a implantação de APIs prontas para produção com um clique, fornece infraestrutura de GPU com autoescalonamento e oferece interfaces simplificadas para usuários não técnicos. Colabore de forma transparente, gerencie nós e modelos personalizados e transforme processos criativos complexos em aplicativos escaláveis sem sobrecarga de engenharia.
Implantação de Modelo
Release.ai
Release.ai é uma plataforma de nível empresarial para desenvolvedores implantarem, gerenciarem e escalarem facilmente modelos de IA de alto desempenho. Oferece latência de inferência abaixo de 100ms, auto-scaling contínuo, segurança robusta e uma vasta biblioteca de modelos pré-otimizados, permitindo uma rápida integração em qualquer fluxo de trabalho de desenvolvimento com apenas algumas linhas de código.
Plataforma como Serviço (PaaS)
LastMile AI
LastMile AI é uma plataforma de desenvolvedor de nível empresarial para testar, avaliar e monitorar aplicações de IA generativa. Fornece ferramentas como o AutoEval para ajuste fino de avaliadores personalizados, geração de dados sintéticos e monitoramento em tempo real para garantir que os sistemas de IA sejam confiáveis e prontos para produção.
Avaliação de Modelo
MonsterAPI
MonsterAPI é uma plataforma centrada no desenvolvedor que simplifica o ajuste fino e a implantação de modelos de IA generativa de código aberto. Oferece uma interface de chat sem código, o MonsterGPT, para gerenciar tarefas complexas, suportando modelos como Llama, SDXL e Whisper. A plataforma fornece endpoints de API escaláveis e infraestrutura de GPU de nível empresarial por uma fração do custo e tempo típicos, tornando a IA avançada acessível a todos os desenvolvedores.
Plataforma como Serviço (PaaS)
Tensorfuse Comments (0)
Sign in to comment.
EntrarNo comments yet.