ToolMage
Entrar

AI TOOL COMPARISON

Crawly vs Simplescraper

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

Crawly Visão geral

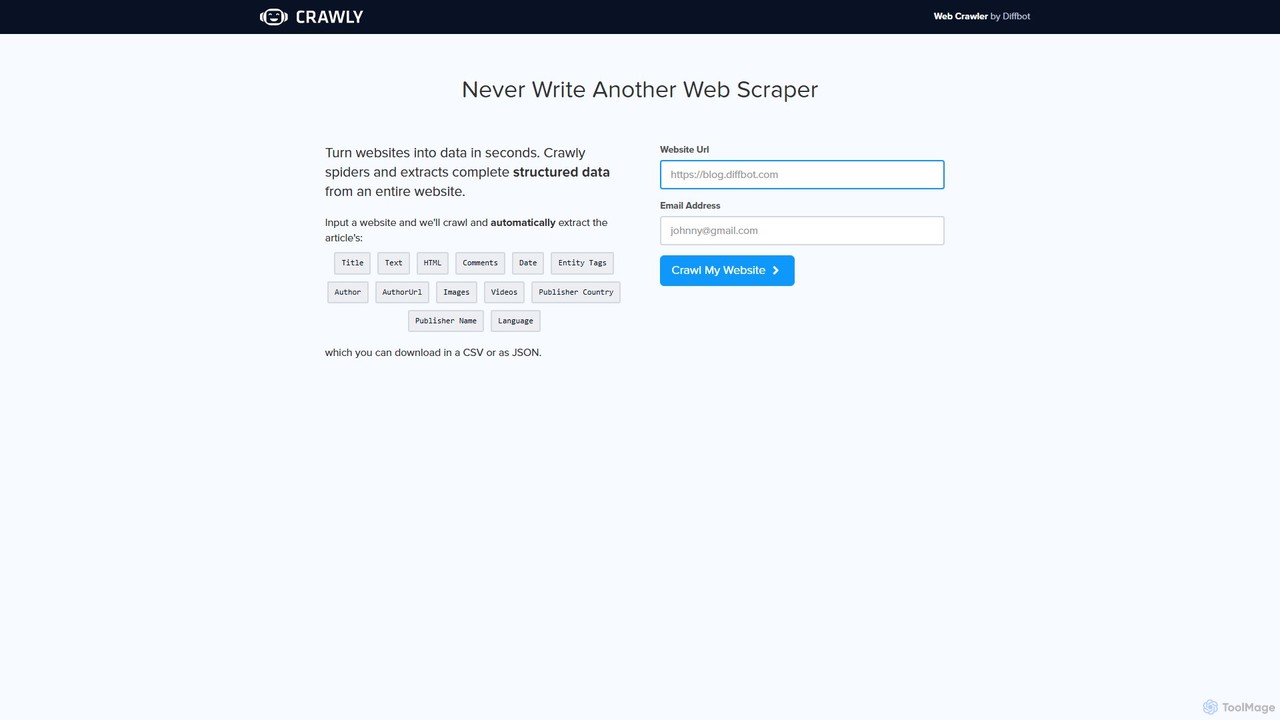
Crawly é um rastreador da web alimentado por IA da Diffbot que extrai automaticamente dados estruturados de sites inteiros. Basta inserir um URL, e o Crawly rastreia o site para extrair informações-chave como artigos, produtos e discussões, convertendo-os em dados limpos em JSON ou CSV sem a necessidade de codificação.

Preview

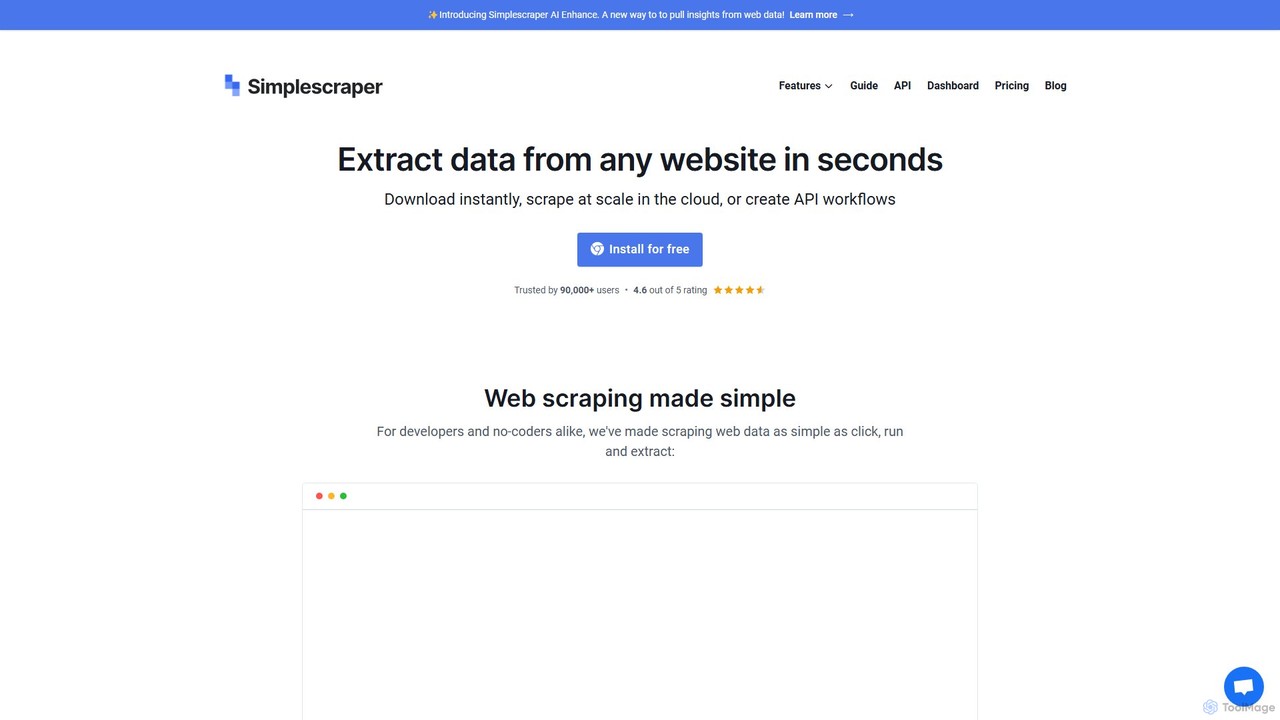
Simplescraper Visão geral

O Simplescraper é uma poderosa ferramenta de web scraping que extrai dados de qualquer site em segundos. Oferece uma extensão do Chrome fácil de usar para seleção de dados sem código, automação baseada na nuvem para scraping em grande escala e um recurso inovador de IA (AI Enhance) para extrair insights usando prompts simples. Transforme sites em dados estruturados (CSV, JSON) ou APIs instantâneas e integre com ferramentas como Google Sheets e Airtable.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Crawly VS Simplescraper — Dados principais
Dados principaisCrawlySimplescraper
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusRaspagem de Dados da WebRaspagem de Dados da Web
Público e funçõesNão verificadoNão verificado
CategoriasRaspagem de Dados da Web · API · Pesquisa de Mercado · AutomaçãoRaspagem de Dados da Web · API · Geração de Leads · Automação
Added10 de ago. de 202517 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Crawly

O Crawly é um rastreador da web poderoso e inteligente desenvolvido pela Diffbot, líder em extração de dados alimentada por IA. Ele foi projetado para eliminar completamente os desafios manuais e técnicos da raspagem de dados da web. Em vez de escrever código complexo ou usar seletores frágeis que quebram com as atualizações do site, o Crawly utiliza inteligência artificial avançada, incluindo visão computacional e processamento de linguagem natural, para entender e interpretar páginas da web como um humano. Isso permite que ele identifique e extraia automaticamente dados completos e estruturados de um site inteiro com apenas um URL como entrada.

A promessa central do Crawly é 'transformar sites em dados em segundos'. Ele navega por um site, seguindo links e analisando a estrutura de cada página para diferenciar entre vários tipos de conteúdo, como artigos, produtos, discussões e galerias de imagens. Os dados extraídos são então organizados em um formato limpo e estruturado, pronto para uso imediato em aplicações, análise de dados ou modelos de aprendizado de máquina.

Como usar o Crawly

Usar o Crawly foi projetado para ser incrivelmente simples e acessível a todos, independentemente da habilidade técnica. O processo envolve apenas alguns passos:

  1. Inserir URL: Navegue até o site do Crawly. No campo de entrada fornecido, insira o URL completo do site que você deseja rastrear.
  2. Fornecer E-mail: Insira seu endereço de e-mail. Isso é usado para notificá-lo e entregar os resultados assim que o rastreamento for concluído.
  3. Iniciar Rastreamento: Clique no botão 'Crawl My Website'. O motor de IA do Crawly começará a rastrear todo o site, analisando páginas и extraindo informações.
  4. Baixar Dados: Assim que o processo for finalizado, você receberá os dados extraídos. Você pode baixá-los em formatos convenientes e estruturados como JSON ou CSV, facilitando a importação para bancos de dados, planilhas ou outro software.

Recursos principais do Crawly

  • Extração Automática com IA: Utiliza a IA avançada da Diffbot para reconhecer e extrair automaticamente dados de artigos, produtos, discussões e mais, sem qualquer configuração manual.
  • Campos de Dados Abrangentes: Extrai um rico conjunto de pontos de dados, incluindo Título, Texto, HTML, Comentários, Data, Autor, URL do Autor, Imagens, Vídeos, Informações do Editor (País, Nome) e Idioma.
  • Reconhecimento de Entidades: Identifica e marca automaticamente entidades dentro do texto, como pessoas, organizações e locais, adicionando outra camada de metadados valiosos.
  • Rastreamento de Site Completo: Ao contrário de raspadores de página única, o Crawly navega por um site inteiro para coletar dados de forma abrangente.
  • Saída de Dados Estruturados: Fornece dados limpos e bem estruturados nos formatos JSON ou CSV, eliminando a necessidade de pós-processamento e limpeza de dados.
  • Solução Sem Código: Não requer habilidades de programação ou conhecimento de tecnologias de raspagem da web, tornando-o acessível a profissionais de marketing, pesquisadores e analistas de negócios.
  • Robusto e Resiliente: Como entende a estrutura semântica do conteúdo, não é facilmente quebrado por mudanças no layout do site, um problema comum com raspadores tradicionais.

Casos de uso para o Crawly

O Crawly é uma ferramenta versátil adequada para uma ampla gama de aplicações:

  • Pesquisa de Mercado: Colete automaticamente informações de produtos concorrentes, preços, avaliações de clientes e menções na imprensa para obter uma vantagem competitiva.
  • Geração de Leads: Extraia detalhes de contato, informações da empresa e pessoal-chave de sites corporativos e diretórios online.
  • Agregação de Conteúdo: Crie um feed de notícias personalizado ou plataforma de conteúdo agregando artigos, postagens de blog e vídeos de múltiplas fontes.
  • Dados para Aprendizado de Máquina: Crie grandes conjuntos de dados de alta qualidade para treinar modelos de aprendizado de máquina, como análise de sentimento em avaliações de produtos ou análise de tendências de artigos de notícias.
  • Monitoramento de Marca: Acompanhe como sua marca, produtos ou executivos são mencionados na web em tempo real.

Vantagens do Crawly

A principal vantagem do Crawly é sua simplicidade e poder. Ele democratiza a extração de dados da web, permitindo que não desenvolvedores realizem tarefas que normalmente exigiriam uma equipe de engenheiros. Ele economiza imensas quantidades de tempo e recursos ao automatizar todo o processo de raspagem. Além disso, sua abordagem orientada por IA garante maior precisão e maior resiliência do que os métodos tradicionais, fornecendo um fluxo confiável de dados de alta qualidade. Por ser um produto da Diffbot, é apoiado por tecnologia de nível empresarial confiada por grandes corporações em todo o mundo.

Preços e planos

O Crawly oferece um rastreamento de teste gratuito diretamente de sua página inicial, permitindo que os usuários testem suas capacidades inserindo um URL e um endereço de e-mail. Isso foi projetado para fornecer uma amostra dos dados estruturados que a ferramenta pode produzir. Para necessidades mais extensas, como rastreamento em larga escala, extração frequente de dados ou acesso à API para uso programático, os usuários normalmente assinariam o conjunto completo de ferramentas oferecido por sua empresa-mãe, a Diffbot. O preço da Diffbot é escalonado, com planos disponíveis para startups, empresas e grandes corporações, oferecendo diferentes níveis de chamadas de API e recursos.

Simplescraper

O Simplescraper é um serviço abrangente de web scraping projetado para tornar a extração de dados acessível a todos, desde usuários sem conhecimento de código até desenvolvedores experientes. Com a confiança de mais de 90.000 usuários, ele transforma qualquer site em uma fonte de dados estruturados e acionáveis. Com sua extensão intuitiva para o Chrome, você pode simplesmente clicar nos dados que precisa e, com sua plataforma em nuvem, pode executar tarefas de scraping automatizadas em grande escala e agendadas. O recurso de destaque, Simplescraper AI Enhance, permite que você use prompts em linguagem natural para extrair, resumir e analisar o conteúdo da web, eliminando a necessidade de configurações complexas ou seletores CSS.

Como usar o Simplescraper

Começar a usar o Simplescraper é simples e oferece múltiplos caminhos, dependendo de suas necessidades:

  1. Usando a Extensão do Chrome (Recomendado): Instale a extensão gratuita da Chrome Store. Navegue até o site que deseja raspar, clique no ícone da extensão e comece a selecionar os elementos de dados (como texto, links ou imagens) que deseja extrair. Você pode visualizar imediatamente os resultados e baixá-los como um arquivo CSV ou JSON.
  2. Salvando uma 'Receita' para Scraping na Nuvem: Para tarefas recorrentes ou em grande escala, salve suas seleções como uma 'receita'. Essa receita pode então ser executada na nuvem, permitindo que você raspe milhares de páginas, lide com paginação e rolagem infinita, e agende raspagens para serem executadas automaticamente.
  3. Usando o Smart Extract: Para uma abordagem ainda mais simples orientada por IA, vá para o recurso 'Smart Extract' no painel. Basta fornecer uma URL e descrever os dados de que precisa (por exemplo, "nome do produto, preço e avaliação do cliente"). A IA analisará a página e gerará automaticamente uma receita de raspagem reutilizável para você.
  4. Aproveitando o AI Enhance: Após executar uma raspagem, vá para a guia 'AI Enhance' dessa receita. Você pode aplicar prompts predefinidos ou personalizados aos seus dados raspados para realizar tarefas como análise de sentimento em avaliações, resumo de artigos ou formatação de endereços.
  5. Integração de API: Cada receita de raspagem que você cria se torna instantaneamente um endpoint de API. Você pode chamar essa API para obter dados atualizados sob demanda, tornando-a perfeita para aplicações e fluxos de trabalho dinâmicos.

Recursos principais do Simplescraper

  • Extração com IA: Utiliza IA através do 'Smart Extract' para identificar dados com base em descrições simples e do 'AI Enhance' para processar e analisar conteúdo raspado usando prompts em linguagem natural.
  • Interface Sem Código e Extensão do Chrome: Uma interface intuitiva de apontar e clicar que facilita para qualquer pessoa selecionar e extrair dados sem escrever uma única linha de código.
  • Scraping Escalável na Nuvem: Execute tarefas de scraping ilimitadas de qualquer tamanho. A plataforma lida com cenários complexos como sites baseados em JavaScript (Single Page Apps), paginação, rolagem infinita e barreiras de login.
  • Geração Instantânea de API: Transforma automaticamente qualquer site que você raspa em uma API estruturada, permitindo acesso programático a dados atualizados.
  • Integrações Abrangentes: Envie seus dados sem problemas para o Google Sheets, Airtable, Zapier ou qualquer outra aplicação usando webhooks, permitindo fluxos de trabalho automatizados.
  • Kit de Ferramentas de Scraping Avançado: Os recursos incluem rotação de proxy para evitar bloqueios, resolução de reCaptcha, scraping profundo (rastreando links para extrair dados de páginas subsequentes) e a capacidade de raspar apenas entradas únicas para evitar duplicatas.
  • Scraping Agendado: Configure suas raspagens para serem executadas em qualquer intervalo que você escolher, de a cada minuto a uma vez por mês, garantindo que seus dados estejam sempre atualizados.

Casos de uso para o Simplescraper

O Simplescraper é versátil e pode ser aplicado em várias indústrias para inúmeros propósitos:

  • E-commerce: Acompanhe os preços da concorrência, monitore a disponibilidade de produtos, agregue avaliações de clientes e colete dados de catálogos de produtos.
  • Imobiliário: Raspe listagens de propriedades de sites como o Zillow para coletar dados sobre preços, localizações, metragem quadrada e detalhes de agentes para análise de mercado.
  • Geração de Leads: Extraia informações de contato de diretórios online, redes profissionais e sites corporativos para construir listas de leads de vendas.
  • Pesquisa de Mercado: Colete dados sobre tendências de mercado, analise o sentimento do público em mídias sociais ou fóruns e colete dados para pesquisa acadêmica ou de negócios.
  • Serviços Financeiros: Colete dados do mercado de ações, notícias financeiras e indicadores econômicos de várias fontes online.
  • Recrutamento: Agregue anúncios de emprego de vários portais de emprego para encontrar talentos ou analisar o mercado de trabalho.

Vantagens do Simplescraper

O Simplescraper se destaca por sua combinação de simplicidade e poder. Sua principal vantagem é seu design amigável, que democratiza o web scraping para usuários não técnicos. Os recursos de IA reduzem significativamente a barreira de entrada, pois os usuários não precisam mais entender a estrutura HTML ou os seletores CSS. Para os desenvolvedores, ele oferece um backend robusto e escalável e uma API poderosa que economiza centenas de horas de desenvolvimento. A confiabilidade da infraestrutura em nuvem, completa com rotação de proxy e resolução de CAPTCHA, garante altas taxas de sucesso para as tarefas de scraping.

Preços e planos

O Simplescraper oferece um modelo freemium com planos projetados para escalar com suas necessidades:

  • Gratuito: Inclui o uso da extensão do navegador para scraping manual e 100 créditos iniciais gratuitos para scraping automatizado na nuvem.
  • Plano Plus: $39/mês por 6.000 créditos, agendamento, integração com Google Sheet e Airtable, webhooks e acesso ao AI Enhance.
  • Plano Pro: $70/mês por 15.000 créditos, incluindo todos os recursos do Plus, além de recursos de scraping de SERP (Página de Resultados do Mecanismo de Busca).
  • Plano Premium: $150/mês por 40.000 créditos e todos os recursos do Pro.
  • Plano Scale: $249/mês por 100.000 créditos, que também inclui um serviço de configuração de receitas e feeds de dados ao vivo.

Todos os planos pagos vêm com suporte individual dedicado. Os créditos são usados para tarefas de scraping na nuvem, com uma página padrão custando 1 crédito e uma página com muito JavaScript custando 2 créditos. O uso do AI Enhance é cobrado separadamente a 1 crédito por 800 palavras processadas.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
Raspagem de Dados da WebAPIAutomação
Só Crawly
Pesquisa de Mercado
Só Simplescraper
Geração de Leads

Etiquetas

Em comum
APIautomaçãoExtração de dadosGeração de leadspesquisa de mercadoNo-codeWeb scraping
Só Crawly
DiffbotJSONdados estruturadosrastreador da web
Só Simplescraper
Extração de dados por IAmineração de dadosRastreamento de preços

Público e funções

Em comum
Sem dados verificados
Só Crawly
Sem dados verificados
Só Simplescraper
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Crawly monthly traffic:

Latest traffic · 2026-05

Visitas mensais
1.8K
Duração média
0:31
Páginas por visita
1.15
Taxa de rejeição
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

Palavras-chave

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

Simplescraper monthly traffic:

Latest traffic · 2026-05

Visitas mensais
104.7K
Duração média
0:28
Páginas por visita
1.75
Taxa de rejeição
48.21%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 93.6K
  • 2026-01: 112.3K
  • 2026-02: 106.1K
  • 2026-03: 101.8K
  • 2026-04: 116.8K
  • 2026-05: 104.7K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States47.86%50.1K
🇮🇳India28.08%29.4K
🇧🇷Brazil8.48%8.9K
🇬🇧United Kingdom8.15%8.5K
🇫🇷France7.43%7.8K

Fontes de tráfego

Source typePercentageEstimated visits
Direto88.2%92.4K
Referência11.73%12.3K
E-mail0.07%73

Palavras-chave

extract urllink extractorsimplescraperurl extractorwebsite url extractor

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Crawly

Avaliação
Não verificado
Comentários
0
Favoritos
162
Curtidas
160

Simplescraper

Avaliação
Não verificado
Comentários
0
Favoritos
172
Curtidas
172

Crawly vs Simplescraper · FAQ da comparação

What do Crawly and Simplescraper have in common?
Both tools are listed under Raspagem de Dados da Web、API、Automação. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Crawly and Simplescraper free?
Listed pricing models: Crawly — Freemium; Simplescraper — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Crawly and Simplescraper?
The primary listed category is Raspagem de Dados da Web for Crawly, and Raspagem de Dados da Web for Simplescraper. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas