Crawly
Raspagem de Dados da Web
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Raspagem de Dados da Web
Raspagem de Dados da Web
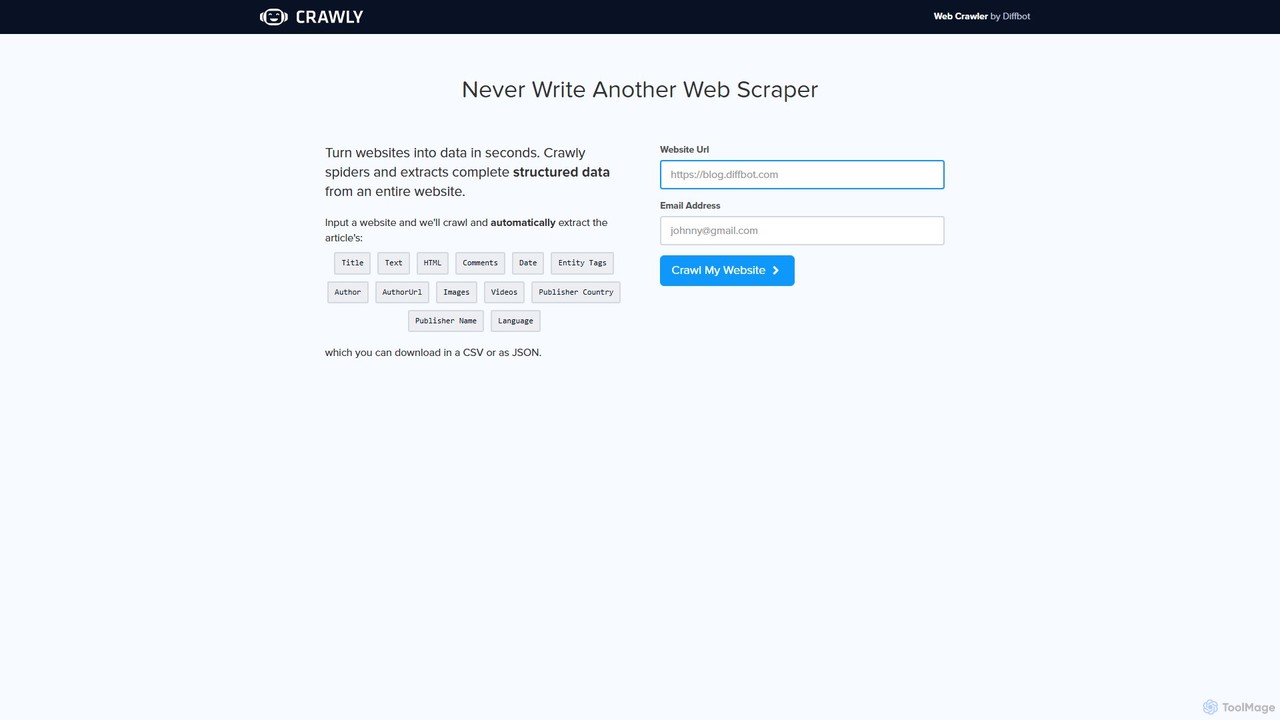
Crawly é um rastreador da web alimentado por IA da Diffbot que extrai automaticamente dados estruturados de sites inteiros. Basta inserir um URL, e o Crawly rastreia o site para extrair informações-chave como artigos, produtos e discussões, convertendo-os em dados limpos em JSON ou CSV sem a necessidade de codificação.
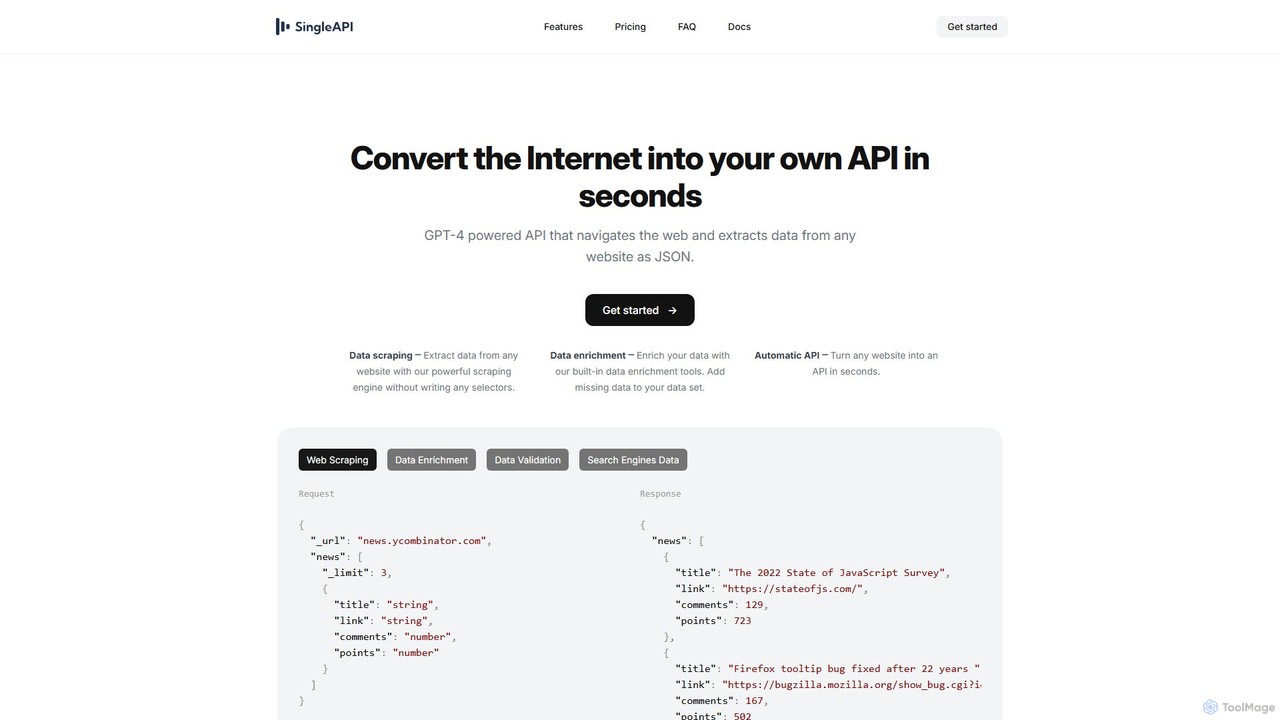
SingleAPI é uma ferramenta alimentada por GPT-4 que converte instantaneamente qualquer site em uma API JSON estruturada. Simplifica a raspagem de dados da web, extração de dados e enriquecimento de dados sem escrever nenhum código ou seletores, permitindo que os usuários acessem dados da web sem esforço para várias aplicações.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Dados principais | Crawly | SingleAPI |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Raspagem de Dados da Web | Raspagem de Dados da Web |
| Público e funções | Não verificado | Não verificado |
| Categorias | Raspagem de Dados da Web · API · Pesquisa de Mercado · Automação | Raspagem de Dados da Web · API · Extração de Dados · Automação |
| Added | 10 de ago. de 2025 | 10 de ago. de 2025 |
| Atualizado | 19 de nov. de 2026 | 19 de nov. de 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
O Crawly é um rastreador da web poderoso e inteligente desenvolvido pela Diffbot, líder em extração de dados alimentada por IA. Ele foi projetado para eliminar completamente os desafios manuais e técnicos da raspagem de dados da web. Em vez de escrever código complexo ou usar seletores frágeis que quebram com as atualizações do site, o Crawly utiliza inteligência artificial avançada, incluindo visão computacional e processamento de linguagem natural, para entender e interpretar páginas da web como um humano. Isso permite que ele identifique e extraia automaticamente dados completos e estruturados de um site inteiro com apenas um URL como entrada.
A promessa central do Crawly é 'transformar sites em dados em segundos'. Ele navega por um site, seguindo links e analisando a estrutura de cada página para diferenciar entre vários tipos de conteúdo, como artigos, produtos, discussões e galerias de imagens. Os dados extraídos são então organizados em um formato limpo e estruturado, pronto para uso imediato em aplicações, análise de dados ou modelos de aprendizado de máquina.
Usar o Crawly foi projetado para ser incrivelmente simples e acessível a todos, independentemente da habilidade técnica. O processo envolve apenas alguns passos:
O Crawly é uma ferramenta versátil adequada para uma ampla gama de aplicações:
A principal vantagem do Crawly é sua simplicidade e poder. Ele democratiza a extração de dados da web, permitindo que não desenvolvedores realizem tarefas que normalmente exigiriam uma equipe de engenheiros. Ele economiza imensas quantidades de tempo e recursos ao automatizar todo o processo de raspagem. Além disso, sua abordagem orientada por IA garante maior precisão e maior resiliência do que os métodos tradicionais, fornecendo um fluxo confiável de dados de alta qualidade. Por ser um produto da Diffbot, é apoiado por tecnologia de nível empresarial confiada por grandes corporações em todo o mundo.
O Crawly oferece um rastreamento de teste gratuito diretamente de sua página inicial, permitindo que os usuários testem suas capacidades inserindo um URL e um endereço de e-mail. Isso foi projetado para fornecer uma amostra dos dados estruturados que a ferramenta pode produzir. Para necessidades mais extensas, como rastreamento em larga escala, extração frequente de dados ou acesso à API para uso programático, os usuários normalmente assinariam o conjunto completo de ferramentas oferecido por sua empresa-mãe, a Diffbot. O preço da Diffbot é escalonado, com planos disponíveis para startups, empresas e grandes corporações, oferecendo diferentes níveis de chamadas de API e recursos.
SingleAPI é uma ferramenta revolucionária projetada para transformar toda a internet em uma fonte de dados estruturada e amigável para desenvolvedores. Alimentada pelo GPT-4, ela fornece uma API inteligente que pode navegar em qualquer site, entender sua estrutura e extrair as informações desejadas em um formato JSON limpo, tudo em segundos. Isso elimina o processo tedioso e complexo da raspagem de dados tradicional, onde os desenvolvedores precisariam escrever e manter seletores frágeis (como seletores CSS ou XPaths) para visar pontos de dados específicos. Com o SingleAPI, você simplesmente descreve os dados de que precisa, e a IA cuida do resto.
A plataforma foi construída para simplicidade e poder, atendendo a uma ampla gama de usuários, desde hobbistas individuais até grandes empresas. Se você precisa monitorar preços de concorrentes, agregar notícias, gerar leads ou enriquecer seus conjuntos de dados existentes, o SingleAPI oferece uma solução robusta e confiável que economiza tempo e recursos significativos.
Usar o SingleAPI é notavelmente simples. O processo envolve o envio de uma simples requisição HTTP com um corpo JSON que especifica o site de destino e o esquema de dados que você deseja extrair. O motor de IA então visita a URL, interpreta sua solicitação, encontra os dados relevantes na página e os retorna em uma resposta JSON perfeitamente estruturada.
Por exemplo, para extrair os 3 principais artigos do Hacker News, sua solicitação seria assim:
Requisição:
{
  "_url": "news.ycombinator.com",
  "news": [
    {
      "_limit": 3,
      "title": "string",
      "link": "string",
      "comments": "number",
      "points": "number"
    }
  ]
}
A IA do SingleAPI entende essa estrutura, navega até o Hacker News, identifica a lista de artigos e extrai o título, link, contagem de comentários e pontos para as três primeiras entradas, retornando um objeto JSON limpo.
A versatilidade do SingleAPI o torna adequado para uma ampla gama de aplicações:
A principal vantagem do SingleAPI é sua simplicidade e eficiência. Ele abstrai as complexidades da raspagem de dados da web, como lidar com sites dinâmicos pesados em JavaScript, gerenciar proxies e analisar HTML. Isso permite que desenvolvedores e não desenvolvedores se concentrem em usar os dados em vez de adquiri-los. A abordagem orientada por IA o torna mais resiliente a mudanças no layout do site em comparação com os raspadores tradicionais. Sua flexibilidade em formatos de dados e entrega em tempo real via webhooks o torna uma ferramenta poderosa para negócios modernos orientados por dados.
O SingleAPI oferece uma estrutura de preços em níveis para atender a diferentes necessidades:
A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.
O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇮🇶Iraq | 100% | 438 |
Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.