ToolMage
Entrar

AI TOOL COMPARISON

Skrape vs Webcrawlerapi

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Visão geral

Skrape Visão geral

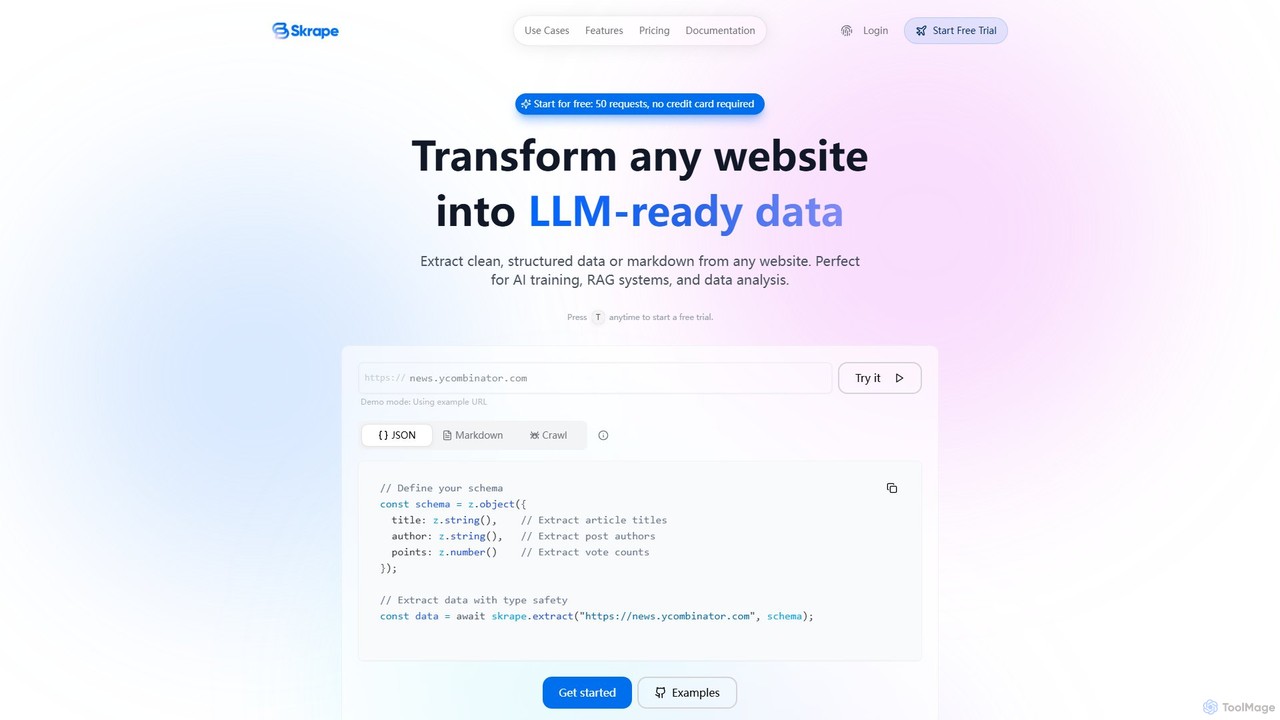
Skrape é uma API de web scraping alimentada por LLM, projetada para transformar qualquer site em dados limpos, estruturados e prontos para LLM. Simplifica a extração de dados convertendo páginas da web em JSON estruturado ou markdown limpo, tornando-o ideal para treinamento de IA, sistemas RAG e análise de dados. Com recursos como manipulação de conteúdo dinâmico e rastreamento inteligente, o Skrape oferece uma solução confiável para desenvolvedores e empresas automatizarem seus pipelines de coleta de dados.

Preview

Webcrawlerapi Visão geral

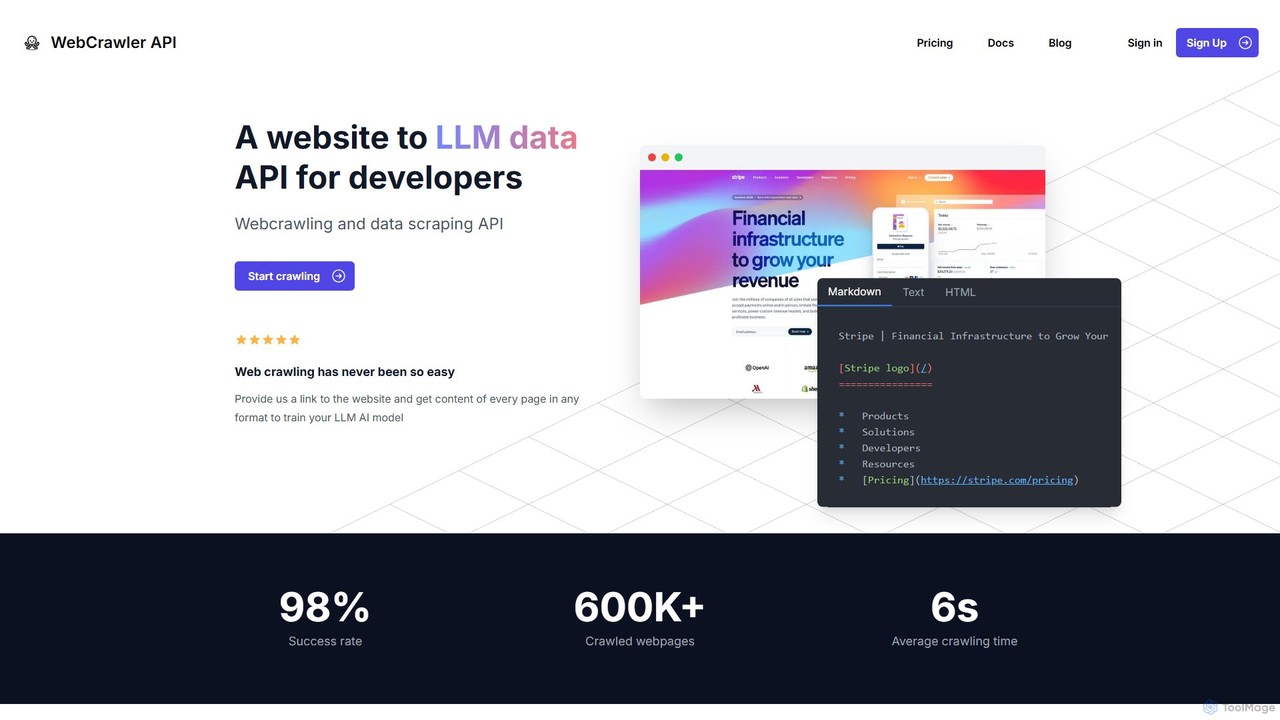
Webcrawlerapi é uma API poderosa para desenvolvedores rastrearem sites e extraírem dados limpos sem esforço. Simplifica a raspagem de dados ao lidar com renderização de JavaScript, medidas anti-bot e análise de dados. Ideal para coletar conteúdo estruturado como Markdown ou texto para treinar modelos de IA LLM ou para sistemas de Geração Aumentada por Recuperação (RAG), oferece uma alta taxa de sucesso e um modelo de preços simples de pagamento conforme o uso.

Preview

Dados principais

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Skrape VS Webcrawlerapi — Dados principais
Dados principaisSkrapeWebcrawlerapi
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusRaspagemExtração de Dados
Público e funçõesNão verificadoNão verificado
CategoriasRaspagem · API · AutomaçãoExtração de Dados · API · Automação
Added12 de ago. de 20252 de ago. de 2025
Atualizado19 de nov. de 202619 de nov. de 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Skrape

Skrape é uma API de web scraping poderosa e amigável para desenvolvedores que utiliza Modelos de Linguagem Grandes (LLMs) para extrair dados limpos e estruturados de qualquer site. Foi especificamente projetada para otimizar o processo de coleta de dados para aplicações modernas de IA, como sistemas de Geração Aumentada por Recuperação (RAG), ajuste fino de modelos e análise de dados aprofundada. O serviço pode transformar páginas web complexas, incluindo aquelas com conteúdo dinâmico renderizado por JavaScript, em markdown bem formatado ou dados JSON estruturados de acordo com um esquema definido pelo usuário.

A filosofia central do Skrape é simplificar a extração de dados da web. Em vez de lidar com análises complexas de HTML, medidas anti-scraping ou gerenciamento de proxies, os desenvolvedores podem usar uma simples chamada de API para obter os dados de que precisam. A plataforma é construída para confiabilidade e escala, garantindo que os usuários sempre recebam dados frescos e em tempo real, sem qualquer cache.

Como usar Skrape

Usar o Skrape é direto e projetado para uma experiência de desenvolvedor sem interrupções. Aqui está o fluxo de trabalho típico:

  1. Inscreva-se e Obtenha a Chave da API: Primeiro, crie uma conta no site do Skrape. Você pode começar com um teste gratuito que fornece 50 créditos sem a necessidade de um cartão de crédito. Ao se inscrever, você receberá uma chave de API do seu painel.
  2. Autenticação: Todas as solicitações de API devem ser autenticadas usando um Token Bearer. Você precisa incluir sua chave de API no cabeçalho `Authorization` de suas solicitações (por exemplo, `Authorization: Bearer YOUR_API_KEY`).
  3. Escolha um Endpoint: O Skrape oferece vários endpoints de API com base em suas necessidades:
    • /api/markdown: Converte uma única página da web em markdown limpo.
    • /api/extract: Extrai dados JSON estruturados de uma página da web com base em um esquema Zod que você fornece. Isso permite uma extração de dados precisa e com segurança de tipo.
    • /api/crawl: Rastreia um site inteiro, seguindo links para coletar dados de várias páginas de forma eficiente.
  4. Faça a Chamada da API: Use seu cliente HTTP preferido ou os SDKs oficiais do Skrape (disponíveis para Node.js e Python) para fazer solicitações à API. Por exemplo, para extrair dados, você definiria sua estrutura de dados desejada como um esquema e a passaria junto com a URL de destino para o endpoint `/api/extract`.
  5. Processe os Resultados: A API retorna os dados extraídos no formato que você solicitou — markdown limpo ou JSON estruturado. O serviço também suporta o processamento de trabalhos em segundo plano para tarefas de longa duração, e você pode verificar o status do trabalho através do endpoint `/api/get-job`.

Recursos principais do Skrape

  • Extração Inteligente Alimentada por LLM: Defina a estrutura de dados desejada usando um esquema, e a IA extrairá e formatará inteligentemente as informações em JSON estruturado.
  • Rastreamento Inteligente: Rastreia automaticamente sites inteiros, mesmo aqueles sem sitemaps, enquanto respeita as regras do `robots.txt` para garantir um scraping ético.
  • Manipulação de Conteúdo Dinâmico: Suporta totalmente a renderização de JavaScript, permitindo lidar com Aplicações de Página Única (SPAs) e outros conteúdos dinâmicos com os quais os scrapers tradicionais têm dificuldade.
  • Conversão para Markdown Limpo: Converte qualquer página da web em markdown perfeitamente formatado e limpo, ideal para sistemas RAG e bases de conhecimento.
  • Ações da API: Pode realizar ações em uma página como clicar em botões, rolar e esperar que um conteúdo específico seja carregado antes da extração.
  • Dados em Tempo Real: O Skrape não armazena conteúdo em cache, garantindo que você sempre obtenha os dados mais frescos e atualizados diretamente da fonte.
  • Amigável para Desenvolvedores: Oferece SDKs oficiais para Node.js e Python, documentação abrangente da API e um formato consistente de tratamento de erros.

Casos de uso para Skrape

O Skrape é versátil e pode ser aplicado a uma ampla gama de tarefas de coleta de dados:

  • Coleta de Dados Pronta para RAG: Transforme sites em conjuntos de dados limpos e estruturados com extração automática de metadados, perfeitos para alimentar aplicações de Geração Aumentada por Recuperação.
  • Pipeline de Dados de Treinamento de IA: Automatize a coleta de conjuntos de dados diversos, de alta qualidade e multilíngues para o ajuste fino de modelos de linguagem e outras aplicações de IA.
  • Construção de Base de Conhecimento: Crie bases de conhecimento abrangentes extraindo documentação técnica, referências de API, tutoriais e artigos de pesquisa de múltiplas fontes.
  • Monitoramento de Conteúdo de IA: Mantenha-se atualizado com as últimas tendências da indústria, rastreando e coletando notícias, pesquisas e blogs técnicos relacionados à IA.
  • Dados para Avaliação de Modelos: Reúna dados do mundo real de vários domínios para avaliar e comparar o desempenho de seus LLMs.

Vantagens do Skrape

O Skrape oferece uma vantagem significativa sobre os métodos tradicionais de web scraping. Suas principais vantagens incluem sua simplicidade, poder e confiabilidade. A abordagem API-first abstrai as complexidades do web scraping, permitindo que os desenvolvedores se concentrem no uso dos dados. O uso de LLMs para extração oferece precisão e flexibilidade superiores em comparação com os métodos frágeis baseados em seletores CSS. Além disso, sua capacidade de lidar com conteúdo dinâmico e fornecer uma saída limpa e pronta para uso economiza tempo e esforço de desenvolvimento significativos.

Preços e planos

O Skrape oferece um modelo de preços transparente e baseado em créditos, projetado para escalar com suas necessidades.

  • Teste Gratuito: Comece com 50 créditos gratuitos para testar o serviço. Nenhum cartão de crédito é necessário.
  • Plano Starter: $15/mês por 3.000 créditos. Ideal para pequenos projetos e desenvolvedores individuais.
  • Plano Growth: $50/mês por 10.000 créditos. Adequado para equipes em crescimento com maiores necessidades de uso. Inclui suporte prioritário.
  • Plano Pro: $250/mês por 50.000 créditos. Projetado para empresas e equipes com requisitos de alto volume. Inclui suporte prioritário e limites de taxa personalizados.

Uso de Créditos:

  • HTML para Markdown: 1 crédito por página
  • Web Crawling: 1 crédito por página
  • Extração de Dados por IA: 5 créditos por página

Webcrawlerapi

Webcrawlerapi é uma API especializada projetada para otimizar o processo de rastreamento da web e extração de dados para desenvolvedores. Em uma era onde os dados são cruciais para treinar grandes modelos de linguagem (LLMs) e alimentar aplicações de IA, a raspagem de dados tradicional apresenta desafios significativos. Estes incluem lidar com conteúdo dinâmico renderizado por JavaScript, contornar sistemas anti-bot sofisticados, gerenciar proxies e limpar HTML bagunçado em formatos utilizáveis. A Webcrawlerapi abstrai todas essas complexidades, fornecendo uma interface simples, mas poderosa, para transformar qualquer site em uma fonte de dados estruturada.

Com uma taxa de sucesso relatada de 98% e um tempo médio de rastreamento de apenas 6 segundos, o serviço é construído para eficiência e confiabilidade. Ele permite que os desenvolvedores se concentrem na lógica principal de sua aplicação, em vez de se prenderem às complexidades de construir e manter uma infraestrutura de rastreamento escalável. Ao fornecer um link, os desenvolvedores podem receber conteúdo limpo e pronto para uso em formatos como Markdown, texto ou HTML bruto, tornando-o perfeito para alimentar pipelines de treinamento de modelos de IA ou bases de conhecimento para sistemas RAG.

Como usar Webcrawlerapi

Integrar a Webcrawlerapi em seu projeto é projetado para ser simples. O processo geralmente envolve apenas algumas linhas de código. Primeiro, você precisa se inscrever no site da Webcrawlerapi para obter sua chave de acesso única da API. Em seguida, você pode usar uma de suas bibliotecas de cliente fornecidas para linguagens de programação populares.

Por exemplo, em um ambiente NodeJS, você começaria instalando a biblioteca do cliente via npm: npm i webcrawlerapi-js. Então, em seu código, você importa a biblioteca, cria uma nova instância do cliente com sua chave de API e chama o método `crawl`. Este método aceita parâmetros como a `url` de destino, o `scrape_type` desejado (por exemplo, 'markdown') e limites opcionais como `items_limit`. A API então lida com todo o processo de rastreamento em segundo plano e retorna uma resposta JSON estruturada com os dados extraídos. Padrões de integração simples semelhantes estão disponíveis para Python, PHP e .NET, tornando-o acessível a uma ampla gama de desenvolvedores.

Recursos principais do Webcrawlerapi

  • Manuseio Automatizado de Links: A API descobre e gerencia inteligentemente todos os links internos em um site, garantindo um rastreamento abrangente enquanto lida automaticamente com duplicatas e limpa URLs.
  • Renderização Avançada de JavaScript: Renderiza efetivamente conteúdo dinâmico do lado do cliente usando um sistema estável e robusto, superando a instabilidade e os problemas de memória frequentemente associados a ferramentas como Puppeteer ou Playwright.
  • Evasão Robusta de Anti-Bot: A Webcrawlerapi vem com mecanismos integrados para lidar com CAPTCHAs, bloqueios de IP, limites de taxa e outras defesas anti-bot comuns, garantindo uma alta taxa de sucesso.
  • Limpeza Automática de Dados: Inclui regras de análise poderosas para converter HTML bruto e complexo em formatos limpos e estruturados como Markdown ou texto simples, economizando um tempo significativo de pós-processamento para os desenvolvedores.
  • Infraestrutura Escalável: O serviço gerencia uma infraestrutura distribuída de rastreadores e proxies, permitindo que você dimensione seus esforços de extração de dados de algumas páginas para milhões sem se preocupar com o hardware subjacente ou o gerenciamento de rede.
  • API e SDKs Amigáveis para Desenvolvedores: Oferece uma API simples e bibliotecas de cliente oficiais para as principais linguagens como NodeJS, Python, PHP e .NET, completas com documentação clara.

Casos de uso para Webcrawlerapi

A Webcrawlerapi é versátil e pode ser aplicada a uma variedade de tarefas intensivas em dados. Seus principais casos de uso giram em torno de IA e análise de dados.

  • Coleta de Dados para Treinamento de LLM: Rastreie sistematicamente sites, blogs e fóruns para coletar grandes quantidades de dados de texto de alta qualidade e específicos de domínio para treinar ou ajustar modelos de linguagem grandes personalizados.
  • Geração Aumentada por Recuperação (RAG): Construa e mantenha bases de conhecimento atualizadas para sistemas RAG. Rastreie documentação de produtos, centrais de ajuda ou sites de notícias para fornecer aos LLMs informações precisas e em tempo real para responder às perguntas dos usuários.
  • Pesquisa de Mercado e Análise Competitiva: Extraia automaticamente detalhes de produtos, informações de preços, avaliações de clientes e conteúdo de marketing de sites de concorrentes para obter insights estratégicos.
  • Agregação de Conteúdo: Potencialize agregadores de notícias, quadros de empregos ou sites de listagem de imóveis, rastreando regularmente várias fontes и consolidando os dados em uma plataforma unificada.

Vantagens do Webcrawlerapi

A principal vantagem da Webcrawlerapi é sua simplicidade e eficiência. Ela permite que as equipes de desenvolvimento terceirizem toda a infraestrutura de rastreamento da web e o ônus da manutenção. Isso significa um tempo de lançamento mais rápido para produtos orientados a dados. A alta taxa de sucesso (98%) e os recursos robustos anti-bot garantem que os pipelines de dados sejam confiáveis. Além disso, seu modelo de preços transparente e de pagamento conforme o uso é altamente econômico, pois você paga apenas por solicitações bem-sucedidas, eliminando o risco e a sobrecarga associados a assinaturas ou à construção de uma solução interna.

Preços e planos

A Webcrawlerapi emprega um modelo de preços 'pague pelo uso' direto e transparente, evitando completamente assinaturas e taxas ocultas. Os custos são calculados com base no número de páginas que você rastreia com sucesso a cada mês. O serviço inclui trabalhos de rastreamento ilimitados, uma rede de proxy ilimitada e gerenciada automaticamente, e suporte por e-mail em seu preço. Para uma estimativa de custo clara, o site fornece uma calculadora. Como exemplo, rastrear 10.000 páginas em um mês custaria aproximadamente $20. Este modelo é ideal para projetos de todos os tamanhos, desde experimentos em pequena escala até operações de dados em grande escala, pois os custos escalam diretamente com o uso. A plataforma também permite que os usuários experimentem o serviço antes de fazer uma compra, provavelmente através de uma alocação de crédito gratuito para novas contas.

Posicionamento

A taxonomia mostra onde os produtos se sobrepõem e onde cada um tem foco próprio. Campos desconhecidos são exibidos claramente e nunca preenchidos com suposições.

Categorias

Em comum
APIAutomação
Só Skrape
Raspagem
Só Webcrawlerapi
Extração de Dados

Etiquetas

Em comum
APIautomaçãoColeta de dadosExtração de dadosferramenta de desenvolvedorGeração Aumentada por Recuperação
Só Skrape
Treinamento de IAconteúdo dinâmicoJSONModelo de Linguagem de Grande EscalaMarkdownWeb scraping
Só Webcrawlerapi
Raspagem de dadosRenderização JavaScriptTreinamento de LLMRastreamento da web

Público e funções

Em comum
Sem dados verificados
Só Skrape
Sem dados verificados
Só Webcrawlerapi
Sem dados verificados

Comparação de tráfego

O tráfego usa a mesma escala para representar corretamente a visibilidade de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Skrape

Não verificado

Webcrawlerapi monthly traffic:

Latest traffic · 2026-05

Visitas mensais
5.4K
Duração média
0:46
Páginas por visita
1.95
Taxa de rejeição
41.65%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5.1K
  • 2026-01: 4.5K
  • 2026-02: 4K
  • 2026-03: 4.3K
  • 2026-04: 5.6K
  • 2026-05: 5.4K

Principais regiões

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States49.13%2.7K
🇩🇪Germany20.9%1.1K
🇮🇳India14.85%809
🇻🇳Vietnam12.23%666
🇦🇺Australia2.89%157

Palavras-chave

better to save as an html or md file packing more informationdata scraping law casesfirecrawl alternativesllms txt generator onlinesubmit website to chatgpt

Sinais da comunidade

Avaliações e reações são sinais da comunidade, não substituem a adequação do produto.

Skrape

Avaliação
Não verificado
Comentários
0
Favoritos
166
Curtidas
153

Webcrawlerapi

Avaliação
Não verificado
Comentários
0
Favoritos
182
Curtidas
179

Skrape vs Webcrawlerapi · FAQ da comparação

What do Skrape and Webcrawlerapi have in common?
Both tools are listed under API、Automação. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Skrape and Webcrawlerapi free?
Listed pricing models: Skrape — Freemium; Webcrawlerapi — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Skrape and Webcrawlerapi?
The primary listed category is Raspagem for Skrape, and Extração de Dados for Webcrawlerapi. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparações relacionadas