

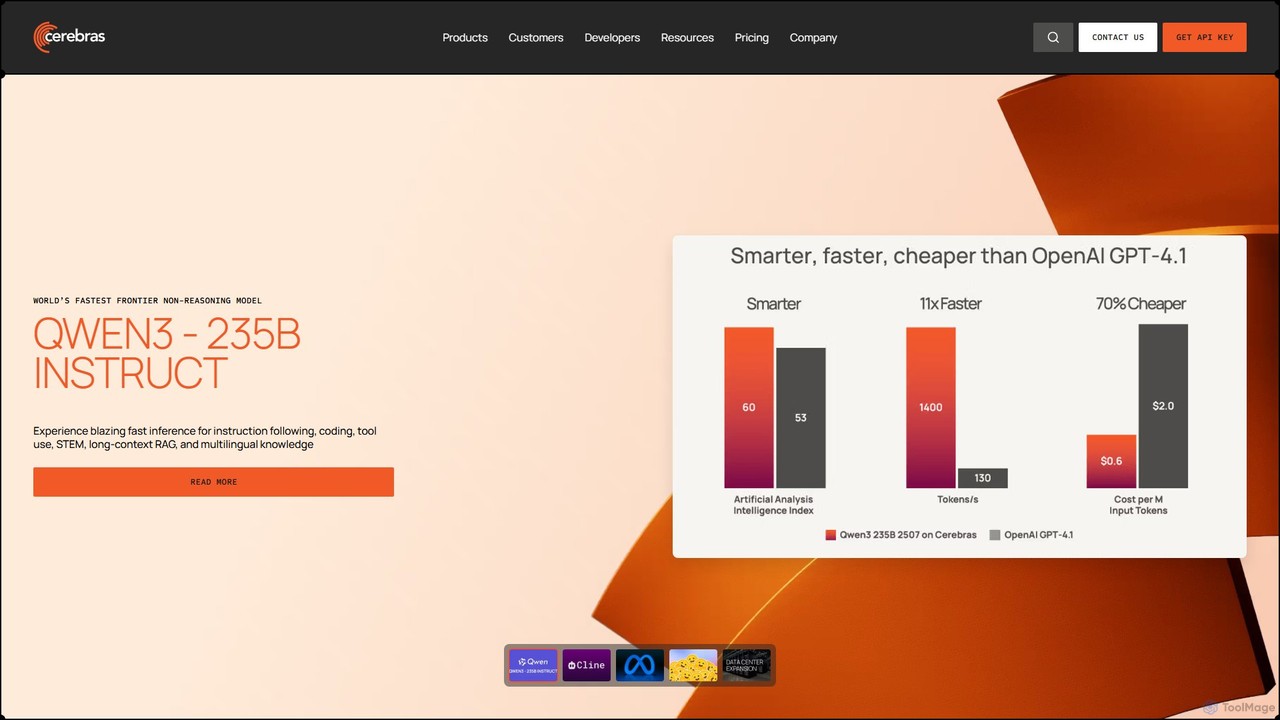
Cerebras Overview
A Cerebras é uma empresa pioneira no setor de hardware de IA e serviços em nuvem, renomada por desenvolver o processador de IA mais rápido do mundo, o Wafer Scale Engine (WSE). Esta tecnologia única integra o poder de uma bolacha de silício inteira em um único chip, oferecendo um desempenho que os clusters de GPU tradicionais não conseguem igualar. A Cerebras fornece esse poder a desenvolvedores, pesquisadores e empresas por meio de seus Serviços de Modelo de IA, permitindo que treinem e implantem modelos de última geração com velocidade e eficiência sem precedentes. Com a confiança de organizações líderes como Meta, Mayo Clinic, AlphaSense e Notion, a Cerebras está acelerando o futuro da IA, desde a pesquisa empresarial em tempo real e inteligência de mercado até a pesquisa científica avançada e o cuidado ao paciente.
Como usar Cerebras
A Cerebras oferece modelos de acesso flexíveis adaptados a diferentes necessidades:
- Para Desenvolvedores e Prototipagem (Plano Exploration): A maneira mais fácil de começar é através da API sem servidor. Os desenvolvedores podem obter acesso instantâneo a modelos populares através da Nuvem de Inferência Cerebras, Hugging Face ou OpenRouter. Este é um modelo de pagamento conforme o uso, onde você paga apenas pelos tokens que usa, tornando-o perfeito para testes, prototipagem e aplicações de pequena escala sem qualquer compromisso mínimo.
- Para Cargas de Trabalho de Produção (Plano Growth): Equipes com aplicações em crescimento podem optar por uma assinatura mensal. Este plano oferece limites de taxa mais altos, menor latência através da prioridade de solicitação e acesso antecipado a novos modelos. Oferece custos previsíveis para escalar cargas de trabalho de produção com confiança.
- Para Implantações em Larga Escala (Plano Enterprise): Para aplicações de missão crítica, indústrias regulamentadas ou organizações que exigem desempenho garantido, a Cerebras oferece uma solução empresarial abrangente. Isso inclui opções para implantação em nuvem privada ou local do hardware Cerebras, acesso a todos os modelos suportados, serviços de ajuste fino, os limites de taxa mais altos e suporte premium com SLAs garantidos. Para começar, as empresas podem entrar em contato com a equipe de vendas da Cerebras para projetar uma solução personalizada.
Recursos principais do Cerebras
- Wafer Scale Engine (WSE): O maior e mais rápido processador de IA do mundo, fornecendo poder de computação massivo e largura de banda de memória em um único chip.
- Inferência Ultrarrápida: Oferece velocidades de inferência líderes do setor, até 20x mais rápidas que as soluções de GPU, com benchmarks mostrando modelos como o Llama 4 Scout rodando a 2.600 tokens por segundo.
- Latência Ultrabaixa: Permite aplicações em tempo real, como IA conversacional, fluxos de trabalho de agentes e análise de dados ao vivo, muitas vezes retornando respostas em menos de um segundo.
- Opções de Implantação Flexíveis: Oferece API sem servidor, nuvem privada e soluções locais para atender a vários requisitos de segurança, desempenho и operacionais.
- Acesso a Modelos de Última Geração: Fornece acesso via API aos modelos de código aberto mais recentes e poderosos, incluindo o Llama 4 da Meta, o Qwen3 da Alibaba e o DeepSeek, muitas vezes no dia de seu lançamento.
- Serviços de Modelo de IA: Serviços abrangentes para treinamento e implantação de modelos, incluindo ajuste fino para clientes empresariais para criar modelos personalizados de alto desempenho.
- Custo-Benefício Superior: Ao combinar velocidade extrema com preços competitivos, a Cerebras oferece um valor excepcional, especialmente para aplicações onde a latência é crítica.
Casos de uso para Cerebras
A plataforma de alto desempenho da Cerebras é ideal para uma ampla gama de aplicações de IA exigentes:
- Pesquisa Empresarial e RAG: Empresas como Notion e AlphaSense usam a Cerebras para potencializar a pesquisa em tempo real e precisa e a geração aumentada por recuperação (RAG) sobre vastos conjuntos de dados.
- Saúde e Ciências da Vida: A Mayo Clinic utiliza a Cerebras para transformar o cuidado ao paciente através de diagnósticos, planejamento de tratamento e pesquisa médica impulsionados por IA.
- Gêmeos Digitais em Tempo Real: A Tavus utiliza a Cerebras para construir gêmeos digitais em tempo real, permitindo simulações e interações complexas que exigem respostas instantâneas.
- Serviços Financeiros: Potencializando a inteligência de mercado, análise de risco e negociação algorítmica impulsionadas por IA, onde a velocidade oferece uma vantagem competitiva.
- IA de Agentes e Uso de Ferramentas: A baixa latência é perfeita para construir agentes de IA sofisticados que podem raciocinar, usar ferramentas e interagir com os usuários em tempo real.
- Governo e Defesa: Selecionada por organizações como a DARPA para plataformas de computação em tempo real de próxima geração para aplicações militares e comerciais avançadas.
Vantagens do Cerebras
A principal vantagem da Cerebras é sua velocidade incomparável. Ao projetar hardware especificamente para cargas de trabalho de IA, o Wafer Scale Engine contorna os gargalos de comunicação inerentes aos grandes clusters de GPU. Isso resulta em latência drasticamente menor e maior rendimento. Essa velocidade se traduz em uma vantagem significativa de custo-benefício; embora os custos por token possam ser comparáveis a outros serviços, o valor de receber esses tokens em tempo real desbloqueia novos casos de uso que são impossíveis com provedores mais lentos. Além disso, seus modelos de implantação flexíveis e parcerias com líderes da indústria como Meta e Hugging Face tornam sua tecnologia de ponta acessível a um público amplo, desde desenvolvedores individuais até as maiores empresas do mundo.
Preços e planos
A Cerebras oferece uma estrutura de preços em camadas para acomodar diferentes escalas de uso:
- Plano Exploration (Pagamento conforme o uso): Ideal para começar. O preço é por milhão de tokens e varia por modelo. Por exemplo: Llama 4 Scout custa $0,65/M de tokens de entrada e $0,85/M de tokens de saída, enquanto o Qwen3 32B custa $0,40/M de entrada e $0,80/M de saída. Sem compromisso mínimo.
- Plano Growth (Assinatura): Para aplicações de produção. As assinaturas mensais começam em $1.500/mês para o Nível 1 e vão até $10.000/mês ou mais para níveis superiores. Cada nível fornece um máximo definido de tokens por minuto/dia e solicitações por minuto, oferecendo custos previsíveis. Por exemplo, o plano Llama-3.3 70B começa em $1.500/mês para 300k tokens de entrada/min e 41M tokens/dia.
- Plano Enterprise (Personalizado): Adaptado para implantações de grande escala e missão crítica. Este plano inclui opções de implantação dedicada, ajuste fino de modelo, os mais altos SLAs de desempenho e suporte premium. O preço é personalizado e está disponível entrando em contato com a equipe de vendas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 398.3K
- 2026-1: 655.0K
- 2026-2: 676.7K
- 2026-3: 609.2K
- 2026-4: 646.3K
- 2026-5: 817.3K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos69.0%
- 🇮🇳Índia11.4%
- 🇨🇳China7.0%
- 🇩🇪Alemanha6.6%
- 🇨🇦Canadá6.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 81.3% |
Referral | 16.9% |
Email | 1.8% |
Top keywords
| Keyword | Cost per click |
|---|---|
| cerebras | $1.10 |
| cerebras ai | $2.02 |
| cerebras api | $0.00 |
| cerebras systems | $1.26 |
| cerebras systems inc | $0.00 |
Cerebras Videos on YouTube



Charbax
Siosi AI
Cerebras Alternatives

PPIO
PPIO é uma plataforma líder de computação em nuvem distribuída que fornece poder de computação de IA, APIs de modelo e serviços de computação de borda econômicos e de alto desempenho. Oferece a desenvolvedores e empresas soluções completas para aplicações de IA, vídeo e metaverso, com GPUs sem servidor, instâncias em contêiner e acesso a grandes modelos de linguagem e multimodais populares.
Hospedagem de Modelo
GPUX
GPUX é uma plataforma de nuvem GPU descentralizada e sem servidor para inferência de modelos de IA rápida e acessível. Permite que desenvolvedores executem modelos via API e que proprietários de GPU ganhem dinheiro contribuindo com seu hardware para uma rede P2P.
Implantação de Modelo
Vast.ai
Vast.ai é uma plataforma líder de nuvem de GPU que oferece acesso sob demanda a uma vasta rede de GPUs para cargas de trabalho de IA e aprendizado de máquina. Ela fornece a desenvolvedores e empresas computação de alto desempenho a custos significativamente mais baixos — até 80% menos que os provedores de nuvem tradicionais — por meio de um mercado transparente e pague-pelo-uso.
Aluguel de GPU
OctoAI
OctoAI é uma plataforma de computação de alto desempenho para desenvolvedores executarem, ajustarem e escalarem modelos de IA generativa de forma eficiente. Oferece endpoints de API otimizados e prontos para produção para modelos populares de código aberto como Llama, Mixtral e Stable Diffusion. Focando em otimizações profundas do sistema, a OctoAI oferece velocidades de inferência mais rápidas e custos mais baixos, permitindo que as empresas construam e implantem aplicativos de IA escaláveis sem gerenciar infraestrutura complexa.
API
H2O.ai
H2O.ai é uma plataforma de nuvem de IA de ponta a ponta para empresas, combinando IA preditiva e generativa. Permite que as empresas construam, implantem e gerenciem modelos e aplicativos de IA seguros e de alto desempenho em qualquer ambiente, da nuvem ao local. A plataforma apresenta AutoML, um Feature Store, Document AI e um robusto Gerenciamento de Risco de Modelo.
Soluções EmpresariaisCerebras Categories
Cerebras Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
H2O.ai
H2O.ai é uma plataforma de nuvem de IA de ponta a ponta para empresas, combinando IA preditiva e generativa. Permite que as empresas construam, implantem e gerenciem modelos e aplicativos de IA seguros e de alto desempenho em qualquer ambiente, da nuvem ao local. A plataforma apresenta AutoML, um Feature Store, Document AI e um robusto Gerenciamento de Risco de Modelo.
Soluções Empresariais
Fluidstack
Fluidstack é uma plataforma de nuvem de IA líder que fornece clusters de GPU dedicados de alto desempenho para treinar e servir modelos de IA de fronteira. Oferece implantação rápida de milhares de GPUs, serviços totalmente gerenciados com suporte especializado 24/7 e preços transparentes com zero taxas de egresso, capacitando equipes de IA a escalar sem atrito de infraestrutura.
Soluções Empresariais
SectorFlow
O SectorFlow é uma plataforma de IA segura e de nível empresarial que fornece acesso a diversos LLMs, automação de fluxo de trabalho gerenciado e modelos hospedados privados. Ele permite que as empresas implantem recursos de IA em qualquer escala, desde a experimentação até a implantação empresarial segura, sem barreiras técnicas.
Soluções Empresariais
Together AI
O Together AI é uma plataforma de nuvem líder para desenvolvedores, fornecendo infraestrutura rápida e econômica para executar, ajustar e treinar modelos de IA generativa de código aberto. Oferece uma extensa biblioteca de mais de 200 modelos, APIs de inferência sem servidor, ajuste fino personalizável e clusters de GPU dedicados, criando uma solução de ponta a ponta para construir e escalar aplicações de IA.
Infraestrutura de GPU
Vectorize
Vectorize é uma plataforma RAG-as-a-Service que simplifica a criação de aplicações de IA em dados não estruturados. Oferece pipelines RAG gerenciados, conectores de fonte de dados extensivos e a flexibilidade de usar seu banco de dados vetorial gerenciado ou conectar o seu próprio, permitindo que os desenvolvedores implantem soluções de IA prontas para produção rapidamente.
Trapo
Anyscale
Anyscale é uma plataforma de computação totalmente gerenciada para escalar cargas de trabalho de IA e Python. Construída sobre o framework de código aberto Ray por seus criadores originais, ela capacita os desenvolvedores a construir, executar e escalar aplicações distribuídas, desde o treinamento de LLMs até o processamento de dados, com desempenho otimizado e eficiência de custos em qualquer nuvem.
MLOps
deepsense.ai
A deepsense.ai é uma empresa de consultoria de IA e desenvolvimento de software personalizado de primeira linha. Eles se especializam na criação de soluções de IA sob medida para empresas, aproveitando a experiência em LLMs, RAG, visão computacional, MLOps e análise preditiva. Eles fazem parceria com empresas e startups para incorporar IA em produtos, otimizar operações e obter uma vantagem competitiva por meio de sistemas de IA avançados e prontos para produção.
Consultoria de IA
FuriosaAI
A FuriosaAI desenvolve aceleradores de IA de alto desempenho e eficientes em termos de energia para data centers. Seu principal produto, o RNGD, é projetado para tarefas exigentes de inferência de IA, especialmente para grandes modelos de linguagem (LLMs). Com a inovadora arquitetura Tensor Contraction Processor (TCP), o RNGD oferece desempenho excepcional com um consumo de energia muito baixo de 180W, reduzindo significativamente o custo total de propriedade e o impacto ambiental para implantações de IA em nuvem e empresariais.
Infraestrutura
Usedify
Usedify é uma plataforma de aprendizado abrangente e um guia prático para dominar a implementação e a criação de valor de IA empresarial usando a estrutura Dify. Oferece tutoriais passo a passo, estudos de caso reais e melhores práticas para desenvolvedores e empresas.
Tutorials
AI News Hub
O AI News Hub é uma plataforma abrangente que oferece anúncios de IA em tempo real, atualizações de blog curadas sobre IA agentic, RAG e ferramentas de produção. Ele oferece um feed personalizado, recursos de favoritos e uma rica coleção de recursos de aprendizado, incluindo roteiros, cursos e vídeos, para manter desenvolvedores e entusiastas informados e qualificados no cenário de IA em rápida evolução.
Aggregation
LLM Models
LLM Models é um diretório online abrangente e plataforma de comparação para grandes modelos de linguagem e modelos de fundação. Ele fornece especificações técnicas detalhadas, desempenho de benchmark e comparações de recursos para ajudar desenvolvedores, pesquisadores e empresas a selecionar os modelos de IA mais adequados às suas necessidades.
Diretório de Modelos
Nexa SDK
Nexa SDK é um poderoso kit de ferramentas que permite aos desenvolvedores implantar qualquer modelo de IA, incluindo modelos de ponta e de última geração, em qualquer dispositivo (móvel, PC, IoT, automotivo) em minutos. Ele oferece inferência on-device pronta para produção com aceleração de hardware em NPUs, GPUs e CPUs, otimizada para velocidade e eficiência energética.
Ai Development KitPPIO
PPIO é uma plataforma líder de computação em nuvem distribuída que fornece poder de computação de IA, APIs de modelo e serviços de computação de borda econômicos e de alto desempenho. Oferece a desenvolvedores e empresas soluções completas para aplicações de IA, vídeo e metaverso, com GPUs sem servidor, instâncias em contêiner e acesso a grandes modelos de linguagem e multimodais populares.
Hospedagem de ModeloGPUX
GPUX é uma plataforma de nuvem GPU descentralizada e sem servidor para inferência de modelos de IA rápida e acessível. Permite que desenvolvedores executem modelos via API e que proprietários de GPU ganhem dinheiro contribuindo com seu hardware para uma rede P2P.
Implantação de Modelo
Cerebras Comments (0)
Sign in to comment.
EntrarNo comments yet.