
ParadeDB Overview
O ParadeDB posiciona-se como uma alternativa poderosa e moderna ao Elasticsearch, especificamente projetada para funcionar perfeitamente dentro do ecossistema PostgreSQL. Ele transforma um banco de dados Postgres padrão em um motor de pesquisa e análise de alto desempenho, projetado para lidar com cargas de trabalho em tempo real e com muitas atualizações. A missão principal do ParadeDB é libertar as equipes de desenvolvimento das complexidades e sobrecargas associadas ao escalonamento, gerenciamento e sincronização de um cluster Elasticsearch separado. Ao integrar capacidades de pesquisa e análise diretamente no Postgres, ele simplifica a pilha de dados, reduz os custos operacionais e elimina problemas comuns de consistência de dados.
Como um projeto de código aberto, o ParadeDB ganhou tração significativa na comunidade de desenvolvedores, evidenciado por milhares de estrelas no GitHub e mais de cem mil implantações Docker. É confiável por uma vasta gama de empresas, desde startups de rápido crescimento como Bilt Rewards e Modern Treasury até empresas da Fortune 500 como Alibaba Cloud, para alimentar aplicações de missão crítica.
Como usar o ParadeDB
Começar a usar o ParadeDB é projetado para ser simples para desenvolvedores familiarizados com o Postgres. Existem dois métodos principais de implantação:
- Contêiner Docker: A maneira mais rápida de testar e executar o ParadeDB é através de sua imagem Docker oficial. Um simples comando é tudo o que é necessário para iniciar uma nova instância:
docker run --name paradedb -e POSTGRES_PASSWORD=password paradedb/paradedb
Uma vez em execução, você pode se conectar a ele usando qualquer cliente Postgres padrão como o `psql`. - Extensão Postgres: Para bancos de dados Postgres existentes e autogerenciados, o ParadeDB pode ser instalado como uma extensão padrão. Isso permite que você aumente seu banco de dados atual com os recursos do ParadeDB sem migrar dados para um novo sistema. Ele se integra com os mecanismos internos do Postgres, como a replicação lógica, permitindo que atue como uma réplica de leitura de alto desempenho que descarrega consultas de pesquisa e análise exigentes do seu banco de dados primário.
Uma vez instalado, você interage com o ParadeDB usando SQL Postgres padrão. Não há necessidade de aprender uma nova linguagem de consulta como a Query DSL do Elasticsearch. Você pode criar índices de pesquisa e executar consultas complexas, filtradas e facetadas usando a sintaxe SQL familiar.
Recursos principais do ParadeDB
- Pesquisa de Texto Completo Avançada: Vai além da pesquisa embutida do Postgres para oferecer recursos como pontuação de relevância BM25, tokenizadores personalizados, correspondência difusa (fuzzy matching), consultas de frase e lógica booleana complexa.
- Análise de Alto Desempenho: Inclui suporte para consultas analíticas rápidas e faceting, alimentado por um índice colunar. Isso é ideal para construir painéis, painéis de insights em tempo real e explorações de drill-down.
- Zero ETL e Sincronização em Tempo Real: Ao usar a replicação lógica nativa do Postgres, o ParadeDB permanece perfeitamente sincronizado com sua fonte de dados primária em tempo real, eliminando a necessidade de pipelines ETL complexos e frágeis (por exemplo, Kafka, Debezium).
- Conformidade ACID: Herda as garantias ACID do Postgres, o que significa que os dados são imediatamente e consistentemente pesquisáveis após uma transação de escrita bem-sucedida.
- Operações Simplificadas: Integra-se com o processo de vacuum do Postgres para limpeza automática de índices obsoletos e aproveita o ecossistema robusto do Postgres para backups, alta disponibilidade e recuperação de desastres.
- Interface SQL Padrão: Todos os recursos são acessíveis através do dialeto SQL padrão do Postgres, diminuindo a curva de aprendizado e aproveitando a expertise da equipe existente.
Casos de uso para o ParadeDB
O ParadeDB é testado em batalha em ambientes de produção exigentes para várias aplicações:
- Bilt Rewards: A plataforma de recompensas de moradia implantou o ParadeDB como uma réplica lógica de seu Postgres primário. Isso descarregou suas consultas de pesquisa facetada e difusa mais caras, resultando em uma redução de 95% nos tempos de espera de consulta e uma queda de 50% na latência de consulta P95.
- Alibaba Cloud: A gigante da tecnologia escolheu o ParadeDB para integrar poderosas capacidades de pesquisa de texto completo em seu data warehouse baseado em Postgres, lidando com conjuntos de dados massivos com alto desempenho.
- Modern Treasury: A API de processamento de pagamentos usa o ParadeDB para potencializar a pesquisa sobre dados de transações financeiras. Eles se beneficiam de sua segurança transacional, natureza relacional e sincronização perfeita, que são críticas para aplicações financeiras.
- Aplicações Empresariais Gerais: Qualquer aplicação construída sobre Postgres que requer pesquisa sofisticada (por exemplo, catálogos de produtos de e-commerce, análise de logs, sistemas de gerenciamento de conteúdo) ou painéis de análise em tempo real pode se beneficiar do ParadeDB.
Vantagens do ParadeDB
A principal vantagem do ParadeDB é sua integração nativa com o Postgres, o que leva a vários benefícios chave:
- Pilha de Dados Simplificada: Consolida seu banco de dados e motor de busca em um único sistema, reduzindo a complexidade da infraestrutura e a sobrecarga operacional.
- Consistência de Dados Garantida: Elimina o risco de perda de dados ou resultados de pesquisa obsoletos causados por sincronizações quebradas entre o Postgres e um motor de busca externo.
- Menor Custo Total de Propriedade: Reduz os custos associados ao licenciamento, gerenciamento e escalonamento de um cluster Elasticsearch separado.
- Produtividade Aumentada do Desenvolvedor: Permite que os desenvolvedores usem uma única e familiar linguagem de consulta (SQL) para todas as operações de dados, acelerando os ciclos de desenvolvimento.
- Confiabilidade Superior: Baseia-se na confiabilidade, estabilidade e ecossistema maduro comprovados do Postgres para recursos como backups e alta disponibilidade.
Preços e planos
O ParadeDB opera em um modelo freemium, de núcleo aberto. A tecnologia principal é de código aberto e de uso gratuito, disponível como uma extensão do Postgres ou uma imagem Docker. Isso é ideal para desenvolvedores, startups e para autogerenciar o software. Para empresas que necessitam de recursos avançados, suporte dedicado ou uma solução em nuvem totalmente gerenciada, o ParadeDB oferece planos comerciais. As partes interessadas são incentivadas a entrar em contato com a equipe de vendas para uma demonstração e informações de preços personalizadas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 34.0K
- 2026-1: 36.3K
- 2026-2: 33.5K
- 2026-3: 53.2K
- 2026-4: 32.9K
- 2026-5: 35.6K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos36.3%
- 🇧🇷Brasil22.4%
- 🇮🇳Índia16.7%
- 🇨🇦Canadá12.8%
- 🇹🇭Tailândia11.8%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.8% |
Referral | 13.2% |
Email | 1.0% |
Top keywords
| Keyword | Cost per click |
|---|---|
| parade db | $0.00 |
| paradedb | $4.55 |
| paradedb vector search | $0.00 |
| pg search | $0.17 |
| tantivy | $0.00 |
ParadeDB Alternatives
Xata
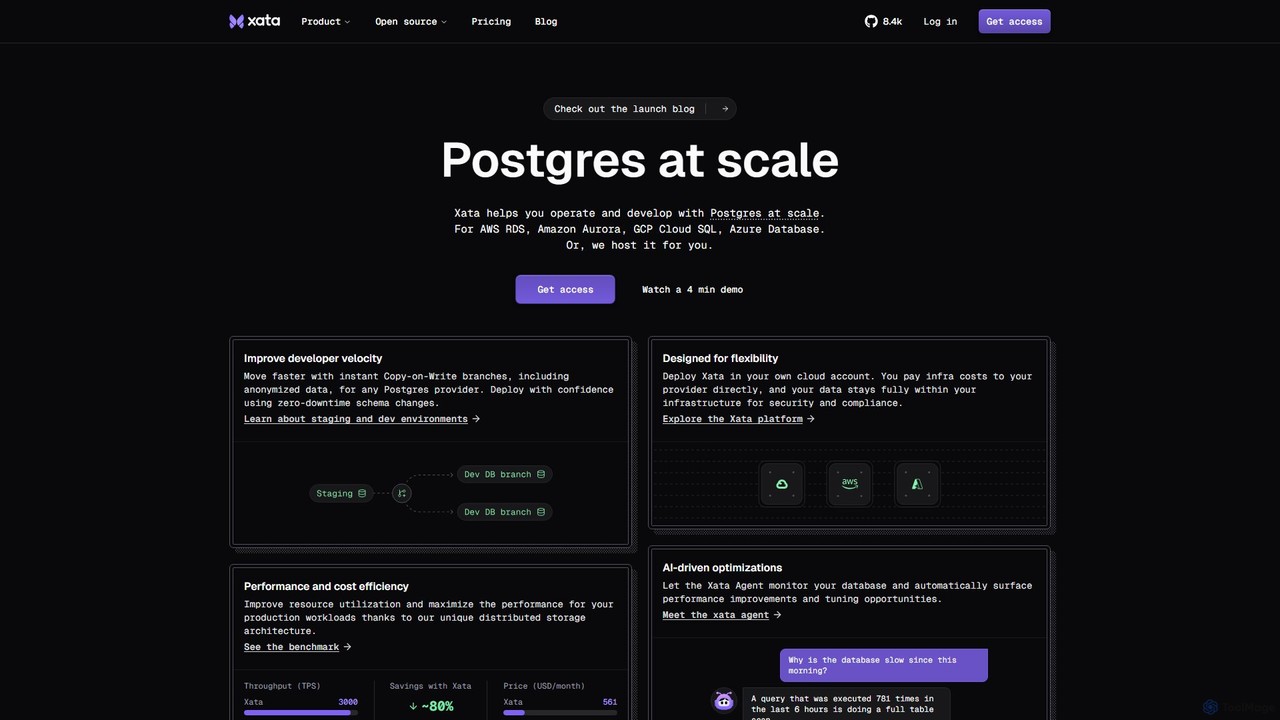
Xata é uma plataforma "Postgres em escala" projetada para aumentar a velocidade do desenvolvedor e otimizar o desempenho do banco de dados. Oferece recursos exclusivos como ramificações instantâneas de Cópia na Gravação com anonimização de PII, migrações de esquema sem tempo de inatividade e um agente alimentado por IA para ajuste automático de desempenho. Implante na infraestrutura da Xata ou em sua própria nuvem para máxima flexibilidade e conformidade.
Otimização de Banco de Dados
TiDB Cloud
O TiDB Cloud é um banco de dados SQL distribuído como serviço (DBaaS) totalmente gerenciado. Oferece escalabilidade horizontal, compatibilidade com MySQL e capacidades de Processamento Híbrido Transacional/Analítico (HTAP). Ideal para construir aplicações modernas, intensivas em dados e serviços alimentados por IA, ele simplifica as operações de banco de dados e fornece um backend poderoso para aplicações que exigem tanto transações em tempo real quanto análises complexas, incluindo busca vetorial para IA.
Banco de Dados Vetorial
InfluxData
A InfluxData oferece o InfluxDB, a principal plataforma de banco de dados de séries temporais construída para dados em tempo real e aplicações de IA. Ela capacita os desenvolvedores a ingerir, armazenar e analisar volumes massivos de dados de alta velocidade de IoT, aplicações e infraestrutura. Com consultas de alto desempenho, compressão de dados superior e integração perfeita com data lakes e pipelines de AI/ML, a InfluxData é o motor para detecção de anomalias, manutenção preditiva e sistemas autônomos.
Gestão de Dados
ChartDB
ChartDB é um visualizador de esquema de banco de dados alimentado por IA que gera instantaneamente diagramas ER interativos a partir de uma única consulta. Foi projetado para desenvolvedores e equipes projetarem, documentarem e colaborarem em estruturas de banco de dados. Possui colaboração em tempo real, sincronização de banco de dados e um assistente de IA para otimizar o design do esquema. Versões em nuvem e auto-hospedadas de código aberto estão disponíveis.
Visualização
Vanna.AI
Vanna.AI é um agente SQL de IA personalizado e de código aberto que transforma perguntas em linguagem natural em consultas SQL precisas. Ele usa um modelo de Geração Aumentada por Recuperação (RAG) treinado no esquema do seu banco de dados específico, documentação e consultas anteriores para alcançar alta precisão em conjuntos de dados complexos. Foi projetado para segurança, flexibilidade e fácil integração em qualquer aplicação, capacitando usuários técnicos e não técnicos a obter insights de seus dados sem esforço.
Inteligência de NegóciosParadeDB Categories
ParadeDB Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.
Related AI tools
Meilisearch
Meilisearch é um motor de busca de código aberto, ultrarrápido e alimentado por IA. Foi projetado para que desenvolvedores integrem facilmente capacidades de busca avançada, incluindo busca de texto completo, semântica e híbrida, em qualquer site ou aplicação. Oferece uma experiência excepcional para desenvolvedores com APIs e SDKs poderosos.
Banco de dadosInfluxData
A InfluxData oferece o InfluxDB, a principal plataforma de banco de dados de séries temporais construída para dados em tempo real e aplicações de IA. Ela capacita os desenvolvedores a ingerir, armazenar e analisar volumes massivos de dados de alta velocidade de IoT, aplicações e infraestrutura. Com consultas de alto desempenho, compressão de dados superior e integração perfeita com data lakes e pipelines de AI/ML, a InfluxData é o motor para detecção de anomalias, manutenção preditiva e sistemas autônomos.
Gestão de Dados
ChartDB
ChartDB é um visualizador de esquema de banco de dados alimentado por IA que gera instantaneamente diagramas ER interativos a partir de uma única consulta. Foi projetado para desenvolvedores e equipes projetarem, documentarem e colaborarem em estruturas de banco de dados. Possui colaboração em tempo real, sincronização de banco de dados e um assistente de IA para otimizar o design do esquema. Versões em nuvem e auto-hospedadas de código aberto estão disponíveis.
VisualizaçãoVanna.AI
Vanna.AI é um agente SQL de IA personalizado e de código aberto que transforma perguntas em linguagem natural em consultas SQL precisas. Ele usa um modelo de Geração Aumentada por Recuperação (RAG) treinado no esquema do seu banco de dados específico, documentação e consultas anteriores para alcançar alta precisão em conjuntos de dados complexos. Foi projetado para segurança, flexibilidade e fácil integração em qualquer aplicação, capacitando usuários técnicos e não técnicos a obter insights de seus dados sem esforço.
Inteligência de Negócios
NeoBase
O NeoBase é um copiloto de IA de código aberto para bancos de dados, permitindo que os usuários interajam com seus dados usando linguagem natural. Ele se conecta a vários bancos de dados SQL e NoSQL, traduz consultas em inglês simples para código otimizado e visualiza os resultados. Projetado para usuários técnicos e não técnicos, ele agiliza a análise de dados, depuração e relatórios, eliminando a necessidade de escrever consultas complexas e fornecendo controle total dos dados por meio de auto-hospedagem.
Análise de Dados
SQL Chat
O SQL Chat é um cliente e editor SQL de código aberto baseado em chat que usa IA para traduzir perguntas em linguagem natural para consultas SQL. Conecte-se ao seu banco de dados, faça perguntas em português simples e obtenha resultados instantaneamente, democratizando o acesso a dados para usuários técnicos e não técnicos.
Assistente de Código
Supabase
Supabase é uma alternativa de código aberto ao Firebase, fornecendo uma solução de backend completa construída sobre o Postgres. Oferece um conjunto de ferramentas que inclui banco de dados, autenticação, APIs instantâneas, edge functions, subscrições em tempo real, armazenamento e embeddings de vetores para acelerar o desenvolvimento de aplicações, do protótipo à produção.
Backend
Milvus
Milvus é um banco de dados vetorial de código aberto e alto desempenho, construído para aplicações de IA. Ele permite que os desenvolvedores gerenciem e pesquisem bilhões de vetores de alta dimensão com latência mínima. Ideal para construir sistemas escaláveis como geração aumentada por recuperação (RAG), motores de recomendação e busca semântica, o Milvus oferece opções de implantação flexíveis, desde prototipagem local até clusters distribuídos em larga escala.
Aprendizado de Máquina
LanceDB
O LanceDB é um lakehouse multimodal nativo de IA de código aberto, projetado para construir e escalar aplicações de IA. Ele fornece uma plataforma unificada para armazenar, pesquisar e gerenciar dados complexos como texto, imagens, voz e vetores. Ideal para RAG, busca semântica e treinamento de modelos, o LanceDB oferece busca híbrida ultrarrápida, escalabilidade massiva para petabytes e economias de custo significativas, tornando-se uma base poderosa para IA de nível empresarial.
Banco de Dados Vetorial
MindsDB
MindsDB é uma plataforma de automação de dados com IA que leva o machine learning para o seu banco de dados. Permite que desenvolvedores e analistas de dados criem, treinem e implantem modelos de IA usando consultas SQL padrão, conectando-se a mais de 200 fontes de dados para fornecer previsões e análises em tempo real sem pipelines ETL complexos.
Inteligência de Negócios
Spice AI
O Spice AI é um motor de computação de dados e IA de código aberto e portátil para desenvolvedores. Ele unifica dados de qualquer fonte, acelera consultas com o Apache Arrow e integra o serviço de modelos de IA e a pesquisa vetorial para simplificar a criação de aplicativos de alto desempenho orientados por dados.
Implantação de Modelo
Postgres Sandbox
Uma ferramenta visual intuitiva, baseada na web, para projetar, prototipar e experimentar esquemas de banco de dados PostgreSQL. Crie tabelas, defina relacionamentos e gere código SQL em um ambiente sandbox sem riscos. Ideal para desenvolvedores, DBAs e estudantes.
Banco de Dados
nao
nao é um editor de código alimentado por IA projetado para equipes de dados. Ele otimiza a criação de pipelines de dados em SQL e Python, fluxos de trabalho dbt e análises, conectando-se nativamente ao seu data warehouse. Seu agente inteligente fornece sugestões de código cientes dos dados, verificações de qualidade e pré-visualizações de diferenças instantâneas para ajudá-lo a entregar dados de forma mais rápida e segura.
Análise
sherloqdata
Sherloqdata é um agente de dados para SQL alimentado por IA que funciona diretamente no seu editor. Ajuda profissionais de dados a escrever, corrigir e gerenciar consultas SQL mais rapidamente, usando seu repositório SQL existente como contexto. Os recursos incluem um Chat SQL com IA, gerenciamento de consultas, controle de versão e colaboração em equipe.
Banco de Dados
ParadeDB Comments (0)
Sign in to comment.
EntrarNo comments yet.