

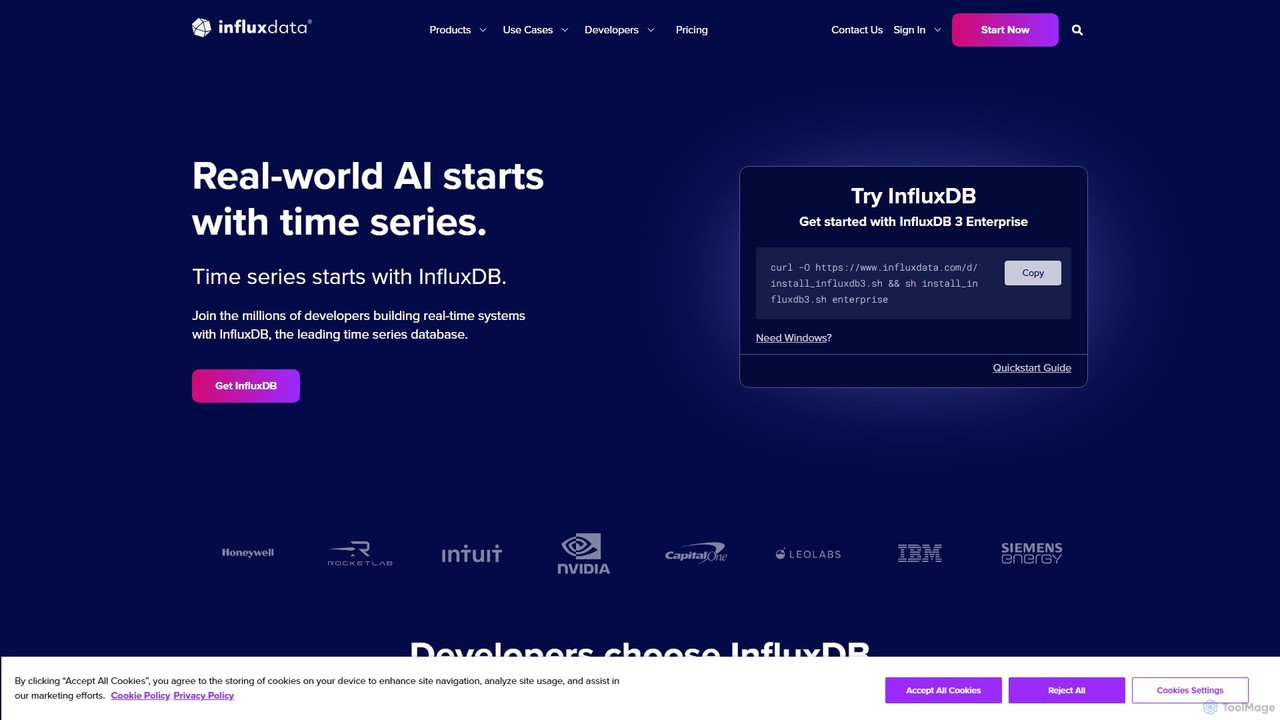
InfluxData Overview
A InfluxData é a criadora do InfluxDB, a principal plataforma de banco de dados de séries temporais de código aberto. Ela foi projetada especificamente para lidar com os volumes massivos e a alta velocidade de dados com carimbo de tempo gerados por sensores, aplicações e infraestrutura. Em sua essência, a InfluxData fornece o motor para a IA do mundo real, permitindo que os sistemas detectem, respondam e prevejam de forma inteligente com base em padrões nos dados ao longo do tempo. A versão mais recente, InfluxDB 3.0, foi rearquitetada em Rust e aproveita o ecossistema Apache — incluindo Arrow, DataFusion e Parquet — para oferecer desempenho incomparável, cardinalidade ilimitada e economias de custo significativas através de compressão avançada. Esta plataforma é projetada para desenvolvedores, oferecendo opções de implantação flexíveis, da nuvem ao local e à borda, garantindo que você possa construir sistemas poderosos em tempo real onde quer que precise deles.
Como usar InfluxData
Começar a usar a InfluxData envolve um processo direto, adaptado para desenvolvedores e equipes de dados:
- Escolha sua Implantação: Selecione o produto InfluxDB que atenda às suas necessidades. Você pode começar gratuitamente com o InfluxDB Cloud Serverless, optar por uma instância gerenciada do InfluxDB Cloud Dedicated ou hospedar por conta própria com o InfluxDB Enterprise ou o InfluxDB 3 Core de código aberto.
- Ingestão de Dados: Use o Telegraf, o coletor de dados de código aberto da InfluxData com mais de 300 plugins de entrada, para extrair métricas de seus sistemas, sensores e aplicações. Alternativamente, use as extensas bibliotecas de cliente para linguagens como Python, Go, JavaScript e C# para transmitir dados diretamente para o InfluxDB.
- Consulta e Análise: Aproveite o poder do SQL para consultar seus dados de séries temporais. O motor de consulta de alto desempenho do InfluxDB, construído sobre o Apache DataFusion, permite análises em tempo real, permitindo que você transforme e analise milhões de pontos de dados por segundo.
- Integração e Extensão: Conecte o InfluxDB à sua pilha de tecnologia existente. Seu formato de dados aberto (Apache Parquet) e integração de catálogo (Apache Iceberg) permitem o compartilhamento de dados sem cópia com data lakes e warehouses. Isso permite treinar modelos de AI/ML ou executar análises complexas em ferramentas como Spark ou Snowflake sem mover ou duplicar dados.
- Automação e Monitoramento: Configure tarefas automatizadas para reduzir a amostragem de dados de alta resolução, criar alertas para comportamento anômalo e despejar automaticamente dados frios para armazenamento de objetos mais barato para gerenciar custos de forma eficaz.
Recursos principais do InfluxData
- Alto Desempenho em Escala: Ingestão de milhões de pontos de dados por segundo sem degradação de desempenho e consulta de conjuntos de dados massivos com latência de subsegundo.
- Motor de Análise em Tempo Real: Realize consultas analíticas complexas, agregações e transformações em dados de streaming à medida que chegam.
- Compressão de Dados Avançada: Utiliza o formato colunar Apache Parquet e algoritmos de compressão avançados para reduzir os custos de armazenamento em até 90% em comparação com outros bancos de dados.
- Cardinalidade Ilimitada: O motor do InfluxDB 3.0 é projetado para lidar com dados de alta cardinalidade sem as limitações de desempenho das soluções de séries temporais mais antigas.
- Implantação Flexível: Execute o InfluxDB em qualquer lugar — na nuvem (multi-tenant ou dedicada), no local em seu data center ou na borda da rede para processamento localizado.
- Aberto e Extensível: Construído sobre padrões abertos (SQL, Parquet, Arrow, Iceberg) e integra-se perfeitamente com mais de 300 ferramentas via Telegraf, além de extensas bibliotecas de cliente para todas as principais linguagens de programação.
- Gerenciamento do Ciclo de Vida dos Dados: Gerencia automaticamente as camadas de dados, movendo dados recentes e "quentes" do armazenamento em memória para um armazenamento de objetos mais barato e "frio" ao longo do tempo.
Casos de uso para InfluxData
A InfluxData é a espinha dorsal para uma ampla gama de aplicações em tempo real em várias indústrias:
- IA em Tempo Real e Análise Preditiva: Fornece dados de séries temporais de alta resolução e ricos em contexto que os modelos de IA e ML precisam para inferir causa e efeito, permitindo previsões precisas e automação inteligente.
- Detecção de Anomalias: Monitore sistemas críticos em tempo real para detectar instantaneamente padrões incomuns ou desvios da norma, acionando respostas automatizadas para prevenir falhas.
- Manutenção Preditiva: Analise dados de sensores de equipamentos e máquinas industriais para prever falhas potenciais, permitindo uma manutenção proativa que minimiza o tempo de inatividade и custos.
- IoT e IoT Industrial (IIoT): Colete, armazene e analise dados de milhões de dispositivos conectados, de sensores de casa inteligente a máquinas de chão de fábrica, para obter insights operacionais.
- DevOps e Monitoramento de Infraestrutura: Monitore a saúde e o desempenho de servidores, contêineres, aplicações e redes com métricas de alta granularidade para garantir confiabilidade e desempenho.
Vantagens do InfluxData
Desenvolvedores e empresas escolhem a InfluxData por várias vantagens-chave:
- Centrado no Desenvolvedor: Construído por desenvolvedores, para desenvolvedores, com foco na facilidade de uso, APIs poderosas, documentação abrangente e uma comunidade vibrante.
- Desempenho Superior: Supera outros bancos de dados de séries temporais tanto na velocidade de ingestão quanto na de consulta, o que é crítico para aplicações em tempo real.
- Economia Massiva de Custos: A combinação de compressão de dados extrema e a capacidade de usar armazenamento de objetos de baixo custo para dados históricos leva a um custo total de propriedade significativamente menor.
- Arquitetura à Prova de Futuro: Ao adotar padrões de dados abertos como Parquet e Iceberg, a InfluxData evita o aprisionamento tecnológico (vendor lock-in) e garante a interoperabilidade com o ecossistema de dados mais amplo, incluindo data lakes e plataformas de IA.
- Plataforma Unificada: Gerencia todo o ciclo de vida dos dados dentro de uma única plataforma coesa, desde a ingestão de alta velocidade e consulta em tempo real até o armazenamento e integração a longo prazo.
Preços e planos
A InfluxData oferece uma estrutura de preços flexível para atender a diferentes necessidades e escalas:
- InfluxDB Cloud Serverless: Um serviço multi-tenant totalmente gerenciado com um nível gratuito perpétuo para começar. Os planos pagos operam com base no pagamento conforme o uso, cobrando pelos dados ingeridos, consultados e armazenados, com um crédito de $250 para novas atualizações.
- InfluxDB Cloud Dedicated: Um serviço single-tenant totalmente gerenciado em infraestrutura dedicada para cargas de trabalho maiores que exigem segurança aprimorada, desempenho e escala ilimitada. O preço é personalizado e baseado na configuração.
- InfluxDB Enterprise: Uma versão auto-gerenciada, altamente disponível e escalável para implantação no local ou em uma nuvem privada. Inclui recursos de nível empresarial e suporte. O preço está disponível mediante solicitação.
- InfluxDB 3 Core (OSS): O motor de séries temporais de código aberto e gratuito para implantações de nó único, perfeito para projetos menores, testes e computação de borda.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 362.0K
- 2026-1: 377.0K
- 2026-2: 312.8K
- 2026-3: 367.5K
- 2026-4: 323.3K
- 2026-5: 310.4K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos30.2%
- 🇩🇪Alemanha23.2%
- 🇮🇳Índia18.6%
- 🇻🇳Vietnã17.7%
- 🇨🇳China10.2%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 80.6% |
Referral | 16.4% |
Email | 3.0% |
Top keywords
| Keyword | Cost per click |
|---|---|
| influx | $4.39 |
| influxdata | $5.81 |
| influx db | $0.88 |
| influxdb | $1.90 |
| telegraf | $0.15 |
InfluxData Videos on YouTube

InfluxData Alternatives
Milvus
Milvus é um banco de dados vetorial de código aberto e alto desempenho, construído para aplicações de IA. Ele permite que os desenvolvedores gerenciem e pesquisem bilhões de vetores de alta dimensão com latência mínima. Ideal para construir sistemas escaláveis como geração aumentada por recuperação (RAG), motores de recomendação e busca semântica, o Milvus oferece opções de implantação flexíveis, desde prototipagem local até clusters distribuídos em larga escala.
Aprendizado de Máquina
ChartDB
ChartDB é um visualizador de esquema de banco de dados alimentado por IA que gera instantaneamente diagramas ER interativos a partir de uma única consulta. Foi projetado para desenvolvedores e equipes projetarem, documentarem e colaborarem em estruturas de banco de dados. Possui colaboração em tempo real, sincronização de banco de dados e um assistente de IA para otimizar o design do esquema. Versões em nuvem e auto-hospedadas de código aberto estão disponíveis.
Visualização
Vanna.AI
Vanna.AI é um agente SQL de IA personalizado e de código aberto que transforma perguntas em linguagem natural em consultas SQL precisas. Ele usa um modelo de Geração Aumentada por Recuperação (RAG) treinado no esquema do seu banco de dados específico, documentação e consultas anteriores para alcançar alta precisão em conjuntos de dados complexos. Foi projetado para segurança, flexibilidade e fácil integração em qualquer aplicação, capacitando usuários técnicos e não técnicos a obter insights de seus dados sem esforço.
Inteligência de Negócios
Activeloop
A Activeloop fornece o Deep Lake, um Banco de Dados especializado para IA, projetado para gerenciar, consultar e transmitir conjuntos de dados multimodais em grande escala (texto, imagens, áudio, vídeo) para a construção de aplicações avançadas de IA. Ele simplifica a infraestrutura de dados complexa, permitindo que os desenvolvedores criem poderosos sistemas de Geração Aumentada por Recuperação (RAG), motores de busca semântica e agentes de IA inteligentes com facilidade.
Gestão de Dados
ParadeDB
O ParadeDB é uma alternativa moderna ao Elasticsearch construída diretamente sobre o Postgres. Ele aprimora o Postgres com poderosas capacidades de pesquisa e análise em tempo real, incluindo pesquisa de texto completo, correspondência difusa e faceting, eliminando a necessidade de processos ETL complexos e motores de busca separados.
BuscaInfluxData Categories
InfluxData Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Milvus
Milvus é um banco de dados vetorial de código aberto e alto desempenho, construído para aplicações de IA. Ele permite que os desenvolvedores gerenciem e pesquisem bilhões de vetores de alta dimensão com latência mínima. Ideal para construir sistemas escaláveis como geração aumentada por recuperação (RAG), motores de recomendação e busca semântica, o Milvus oferece opções de implantação flexíveis, desde prototipagem local até clusters distribuídos em larga escala.
Aprendizado de MáquinaChartDB
ChartDB é um visualizador de esquema de banco de dados alimentado por IA que gera instantaneamente diagramas ER interativos a partir de uma única consulta. Foi projetado para desenvolvedores e equipes projetarem, documentarem e colaborarem em estruturas de banco de dados. Possui colaboração em tempo real, sincronização de banco de dados e um assistente de IA para otimizar o design do esquema. Versões em nuvem e auto-hospedadas de código aberto estão disponíveis.
VisualizaçãoVanna.AI
Vanna.AI é um agente SQL de IA personalizado e de código aberto que transforma perguntas em linguagem natural em consultas SQL precisas. Ele usa um modelo de Geração Aumentada por Recuperação (RAG) treinado no esquema do seu banco de dados específico, documentação e consultas anteriores para alcançar alta precisão em conjuntos de dados complexos. Foi projetado para segurança, flexibilidade e fácil integração em qualquer aplicação, capacitando usuários técnicos e não técnicos a obter insights de seus dados sem esforço.
Inteligência de NegóciosParadeDB
O ParadeDB é uma alternativa moderna ao Elasticsearch construída diretamente sobre o Postgres. Ele aprimora o Postgres com poderosas capacidades de pesquisa e análise em tempo real, incluindo pesquisa de texto completo, correspondência difusa e faceting, eliminando a necessidade de processos ETL complexos e motores de busca separados.
Busca
NeoBase
O NeoBase é um copiloto de IA de código aberto para bancos de dados, permitindo que os usuários interajam com seus dados usando linguagem natural. Ele se conecta a vários bancos de dados SQL e NoSQL, traduz consultas em inglês simples para código otimizado e visualiza os resultados. Projetado para usuários técnicos e não técnicos, ele agiliza a análise de dados, depuração e relatórios, eliminando a necessidade de escrever consultas complexas e fornecendo controle total dos dados por meio de auto-hospedagem.
Análise de Dados
SQL Chat
O SQL Chat é um cliente e editor SQL de código aberto baseado em chat que usa IA para traduzir perguntas em linguagem natural para consultas SQL. Conecte-se ao seu banco de dados, faça perguntas em português simples e obtenha resultados instantaneamente, democratizando o acesso a dados para usuários técnicos e não técnicos.
Assistente de Código
PostgresML
PostgresML é uma poderosa extensão de código aberto que integra machine learning e IA diretamente no seu banco de dados PostgreSQL. Ele permite inferência acelerada por GPU, busca vetorial e pipelines RAG completos usando comandos SQL simples, eliminando a movimentação de dados e simplificando a pilha de MLOps para aplicações de IA escaláveis e de alto desempenho.
MLOps
ClickHouse
ClickHouse é um sistema de gerenciamento de banco de dados OLAP de código aberto, orientado a colunas e de alto desempenho. Ele foi projetado para análises em tempo real em dados de grande escala, permitindo consultas ultrarrápidas para observabilidade, business intelligence, ML/GenAI e muito mais, mantendo-se eficiente em recursos e econômico.
Bancos de dados
SingleStore
O SingleStore é uma plataforma de dados de alto desempenho e em tempo real, projetada para IA empresarial e aplicações intensivas em dados. Ele unifica cargas de trabalho transacionais (OLTP) e analíticas (OLAP), incluindo pesquisa vetorial, em um único banco de dados SQL distribuído, oferecendo latência de milissegundos em escala.
Banco de Dados Vetorial
Metorial
Metorial é uma plataforma de integração para agentes de IA, permitindo que desenvolvedores construam, implementem e monitorem rapidamente poderosas aplicações de IA agentiva. Ela oferece conexões contínuas a centenas de ferramentas, fontes de dados e APIs através de sua plataforma serverless Model Context Protocol (MCP), fornecendo SDKs robustos, observabilidade e segurança de nível empresarial para soluções de IA escaláveis.
IA Agente
MindsDB
MindsDB é uma plataforma de automação de dados com IA que leva o machine learning para o seu banco de dados. Permite que desenvolvedores e analistas de dados criem, treinem e implantem modelos de IA usando consultas SQL padrão, conectando-se a mais de 200 fontes de dados para fornecer previsões e análises em tempo real sem pipelines ETL complexos.
Inteligência de Negócios
Postgres Sandbox
Uma ferramenta visual intuitiva, baseada na web, para projetar, prototipar e experimentar esquemas de banco de dados PostgreSQL. Crie tabelas, defina relacionamentos e gere código SQL em um ambiente sandbox sem riscos. Ideal para desenvolvedores, DBAs e estudantes.
Banco de Dados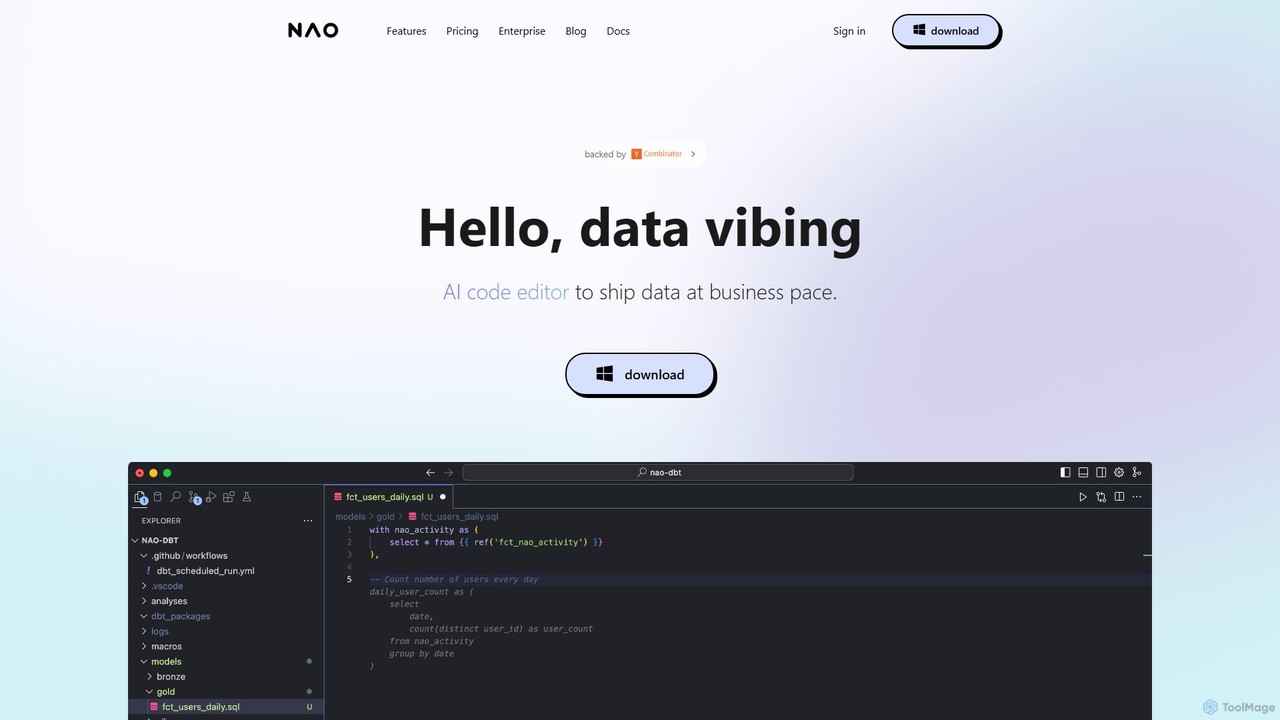
nao
nao é um editor de código alimentado por IA projetado para equipes de dados. Ele otimiza a criação de pipelines de dados em SQL e Python, fluxos de trabalho dbt e análises, conectando-se nativamente ao seu data warehouse. Seu agente inteligente fornece sugestões de código cientes dos dados, verificações de qualidade e pré-visualizações de diferenças instantâneas para ajudá-lo a entregar dados de forma mais rápida e segura.
Análise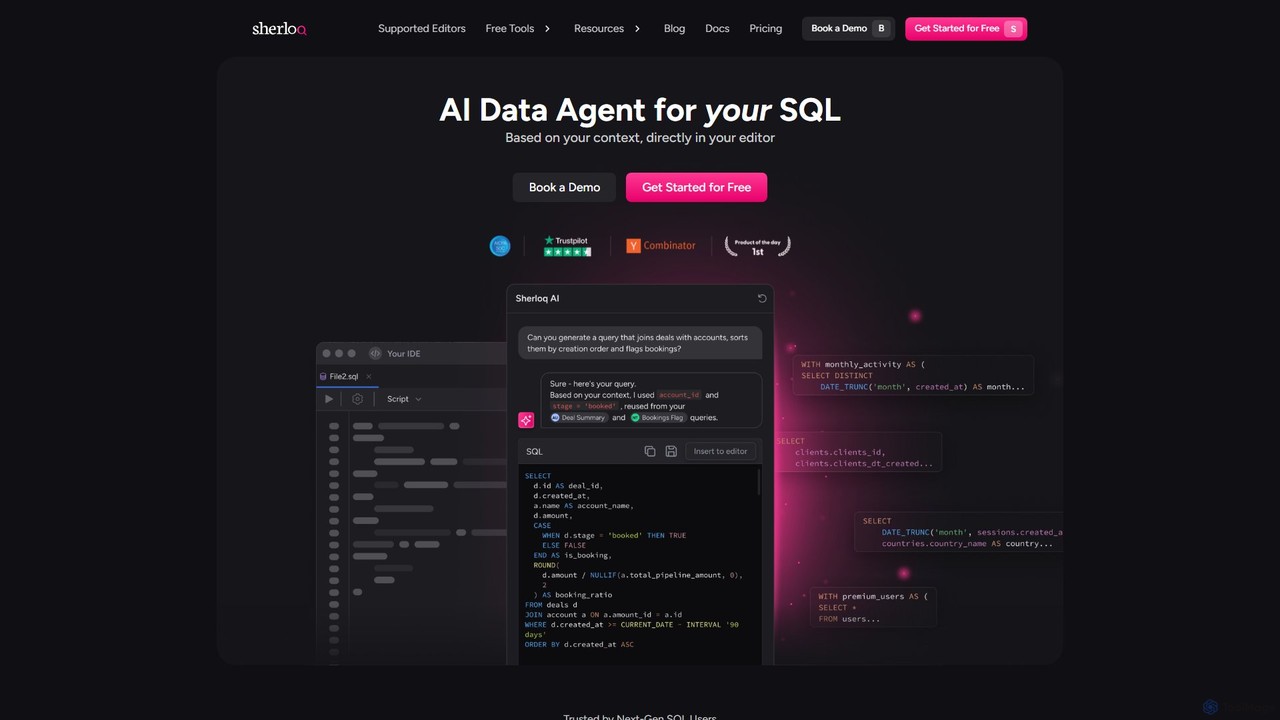
sherloqdata
Sherloqdata é um agente de dados para SQL alimentado por IA que funciona diretamente no seu editor. Ajuda profissionais de dados a escrever, corrigir e gerenciar consultas SQL mais rapidamente, usando seu repositório SQL existente como contexto. Os recursos incluem um Chat SQL com IA, gerenciamento de consultas, controle de versão e colaboração em equipe.
Banco de Dados
InfluxData Comments (0)
Sign in to comment.
EntrarNo comments yet.