
Superlinked Overview
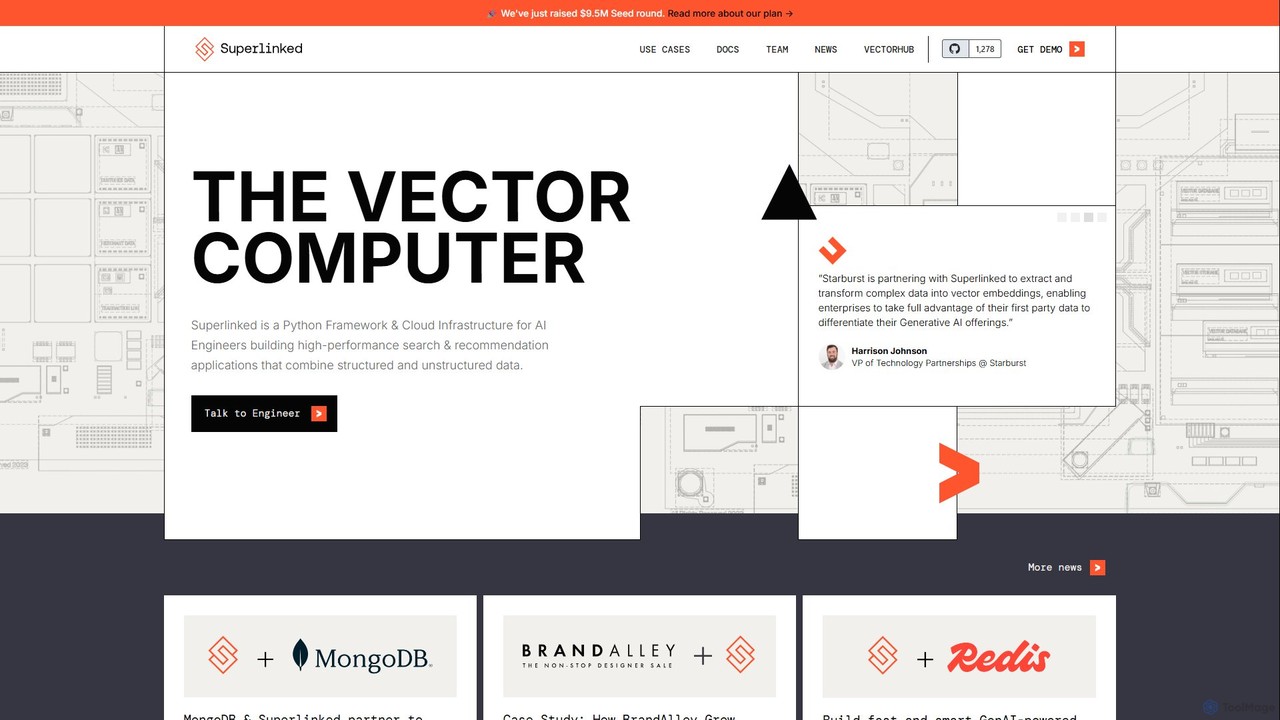
O Superlinked se apresenta como 'O Computador Vetorial', um sofisticado framework Python e solução de infraestrutura em nuvem sob medida para engenheiros de IA. Sua missão principal é capacitar desenvolvedores a construir aplicações de busca, recomendação e Geração Aumentada por Recuperação (RAG) de alto desempenho e de próxima geração. A força central da plataforma reside em sua capacidade de integrar perfeitamente dados estruturados complexos (como metadados, preços ou timestamps) com dados não estruturados (como texto e imagens) em embeddings vetoriais multimodais unificados e poderosos. Essa abordagem holística garante que as aplicações de IA possam entender o contexto completo dos dados, levando a resultados mais precisos e relevantes.
Tendo garantido recentemente uma rodada de financiamento semente de $9.5M, o Superlinked está expandindo rapidamente suas capacidades e presença no mercado. A plataforma é construída sobre uma base de profunda expertise em infraestrutura de aprendizado de máquina e é apoiada por parcerias estratégicas com líderes da indústria como MongoDB, Redis, Starburst e Dataiku. Essas colaborações garantem que o Superlinked se integre suavemente aos stacks de dados empresariais existentes, atuando como a camada de computação crucial entre as fontes de dados e os bancos de dados vetoriais.
Como usar o Superlinked
O Superlinked oferece um fluxo de trabalho simplificado de 'implemente uma vez, execute em qualquer lugar' que leva os desenvolvedores da experimentação inicial à produção em larga escala usando um único SDK Python:
- Experimentar: Os desenvolvedores podem começar em um notebook Python. Neste ambiente interativo e em memória, eles podem descrever e carregar seus dados, usar os 'Espaços' do Superlinked para construir e testar índices, e executar consultas para validar sua abordagem.
- Implantar: Uma vez que a lógica é finalizada, o mesmo código Python pode ser implantado em uma máquina local, uma VM na nuvem ou um ambiente containerizado. O desenvolvedor o conecta ao seu banco de dados vetorial de produção escolhido.
- Lançar e Usar: Atualizar a aplicação é simples. Os desenvolvedores podem enviar o novo código para um bucket na nuvem ou sobrescrever o arquivo .py local. O Superlinked gera automaticamente uma API de ingestão para enviar novas entidades de dados e uma API de consulta para executar buscas complexas com parâmetros ponderados, tornando o sistema fácil de integrar e manter.
Recursos principais do Superlinked
- Vetores Multimodais: Combina texto, imagens e vários metadados estruturados em uma única representação vetorial que captura o contexto completo de uma entidade.
- Consultas Multi-objetivo: Permite que os desenvolvedores ajustem finamente as consultas, equilibrando múltiplos objetivos concorrentes, como relevância, frescor, popularidade e avaliações de usuários, em uma única solicitação.
- Infraestrutura como Código: Toda a camada de computação vetorial é gerenciada através de um SDK Python simples e intuitivo, simplificando a implantação, o versionamento e a manutenção.
- Sistema Unificado para Múltiplos Casos de Uso: Uma única implementação do Superlinked pode alimentar várias tarefas de recuperação de informação e engenharia de features, incluindo RAG, busca semântica, recomendações e análises.
- Componentes de Código Aberto: Fornece elementos de código aberto, incluindo um repositório no GitHub e notebooks no Colab, para facilitar o aprendizado, a experimentação e a colaboração da comunidade.
Casos de uso para o Superlinked
O Superlinked é projetado para resolver desafios complexos de recuperação de informação em várias indústrias:
- Geração Aumentada por Recuperação (RAG): Aprimora sistemas baseados em LLM, recuperando os trechos de documentos mais relevantes e frescos, combinando relevância semântica com outros fatores críticos como a recenticidade.
- Recomendações de E-commerce: Alimenta motores de recomendação sofisticados que vão além do simples histórico do usuário, incorporando popularidade do produto, frescor e outros metadados. A BrandAlley usou o Superlinked com sucesso para aumentar as conversões em 77%.
- Busca Semântica Avançada: Cria sistemas de busca que entendem consultas em linguagem natural e podem filtrar e classificar resultados com base em critérios complexos e multifacetados (por exemplo, buscas conversacionais de empregos ou hotéis).
- Tecnologia de Recrutamento: A Climatebase aproveitou o Superlinked para aumentar as candidaturas a empregos em 50%, fornecendo correspondências de vagas mais relevantes para os candidatos.
Vantagens do Superlinked
O Superlinked oferece uma vantagem competitiva distinta para equipes que constroem com vetores:
- Conectando Silos de Dados: Ele conecta de forma única dados empresariais complexos e de primeira parte com o poder dos bancos de dados vetoriais, desbloqueando o valor total das informações proprietárias.
- Produção Simplificada: Abstrair as complexidades da computação vetorial e do gerenciamento de infraestrutura acelera significativamente o caminho do protótipo para um sistema de produção confiável e escalável.
- Precisão Aprimorada: Ao criar embeddings multimodais ricos em contexto e permitir consultas multi-objetivo, o Superlinked entrega resultados que são muito mais precisos e alinhados com os objetivos de negócio do que a busca vetorial tradicional sozinha.
- Forte Integração com o Ecossistema: Parcerias com grandes plataformas de dados como Redis, MongoDB e Starburst garantem integração perfeita e desempenho robusto dentro de arquiteturas de dados modernas.
Preços e planos
O Superlinked opera em um modelo freemium. Ele oferece componentes de código aberto para que os desenvolvedores comecem e experimentem. Para implantação em produção, infraestrutura em nuvem e recursos de nível empresarial, ele fornece planos pagos personalizados. As partes interessadas são incentivadas a 'Conversar com um Engenheiro' através de seu site para discutir suas necessidades específicas e receber uma cotação personalizada.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 27.5K
- 2026-1: 21.9K
- 2026-2: 18.6K
- 2026-3: 18.0K
- 2026-4: 19.4K
- 2026-5: 32.0K
Geography
Top 5 countries / regions
- 🇮🇳Índia51.4%
- 🇺🇸Estados Unidos22.7%
- 🇻🇳Vietnã12.4%
- 🇷🇺Rússia6.8%
- 🇮🇩Indonésia6.7%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 82.3% |
Referral | 17.1% |
Email | 0.7% |
Top keywords
| Keyword | Cost per click |
|---|---|
| data augmentation transforms | $0.00 |
| superlinked | $5.57 |
| superlinked ai | $0.00 |
| superlinked -vector | $0.00 |
| visualize embeddings in browser | $0.00 |
Superlinked Alternatives
Zilliz
Zilliz é um banco de dados vetorial de nível empresarial construído para aplicações de IA escaláveis. Potencializado pelo popular projeto de código aberto Milvus, ele oferece um serviço de alto desempenho, econômico e totalmente gerenciado (Zilliz Cloud) para armazenar, indexar e pesquisar bilhões de embeddings de vetores. Ele foi projetado para impulsionar aplicações como RAG, sistemas de recomendação e busca multimodal, com integrações perfeitas com os principais frameworks de IA e plataformas de nuvem.
Aprendizagem de Máquina
SvectorDB
SvectorDB é um banco de dados vetorial sem servidor projetado para desenvolvedores. Ele simplifica a criação de aplicativos de IA como motores de recomendação, busca semântica e sistemas RAG com preços por solicitação, atualizações instantâneas e vetorizadores integrados. Vá do protótipo à produção com apenas algumas linhas de código.
Pesquisa Vetorial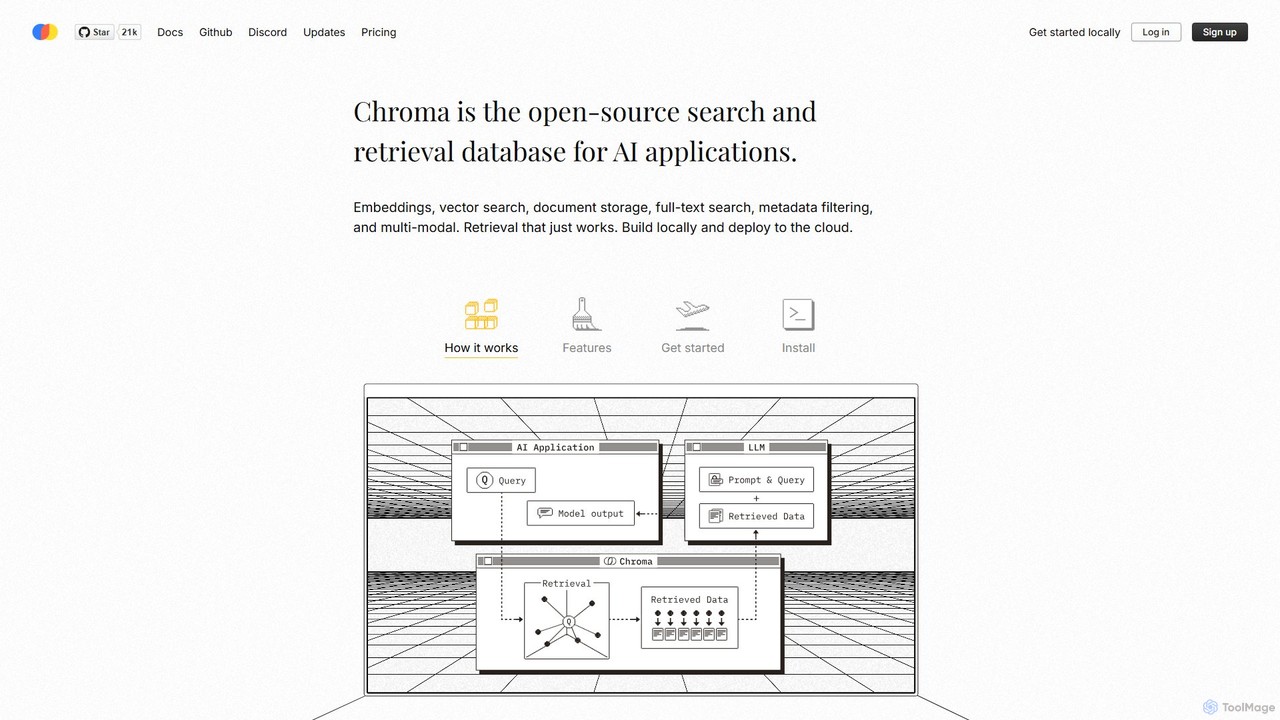
Chroma
Chroma é o banco de dados de recuperação de código aberto e nativo de IA, projetado para construir poderosas aplicações de IA com Geração Aumentada por Recuperação (RAG). Ele simplifica o armazenamento e a busca de embeddings, documentos e metadados, oferecendo busca vetorial, busca de texto completo e uma plataforma em nuvem escalável e sem servidor. Foi construído para ser fácil de usar, econômico e potente, do desenvolvimento local à produção em larga escala.
Banco de Dados Vetorial
Mixpeek
Mixpeek é um data warehouse multimodal e API para desenvolvedores, projetado para processar, pesquisar e analisar dados não estruturados como vídeo, áudio, imagens e documentos. Ele simplifica o pipeline de IA/ML com busca semântica unificada, classificação automatizada e gerenciamento de modelos contínuo, permitindo que os desenvolvedores criem aplicações multimodais poderosas.
Aprendizagem de Máquina
infiniflow
infiniflow é um banco de dados de código aberto, nativo de IA e de alto desempenho, projetado especificamente para aplicações de LLM. Oferece busca vetorial incrivelmente rápida, poderosos recursos de busca híbrida (vetor, texto completo, tensor) e implantação simplificada. Com uma API Python intuitiva, foi construído para potencializar tarefas de IA exigentes, como Geração Aumentada por Recuperação (RAG) e busca semântica com latência de milissegundos.
Pesquisa VetorialSuperlinked Categories
Superlinked Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

Pinecone
O Pinecone é um banco de dados vetorial de alto desempenho e totalmente gerenciado, projetado para a construção de aplicações de IA com conhecimento em escala. Ele permite que os desenvolvedores implementem recursos avançados como busca semântica, geração aumentada por recuperação (RAG) e recomendações personalizadas, armazenando e consultando eficientemente bilhões de embeddings de vetores em tempo real.
Banco de Dados
Qdrant
Qdrant é um banco de dados vetorial de código aberto e motor de busca por similaridade de alto desempenho, construído em Rust. Ele foi projetado para impulsionar a próxima geração de aplicações de IA, gerenciando e pesquisando eficientemente bilhões de vetores de alta dimensão. Com recursos avançados como filtragem rica, armazenamento de payload e vários métodos de quantização, o Qdrant permite que os desenvolvedores criem soluções escaláveis e econômicas para busca semântica, sistemas de recomendação e Geração Aumentada por Recuperação (RAG).
Pesquisa Vetorial
LanceDB
O LanceDB é um lakehouse multimodal nativo de IA de código aberto, projetado para construir e escalar aplicações de IA. Ele fornece uma plataforma unificada para armazenar, pesquisar e gerenciar dados complexos como texto, imagens, voz e vetores. Ideal para RAG, busca semântica e treinamento de modelos, o LanceDB oferece busca híbrida ultrarrápida, escalabilidade massiva para petabytes e economias de custo significativas, tornando-se uma base poderosa para IA de nível empresarial.
Banco de Dados VetorialZilliz
Zilliz é um banco de dados vetorial de nível empresarial construído para aplicações de IA escaláveis. Potencializado pelo popular projeto de código aberto Milvus, ele oferece um serviço de alto desempenho, econômico e totalmente gerenciado (Zilliz Cloud) para armazenar, indexar e pesquisar bilhões de embeddings de vetores. Ele foi projetado para impulsionar aplicações como RAG, sistemas de recomendação e busca multimodal, com integrações perfeitas com os principais frameworks de IA e plataformas de nuvem.
Aprendizagem de MáquinaSvectorDB
SvectorDB é um banco de dados vetorial sem servidor projetado para desenvolvedores. Ele simplifica a criação de aplicativos de IA como motores de recomendação, busca semântica e sistemas RAG com preços por solicitação, atualizações instantâneas e vetorizadores integrados. Vá do protótipo à produção com apenas algumas linhas de código.
Pesquisa Vetorial
Milvus
Milvus é um banco de dados vetorial de código aberto e alto desempenho, construído para aplicações de IA. Ele permite que os desenvolvedores gerenciem e pesquisem bilhões de vetores de alta dimensão com latência mínima. Ideal para construir sistemas escaláveis como geração aumentada por recuperação (RAG), motores de recomendação e busca semântica, o Milvus oferece opções de implantação flexíveis, desde prototipagem local até clusters distribuídos em larga escala.
Aprendizado de Máquina
Jina AI
A Jina AI fornece uma plataforma de Fundação de Pesquisa de ponta, oferecendo um conjunto de APIs poderosas para embeddings multimodais, reclassificação e extração de dados. É projetada para desenvolvedores e empresas construírem IA generativa de alta qualidade, RAG (Geração Aumentada por Recuperação) e aplicações de pesquisa avançada com capacidades multilíngues e multimodais.
Modelo de Linguagem
SurrealDB
O SurrealDB é um banco de dados em nuvem multi-modelo de última geração, projetado para aplicações modernas. Ele simplifica o desenvolvimento de backend unificando modelos de documento, relacional, gráfico e de série temporal com busca de texto completo, busca vetorial e aprendizado de máquina no banco de dados integrados. Construído para escalabilidade e dados em tempo real, ele capacita os desenvolvedores a construir aplicações complexas e alimentadas por IA com uma facilidade e velocidade sem precedentes.
Banco de Dados Vetorial
Spice AI
O Spice AI é um motor de computação de dados e IA de código aberto e portátil para desenvolvedores. Ele unifica dados de qualquer fonte, acelera consultas com o Apache Arrow e integra o serviço de modelos de IA e a pesquisa vetorial para simplificar a criação de aplicativos de alto desempenho orientados por dados.
Implantação de Modelo
Meilisearch
Meilisearch é um motor de busca de código aberto, ultrarrápido e alimentado por IA. Foi projetado para que desenvolvedores integrem facilmente capacidades de busca avançada, incluindo busca de texto completo, semântica e híbrida, em qualquer site ou aplicação. Oferece uma experiência excepcional para desenvolvedores com APIs e SDKs poderosos.
Banco de dados
Ducky
Ducky é uma infraestrutura de busca de IA totalmente gerenciada, projetada para desenvolvedores. Simplifica a implementação da Geração Aumentada por Recuperação (RAG) ao lidar com tarefas complexas como divisão de dados, embedding e reclassificação. Com um SDK Python simples, o Ducky permite que os desenvolvedores construam rapidamente capacidades de busca semântica rápidas, precisas e escaláveis em suas aplicações, fornecendo respostas conscientes do contexto e sem alucinações de LLMs.
Geração Aumentada por Recuperação
vecrank
vecrank é uma plataforma avançada de busca e ranqueamento com IA para desenvolvedores. Utiliza embeddings de vetores para fornecer resultados de busca semântica altamente relevantes, indo além da simples correspondência de palavras-chave. Ideal para construir experiências de busca de última geração, motores de recomendação e sistemas RAG.
Banco de dadosChroma
Chroma é o banco de dados de recuperação de código aberto e nativo de IA, projetado para construir poderosas aplicações de IA com Geração Aumentada por Recuperação (RAG). Ele simplifica o armazenamento e a busca de embeddings, documentos e metadados, oferecendo busca vetorial, busca de texto completo e uma plataforma em nuvem escalável e sem servidor. Foi construído para ser fácil de usar, econômico e potente, do desenvolvimento local à produção em larga escala.
Banco de Dados VetorialMixpeek
Mixpeek é um data warehouse multimodal e API para desenvolvedores, projetado para processar, pesquisar e analisar dados não estruturados como vídeo, áudio, imagens e documentos. Ele simplifica o pipeline de IA/ML com busca semântica unificada, classificação automatizada e gerenciamento de modelos contínuo, permitindo que os desenvolvedores criem aplicações multimodais poderosas.
Aprendizagem de Máquina
Superlinked Comments (0)
Sign in to comment.
EntrarNo comments yet.