
ToolMage
Đăng nhập

Best 1 Đánh giá LLM AI tools for Công cụ dành cho nhà phát triển

Popular Đánh giá LLM AI tools in Công cụ dành cho nhà phát triển include Cleanlab Chat, helping you work more efficiently.

Cleanlab Chat
Freemium

Cleanlab Chat

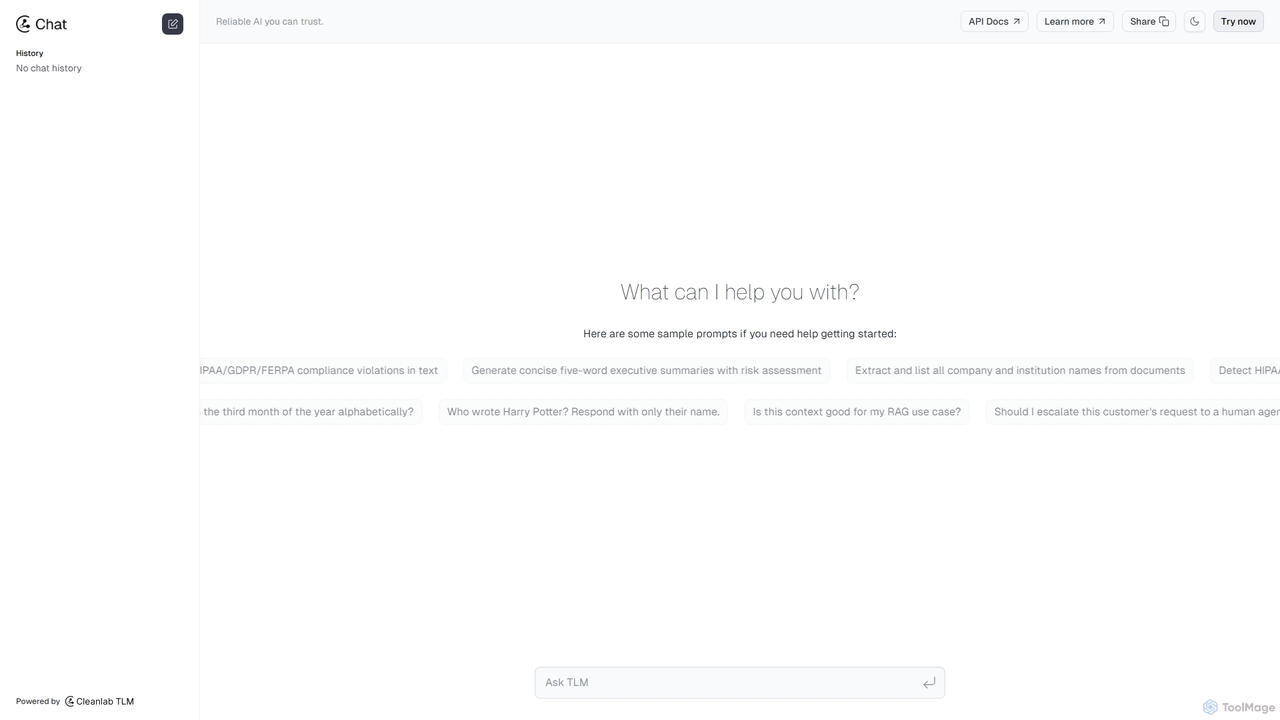
Cleanlab Chat là một giao diện trò chuyện AI tiên tiến được cung cấp bởi Mô hình Ngôn ngữ Đáng tin cậy (TLM) của Cleanlab. Nó được thiết kế cho các tác vụ cấp doanh nghiệp, bao gồm đánh giá hệ thống RAG, phát hiện ảo giác, kiểm tra tuân thủ dữ liệu (HIPAA, GDPR) và phân tích văn bản đáng tin cậy, đảm bảo tính chính xác và an toàn trong các ứng dụng kinh doanh.

Đánh giá LLM
Visits 6.6KFavorites 170Likes 163

About Đánh giá LLM

Công cụ Đánh giá LLM là một danh mục chuyên biệt gồm các tiện ích dành cho nhà phát triển được thiết kế để đo lường, phân tích và so sánh hiệu suất của các Mô hình Ngôn ngữ Lớn (LLM) một cách có hệ thống. Các nền tảng này cung cấp khuôn khổ để chạy các bài kiểm tra tiêu chuẩn, tính toán các chỉ số chính và tiến hành các đánh giá định tính để đảm bảo độ tin cậy, độ chính xác và an toàn của mô hình. Chúng rất cần thiết cho các nhà phát triển và tổ chức để xác thực hành vi của mô hình trước khi triển khai, giám sát hiệu suất trong sản xuất và đưa ra quyết định dựa trên dữ liệu khi lựa chọn hoặc tinh chỉnh mô hình. Quá trình này giúp xác định các điểm yếu, thành kiến và rủi ro tiềm ẩn liên quan đến kết quả đầu ra của LLM.

Tính năng Cốt lõi

  • Kiểm tra tự động (Benchmarking): Chạy các mô hình trên các bộ dữ liệu học thuật và công nghiệp tiêu chuẩn (ví dụ: MMLU, HellaSwag) để có được điểm hiệu suất có thể so sánh.
  • Tính toán Chỉ số: Tự động tính toán các chỉ số định lượng như độ chính xác, độ phức tạp (perplexity), điểm BLEU/ROUGE, mức độ độc hại và các chỉ số thiên vị.
  • Đánh giá có sự tham gia của con người (HITL): Cung cấp giao diện cho người đánh giá để xếp hạng, chấm điểm hoặc so sánh song song các kết quả đầu ra của mô hình để phân tích định tính.
  • Kiểm tra đối kháng & Red Teaming: Thăm dò hệ thống các mô hình để tìm lỗ hổng, lỗi bảo mật và các hành vi không mong muốn bằng cách tạo ra các đầu vào đầy thách thức hoặc độc hại.
  • Theo dõi Hiệu suất & Chi phí: Giám sát các chỉ số vận hành như độ trễ, thông lượng và chi phí API trong quá trình đánh giá để đánh giá sự sẵn sàng cho sản xuất.

Trường hợp sử dụng

Công cụ Đánh giá LLM rất quan trọng trong suốt vòng đời phát triển AI. Chúng được các kỹ sư ML sử dụng để kiểm tra hồi quy sau khi tinh chỉnh mô hình, được các nhóm an toàn AI sử dụng để kiểm tra thành kiến và độc tính trước khi phát hành công khai, và được các nhà quản lý sản phẩm sử dụng để so sánh các mô hình của bên thứ ba khác nhau (như GPT so với Claude) cho một ứng dụng cụ thể. Các công cụ này cũng rất quan trọng cho việc giám sát liên tục để phát hiện sự suy giảm hiệu suất hoặc sự trôi dạt của mô hình trong các ứng dụng đang hoạt động.

Cách lựa chọn

Khi chọn một công cụ Đánh giá LLM, hãy xem xét khả năng hỗ trợ các mô hình khác nhau (cả API độc quyền và mã nguồn mở), phạm vi của các bài kiểm tra và chỉ số tích hợp sẵn, và tính linh hoạt trong việc xác định các bộ dữ liệu và tiêu chí đánh giá tùy chỉnh. Ngoài ra, hãy đánh giá khả năng tích hợp của nó với các quy trình MLOps (như CI/CD), các tính năng phản hồi hợp tác từ con người và khả năng mở rộng để xử lý các bài kiểm tra quy mô lớn. Mô hình định giá — dù dựa trên mức sử dụng, số lượng người dùng hay tính năng — cũng là một yếu tố quan trọng.

Đánh giá LLM use cases

1

Lựa chọn LLM tốt nhất cho Chatbot Dịch vụ Khách hàng

Một nhóm sản phẩm tại một công ty thương mại điện tử cần chọn LLM phù hợp nhất cho nhân viên dịch vụ khách hàng AI mới của họ. Họ sử dụng một nền tảng đánh giá LLM để so sánh ba ứng cử viên: GPT-4o, Claude 3 Opus và một mô hình Llama 3 đã được tinh chỉnh. Nhóm tạo ra một bộ dữ liệu đánh giá tùy chỉnh gồm 1.000 truy vấn thực tế của khách hàng, bao gồm các chủ đề như theo dõi đơn hàng, trả hàng và câu hỏi về sản phẩm. Công cụ này tự động hóa quá trình chạy từng truy vấn qua cả ba mô hình và tính toán các chỉ số về độ chính xác, mức độ hữu ích và sự tuân thủ giọng văn mong muốn của công ty. Sau đó, những người đánh giá sử dụng giao diện so sánh song song của nền tảng để chấm điểm các phản hồi về các phẩm chất tinh tế, dẫn đến một quyết định được hỗ trợ bởi dữ liệu.

2

Tự động hóa Kiểm tra Hồi quy cho các Cập nhật Mô hình

Một công ty phần mềm doanh nghiệp tinh chỉnh mô hình tạo mã độc quyền của họ hàng quý với dữ liệu mới. Để ngăn chặn sự suy giảm hiệu suất, nhóm MLOps của họ tích hợp một công cụ đánh giá LLM vào quy trình CI/CD của họ. Sau mỗi lần chạy tinh chỉnh, quy trình sẽ tự động kích hoạt một công việc đánh giá. Công việc này chạy mô hình đã cập nhật trên một 'bộ dữ liệu vàng' gồm 500 thử thách lập trình phức tạp với các giải pháp tối ưu đã biết. Công cụ này đo lường tính đúng đắn của mã, hiệu quả và sự tuân thủ các hướng dẫn về phong cách. Nếu bất kỳ chỉ số chính nào giảm xuống dưới ngưỡng được xác định trước, bản dựng sẽ thất bại và nhóm sẽ được cảnh báo, ngăn chặn một mô hình bị lỗi được triển khai vào sản xuất.

3

Thực hiện Kiểm tra An toàn và Thành kiến AI

Một công ty dịch vụ tài chính đang phát triển một LLM để hỗ trợ tóm tắt các tài liệu quy định. Trước khi triển khai, nhóm tuân thủ và an toàn AI của họ sử dụng một công cụ đánh giá để tiến hành một cuộc kiểm tra kỹ lưỡng. Họ sử dụng các tính năng red teaming của công cụ để tạo ra các lời nhắc đối kháng được thiết kế để kiểm tra các thành kiến liên quan đến các đặc điểm được bảo vệ (ví dụ: tuổi tác, giới tính) và để thăm dò các lỗ hổng bảo mật, chẳng hạn như các cuộc tấn công chèn lời nhắc. Nền tảng tự động gắn cờ các phản hồi độc hại, thiên vị hoặc không tuân thủ và tạo ra một báo cáo chi tiết. Điều này cho phép nhóm phát triển xác định và giảm thiểu các rủi ro an toàn quan trọng trước khi mô hình được sử dụng nội bộ.

4

So sánh các chiến lược Kỹ thuật Lời nhắc

Một nhóm tiếp thị đang sử dụng LLM để tạo bản sao quảng cáo trên mạng xã hội. Để tìm ra cấu trúc lời nhắc hiệu quả nhất, họ sử dụng một công cụ đánh giá để kiểm tra A/B các kỹ thuật nhắc khác nhau, chẳng hạn như zero-shot, few-shot và chuỗi suy nghĩ. Họ tạo một bộ kiểm tra với 100 mô tả sản phẩm khác nhau. Công cụ này chạy từng mô tả qua LLM bằng năm mẫu lời nhắc khác nhau. Các kết quả đầu ra sau đó được chấm điểm tự động theo một bảng tiêu chí về sự sáng tạo, rõ ràng và nhất quán với giọng điệu thương hiệu. Cách tiếp cận có hệ thống này cho phép nhóm xác định mẫu lời nhắc luôn tạo ra bản sao chất lượng cao nhất, tối ưu hóa quy trình làm việc tạo nội dung của họ.

5

Giám sát Sự trôi dạt Hiệu suất của Mô hình Sản xuất

Một công ty công nghệ pháp lý sử dụng LLM để cung cấp tính năng tóm tắt tài liệu. Để đảm bảo chất lượng của nó luôn ở mức cao theo thời gian, họ sử dụng một công cụ đánh giá để giám sát liên tục. Công cụ được cấu hình để lấy mẫu 1% tất cả các yêu cầu sản xuất và các bản tóm tắt tương ứng hàng ngày. Nó tự động tính toán các chỉ số ROUGE và BERTScore bằng cách so sánh đầu ra của LLM với một bản tóm tắt tham chiếu (khi có sẵn) hoặc các phương pháp phỏng đoán khác. Một bảng điều khiển trực quan hóa các chỉ số này theo thời gian. Nếu điểm ROUGE trung bình giảm hơn 5% trong một tuần, một cảnh báo sẽ được gửi đến nhóm kỹ thuật, báo hiệu sự trôi dạt tiềm năng của mô hình và thúc đẩy một cuộc điều tra hoặc chu kỳ đào tạo lại.

6

Tối ưu hóa Chi phí và Độ trễ trong các Ứng dụng Thời gian thực

Một nhà phát triển đang xây dựng tính năng dịch thuật thời gian thực cho một ứng dụng di động và cần cân bằng giữa chất lượng, tốc độ và chi phí. Họ sử dụng một công cụ đánh giá LLM để so sánh một mô hình lớn, chất lượng cao (như GPT-4) với một mô hình nhỏ hơn, nhanh hơn và rẻ hơn (như một mô hình mã nguồn mở được chưng cất). Họ chạy một bộ kiểm tra gồm 2.000 cụm từ phổ biến trên cả hai mô hình. Công cụ đánh giá không chỉ ghi lại độ chính xác của bản dịch (sử dụng điểm BLEU) mà còn cả độ trễ trung bình và chi phí API cho mỗi mô hình. Báo cáo kết quả cung cấp một phân tích đánh đổi rõ ràng, cho phép nhà phát triển chọn mô hình đáp ứng ngưỡng chất lượng tối thiểu cho người dùng của họ trong khi vẫn nằm trong mục tiêu ngân sách và độ trễ.

Đánh giá LLM FAQ

Công cụ Đánh giá LLM là gì?

Công cụ Đánh giá LLM là các nền tảng phần mềm chuyên dụng giúp các nhà phát triển, nhà nghiên cứu và tổ chức đo lường một cách có hệ thống hiệu suất và sự an toàn của các Mô hình Ngôn ngữ Lớn. Chúng cung cấp các khuôn khổ để tự động hóa việc kiểm tra, so sánh các mô hình hoặc lời nhắc khác nhau và phân tích kết quả đầu ra dựa trên các chỉ số đã xác định. Các chức năng chính bao gồm chạy các bài kiểm tra, tính điểm về độ chính xác và độ trôi chảy, phát hiện thành kiến và độc tính, và tạo điều kiện cho phản hồi của con người. Những công cụ này rất cần thiết để đảm bảo rằng các ứng dụng được hỗ trợ bởi LLM là đáng tin cậy, hiệu quả và an toàn trước và sau khi triển khai.

Làm thế nào để chọn công cụ Đánh giá LLM phù hợp?

Việc chọn công cụ phù hợp phụ thuộc vào nhu cầu cụ thể của bạn. Hãy xem xét các yếu tố sau:

  • Hỗ trợ Mô hình: Công cụ có hỗ trợ các LLM bạn sử dụng không (ví dụ: OpenAI, Anthropic, các mô hình mã nguồn mở như Llama)?
  • Chỉ số & Bài kiểm tra: Nó có cung cấp các bài kiểm tra và chỉ số tiêu chuẩn liên quan đến trường hợp sử dụng của bạn không (ví dụ: ROUGE để tóm tắt, tính đúng đắn của mã để tạo mã)?
  • Tùy chỉnh: Bạn có thể dễ dàng tải lên bộ dữ liệu riêng của mình và xác định logic hoặc chỉ số đánh giá tùy chỉnh không?
  • Tích hợp: Nó tích hợp tốt như thế nào với quy trình làm việc MLOps hiện tại của bạn, chẳng hạn như các quy trình CI/CD để kiểm tra tự động?
  • Tính năng Hợp tác: Nó có cung cấp giao diện người dùng tốt để người đánh giá cung cấp phản hồi định tính không?
  • Khả năng mở rộng và Chi phí: Nó có thể xử lý khối lượng đánh giá bạn cần không, và mô hình định giá của nó có phù hợp với ngân sách của bạn không?
Sự khác biệt giữa đánh giá tự động và đánh giá của con người đối với LLM là gì?

Đánh giá tự động và đánh giá của con người là hai phương pháp bổ sung cho nhau để đánh giá LLM. Đánh giá tự động sử dụng các chỉ số có thể tính toán được (như BLEU, ROUGE, độ chính xác) để nhanh chóng chấm điểm kết quả đầu ra của mô hình so với một bộ dữ liệu tham chiếu trên quy mô lớn. Nó nhanh, rẻ và khách quan cho các nhiệm vụ cụ thể. Mặt khác, đánh giá của con người liên quan đến việc mọi người xếp hạng hoặc so sánh kết quả đầu ra của mô hình dựa trên các phẩm chất chủ quan như sự sáng tạo, mạch lạc, hữu ích hoặc giọng điệu. Mặc dù chậm hơn và tốn kém hơn, đây là tiêu chuẩn vàng để nắm bắt các khía cạnh tinh tế của ngôn ngữ mà các chỉ số tự động thường bỏ qua. Hầu hết các chiến lược đánh giá mạnh mẽ đều sử dụng các phương pháp tự động để kiểm tra nhanh chóng, rộng rãi và phản hồi của con người để xác thực sâu hơn, định tính hơn.

Các chỉ số phổ biến được sử dụng trong Đánh giá LLM là gì?

Các chỉ số được sử dụng phụ thuộc nhiều vào nhiệm vụ. Tuy nhiên, một số chỉ số phổ biến bao gồm:

  • Độ chính xác (Accuracy): Đối với các nhiệm vụ phân loại hoặc trả lời câu hỏi, chỉ số này đo lường tỷ lệ phần trăm các dự đoán đúng.
  • Độ phức tạp (Perplexity): Đo lường mức độ một mô hình xác suất dự đoán một mẫu tốt như thế nào. Độ phức tạp thấp hơn thường cho thấy một mô hình tốt hơn.
  • BLEU/ROUGE: Thường được sử dụng cho dịch thuật và tóm tắt, chúng so sánh sự chồng chéo của các n-gram giữa đầu ra của mô hình và một văn bản tham chiếu.
  • Điểm Độc hại/Thành kiến: Các bộ phân loại chuyên dụng được sử dụng để chấm điểm các kết quả đầu ra về nội dung có hại, định kiến hoặc các thành kiến khác.
  • Độ trễ & Chi phí: Các chỉ số vận hành đo lường thời gian phản hồi của mô hình và chi phí tài chính cho mỗi lần suy luận, rất quan trọng đối với các ứng dụng trong thế giới thực.
Tại sao việc đánh giá liên tục các LLM trong sản xuất lại quan trọng?

Việc đánh giá liên tục là rất quan trọng vì hiệu suất của một LLM không phải là tĩnh. Nó có thể suy giảm theo thời gian do một hiện tượng gọi là 'sự trôi dạt của mô hình' (model drift), khi các mẫu trong dữ liệu đầu vào thực tế thay đổi và không còn khớp với dữ liệu mà mô hình đã được đào tạo. Ví dụ, một bot dịch vụ khách hàng có thể gặp các loại truy vấn mới mà nó chưa được đào tạo để xử lý. Việc giám sát liên tục các chỉ số chính cho phép các nhóm phát hiện sớm sự suy giảm hiệu suất này, xác định nguyên nhân của nó (ví dụ: chủ đề mới, ngôn ngữ người dùng thay đổi) và kích hoạt các hành động cần thiết như đào tạo lại mô hình hoặc cập nhật lời nhắc. Điều này đảm bảo ứng dụng vẫn đáng tin cậy và hiệu quả cho người dùng sau một thời gian dài kể từ khi ra mắt ban đầu.