ToolMage
Anmelden

Best 2 Datenpipeline AI tools for Daten

Popular Datenpipeline AI tools in Daten include Orchestra und Observo AI, helping you work more efficiently.

Observo AI
Paid

Observo AI

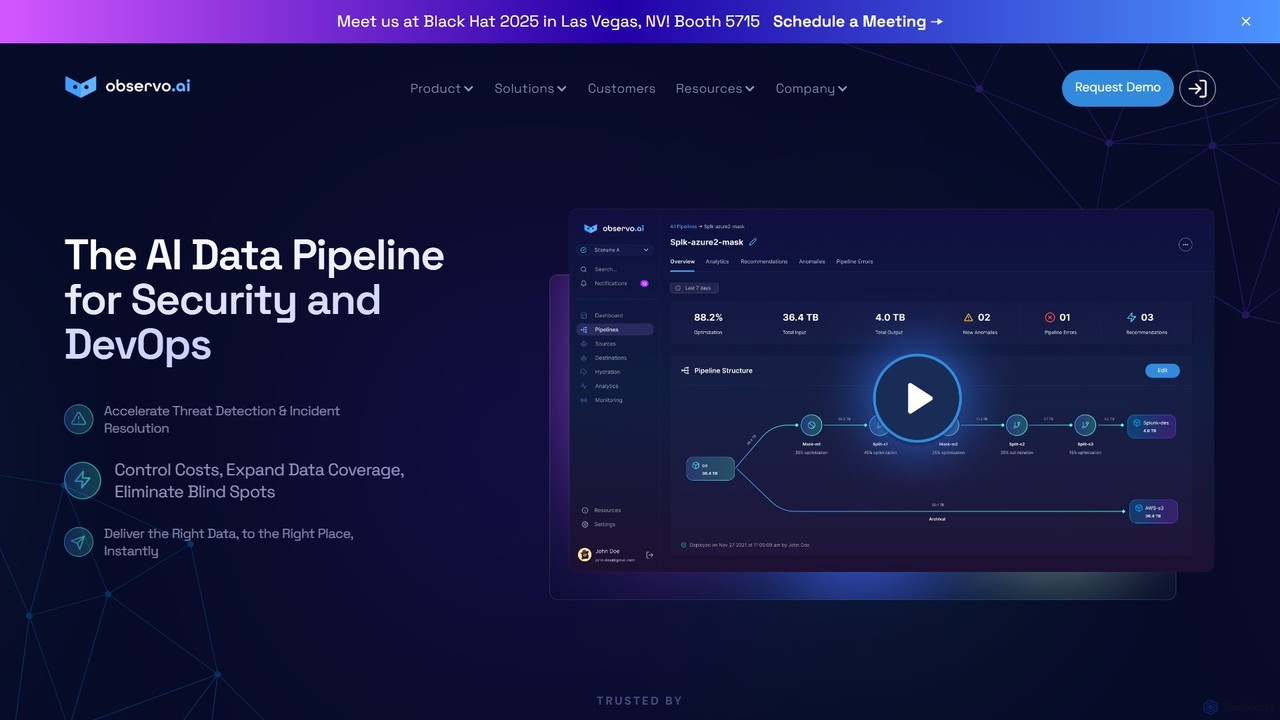
Observo AI ist eine intelligente Datenpipeline-Plattform für Sicherheits- und DevOps-Teams. Sie nutzt KI, um Telemetriedaten zu optimieren, das Protokollvolumen um bis zu 80 % und die Beobachtbarkeitskosten um über 50 % zu senken. Die Plattform beschleunigt die Bedrohungserkennung, reichert Daten in Echtzeit an und beseitigt blinde Flecken, wodurch Sicherheit und Betrieb effizienter und kostengünstiger werden.

Datenpipeline
Visits 13.9KFavorites 140Likes 158
Orchestra
Freemium

Orchestra

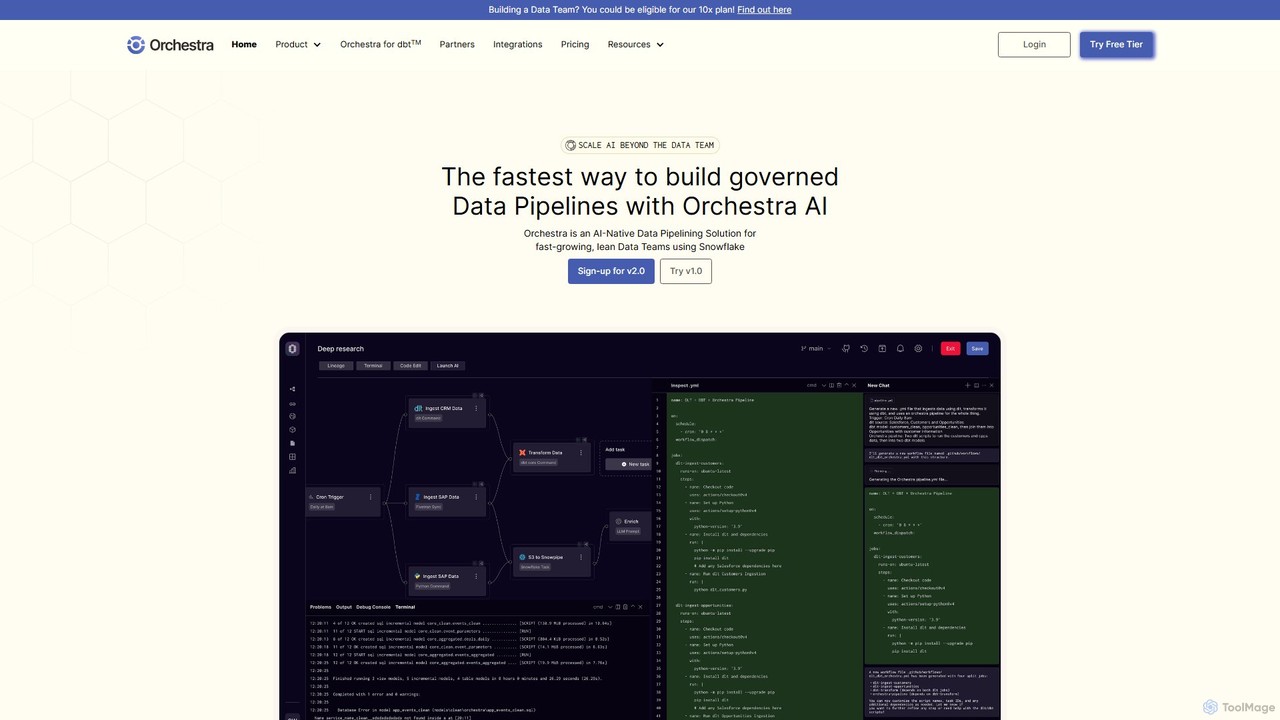
Orchestra ist eine einheitliche Steuerungsebene für Datenorchestrierung und -pipelining, die für schlanke Datenteams entwickelt wurde. Es bietet eine KI-native Lösung zum Erstellen, Überwachen und Verwalten von gesteuerten Datenpipelines mit End-to-End-Beobachtbarkeit, proaktiven Warnungen und umfangreichen Integrationen. Es vereinfacht komplexe Daten-Workflows, reduziert den Wartungsaufwand und stellt sicher, dass Daten zuverlässig und KI-fähig sind.

Business Intelligence
Visits 77.1KFavorites 139Likes 150

About Datenpipeline

Datenpipeline-Tools sind Plattformen, die entwickelt wurden, um die Bewegung und Transformation von Daten von verschiedenen Quellen zu einem Ziel für die Analyse zu automatisieren. Sie orchestrieren komplexe Arbeitsabläufe, einschließlich Datenerfassung, -verarbeitung und -ladung, oft in Echtzeit oder nach einem Zeitplan. Diese Tools sind unerlässlich für die Aufrechterhaltung konsistenter, zuverlässiger und aktueller Daten für Business Intelligence, maschinelles Lernen und operative Berichterstattung. Sie bieten robuste Überwachung, Fehlerbehandlung und Skalierbarkeit, um Datenflüsse innerhalb des breiteren Datenökosystems effizient zu verwalten.

Kernfunktionen

  • Datenquellen-Konnektoren: Native Verbindung zu einer Vielzahl von Datenbanken, APIs, Cloud-Speichern und SaaS-Anwendungen zur Datenextraktion.
  • Workflow-Orchestrierung: Visuelles Entwerfen, Planen und Verwalten von mehrstufigen Datenverarbeitungsaufgaben und deren Abhängigkeiten.
  • In-Flight-Transformation: Bereinigen, Anreichern, Aggregieren und Umformatieren von Daten, während sie die Pipeline durchlaufen, unter Verwendung von SQL oder codebasierter Logik (ETL/ELT).
  • Überwachung und Alarmierung: Verfolgen Sie den Zustand der Pipeline, die Datenqualität und die Leistung in Echtzeit mit automatisierten Warnungen bei Ausfällen oder Anomalien.

Anwendungsfälle

Datenpipeline-Tools werden von Dateningenieuren, Analysten und Wissenschaftlern in den Bereichen Technologie, Finanzen und E-Commerce weit verbreitet eingesetzt. Sie sind grundlegend für die Erstellung automatisierter Berichtssysteme, die Einspeisung von Daten in Modelle des maschinellen Lernens zum Training oder die Synchronisierung von Daten zwischen operativen Systemen wie CRMs und ERPs.

Wie man wählt

Bei der Auswahl eines Datenpipeline-Tools sollten Sie die Vielfalt und das Volumen Ihrer Datenquellen berücksichtigen. Bewerten Sie seine Transformationsfähigkeiten (codebasiert vs. Low-Code), die Skalierbarkeit für zukünftiges Wachstum und die Integration in Ihren bestehenden Daten-Stack (z. B. Data Warehouses, BI-Tools). Bewerten Sie auch die Überwachungsfunktionen und das Preismodell (z. B. volumenbasiert vs. rechenbasiert).

Datenpipeline use cases

1

Automatisierung von Business-Intelligence-Berichten

Ein Datenanalyseteam verwendet ein Datenpipeline-Tool, um Informationen aus mehreren Quellen zu konsolidieren. Jede Nacht extrahiert die Pipeline automatisch Verkaufsdaten aus Salesforce, Marketingkampagnen-Metriken aus Google Ads und Kundensupport-Tickets aus Zendesk. Anschließend bereinigt, standardisiert und verbindet sie diese Datensätze, bevor die einheitlichen Daten in ein BigQuery-Data-Warehouse geladen werden. Dies stellt sicher, dass die Tableau-Dashboards des Unternehmens zu Beginn jedes Arbeitstages mit frischen, umfassenden Daten aktualisiert werden, wodurch Stunden manueller Datenerfassung und -verarbeitung entfallen.

2

Unterstützung des Trainings von Machine-Learning-Modellen

Ein Data-Science-Team muss regelmäßig ein Modell zur Vorhersage von Kundenabwanderung neu trainieren. Sie richten eine Datenpipeline ein, um rohe Benutzeraktivitätsdaten aus der Datenbank ihrer Anwendung und Produktnutzungsprotokolle aus einem Cloud-Speicher-Bucket zu ziehen. Die Pipeline führt Feature-Engineering durch, indem sie die Rohdaten in aussagekräftige Merkmale wie 'letztes_anmeldedatum' und 'monatliche_transaktionsanzahl' umwandelt. Der verarbeitete, merkmalsreiche Datensatz wird dann versioniert und an einem Ort gespeichert, auf den ihre ML-Trainingsplattform zugreifen kann, um sicherzustellen, dass das Modell immer mit den neuesten, hochwertigen Daten trainiert wird.

3

Echtzeit-Datensynchronisation über Systeme hinweg

Ein E-Commerce-Unternehmen muss seine Bestandsdaten über seine Website, mobile App und sein Lagerverwaltungssystem (WMS) hinweg konsistent halten. Sie implementieren eine Echtzeit-Datenpipeline unter Verwendung einer Streaming-Plattform. Wenn ein Kunde eine Bestellung auf der Website aufgibt, wird ein Ereignis erfasst und durch die Pipeline gesendet. Die Pipeline aktualisiert sofort den Lagerbestand im WMS und spiegelt den neuen Lagerbestand sowohl auf der Website als auch in der mobilen App wider. Dies verhindert Überverkäufe und gewährleistet ein konsistentes Kundenerlebnis über alle Kanäle hinweg.

4

Migration von Daten in ein Cloud-Data-Warehouse

Ein Unternehmen wechselt von einer lokalen SQL Server-Datenbank zu einem cloudbasierten Data Warehouse wie Snowflake. Ein Dateningenieur verwendet ein Datenpipeline-Tool, um diese komplexe Migration zu verwalten. Die Pipeline ist so konfiguriert, dass sie zunächst einen historischen Massen-Upload aller vorhandenen Daten durchführt. Danach wechselt sie in einen inkrementellen Change Data Capture (CDC)-Modus, der kontinuierlich alle neuen oder aktualisierten Datensätze vom SQL Server nach Snowflake repliziert. Dies gewährleistet einen reibungslosen Übergang mit minimaler Ausfallzeit und garantiert die Datenkonsistenz zwischen dem alten und dem neuen System während des Migrationszeitraums.

5

Aggregation von Protokollen für die Sicherheitsanalyse

Ein Cybersicherheitsteam benötigt eine zentralisierte Ansicht aller System- und Anwendungsprotokolle zur Bedrohungserkennung. Sie setzen eine Datenpipeline ein, die Protokolle in Echtzeit von Webservern, Datenbanken und Firewalls sammelt. Die Pipeline analysiert die unstrukturierten Protokolldaten, standardisiert Zeitstempel und reichert sie mit Geolokalisierungsinformationen basierend auf IP-Adressen an. Die verarbeiteten Protokolle werden dann in ein Sicherheitsinformations- und Ereignis-Management-System (SIEM) gestreamt. Dies ermöglicht es Sicherheitsanalysten, komplexe Abfragen auszuführen, verdächtige Muster zu identifizieren und viel schneller auf Sicherheitsvorfälle zu reagieren.

6

Anreicherung von CRM-Daten mit Informationen von Drittanbietern

Ein Marketing-Operations-Team möchte das Lead-Scoring durch die Anreicherung seiner CRM-Kontakte verbessern. Sie verwenden ein Datenpipeline-Tool, um neue Leads aus ihrem Salesforce-CRM zu extrahieren. Die Pipeline sendet dann den Firmennamen jedes Leads an die API eines Drittanbieters (wie Clearbit), um firmografische Daten wie Unternehmensgröße und Branche abzurufen. Schließlich schreibt die Pipeline diese angereicherten Daten zurück in die entsprechenden Kontaktdatensätze in Salesforce. Dieser automatisierte Prozess liefert dem Vertriebsteam einen reichhaltigeren Kontext zu jedem Lead, was zu einer genaueren Priorisierung und effektiveren Kontaktaufnahme führt.

Datenpipeline FAQ

Was sind Datenpipeline-Tools?

Datenpipeline-Tools sind Softwareplattformen, die den Prozess des Verschiebens von Daten von einem Quellsystem zu einem Zielsystem automatisieren. Sie übernehmen alle dazwischenliegenden Schritte, einschließlich Extraktion, Transformation (Bereinigung, Formatierung, Anreicherung) und Laden. Im Gegensatz zur einfachen Datenübertragung orchestrieren diese Tools komplexe, mehrstufige Arbeitsabläufe, bieten Fehlerbehandlung und ermöglichen die Planung und Überwachung von Datenflüssen, was sie für eine zuverlässige Datenintegration und -analyse unerlässlich macht.

Wie unterscheiden sich Datenpipeline-Tools von ETL-Tools?

ETL (Extrahieren, Transformieren, Laden) ist ein spezifisches Muster einer Datenpipeline. Während alle ETL-Tools Datenpipelines erstellen, sind nicht alle Datenpipeline-Tools auf ETL beschränkt. Moderne Datenpipeline-Plattformen sind vielseitiger und können andere Muster wie ELT (Extrahieren, Laden, Transformieren), Reverse ETL (Synchronisierung von Daten aus einem Warehouse zurück in Geschäftsanwendungen) und Echtzeit-Datenstreaming unterstützen. Im Wesentlichen ist 'Datenpipeline' ein breiterer Begriff für die Orchestrierung von Datenbewegungen, während 'ETL' eine spezifische, traditionelle Methode dafür beschreibt.

Wer verwendet typischerweise Datenpipeline-Tools?

Die Hauptnutzer sind Dateningenieure, die diese Pipelines entwerfen, erstellen und warten. Mit dem Aufkommen von Low-Code- und No-Code-Plattformen nutzen jedoch auch andere Rollen sie zunehmend:

  • Datenanalysten: Um die Datenerfassung für ihre Berichte und Dashboards zu automatisieren.
  • Datenwissenschaftler: Um Pipelines zu erstellen, die saubere, aufbereitete Daten in ihre Modelle für maschinelles Lernen einspeisen.
  • Software-Ingenieure: Um Daten zwischen verschiedenen Microservices oder Anwendungen zu integrieren.
  • Marketing-/Vertriebsoperationen: Um Kundendaten zwischen CRMs, Marketing-Automatisierungsplattformen und anderen Geschäftstools zu synchronisieren.

Welche Schlüsselfunktionen sollte man bei einem Datenpipeline-Tool beachten?

Bei der Bewertung eines Datenpipeline-Tools sollten Sie sich auf diese kritischen Funktionen konzentrieren:

  • Konnektoren: Eine umfassende Bibliothek vorgefertigter Konnektoren für Ihre spezifischen Datenquellen (Datenbanken, APIs, SaaS-Apps) und Ziele (Data Warehouses, Lakes).
  • Skalierbarkeit: Die Fähigkeit, steigende Datenmengen und Verarbeitungskomplexität ohne Leistungseinbußen zu bewältigen.
  • Überwachung & Beobachtbarkeit: Dashboards, Protokolle und Alarmsysteme zur Verfolgung des Pipeline-Zustands, zur Identifizierung von Engpässen und zur schnellen Fehlerbehebung.
  • Benutzerfreundlichkeit: Eine intuitive Benutzeroberfläche (ob UI-basiert oder code-basiert), die dem technischen Kenntnisstand Ihres Teams entspricht.
  • Transformationsfähigkeiten: Unterstützung für die von Ihnen benötigte Daten-Transformationslogik, von einfachen SQL-Abfragen bis hin zu komplexem Python- oder Java-Code.

Kann KI in Datenpipelines verwendet werden?

Ja, KI und maschinelles Lernen werden zunehmend in moderne Datenpipeline-Tools integriert. KI kann zur Automatisierung komplexer Aufgaben wie Datenqualitätsprüfungen, Anomalieerkennung in Datenströmen und Schema-Mapping zwischen verschiedenen Systemen eingesetzt werden. Einige fortschrittliche Tools verwenden KI, um sensible Daten (PII) für Compliance-Zwecke automatisch zu erkennen und zu klassifizieren oder um die Pipeline-Leistung durch dynamische Ressourcenzuweisung basierend auf der Arbeitslast zu optimieren. Dieser Einsatz von KI macht Datenpipelines intelligenter, widerstandsfähiger und effizienter.