

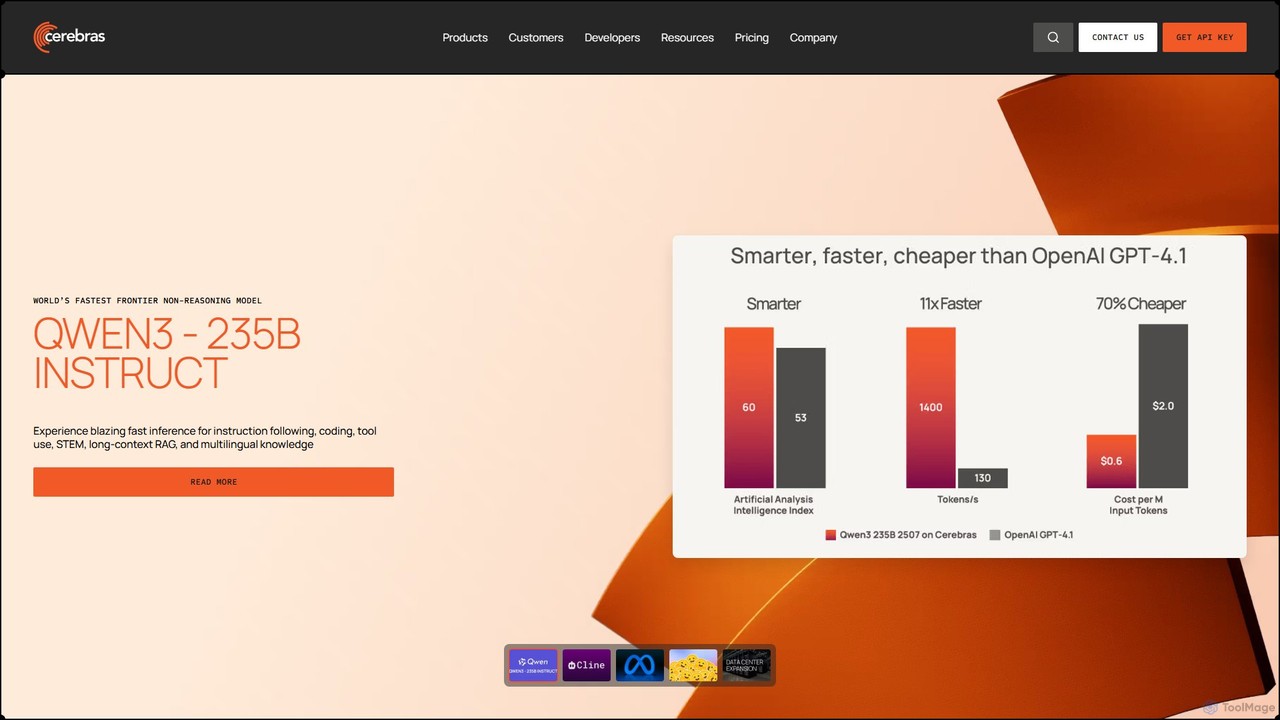
Cerebras Overview
Cerebras ist ein wegweisendes Unternehmen im Bereich KI-Hardware und Cloud-Dienste, bekannt für die Entwicklung des weltweit schnellsten KI-Prozessors, der Wafer Scale Engine (WSE). Diese einzigartige Technologie integriert die Leistung eines gesamten Silizium-Wafers in einem einzigen Chip und liefert eine Leistung, die herkömmliche GPU-Cluster nicht erreichen können. Cerebras stellt diese Leistung Entwicklern, Forschern und Unternehmen über seine KI-Modelldienste zur Verfügung und ermöglicht es ihnen, hochmoderne Modelle mit beispielloser Geschwindigkeit und Effizienz zu trainieren und bereitzustellen. Vertraut von führenden Organisationen wie Meta, der Mayo Clinic, AlphaSense und Notion, beschleunigt Cerebras die Zukunft der KI, von der Echtzeit-Unternehmenssuche und Marktintelligenz bis hin zu fortgeschrittener wissenschaftlicher Forschung und Patientenversorgung.
Wie man Cerebras verwendet
Cerebras bietet flexible Zugangsmodelle, die auf unterschiedliche Bedürfnisse zugeschnitten sind:
- Für Entwickler & Prototyping (Exploration Plan): Der einfachste Weg, um zu beginnen, ist über die serverlose API. Entwickler können sofortigen Zugriff auf beliebte Modelle über die Cerebras Inference Cloud, Hugging Face oder OpenRouter erhalten. Dies ist ein Pay-as-you-go-Modell, bei dem Sie nur für die von Ihnen genutzten Token bezahlen, was es perfekt für Tests, Prototyping und kleine Anwendungen ohne Mindestverpflichtung macht.
- Für Produktions-Workloads (Growth Plan): Teams mit wachsenden Anwendungen können sich für ein monatliches Abonnement entscheiden. Dieser Plan bietet höhere Ratenlimits, geringere Latenz durch Anfragenpriorität und frühen Zugriff auf neue Modelle. Er bietet vorhersehbare Kosten für die sichere Skalierung von Produktions-Workloads.
- Für groß angelegte Bereitstellungen (Enterprise Plan): Für geschäftskritische Anwendungen, regulierte Branchen oder Organisationen, die eine garantierte Leistung benötigen, bietet Cerebras eine umfassende Unternehmenslösung. Dazu gehören Optionen für die Bereitstellung von Cerebras-Hardware in der privaten Cloud oder vor Ort, Zugriff auf alle unterstützten Modelle, Feinabstimmungsdienste, die höchsten Ratenlimits und dedizierten White-Glove-Support mit garantierten SLAs. Um zu beginnen, können Unternehmen das Cerebras-Vertriebsteam kontaktieren, um eine maßgeschneiderte Lösung zu entwerfen.
Kernfunktionen von Cerebras
- Wafer Scale Engine (WSE): Der weltweit größte und schnellste KI-Prozessor, der massive Rechenleistung und Speicherbandbreite auf einem einzigen Chip bietet.
- Blitzschnelle Inferenz: Liefert branchenführende Inferenzgeschwindigkeiten, bis zu 20-mal schneller als GPU-Lösungen, wobei Benchmarks zeigen, dass Modelle wie Llama 4 Scout mit 2.600 Token pro Sekunde laufen.
- Ultra-niedrige Latenz: Ermöglicht Echtzeitanwendungen wie Konversations-KI, agentenbasierte Arbeitsabläufe und Live-Datenanalyse, oft mit Antworten in weniger als einer Sekunde.
- Flexible Bereitstellungsoptionen: Bietet serverlose API-, Private-Cloud- und On-Premises-Lösungen, um verschiedenen Sicherheits-, Leistungs- und Betriebsanforderungen gerecht zu werden.
- Zugriff auf hochmoderne Modelle: Bietet API-Zugriff auf die neuesten und leistungsstärksten Open-Source-Modelle, einschließlich Metas Llama 4, Alibabas Qwen3 und DeepSeek, oft am Tag ihrer Veröffentlichung.
- KI-Modelldienste: Umfassende Dienste für das Training und die Bereitstellung von Modellen, einschließlich Feinabstimmung für Unternehmenskunden zur Erstellung benutzerdefinierter, hochleistungsfähiger Modelle.
- Überlegenes Preis-Leistungs-Verhältnis: Durch die Kombination von extremer Geschwindigkeit mit wettbewerbsfähigen Preisen bietet Cerebras einen außergewöhnlichen Wert, insbesondere für Anwendungen, bei denen die Latenz entscheidend ist.
Anwendungsfälle für Cerebras
Die Hochleistungsplattform von Cerebras ist ideal für eine Vielzahl anspruchsvoller KI-Anwendungen:
- Unternehmenssuche & RAG: Unternehmen wie Notion und AlphaSense nutzen Cerebras, um echtzeitnahe, genaue Suchen und Retrieval-Augmented Generation (RAG) über riesige Datenmengen zu ermöglichen.
- Gesundheitswesen und Biowissenschaften: Die Mayo Clinic nutzt Cerebras, um die Patientenversorgung durch KI-gesteuerte Diagnose, Behandlungsplanung und medizinische Forschung zu transformieren.
- Echtzeit-Digitale-Zwillinge: Tavus nutzt Cerebras, um Echtzeit-Digitale-Zwillinge zu erstellen, die komplexe Simulationen und Interaktionen ermöglichen, die sofortige Reaktionen erfordern.
- Finanzdienstleistungen: Antreiben von KI-gesteuerter Marktintelligenz, Risikoanalyse und algorithmischem Handel, wo Geschwindigkeit einen Wettbewerbsvorteil bietet.
- Agenten-KI und Werkzeugnutzung: Die niedrige Latenz ist perfekt für die Erstellung anspruchsvoller KI-Agenten, die in Echtzeit schlussfolgern, Werkzeuge verwenden und mit Benutzern interagieren können.
- Regierung und Verteidigung: Ausgewählt von Organisationen wie DARPA für Echtzeit-Rechenplattformen der nächsten Generation für fortgeschrittene militärische und kommerzielle Anwendungen.
Vorteile von Cerebras
Der Hauptvorteil von Cerebras ist seine unübertroffene Geschwindigkeit. Durch die spezielle Entwicklung von Hardware für KI-Workloads umgeht die Wafer Scale Engine die Kommunikationsengpässe, die großen GPU-Clustern innewohnen. Dies führt zu drastisch geringerer Latenz und höherem Durchsatz. Diese Geschwindigkeit führt zu einem erheblichen Preis-Leistungs-Vorteil; während die Token-Kosten mit anderen Diensten vergleichbar sein mögen, erschließt der Wert des Echtzeit-Empfangs dieser Token neue Anwendungsfälle, die mit langsameren Anbietern unmöglich sind. Darüber hinaus machen seine flexiblen Bereitstellungsmodelle und Partnerschaften mit Branchenführern wie Meta und Hugging Face seine Spitzentechnologie einem breiten Publikum zugänglich, von einzelnen Entwicklern bis zu den größten Unternehmen der Welt.
Preise und Pläne
Cerebras bietet eine gestaffelte Preisstruktur, um unterschiedlichen Nutzungsumfängen gerecht zu werden:
- Exploration Plan (Pay-as-you-go): Ideal für den Einstieg. Die Preise gelten pro Million Token und variieren je nach Modell. Zum Beispiel: Llama 4 Scout kostet 0,65 $/Mio. Eingabe-Token und 0,85 $/Mio. Ausgabe-Token, während Qwen3 32B 0,40 $/Mio. Eingabe und 0,80 $/Mio. Ausgabe kostet. Keine Mindestverpflichtung.
- Growth Plan (Abonnement): Für Produktionsanwendungen. Monatliche Abonnements beginnen bei 1.500 $/Monat für Tier 1 und gehen bis zu 10.000 $/Monat oder mehr für höhere Tiers. Jede Stufe bietet ein festgelegtes Maximum an Token pro Minute/Tag und Anfragen pro Minute und bietet vorhersehbare Kosten. Zum Beispiel beginnt der Llama-3.3 70B-Plan bei 1.500 $/Monat für 300.000 Eingabe-Token/Min. und 41 Mio. Token/Tag.
- Enterprise Plan (Benutzerdefiniert): Maßgeschneidert für groß angelegte, geschäftskritische Bereitstellungen. Dieser Plan umfasst dedizierte Bereitstellungsoptionen, Modell-Feinabstimmung, die höchsten Leistungs-SLAs und Premium-Support. Die Preise sind individuell und auf Anfrage beim Vertriebsteam erhältlich.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 398.3K
- 2026-1: 655.0K
- 2026-2: 676.7K
- 2026-3: 609.2K
- 2026-4: 646.3K
- 2026-5: 817.3K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten69.0%
- 🇮🇳Indien11.4%
- 🇨🇳China7.0%
- 🇩🇪Deutschland6.6%
- 🇨🇦Kanada6.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 81.3% |
Referral | 16.9% |
Email | 1.8% |
Top keywords
| Keyword | Cost per click |
|---|---|
| cerebras | $1.10 |
| cerebras ai | $2.02 |
| cerebras api | $0.00 |
| cerebras systems | $1.26 |
| cerebras systems inc | $0.00 |
Cerebras Videos on YouTube



Charbax
Siosi AI
Cerebras Alternatives

PPIO
PPIO ist eine führende verteilte Cloud-Computing-Plattform, die kostengünstige, hochleistungsfähige KI-Rechenleistung, Modell-APIs und Edge-Computing-Dienste anbietet. Sie bietet Entwicklern und Unternehmen Komplettlösungen für KI-, Video- und Metaverse-Anwendungen, einschließlich serverloser GPUs, containerisierter Instanzen und Zugriff auf beliebte große Sprach- und multimodale Modelle.
Modell-Hosting
GPUX
GPUX ist eine serverlose, dezentrale GPU-Cloud-Plattform für schnelle und kostengünstige KI-Modellinferenz. Sie ermöglicht Entwicklern die Ausführung von Modellen über eine API und GPU-Besitzern, durch die Bereitstellung ihrer Hardware in einem P2P-Netzwerk Geld zu verdienen.
Modellbereitstellung
Vast.ai
Vast.ai ist eine führende GPU-Cloud-Plattform, die On-Demand-Zugriff auf ein riesiges Netzwerk von GPUs für KI- und Machine-Learning-Workloads bietet. Sie versorgt Entwickler und Unternehmen mit Hochleistungsrechnen zu deutlich geringeren Kosten – bis zu 80 % günstiger als herkömmliche Cloud-Anbieter – über einen transparenten Pay-as-you-go-Marktplatz.
GPU-Vermietung
OctoAI
OctoAI ist eine Hochleistungs-Rechenplattform für Entwickler, um generative KI-Modelle effizient auszuführen, anzupassen und zu skalieren. Sie bietet optimierte, produktionsreife API-Endpunkte für beliebte Open-Source-Modelle wie Llama, Mixtral und Stable Diffusion. Durch die Konzentration auf tiefgreifende Systemoptimierungen bietet OctoAI schnellere Inferenzgeschwindigkeiten und niedrigere Kosten, sodass Unternehmen skalierbare KI-Anwendungen erstellen und bereitstellen können, ohne komplexe Infrastrukturen verwalten zu müssen.
API
H2O.ai
H2O.ai ist eine End-to-End-KI-Cloud-Plattform für Unternehmen, die prädiktive und generative KI kombiniert. Sie ermöglicht es Unternehmen, sichere, leistungsstarke KI-Modelle und -Anwendungen in jeder Umgebung zu erstellen, bereitzustellen und zu verwalten, von der Cloud bis zum On-Premise-Betrieb. Die Plattform bietet AutoML, einen Feature Store, Document AI und ein robustes Modellrisikomanagement.
UnternehmenslösungenCerebras Categories
Cerebras Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
H2O.ai
H2O.ai ist eine End-to-End-KI-Cloud-Plattform für Unternehmen, die prädiktive und generative KI kombiniert. Sie ermöglicht es Unternehmen, sichere, leistungsstarke KI-Modelle und -Anwendungen in jeder Umgebung zu erstellen, bereitzustellen und zu verwalten, von der Cloud bis zum On-Premise-Betrieb. Die Plattform bietet AutoML, einen Feature Store, Document AI und ein robustes Modellrisikomanagement.
Unternehmenslösungen
Fluidstack
Fluidstack ist eine führende KI-Cloud-Plattform, die hochleistungsfähige, dedizierte GPU-Cluster für das Training und die Bereitstellung von Frontier-KI-Modellen anbietet. Sie ermöglicht den schnellen Einsatz von Tausenden von GPUs, vollständig verwaltete Dienste mit 24/7-Experten-Support und transparente Preise ohne Egress-Gebühren, um KI-Teams eine reibungslose Skalierung ohne Infrastrukturhürden zu ermöglichen.
Unternehmenslösungen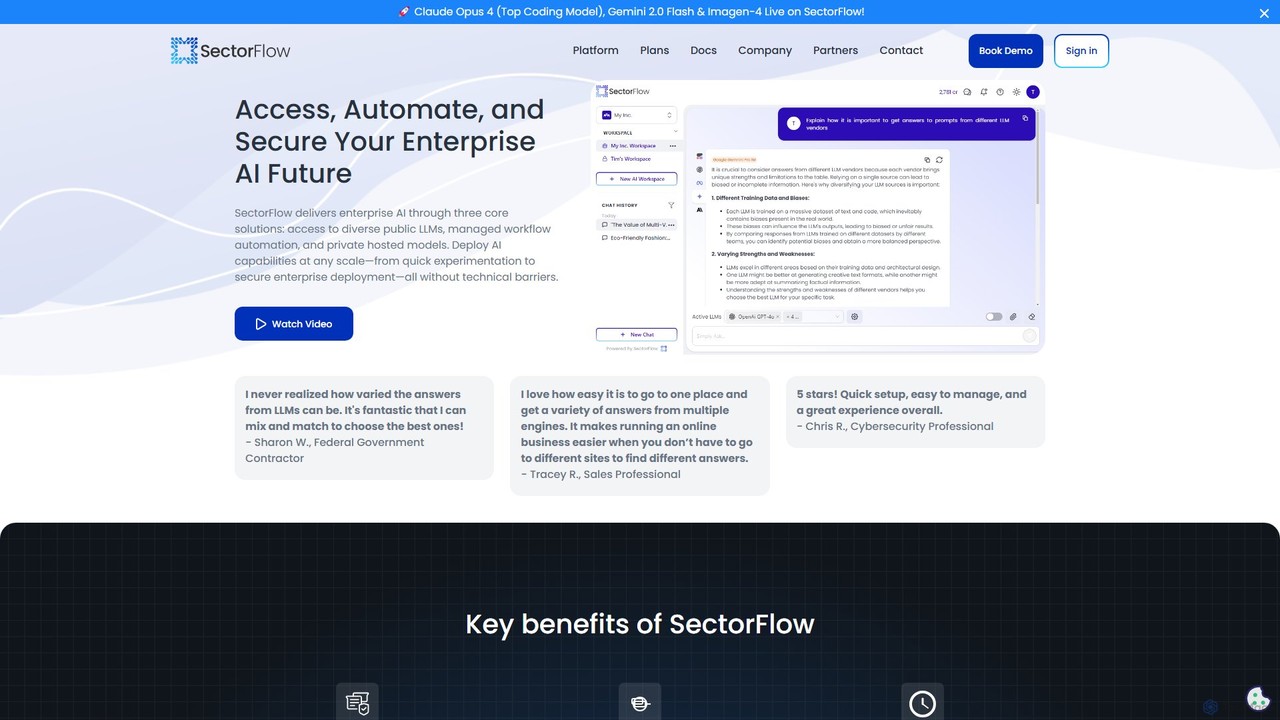
SectorFlow
SectorFlow ist eine sichere, unternehmenstaugliche KI-Plattform, die Zugriff auf verschiedene LLMs, verwaltete Workflow-Automatisierung und privat gehostete Modelle bietet. Sie ermöglicht es Unternehmen, KI-Fähigkeiten in jedem Maßstab einzusetzen, von Experimenten bis hin zur sicheren Unternehmensbereitstellung, ohne technische Hürden.
Unternehmenslösungen
Together AI
Together AI ist eine führende Cloud-Plattform für Entwickler, die eine schnelle und kostengünstige Infrastruktur zum Ausführen, Feinabstimmen und Trainieren von Open-Source-Generative-AI-Modellen bereitstellt. Sie bietet eine umfangreiche Bibliothek mit über 200 Modellen, serverlose Inferenz-APIs, anpassbares Fine-Tuning und dedizierte GPU-Cluster und schafft so eine End-to-End-Lösung für die Erstellung und Skalierung von KI-Anwendungen.
GPU-Infrastruktur
Vectorize
Vectorize ist eine RAG-as-a-Service-Plattform, die die Erstellung von KI-Anwendungen auf unstrukturierten Daten vereinfacht. Sie bietet verwaltete RAG-Pipelines, umfangreiche Datenquellen-Konnektoren und die Flexibilität, die verwaltete Vektordatenbank zu nutzen oder eine eigene anzubinden, sodass Entwickler produktionsreife KI-Lösungen schnell bereitstellen können.
Lappen
Anyscale
Anyscale ist eine vollständig verwaltete Rechenplattform zur Skalierung von KI- und Python-Workloads. Sie wurde von den ursprünglichen Entwicklern des Open-Source-Frameworks Ray entwickelt und ermöglicht es Entwicklern, verteilte Anwendungen – vom LLM-Training bis zur Datenverarbeitung – mit optimierter Leistung und Kosteneffizienz in jeder Cloud zu erstellen, auszuführen und zu skalieren.
MLOps
deepsense.ai
deepsense.ai ist ein führendes Unternehmen für KI-Beratung und kundenspezifische Softwareentwicklung. Sie sind darauf spezialisiert, maßgeschneiderte KI-Lösungen für Unternehmen zu entwickeln und nutzen dabei Expertise in LLMs, RAG, Computer Vision, MLOps und prädiktiver Analytik. Sie arbeiten mit Unternehmen und Start-ups zusammen, um KI in Produkte zu integrieren, Betriebsabläufe zu optimieren und durch fortschrittliche, produktionsreife KI-Systeme einen Wettbewerbsvorteil zu erzielen.
KI-Beratung
FuriosaAI
FuriosaAI entwickelt hochleistungsfähige, energieeffiziente KI-Beschleuniger für Rechenzentren. Das Flaggschiffprodukt RNGD ist für anspruchsvolle KI-Inferenzaufgaben konzipiert, insbesondere für große Sprachmodelle (LLMs). Mit der innovativen Tensor Contraction Processor (TCP)-Architektur liefert RNGD außergewöhnliche Leistung bei einem sehr geringen Stromverbrauch von 180 W, was die Gesamtbetriebskosten und die Umweltauswirkungen für Unternehmens- und Cloud-KI-Implementierungen erheblich reduziert.
Infrastruktur
Usedify
Usedify ist eine umfassende Lernplattform und ein praktischer Leitfaden zur Beherrschung der Implementierung und Wertschöpfung von Unternehmens-KI mithilfe des Dify-Frameworks. Es bietet Schritt-für-Schritt-Tutorials, reale Fallstudien und Best Practices für Entwickler und Unternehmen.
Tutorials
AI News Hub
AI News Hub ist eine umfassende Plattform, die Echtzeit-KI-Ankündigungen, kuratierte Blog-Updates zu agentischer KI, RAG und Produktionstools bereitstellt. Sie bietet einen personalisierten Feed, Lesezeichenfunktionen und eine reichhaltige Sammlung von Lernressourcen, einschließlich Roadmaps, Kursen und Videos, um Entwickler und Enthusiasten in der sich schnell entwickelnden KI-Landschaft auf dem Laufenden und kompetent zu halten.
Aggregation
LLM Models
LLM Models ist ein umfassendes Online-Verzeichnis und eine Vergleichsplattform für große Sprachmodelle und Grundmodelle. Es bietet detaillierte technische Spezifikationen, Benchmark-Leistung und Funktionsvergleiche, um Entwicklern, Forschern und Unternehmen bei der Auswahl der am besten geeigneten KI-Modelle für ihre Anforderungen zu helfen.
Modellverzeichnis
Nexa SDK
Nexa SDK ist ein leistungsstarkes Toolkit, das Entwicklern ermöglicht, jedes KI-Modell, einschließlich Frontier- und modernster Modelle, in wenigen Minuten auf jedem Gerät (mobil, PC, IoT, Automotive) bereitzustellen. Es bietet produktionsreife On-Device-Inferenz mit Hardwarebeschleunigung über NPUs, GPUs und CPUs, optimiert für Geschwindigkeit und Energieeffizienz.
Ai Development KitPPIO
PPIO ist eine führende verteilte Cloud-Computing-Plattform, die kostengünstige, hochleistungsfähige KI-Rechenleistung, Modell-APIs und Edge-Computing-Dienste anbietet. Sie bietet Entwicklern und Unternehmen Komplettlösungen für KI-, Video- und Metaverse-Anwendungen, einschließlich serverloser GPUs, containerisierter Instanzen und Zugriff auf beliebte große Sprach- und multimodale Modelle.
Modell-Hosting
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
AutomatisierungGPUX
GPUX ist eine serverlose, dezentrale GPU-Cloud-Plattform für schnelle und kostengünstige KI-Modellinferenz. Sie ermöglicht Entwicklern die Ausführung von Modellen über eine API und GPU-Besitzern, durch die Bereitstellung ihrer Hardware in einem P2P-Netzwerk Geld zu verdienen.
Modellbereitstellung
Cerebras Comments (0)
Sign in to comment.
AnmeldenNo comments yet.