

Hazy Overview
Hazy ist eine führende Plattform zur Erzeugung synthetischer Daten, die Organisationen dabei unterstützt, die Herausforderungen des Datenschutzes und der Datenzugänglichkeit zu meistern. In der heutigen datengesteuerten Welt sind viele der wertvollsten Daten einer Organisation oft aufgrund von Datenschutzbedenken, regulatorischen Einschränkungen (wie DSGVO, HIPAA, CCPA) und dem inhärenten Risiko von Datenlecks gesperrt. Hazy löst dieses Problem, indem es modernste generative KI-Modelle verwendet, um statistisch repräsentative, aber vollständig künstliche Datensätze zu erstellen. Diese synthetischen Daten spiegeln die Muster, Korrelationen und Eigenschaften der Originaldaten wider, ohne jegliche echten personenbezogenen Daten (PII) zu enthalten, was es Teams ermöglicht, frei zu arbeiten und schneller zu innovieren.
Die Plattform basiert auf dem Prinzip der differentiellen Privatsphäre und bietet eine mathematische Garantie für die Privatsphäre des Einzelnen. Das bedeutet, dass durch die Analyse der synthetischen Daten nichts Spezifisches über eine Person im ursprünglichen Datensatz gelernt werden kann. Dieser robuste Datenschutz ermöglicht es Unternehmen in sensiblen Sektoren wie Finanzen, Gesundheitswesen und Telekommunikation, ihre Datenbestände sicher und ethisch zu nutzen.
Wie man Hazy verwendet
Die Verwendung von Hazy umfasst einen unkomplizierten, optimierten Prozess, der sowohl für Datenwissenschaftler als auch für Entwickler konzipiert ist:
- Mit der Datenquelle verbinden: Verbinden Sie Hazy sicher mit Ihrer Datenbank, Ihrem Data Warehouse oder Ihrem Data Lake, wo die sensiblen Produktionsdaten liegen. Die Plattform unterstützt eine breite Palette von Datenquellen und -formaten.
- Generierung konfigurieren: Definieren Sie die Parameter für die Datensynthese. Benutzer können spezifische Datenschutzstufen festlegen (z. B. Epsilon-Werte für differentielle Privatsphäre) und die Tabellen oder Spalten auswählen, die sie synthetisieren möchten.
- KI-Modelltraining: Die generativen Modelle von Hazy lernen automatisch die komplexen statistischen Muster, Verteilungen und Beziehungen in Ihren Quelldaten. Dieser Prozess findet in einer sicheren Umgebung statt, ohne die Rohdaten preiszugeben.
- Synthetische Daten erzeugen: Sobald das Modell trainiert ist, können Sie einen synthetischen Datensatz beliebiger Größe erzeugen. Dieser neue Datensatz ist strukturell identisch mit dem Original, enthält aber völlig neue, künstliche Datenpunkte.
- Validieren und verwenden: Hazy bietet Nützlichkeits- und Qualitätsberichte, um die synthetischen Daten mit dem Original zu vergleichen und sicherzustellen, dass sie für den Zweck geeignet sind. Die datenschutzsicheren Daten können dann in der gesamten Organisation für Analysen, das Training von maschinellen Lernmodellen, Softwaretests oder die Erstellung von Produktdemos geteilt werden.
Kernfunktionen von Hazy
- Hochwertige synthetische Daten: Erzeugt statistisch identische Daten, die komplexe Korrelationen und Zeitreihenabhängigkeiten bewahren, was sie für fortgeschrittene Analysen und das Training von ML-Modellen sehr nützlich macht.
- Garantien für differentielle Privatsphäre: Implementiert modernste Techniken der differentiellen Privatsphäre, um ein mathematisch nachweisbares Maß an Anonymität zu bieten und sicherzustellen, dass die Daten vor Re-Identifikationsangriffen geschützt sind.
- Skalierbarkeit für Unternehmen: Entwickelt, um große und komplexe Datensätze zu verarbeiten, sodass Organisationen synthetische Daten in großem Maßstab erzeugen können.
- Breite Unterstützung von Datentypen: Kann verschiedene Datentypen synthetisieren, einschließlich tabellarischer, sequentieller und Zeitreihendaten, um unterschiedlichen Geschäftsanforderungen gerecht zu werden.
- Daten-Nützlichkeits- und Qualitätsmetriken: Bietet umfassende Berichte zur Bewertung der Qualität der synthetischen Daten, um sicherzustellen, dass sie für den beabsichtigten Anwendungsfall eine hohe Nützlichkeit behalten.
- Einhaltung von Vorschriften: Hilft Organisationen, wichtige Datenschutzvorschriften wie DSGVO, CCPA und HIPAA einzuhalten, indem die Abhängigkeit von echten PII beseitigt wird.
- Nahtlose Integration: Bietet APIs und Konnektoren für eine einfache Integration in bestehende Datenpipelines, MLOps-Workflows und Cloud-Umgebungen.
Anwendungsfälle für Hazy
Hazy ist vielseitig und bietet in zahlreichen Branchen einen Mehrwert:
- Finanzdienstleistungen: Training von Betrugserkennungsalgorithmen, Durchführung von Risikomodellierungen und Personalisierung von Produkten ohne Verwendung sensibler Kundendaten.
- Gesundheitswesen: Erleichterung der medizinischen Forschung und Arzneimittelentwicklung durch die gemeinsame Nutzung synthetischer Patientendaten, die statistische Eigenschaften bewahren, ohne die Identität der Patienten preiszugeben.
- Softwareentwicklung & QA: Erzeugung realistischer und komplexer Testdaten für Softwaretests und Qualitätssicherung, wodurch die Risiken der Verwendung von Produktionsdaten in Entwicklungsumgebungen eliminiert werden.
- Einzelhandel: Analyse von Kundenverhaltensmustern, Optimierung von Lieferketten und Vorhersage der Nachfrage mithilfe datenschutzsicherer Versionen von Transaktionsdaten.
- Telekommunikation: Vorhersage von Kundenabwanderung und Optimierung der Netzwerkleistung mit synthetischen Daten, die aus Benutzeraktivitätsprotokollen abgeleitet werden.
Vorteile von Hazy
Durch die Einführung von Hazy verschaffen sich Organisationen einen erheblichen Wettbewerbsvorteil:
- Gefangene Daten freisetzen: Sichere Nutzung sensibler Datensätze, die aufgrund von Datenschutzbeschränkungen bisher unzugänglich waren.
- Innovationszyklen beschleunigen: Drastische Verkürzung der Zeit für die Bereitstellung von Daten für Datenwissenschafts- und Entwicklungsteams von Monaten auf Minuten.
- Datenleckrisiken mindern: Beseitigung des Risikos, sensible Kunden- oder Patientendaten im Falle eines Sicherheitsvorfalls preiszugeben.
- Datenkollaboration verbessern: Ermöglicht den sicheren Datenaustausch mit internen Teams, externen Partnern und Forschern, ohne die Privatsphäre zu gefährden.
- Kosteneffiziente Compliance: Reduziert die Komplexität und die Kosten, die mit herkömmlichen Anonymisierungsmethoden und der Navigation durch rechtliche Genehmigungen für den Datenzugriff verbunden sind.
Preise und Pläne
Hazy ist eine unternehmenstaugliche Lösung, deren Preise auf die spezifischen Bedürfnisse einer Organisation zugeschnitten sind, wie z. B. Datenvolumen, Komplexität und Bereitstellungsmodell. Preisinformationen werden nicht öffentlich aufgeführt. Um ein individuelles Angebot zu erhalten, müssen sich Interessenten an das Hazy-Vertriebsteam wenden oder eine Demo über die offizielle Website anfordern.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2026-1: 145.6K
- 2026-2: 117.1K
- 2026-3: 124.3K
- 2026-4: 105.0K
- 2026-5: 133.7K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten53.0%
- 🇮🇳Indien14.3%
- 🇬🇧Vereinigtes Königreich12.6%
- 🇰🇷Südkorea11.4%
- 🇨🇦Kanada8.7%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 76.3% |
Referral | 22.0% |
Email | 1.7% |
Top keywords
| Keyword | Cost per click |
|---|---|
| animeobt | $3.22 |
| domain agents | $5.30 |
| domainagents | $2.99 |
| typlace.com | $0.00 |
| vp520.net | $0.00 |
Hazy Videos on YouTube
Kominami Beat

Kominami Beat

Switched On Pop
High and Hazy Podcast
Hazy Alternatives
Amplitude
Amplitude ist eine führende digitale Analyseplattform, die KI nutzt, um Unternehmen dabei zu helfen, das Nutzerverhalten zu verstehen, Produkte zu optimieren und das Wachstum zu fördern. Sie bietet eine einheitliche Lösung für Produktanalysen, Session Replays, A/B-Tests und Feature-Management, die es Teams ermöglicht, datengesteuerte Entscheidungen zu treffen und bessere Kundenerlebnisse zu schaffen.
Analysen
MOSTLY AI
MOSTLY AI ist eine Datenintelligenz-Plattform, die sich auf die Erzeugung hochwertiger, datenschutzkonformer synthetischer Daten spezialisiert hat. Sie ermöglicht es Organisationen, sicher auf Daten zuzugreifen, sie zu analysieren und zu teilen, wodurch die KI-Innovation beschleunigt und Arbeitsabläufe optimiert werden, während die vollständige Einhaltung der Datenschutzbestimmungen gewährleistet ist.
Maschinelles Lernen
Openlayer
Openlayer ist eine unternehmenstaugliche Plattform für KI-Evaluierung und Beobachtbarkeit. Sie ermöglicht es Teams, sowohl traditionelle maschinelle Lernmodelle als auch große Sprachmodelle (LLMs) über ihren gesamten Lebenszyklus hinweg zu testen, zu überwachen und zu steuern – von der Entwicklung bis zur Produktion – und gewährleistet so Zuverlässigkeit und Compliance.
Analysen
Hubble
Hubble ist eine All-in-One, KI-gestützte Nutzerforschungsplattform für Unternehmensteams. Sie ermöglicht schnelle Einblicke, indem sie den gesamten Forschungsprozess von der Studienerstellung über die Teilnehmerrekrutierung bis zur Feedback-Analyse optimiert. Die Plattform unterstützt verschiedene Methoden wie Prototyp-Tests, Umfragen und Card Sorting und nutzt KI, um Ergebnisse zusammenzufassen und Entscheidungen zu beschleunigen.
Analysen
Gretel
Gretel ist eine fortschrittliche Plattform für synthetische Daten, die für die KI-Entwicklung konzipiert wurde. Sie ermöglicht Entwicklern und Datenwissenschaftlern, hochpräzise, datenschutzkonforme künstliche Datensätze zu generieren, die reale Daten nachahmen. Dies ermöglicht robustes KI-Modelltraining, Tests und Datenaustausch, ohne sensible Informationen zu gefährden oder Datenschutzbestimmungen wie die DSGVO und CCPA zu verletzen.
Synthetische DatenHazy Categories
Hazy Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
MOSTLY AI
MOSTLY AI ist eine Datenintelligenz-Plattform, die sich auf die Erzeugung hochwertiger, datenschutzkonformer synthetischer Daten spezialisiert hat. Sie ermöglicht es Organisationen, sicher auf Daten zuzugreifen, sie zu analysieren und zu teilen, wodurch die KI-Innovation beschleunigt und Arbeitsabläufe optimiert werden, während die vollständige Einhaltung der Datenschutzbestimmungen gewährleistet ist.
Maschinelles LernenGretel
Gretel ist eine fortschrittliche Plattform für synthetische Daten, die für die KI-Entwicklung konzipiert wurde. Sie ermöglicht Entwicklern und Datenwissenschaftlern, hochpräzise, datenschutzkonforme künstliche Datensätze zu generieren, die reale Daten nachahmen. Dies ermöglicht robustes KI-Modelltraining, Tests und Datenaustausch, ohne sensible Informationen zu gefährden oder Datenschutzbestimmungen wie die DSGVO und CCPA zu verletzen.
Synthetische Daten
GoMask
GoMask ist eine KI-gestützte Plattform, die die Softwareentwicklung beschleunigt, indem sie sofortige, konforme und realistische Testdaten durch fortschrittliche Datenmaskierung und synthetische Datengenerierung bereitstellt. Sie eliminiert Engpässe, gewährleistet die Einhaltung gesetzlicher Vorschriften und integriert sich nahtlos in moderne CI/CD-Pipelines.
Datenmaskierung
Artivatic
Artivatic ist eine KI-native SaaS-Plattform, die entwickelt wurde, um die Versicherungs- und Gesundheitsbranche zu revolutionieren. Sie bietet End-to-End-Lösungen, von intelligenter Risikoprüfung und automatisierter Schadensbearbeitung bis hin zu personalisierter Produktgestaltung und Kunden-Onboarding. Durch den Einsatz von KI, ML und einem robusten API-Gateway ermöglicht Artivatic Versicherern, Maklern und Gesundheitsdienstleistern, den Betrieb zu digitalisieren, die Effizienz zu steigern und ein überlegenes Kundenerlebnis zu bieten.
API
syntheticAIdata
syntheticAIdata ist eine fortschrittliche Plattform zur Erzeugung hochwertiger, perfekt annotierter synthetischer Daten in großem Maßstab für KI-Modelle der Computer Vision. Es bietet eine No-Code-Lösung, die Unternehmen dabei hilft, die Kosten für die Datenbeschaffung zu senken, Datenschutzbedenken zu beseitigen, Verzerrungen zu mindern und die Entwicklung und Bereitstellung von KI-Produkten in Branchen wie Fertigung, Robotik und Einzelhandel erheblich zu beschleunigen.
Computer Vision
Syntaccx
Eine All-in-One No-Code Computer-Vision-Plattform, die synthetische Trainingsdaten aus CAD/3D-Modellen generiert. Sie ermöglicht es Anwendern, robuste KI-Visionsmodelle in Minuten zu erstellen, zu trainieren und bereitzustellen, was Kosten und Entwicklungszeit erheblich reduziert, ohne tiefes Fachwissen zu erfordern.
Modellierung
Neosync
Neosync ist eine Open-Source-Plattform zur Datenanonymisierung und Generierung synthetischer Daten. Sie hilft Entwicklern und Datenwissenschaftlern, sichere, datenschutzkonforme und realistische Datensätze für Tests, Entwicklung und das Training von KI-Modellen zu erstellen und gewährleistet dabei die referenzielle Integrität über Datenbanken hinweg.
Datengenerierung
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
deid
Ein KI-gestütztes Tool von Segmed zur De-Identifizierung medizinischer Daten. Es verwendet NLP und Sprachmodelle, um geschützte Gesundheitsinformationen (PHI) aus klinischen Texten automatisch zu erkennen und zu entfernen, um Datenschutz und Compliance für die medizinische Forschung und den Datenaustausch zu gewährleisten.
Datenschutz
Ketch
Eine umfassende Plattform für Datenschutz und KI-Governance. Ketch hilft Unternehmen, die Einhaltung von Vorschriften wie DSGVO und CCPA zu automatisieren, die Zustimmung der Nutzer zu verwalten und Daten verantwortungsvoll für Wachstum zu nutzen. Es bietet Werkzeuge für DSR-Automatisierung, Daten-Mapping und Risikobewertungen.
Datenmanagement
Tonic.ai
Tonic.ai ist eine KI-gestützte Plattform zur Generierung hochwertiger, realistischer und sicherer synthetischer Daten. Sie hilft Software- und KI-Ingenieuren, die Entwicklung zu beschleunigen, die Einhaltung von Vorschriften (DSGVO, HIPAA) sicherzustellen und Tests zu verbessern, indem sie Produktionsdaten nachahmt, ohne sensible Informationen preiszugeben. Die Suite umfasst Werkzeuge für die Synthese von strukturierten, unstrukturierten und von Grund auf neu erstellten Daten.
Synthetische Daten
RagaAI
RagaAI ist eine umfassende KI-Test- und Beobachtbarkeitsplattform, die Entwicklern und Unternehmen hilft, zuverlässige KI-Anwendungen zu erstellen. Sie bietet eine Reihe von Werkzeugen zur Beobachtung, Bewertung und Fehlerbehebung von KI-Agenten, LLMs und RAG-Systemen. Zu den Hauptfunktionen gehören agentenbasiertes Testen, Echtzeit-Leitplanken (Guardrails), die Generierung synthetischer Daten und Feinabstimmungsfunktionen. RagaAI unterstützt multimodale Daten (LLMs, Computer Vision, tabellarische Daten) und zielt darauf ab, den gesamten Lebenszyklus der KI-Qualitätssicherung zu automatisieren, von der Problemerkennung bis zur Lösung, um robuste und vertrauenswürdige KI-Implementierungen zu gewährleisten.
Analysen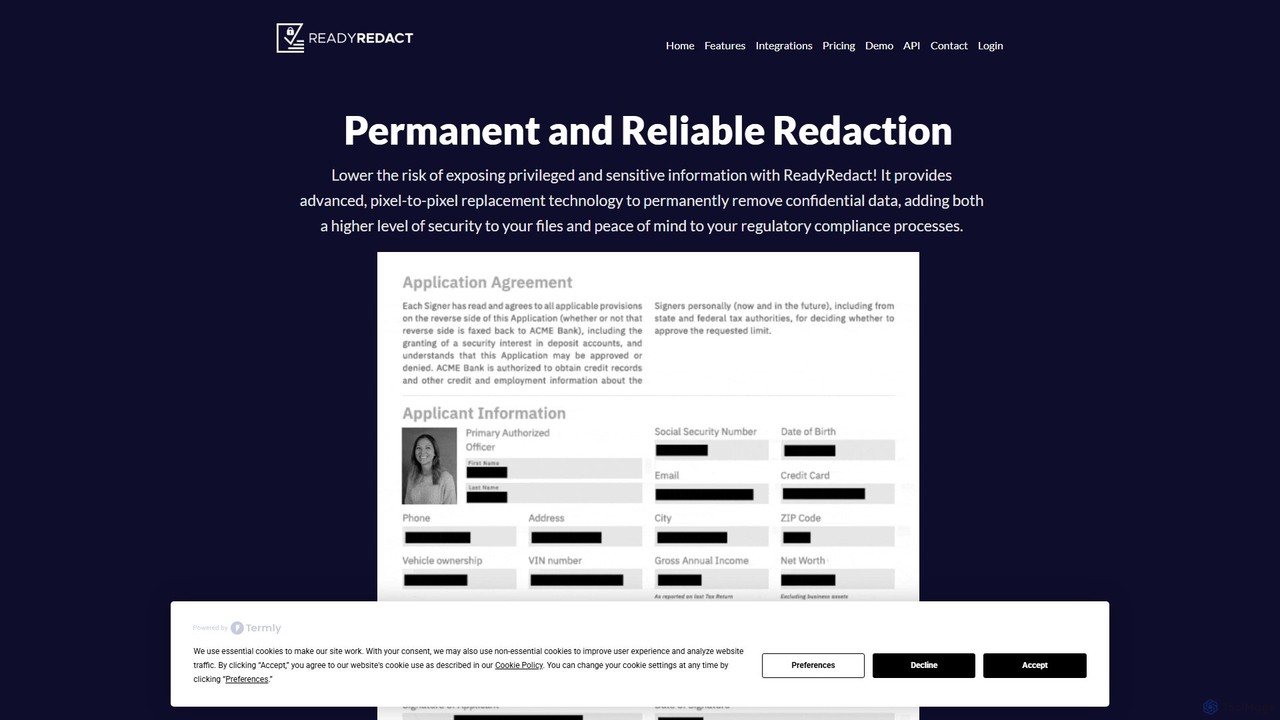
ReadyRedact
ReadyRedact ist eine KI-gestützte, cloudbasierte Software zur automatisierten Schwärzung von Dokumenten. Sie entfernt sensible und vertrauliche Informationen dauerhaft aus Dokumenten mithilfe fortschrittlicher Pixel-zu-Pixel-Ersetzungstechnologie und gewährleistet so Sicherheit und Einhaltung von Vorschriften in Branchen wie Gesundheitswesen, Recht und Finanzen. Es bietet flexible Pläne, einschließlich einer kostenlosen Stufe, um Datenschutz-Workflows zu optimieren.
Compliance
QuarkIQL
Eine ehemalige generative Testplattform für Computer-Vision-APIs, die es Entwicklern ermöglichte, benutzerdefinierte synthetische Bilder und API-Anfragen zu erstellen, um Test-Workflows zu optimieren. Bitte beachten Sie: Dieses Tool ist nicht mehr verfügbar.
MLOps
iDox.ai
iDox.ai ist eine unternehmenstaugliche, KI-gestützte Lösung für die Dokumenten-Compliance, die entwickelt wurde, um die Erkennung, Schwärzung, Extraktion und den Vergleich sensibler Daten zu automatisieren. Sie hilft Organisationen, die Einhaltung von Vorschriften wie DSGVO, HIPAA und CCPA zu optimieren, das Risiko von Datenpannen zu mindern und die betriebliche Effizienz durch den Schutz personenbezogener Daten (PII) und geschützter Gesundheitsinformationen (PHI) in zahlreichen Dateitypen erheblich zu verbessern.
Compliance
Hazy Comments (0)
Sign in to comment.
AnmeldenNo comments yet.