

ParadeDB Overview
ParadeDB positioniert sich als eine leistungsstarke, moderne Alternative zu Elasticsearch, die speziell für die nahtlose Integration in das PostgreSQL-Ökosystem entwickelt wurde. Es verwandelt eine Standard-Postgres-Datenbank in eine hochleistungsfähige Such- und Analyse-Engine, die für echtzeitnahe, update-intensive Workloads konzipiert ist. Die Kernmission von ParadeDB ist es, Entwicklungsteams von der Komplexität und dem Aufwand zu befreien, die mit der Skalierung, Verwaltung und Synchronisierung eines separaten Elasticsearch-Clusters verbunden sind. Durch die direkte Integration von Such- und Analysefunktionen in Postgres vereinfacht es den Daten-Stack, reduziert die Betriebskosten und eliminiert häufige Datenkonsistenzprobleme.
Als Open-Source-Projekt hat ParadeDB in der Entwicklergemeinschaft erheblich an Zugkraft gewonnen, was durch Tausende von GitHub-Sternen und über hunderttausend Docker-Deployments belegt wird. Es wird von einer Vielzahl von Unternehmen, von schnell wachsenden Startups wie Bilt Rewards und Modern Treasury bis hin zu Fortune-500-Unternehmen wie Alibaba Cloud, für den Betrieb geschäftskritischer Anwendungen geschätzt.
Wie man ParadeDB verwendet
Der Einstieg in ParadeDB ist für Entwickler, die mit Postgres vertraut sind, unkompliziert gestaltet. Es gibt zwei primäre Bereitstellungsmethoden:
- Docker-Container: Der schnellste Weg, ParadeDB zu testen und auszuführen, ist über das offizielle Docker-Image. Ein einfacher Befehl genügt, um eine neue Instanz zu starten:
docker run --name paradedb -e POSTGRES_PASSWORD=password paradedb/paradedb
Nach dem Start können Sie sich mit jedem Standard-Postgres-Client wie `psql` damit verbinden. - Postgres-Erweiterung: Für bestehende, selbstverwaltete Postgres-Datenbanken kann ParadeDB als Standarderweiterung installiert werden. Dies ermöglicht es Ihnen, Ihre aktuelle Datenbank mit den Funktionen von ParadeDB zu erweitern, ohne Daten in ein neues System migrieren zu müssen. Es integriert sich in die internen Mechanismen von Postgres, wie die logische Replikation, und kann so als hochleistungsfähige Lesereplika fungieren, die anspruchsvolle Such- und Analyseabfragen von Ihrer primären Datenbank auslagert.
Nach der Installation interagieren Sie mit ParadeDB über Standard-Postgres-SQL. Es ist nicht notwendig, eine neue Abfragesprache wie die Query DSL von Elasticsearch zu lernen. Sie können Suchindizes erstellen und komplexe, gefilterte und facettierte Abfragen mit der vertrauten SQL-Syntax ausführen.
Kernfunktionen von ParadeDB
- Erweiterte Volltextsuche: Geht über die integrierte Suche von Postgres hinaus und bietet Funktionen wie BM25-Relevanzbewertung, benutzerdefinierte Tokenizer, Fuzzy-Matching, Phrasenabfragen und komplexe boolesche Logik.
- Hochleistungsanalyse: Bietet Unterstützung für schnelle analytische Abfragen und Facettierung, angetrieben von einem spaltenorientierten Index. Dies ist ideal für die Erstellung von Dashboards, Echtzeit-Einblicks-Panels und Drill-Down-Explorationen.
- Zero ETL & Echtzeit-Synchronisation: Durch die Nutzung der nativen logischen Replikation von Postgres bleibt ParadeDB in Echtzeit perfekt mit Ihrer primären Datenquelle synchronisiert, was komplexe und anfällige ETL-Pipelines (z. B. Kafka, Debezium) überflüssig macht.
- ACID-Konformität: Erbt die ACID-Garantien von Postgres, was bedeutet, dass Daten nach einer erfolgreichen Schreibtransaktion sofort und konsistent durchsuchbar sind.
- Vereinfachter Betrieb: Integriert sich in den Vacuum-Prozess von Postgres zur automatischen Bereinigung veralteter Indizes und nutzt das robuste Ökosystem von Postgres für Backups, Hochverfügbarkeit und Notfallwiederherstellung.
- Standard-SQL-Schnittstelle: Alle Funktionen sind über den Standard-Postgres-SQL-Dialekt zugänglich, was die Lernkurve senkt und vorhandenes Team-Know-how nutzt.
Anwendungsfälle für ParadeDB
ParadeDB ist in anspruchsvollen Produktionsumgebungen für verschiedene Anwendungen praxiserprobt:
- Bilt Rewards: Die Wohnungsprämienplattform setzte ParadeDB als logische Replik ihrer primären Postgres-Datenbank ein. Dies entlastete ihre teuersten facettierten und Fuzzy-Suchabfragen, was zu einer Reduzierung der Abfrage-Timeouts um 95 % und einer Senkung der P95-Abfragelatenz um 50 % führte.
- Alibaba Cloud: Der Technologieriese wählte ParadeDB, um leistungsstarke Volltextsuchfunktionen in sein Postgres-basiertes Data Warehouse zu integrieren und riesige Datenmengen mit hoher Leistung zu verarbeiten.
- Modern Treasury: Die Zahlungsabwicklungs-API verwendet ParadeDB, um die Suche über Finanztransaktionsdaten zu ermöglichen. Sie profitieren von der Transaktionssicherheit, der relationalen Natur und der perfekten Synchronisation, die für Finanzanwendungen entscheidend sind.
- Allgemeine Unternehmensanwendungen: Jede Anwendung, die auf Postgres aufbaut und eine anspruchsvolle Suche (z. B. E-Commerce-Produktkataloge, Log-Analyse, Content-Management-Systeme) oder Echtzeit-Analyse-Dashboards erfordert, kann von ParadeDB profitieren.
Vorteile von ParadeDB
Der Hauptvorteil von ParadeDB ist seine native Integration mit Postgres, was zu mehreren entscheidenden Vorteilen führt:
- Vereinfachter Daten-Stack: Konsolidiert Ihre Datenbank und Suchmaschine in einem einzigen System, was die Infrastrukturkomplexität und den Betriebsaufwand reduziert.
- Garantierte Datenkonsistenz: Eliminiert das Risiko von Datenverlust oder veralteten Suchergebnissen, die durch fehlerhafte Synchronisationen zwischen Postgres und einer externen Suchmaschine verursacht werden.
- Niedrigere Gesamtbetriebskosten: Reduziert die Kosten, die mit der Lizenzierung, Verwaltung und Skalierung eines separaten Elasticsearch-Clusters verbunden sind.
- Gesteigerte Entwicklerproduktivität: Ermöglicht Entwicklern die Verwendung einer einzigen, vertrauten Abfragesprache (SQL) für alle Datenoperationen, was die Entwicklungszyklen beschleunigt.
- Überlegene Zuverlässigkeit: Baut auf der bewährten Zuverlässigkeit, Stabilität und dem ausgereiften Ökosystem von Postgres für Funktionen wie Backups und Hochverfügbarkeit auf.
Preise und Pläne
ParadeDB arbeitet nach einem Freemium-, Open-Core-Modell. Die Kerntechnologie ist Open-Source und kostenlos nutzbar, verfügbar als Postgres-Erweiterung oder Docker-Image. Dies ist ideal für Entwickler, Startups und für die Selbstverwaltung der Software. Für Unternehmen, die erweiterte Funktionen, dedizierten Support oder eine vollständig verwaltete Cloud-Lösung benötigen, bietet ParadeDB kommerzielle Pläne an. Interessenten werden gebeten, sich für eine Demo und individuelle Preisinformationen an das Vertriebsteam zu wenden.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 34.0K
- 2026-1: 36.3K
- 2026-2: 33.5K
- 2026-3: 53.2K
- 2026-4: 32.9K
- 2026-5: 35.6K
Geography
Top 5 countries / regions
- 🇺🇸Vereinigte Staaten36.3%
- 🇧🇷Brasilien22.4%
- 🇮🇳Indien16.7%
- 🇨🇦Kanada12.8%
- 🇹🇭Thailand11.8%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 85.8% |
Referral | 13.2% |
Email | 1.0% |
Top keywords
| Keyword | Cost per click |
|---|---|
| parade db | $0.00 |
| paradedb | $4.55 |
| paradedb vector search | $0.00 |
| pg search | $0.17 |
| tantivy | $0.00 |
ParadeDB Alternatives
Xata
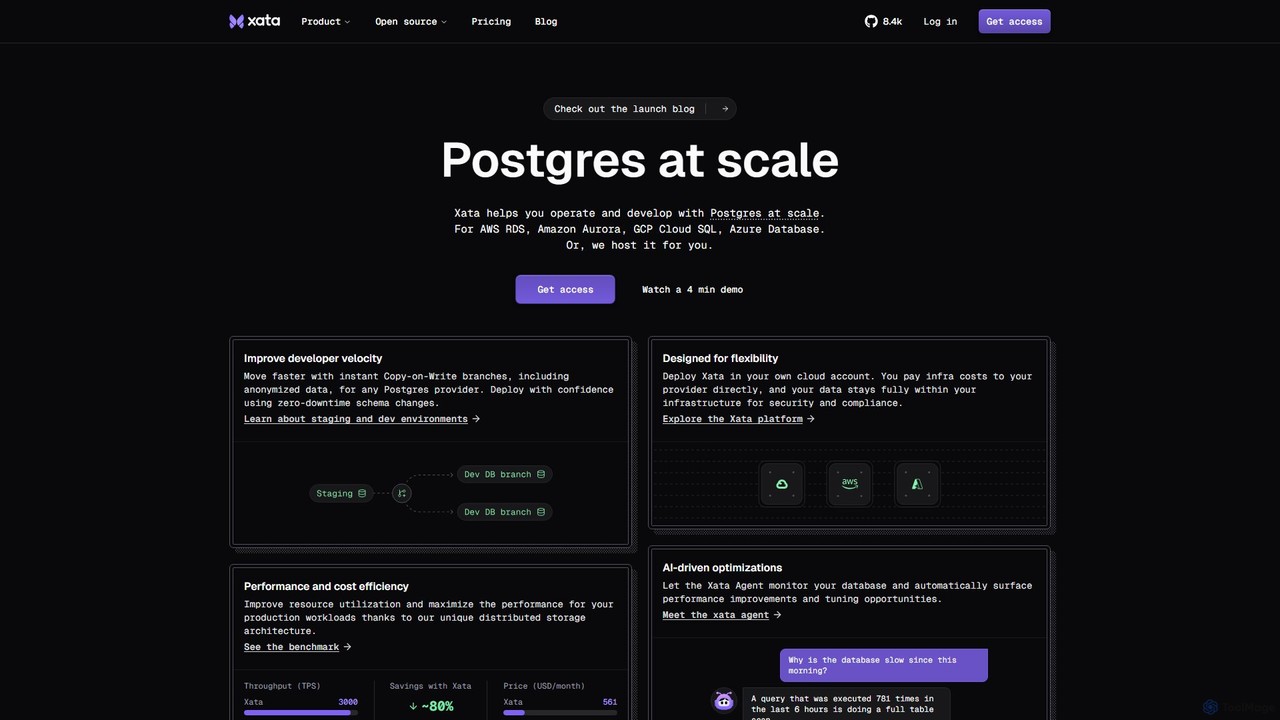
Xata ist eine „Postgres at scale“-Plattform, die entwickelt wurde, um die Entwicklergeschwindigkeit zu erhöhen und die Datenbankleistung zu optimieren. Sie bietet einzigartige Funktionen wie sofortige Copy-on-Write-Branches mit PII-Anonymisierung, Zero-Downtime-Schema-Migrationen und einen KI-gestützten Agenten für automatisches Performance-Tuning. Stellen Sie es auf der Xata-Infrastruktur oder in Ihrer eigenen Cloud bereit, um maximale Flexibilität und Compliance zu gewährleisten.
Datenbankoptimierung
TiDB Cloud
TiDB Cloud ist eine vollständig verwaltete, verteilte SQL-Datenbank-as-a-Service (DBaaS). Sie bietet horizontale Skalierbarkeit, MySQL-Kompatibilität und HTAP-Fähigkeiten (Hybrid Transactional/Analytical Processing). Ideal für die Entwicklung moderner, datenintensiver Anwendungen und KI-gestützter Dienste, vereinfacht sie den Datenbankbetrieb und bietet ein leistungsstarkes Backend für Anwendungen, die sowohl Echtzeittransaktionen als auch komplexe Analysen, einschließlich Vektorsuche für KI, erfordern.
Vektordatenbank
InfluxData
InfluxData bietet InfluxDB, die führende Zeitreihen-Datenbankplattform, die für Echtzeitdaten und KI-Anwendungen entwickelt wurde. Sie ermöglicht Entwicklern, riesige Mengen an Hochgeschwindigkeitsdaten aus IoT, Anwendungen und Infrastruktur zu erfassen, zu speichern und zu analysieren. Mit hochleistungsfähigen Abfragen, überlegener Datenkompression und nahtloser Integration in Data Lakes und KI/ML-Pipelines ist InfluxData der Motor für Anomalieerkennung, vorausschauende Wartung und autonome Systeme.
Datenmanagement
ChartDB
ChartDB ist ein KI-gestützter Datenbank-Schema-Visualisierer, der interaktive ER-Diagramme sofort aus einer einzigen Abfrage generiert. Er wurde für Entwickler und Teams entwickelt, um Datenbankstrukturen zu entwerfen, zu dokumentieren und gemeinsam daran zu arbeiten. Er bietet Echtzeit-Kollaboration, Datenbanksynchronisierung und einen KI-Assistenten zur Optimierung des Schema-Designs. Es sind sowohl Cloud- als auch selbst gehostete Open-Source-Versionen verfügbar.
Visualisierung
Vanna.AI
Vanna.AI ist ein personalisierter Open-Source-KI-SQL-Agent, der Fragen in natürlicher Sprache in präzise SQL-Abfragen umwandelt. Es verwendet ein Retrieval-Augmented Generation (RAG)-Modell, das auf Ihrem spezifischen Datenbankschema, Ihrer Dokumentation und früheren Abfragen trainiert wurde, um eine hohe Genauigkeit bei komplexen Datensätzen zu erzielen. Es ist auf Sicherheit, Flexibilität und einfache Integration in jede Anwendung ausgelegt und befähigt sowohl technische als auch nicht-technische Benutzer, mühelos Einblicke aus ihren Daten zu gewinnen.
Business IntelligenceParadeDB Categories
ParadeDB Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Meilisearch
Meilisearch ist eine Open-Source, blitzschnelle und KI-gestützte Suchmaschine. Sie wurde für Entwickler konzipiert, um fortschrittliche Suchfunktionen, einschließlich Volltext-, semantischer und hybrider Suche, einfach in jede Website oder Anwendung zu integrieren. Sie bietet eine außergewöhnliche Entwicklererfahrung mit leistungsstarken APIs und SDKs.
DatenbankInfluxData
InfluxData bietet InfluxDB, die führende Zeitreihen-Datenbankplattform, die für Echtzeitdaten und KI-Anwendungen entwickelt wurde. Sie ermöglicht Entwicklern, riesige Mengen an Hochgeschwindigkeitsdaten aus IoT, Anwendungen und Infrastruktur zu erfassen, zu speichern und zu analysieren. Mit hochleistungsfähigen Abfragen, überlegener Datenkompression und nahtloser Integration in Data Lakes und KI/ML-Pipelines ist InfluxData der Motor für Anomalieerkennung, vorausschauende Wartung und autonome Systeme.
DatenmanagementChartDB
ChartDB ist ein KI-gestützter Datenbank-Schema-Visualisierer, der interaktive ER-Diagramme sofort aus einer einzigen Abfrage generiert. Er wurde für Entwickler und Teams entwickelt, um Datenbankstrukturen zu entwerfen, zu dokumentieren und gemeinsam daran zu arbeiten. Er bietet Echtzeit-Kollaboration, Datenbanksynchronisierung und einen KI-Assistenten zur Optimierung des Schema-Designs. Es sind sowohl Cloud- als auch selbst gehostete Open-Source-Versionen verfügbar.
VisualisierungVanna.AI
Vanna.AI ist ein personalisierter Open-Source-KI-SQL-Agent, der Fragen in natürlicher Sprache in präzise SQL-Abfragen umwandelt. Es verwendet ein Retrieval-Augmented Generation (RAG)-Modell, das auf Ihrem spezifischen Datenbankschema, Ihrer Dokumentation und früheren Abfragen trainiert wurde, um eine hohe Genauigkeit bei komplexen Datensätzen zu erzielen. Es ist auf Sicherheit, Flexibilität und einfache Integration in jede Anwendung ausgelegt und befähigt sowohl technische als auch nicht-technische Benutzer, mühelos Einblicke aus ihren Daten zu gewinnen.
Business Intelligence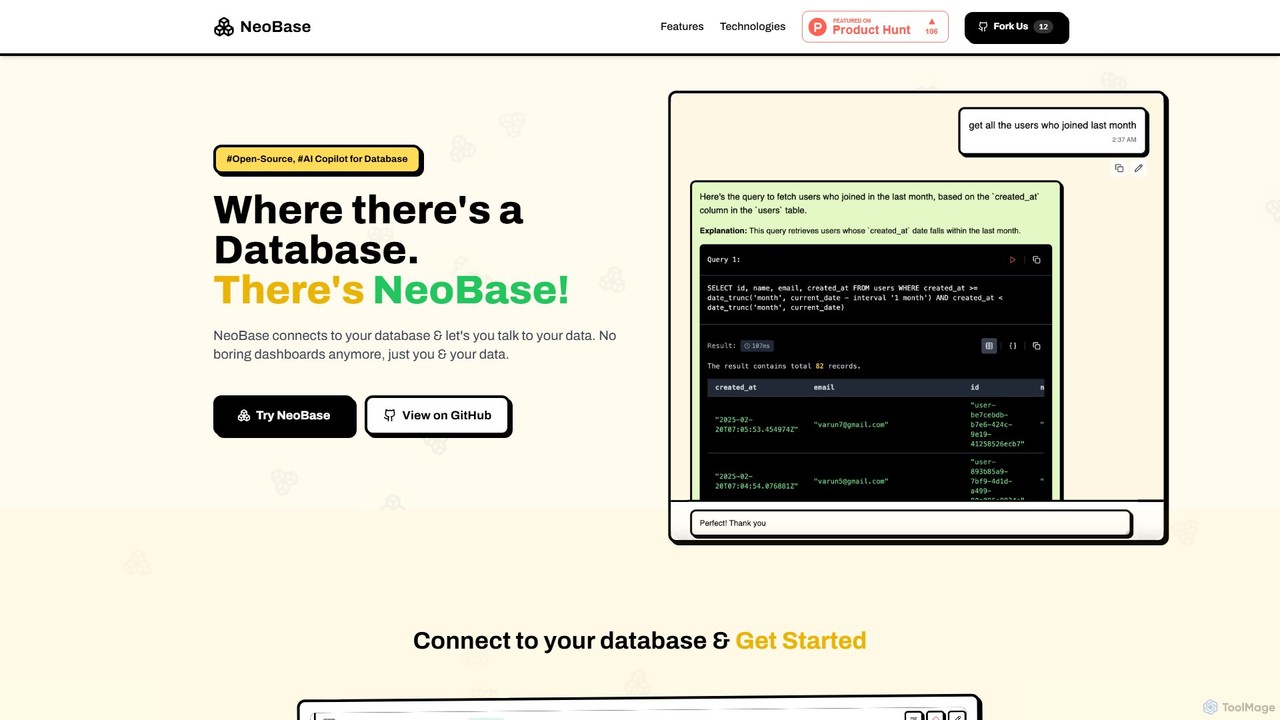
NeoBase
NeoBase ist ein Open-Source-KI-Copilot für Datenbanken, der es Benutzern ermöglicht, mit ihren Daten in natürlicher Sprache zu interagieren. Er verbindet sich mit verschiedenen SQL- und NoSQL-Datenbanken, übersetzt einfache englische Abfragen in optimierten Code und visualisiert die Ergebnisse. Entwickelt für technische und nicht-technische Benutzer, optimiert es die Datenanalyse, das Debugging und die Berichterstattung, eliminiert die Notwendigkeit, komplexe Abfragen zu schreiben, und bietet volle Datenkontrolle durch Self-Hosting.
Datenanalyse
SQL Chat
SQL Chat ist ein Open-Source, chatbasierter SQL-Client und -Editor, der KI verwendet, um Fragen in natürlicher Sprache in SQL-Abfragen zu übersetzen. Verbinden Sie sich mit Ihrer Datenbank, stellen Sie Fragen auf Deutsch und erhalten Sie sofort Ergebnisse, was den Datenzugriff für technische und nicht-technische Benutzer demokratisiert.
Code-Assistent
Supabase
Supabase ist eine Open-Source-Alternative zu Firebase und bietet eine komplette Backend-Lösung auf Basis von Postgres. Es bietet eine Reihe von Tools, darunter eine Datenbank, Authentifizierung, sofortige APIs, Edge-Funktionen, Echtzeit-Abonnements, Speicher und Vektor-Embeddings, um die Anwendungsentwicklung vom Prototyp bis zur Produktion zu beschleunigen.
Backend
Jyek
Jyek ist eine KI-Agenten-Plattform, die Ziele versteht, Ausführungspläne erstellt, Werkzeuge nutzt und überprüfbare Ergebnisse für komplexe, mehrstufige Aufgaben liefert.
Automatisierung
Milvus
Milvus ist eine leistungsstarke Open-Source-Vektordatenbank, die für KI-Anwendungen entwickelt wurde. Sie ermöglicht Entwicklern, Milliarden von hochdimensionalen Vektoren mit minimaler Latenz zu verwalten und zu durchsuchen. Ideal für den Aufbau skalierbarer Systeme wie Retrieval-Augmented Generation (RAG), Empfehlungssysteme und semantische Suche, bietet Milvus flexible Bereitstellungsoptionen vom lokalen Prototyping bis hin zu großen verteilten Clustern.
Maschinelles Lernen
LanceDB
LanceDB ist ein Open-Source, KI-natives multimodales Lakehouse, das für die Erstellung und Skalierung von KI-Anwendungen entwickelt wurde. Es bietet eine einheitliche Plattform zum Speichern, Suchen und Verwalten komplexer Daten wie Text, Bilder, Sprache und Vektoren. Ideal für RAG, semantische Suche und Modelltraining, bietet LanceDB eine blitzschnelle hybride Suche, massive Skalierbarkeit bis in den Petabyte-Bereich und erhebliche Kosteneinsparungen, was es zu einer leistungsstarken Grundlage für unternehmenstaugliche KI macht.
Vektordatenbank
MindsDB
MindsDB ist eine KI-Datenautomatisierungsplattform, die maschinelles Lernen in Ihre Datenbank bringt. Sie ermöglicht Entwicklern und Datenanalysten, KI-Modelle mit Standard-SQL-Abfragen zu erstellen, zu trainieren und bereitzustellen und sich mit über 200 Datenquellen zu verbinden, um Echtzeit-Vorhersagen und -Analysen ohne komplexe ETL-Pipelines zu liefern.
Business Intelligence
Spice AI
Spice AI ist eine quelloffene, portable Daten- und KI-Compute-Engine für Entwickler. Sie vereinheitlicht Daten aus beliebigen Quellen, beschleunigt Abfragen mit Apache Arrow und integriert KI-Modell-Serving sowie Vektorsuche, um die Erstellung hochleistungsfähiger, datengesteuerter Anwendungen zu vereinfachen.
Modellbereitstellung
Postgres Sandbox
Ein intuitives, webbasiertes visuelles Werkzeug zum Entwerfen, Prototyping und Experimentieren mit PostgreSQL-Datenbankschemata. Erstellen Sie Tabellen, definieren Sie Beziehungen und generieren Sie SQL-Code in einer risikofreien Sandbox-Umgebung. Ideal für Entwickler, DBAs und Studenten.
Datenbank
nao
nao ist ein KI-gestützter Code-Editor für Datenteams. Er optimiert die Erstellung von SQL- und Python-Datenpipelines, dbt-Workflows und Analysen durch native Anbindung an Ihr Data Warehouse. Sein intelligenter Agent liefert datenbewusste Code-Vorschläge, Qualitätsprüfungen und sofortige Diff-Vorschauen, um Ihnen zu helfen, Daten schneller und sicherer bereitzustellen.
Analysen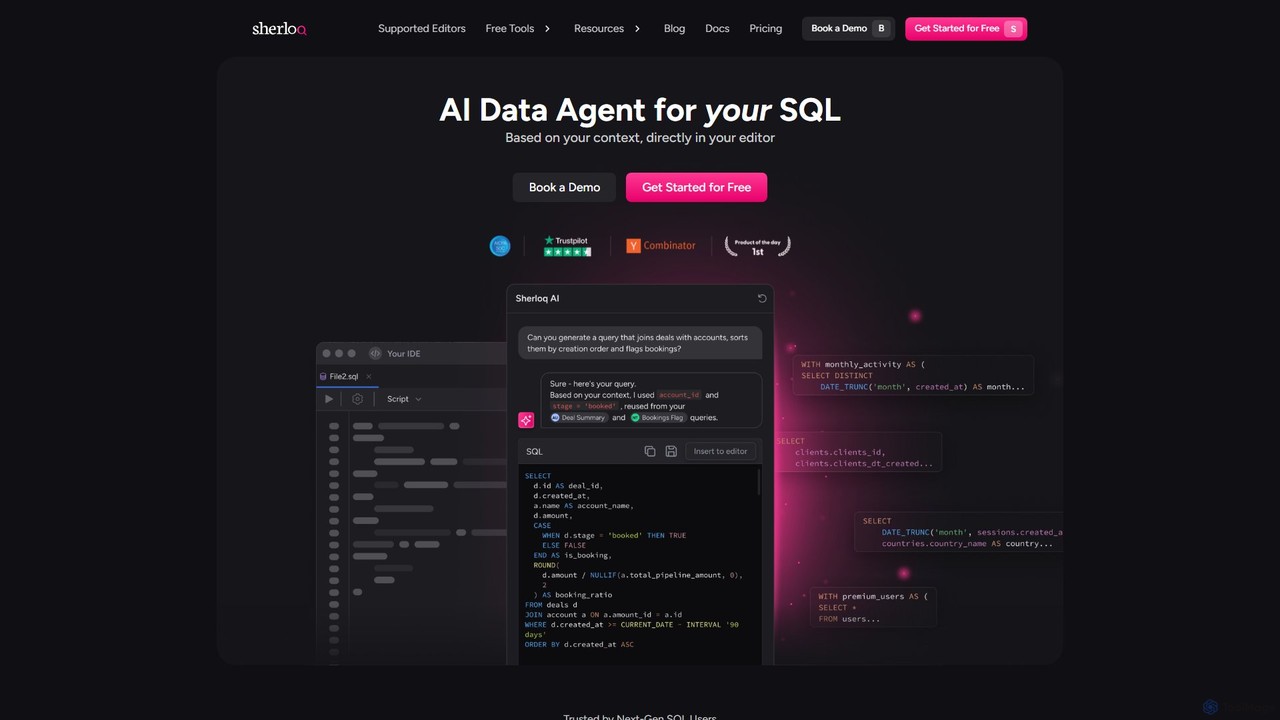
sherloqdata
Sherloqdata ist ein KI-gestützter Datenagent für SQL, der direkt in Ihrem Editor arbeitet. Er hilft Datenexperten, SQL-Abfragen schneller zu schreiben, zu korrigieren und zu verwalten, indem er Ihr bestehendes SQL-Repository als Kontext verwendet. Zu den Funktionen gehören ein KI-SQL-Chat, Abfragemanagement, Versionskontrolle und Teamzusammenarbeit.
Datenbank
ParadeDB Comments (0)
Sign in to comment.
AnmeldenNo comments yet.