

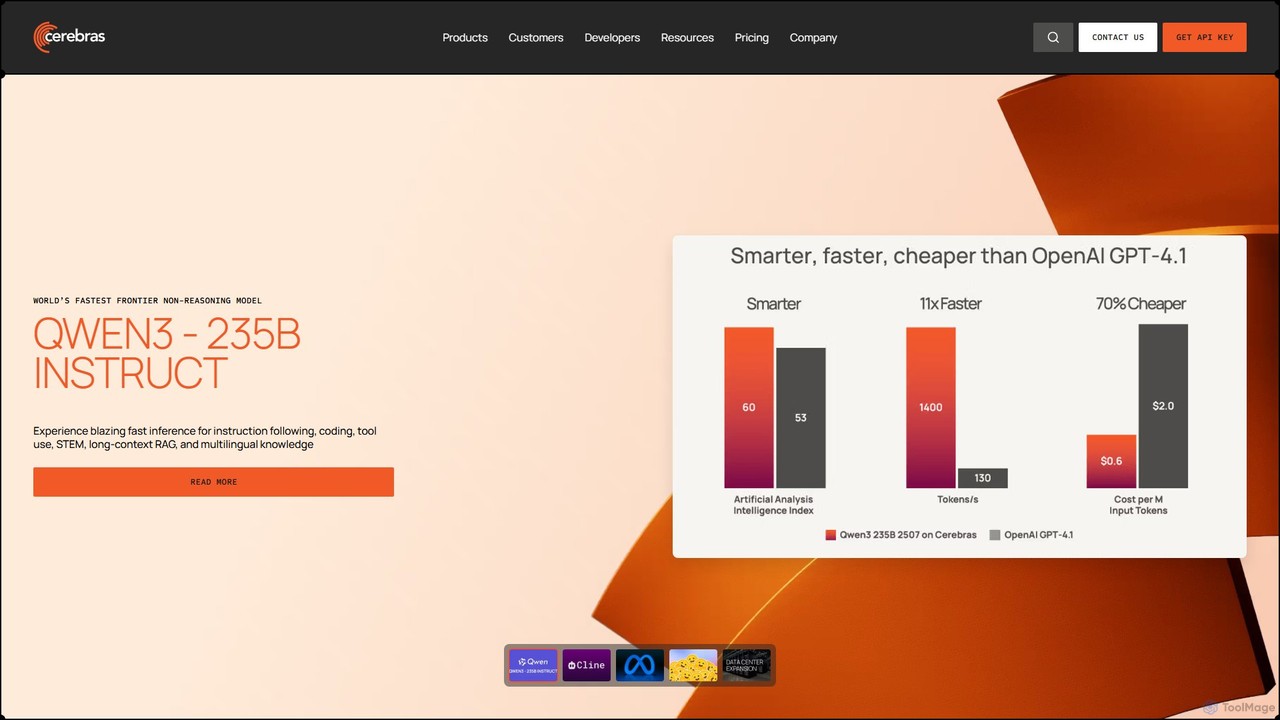
Cerebras Overview
Cerebras es una empresa pionera en el sector de hardware de IA y servicios en la nube, reconocida por desarrollar el procesador de IA más rápido del mundo, el Wafer Scale Engine (WSE). Esta tecnología única integra la potencia de una oblea de silicio completa en un solo chip, ofreciendo un rendimiento que los clústeres de GPU tradicionales no pueden igualar. Cerebras pone esta potencia a disposición de desarrolladores, investigadores y empresas a través de sus Servicios de Modelos de IA, permitiéndoles entrenar e implementar modelos de última generación con una velocidad y eficiencia sin precedentes. Con la confianza de organizaciones líderes como Meta, Mayo Clinic, AlphaSense y Notion, Cerebras está acelerando el futuro de la IA, desde la búsqueda empresarial en tiempo real y la inteligencia de mercado hasta la investigación científica avanzada y la atención al paciente.
Cómo usar Cerebras
Cerebras ofrece modelos de acceso flexibles adaptados a diferentes necesidades:
- Para desarrolladores y prototipado (Plan Exploration): La forma más fácil de empezar es a través de la API sin servidor. Los desarrolladores pueden obtener acceso instantáneo a modelos populares a través de la Nube de Inferencia de Cerebras, Hugging Face u OpenRouter. Se trata de un modelo de pago por uso, en el que solo pagas por los tokens que utilizas, lo que lo hace perfecto para pruebas, prototipado y aplicaciones a pequeña escala sin ningún compromiso mínimo.
- Para cargas de trabajo de producción (Plan Growth): Los equipos con aplicaciones en crecimiento pueden optar por una suscripción mensual. Este plan proporciona límites de tasa más altos, menor latencia gracias a la prioridad de las solicitudes y acceso anticipado a nuevos modelos. Ofrece costes predecibles para escalar las cargas de trabajo de producción con confianza.
- Para despliegues a gran escala (Plan Enterprise): Para aplicaciones de misión crítica, industrias reguladas u organizaciones que requieren un rendimiento garantizado, Cerebras ofrece una solución empresarial integral. Esto incluye opciones para el despliegue en la nube privada o en las propias instalaciones del hardware de Cerebras, acceso a todos los modelos compatibles, servicios de ajuste fino, los límites de tasa más altos y soporte premium con SLAs garantizados. Para empezar, las empresas pueden ponerse en contacto con el equipo de ventas de Cerebras para diseñar una solución a medida.
Características principales de Cerebras
- Wafer Scale Engine (WSE): El procesador de IA más grande y rápido del mundo, que proporciona una enorme potencia de cálculo y ancho de banda de memoria en un solo chip.
- Inferencia ultrarrápida: Ofrece velocidades de inferencia líderes en la industria, hasta 20 veces más rápidas que las soluciones de GPU, con benchmarks que muestran modelos como Llama 4 Scout funcionando a 2.600 tokens por segundo.
- Latencia ultrabaja: Permite aplicaciones en tiempo real como IA conversacional, flujos de trabajo de agentes y análisis de datos en vivo, a menudo devolviendo respuestas en menos de un segundo.
- Opciones de despliegue flexibles: Ofrece API sin servidor, nube privada y soluciones locales para adaptarse a diversos requisitos de seguridad, rendimiento y operativos.
- Acceso a modelos de última generación: Proporciona acceso API a los modelos de código abierto más recientes y potentes, incluidos Llama 4 de Meta, Qwen3 de Alibaba y DeepSeek, a menudo el mismo día de su lanzamiento.
- Servicios de modelos de IA: Servicios integrales tanto para el entrenamiento como para la implementación de modelos, incluido el ajuste fino para clientes empresariales para crear modelos personalizados de alto rendimiento.
- Relación precio-rendimiento superior: Al combinar una velocidad extrema con precios competitivos, Cerebras ofrece un valor excepcional, especialmente para aplicaciones donde la latencia es crítica.
Casos de uso para Cerebras
La plataforma de alto rendimiento de Cerebras es ideal para una amplia gama de aplicaciones de IA exigentes:
- Búsqueda empresarial y RAG: Empresas como Notion y AlphaSense utilizan Cerebras para potenciar la búsqueda en tiempo real y precisa y la generación aumentada por recuperación (RAG) sobre vastos conjuntos de datos.
- Salud y ciencias de la vida: Mayo Clinic aprovecha Cerebras para transformar la atención al paciente a través del diagnóstico, la planificación del tratamiento y la investigación médica impulsados por IA.
- Gemelos digitales en tiempo real: Tavus utiliza Cerebras para construir gemelos digitales en tiempo real, permitiendo simulaciones e interacciones complejas que requieren respuestas instantáneas.
- Servicios financieros: Impulsando la inteligencia de mercado, el análisis de riesgos y el trading algorítmico impulsados por IA, donde la velocidad proporciona una ventaja competitiva.
- IA de agentes y uso de herramientas: La baja latencia es perfecta para construir sofisticados agentes de IA que pueden razonar, usar herramientas e interactuar con los usuarios en tiempo real.
- Gobierno y defensa: Seleccionado por organizaciones como DARPA para plataformas de computación en tiempo real de próxima generación para aplicaciones militares y comerciales avanzadas.
Ventajas de Cerebras
La principal ventaja de Cerebras es su velocidad inigualable. Al diseñar hardware específicamente para cargas de trabajo de IA, el Wafer Scale Engine evita los cuellos de botella de comunicación inherentes a los grandes clústeres de GPU. Esto se traduce en una latencia drásticamente menor y un mayor rendimiento. Esta velocidad se traduce en una ventaja significativa en la relación precio-rendimiento; aunque los costes por token pueden ser comparables a los de otros servicios, el valor de recibir esos tokens en tiempo real desbloquea nuevos casos de uso que son imposibles con proveedores más lentos. Además, sus modelos de despliegue flexibles y sus asociaciones con líderes de la industria como Meta y Hugging Face hacen que su tecnología de vanguardia sea accesible a un público amplio, desde desarrolladores individuales hasta las empresas más grandes del mundo.
Precios y planes
Cerebras ofrece una estructura de precios por niveles para adaptarse a diferentes escalas de uso:
- Plan Exploration (Pago por uso): Ideal para empezar. El precio es por millón de tokens y varía según el modelo. Por ejemplo: Llama 4 Scout cuesta 0,65 $/M de tokens de entrada y 0,85 $/M de tokens de salida, mientras que Qwen3 32B cuesta 0,40 $/M de entrada y 0,80 $/M de salida. Sin compromiso mínimo.
- Plan Growth (Suscripción): Para aplicaciones de producción. Las suscripciones mensuales comienzan en 1.500 $/mes para el Nivel 1 y llegan hasta 10.000 $/mes o más para niveles superiores. Cada nivel proporciona un máximo establecido de tokens por minuto/día y solicitudes por minuto, ofreciendo costes predecibles. Por ejemplo, el plan Llama-3.3 70B comienza en 1.500 $/mes para 300k tokens de entrada/min y 41M de tokens/día.
- Plan Enterprise (Personalizado): Diseñado para despliegues a gran escala y de misión crítica. Este plan incluye opciones de despliegue dedicado, ajuste fino de modelos, los SLAs de rendimiento más altos y soporte premium. El precio es personalizado y está disponible contactando al equipo de ventas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 398.3K
- 2026-1: 655.0K
- 2026-2: 676.7K
- 2026-3: 609.2K
- 2026-4: 646.3K
- 2026-5: 817.3K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos69.0%
- 🇮🇳India11.4%
- 🇨🇳China7.0%
- 🇩🇪Alemania6.6%
- 🇨🇦Canadá6.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 81.3% |
Referral | 16.9% |
Email | 1.8% |
Top keywords
| Keyword | Cost per click |
|---|---|
| cerebras | $1.10 |
| cerebras ai | $2.02 |
| cerebras api | $0.00 |
| cerebras systems | $1.26 |
| cerebras systems inc | $0.00 |
Cerebras Videos on YouTube



Charbax
Siosi AI
Cerebras Alternatives

PPIO
PPIO es una plataforma líder de computación en la nube distribuida que proporciona potencia de cómputo de IA, API de modelos y servicios de computación de borde rentables y de alto rendimiento. Ofrece a desarrolladores y empresas soluciones integrales para aplicaciones de IA, video y metaverso, con GPU sin servidor, instancias en contenedores y acceso a populares modelos de lenguaje grandes y multimodales.
Alojamiento de Modelos
GPUX
GPUX es una plataforma de nube GPU descentralizada y sin servidor para una inferencia de modelos de IA rápida y asequible. Permite a los desarrolladores ejecutar modelos a través de API y a los propietarios de GPU ganar dinero contribuyendo con su hardware a una red P2P.
Despliegue de Modelo
Vast.ai
Vast.ai es una plataforma líder de nube de GPU que ofrece acceso bajo demanda a una vasta red de GPUs para cargas de trabajo de IA y aprendizaje automático. Proporciona a desarrolladores y empresas computación de alto rendimiento a costos significativamente más bajos, hasta un 80% menos que los proveedores de nube tradicionales, a través de un mercado transparente de pago por uso.
Alquiler de GPU
OctoAI
OctoAI es una plataforma de computación de alto rendimiento para que los desarrolladores ejecuten, ajusten y escalen modelos de IA generativa de manera eficiente. Ofrece puntos de conexión de API optimizados y listos para producción para modelos populares de código abierto como Llama, Mixtral y Stable Diffusion. Al centrarse en optimizaciones profundas del sistema, OctoAI proporciona velocidades de inferencia más rápidas y costos más bajos, permitiendo a las empresas construir y desplegar aplicaciones de IA escalables sin gestionar una infraestructura compleja.
API
H2O.ai
H2O.ai es una plataforma de nube de IA de extremo a extremo para empresas, que combina IA predictiva y generativa. Permite a las empresas construir, desplegar y gestionar modelos y aplicaciones de IA seguros y de alto rendimiento en cualquier entorno, desde la nube hasta las instalaciones locales. La plataforma cuenta con AutoML, un Feature Store, Document AI y una sólida Gestión de Riesgos de Modelos.
Soluciones EmpresarialesCerebras Categories
Cerebras Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
H2O.ai
H2O.ai es una plataforma de nube de IA de extremo a extremo para empresas, que combina IA predictiva y generativa. Permite a las empresas construir, desplegar y gestionar modelos y aplicaciones de IA seguros y de alto rendimiento en cualquier entorno, desde la nube hasta las instalaciones locales. La plataforma cuenta con AutoML, un Feature Store, Document AI y una sólida Gestión de Riesgos de Modelos.
Soluciones Empresariales
Fluidstack
Fluidstack es una plataforma líder de nube de IA que proporciona clústeres de GPU dedicados de alto rendimiento para entrenar y servir modelos de IA de frontera. Ofrece un despliegue rápido de miles de GPUs, servicios totalmente gestionados con soporte experto 24/7 y precios transparentes con cero tarifas de egreso, capacitando a los equipos de IA para escalar sin fricciones de infraestructura.
Soluciones Empresariales
SectorFlow
SectorFlow es una plataforma de IA segura y de nivel empresarial que proporciona acceso a diversos LLM, automatización de flujos de trabajo gestionados y modelos alojados privados. Permite a las empresas desplegar capacidades de IA a cualquier escala, desde la experimentación hasta la implementación empresarial segura, sin barreras técnicas.
Soluciones Empresariales
Together AI
Together AI es una plataforma en la nube líder para desarrolladores, que proporciona una infraestructura rápida y rentable para ejecutar, ajustar y entrenar modelos de IA generativa de código abierto. Ofrece una extensa biblioteca de más de 200 modelos, API de inferencia sin servidor, ajuste fino personalizable y clústeres de GPU dedicados, creando una solución integral para construir y escalar aplicaciones de IA.
Infraestructura de GPU
Vectorize
Vectorize es una plataforma RAG-as-a-Service que simplifica la creación de aplicaciones de IA sobre datos no estructurados. Ofrece pipelines RAG gestionados, amplios conectores de fuentes de datos y la flexibilidad de usar su base de datos vectorial gestionada o conectar la tuya propia, permitiendo a los desarrolladores desplegar soluciones de IA listas para producción rápidamente.
Trapo
Anyscale
Anyscale es una plataforma de computación totalmente gestionada para escalar cargas de trabajo de IA y Python. Construida sobre el framework de código abierto Ray por sus creadores originales, permite a los desarrolladores construir, ejecutar y escalar aplicaciones distribuidas, desde el entrenamiento de LLMs hasta el procesamiento de datos, con un rendimiento optimizado y eficiencia de costes en cualquier nube.
MLOps
deepsense.ai
deepsense.ai es una empresa líder en consultoría de IA y desarrollo de software a medida. Se especializan en crear soluciones de IA personalizadas para empresas, aprovechando su experiencia en LLMs, RAG, visión por computadora, MLOps y análisis predictivo. Se asocian con empresas y startups para integrar IA en productos, optimizar operaciones y obtener una ventaja competitiva a través de sistemas de IA avanzados y listos para producción.
Consultoría de IA
FuriosaAI
FuriosaAI desarrolla aceleradores de IA de alto rendimiento y eficientes en energía para centros de datos. Su producto estrella, RNGD, está diseñado para tareas de inferencia de IA exigentes, especialmente para grandes modelos de lenguaje (LLM). Con la innovadora arquitectura Tensor Contraction Processor (TCP), RNGD ofrece un rendimiento excepcional con un consumo de energía muy bajo de 180W, reduciendo significativamente el costo total de propiedad y el impacto ambiental para las implementaciones de IA en la nube y empresariales.
Infraestructura
Usedify
Usedify es una plataforma de aprendizaje integral y una guía práctica para dominar la implementación de IA empresarial y la creación de valor utilizando el framework Dify. Ofrece tutoriales paso a paso, estudios de casos reales y mejores prácticas para desarrolladores y empresas.
Tutorials
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
AI News Hub
AI News Hub es una plataforma integral que proporciona anuncios de IA en tiempo real, actualizaciones de blogs curadas sobre IA agentic, RAG y herramientas de producción. Ofrece un feed personalizado, funciones de marcadores y una rica colección de recursos de aprendizaje, incluyendo hojas de ruta, cursos y videos, para mantener a desarrolladores y entusiastas informados y capacitados en el panorama de IA en rápida evolución.
Aggregation
LLM Models
LLM Models es un directorio en línea completo y una plataforma de comparación para grandes modelos de lenguaje y modelos fundacionales. Proporciona especificaciones técnicas detalladas, rendimiento de referencia y comparaciones de características para ayudar a desarrolladores, investigadores y empresas a seleccionar los modelos de IA más adecuados para sus necesidades.
Directorio de Modelos
Nexa SDK
Nexa SDK es un potente kit de herramientas que permite a los desarrolladores implementar cualquier modelo de IA, incluidos los modelos de vanguardia y de última generación, en cualquier dispositivo (móvil, PC, IoT, automotriz) en minutos. Ofrece inferencia en el dispositivo lista para producción con aceleración de hardware en NPUs, GPUs y CPUs, optimizada para velocidad y eficiencia energética.
Ai Development KitPPIO
PPIO es una plataforma líder de computación en la nube distribuida que proporciona potencia de cómputo de IA, API de modelos y servicios de computación de borde rentables y de alto rendimiento. Ofrece a desarrolladores y empresas soluciones integrales para aplicaciones de IA, video y metaverso, con GPU sin servidor, instancias en contenedores y acceso a populares modelos de lenguaje grandes y multimodales.
Alojamiento de ModelosGPUX
GPUX es una plataforma de nube GPU descentralizada y sin servidor para una inferencia de modelos de IA rápida y asequible. Permite a los desarrolladores ejecutar modelos a través de API y a los propietarios de GPU ganar dinero contribuyendo con su hardware a una red P2P.
Despliegue de Modelo
Cerebras Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.