
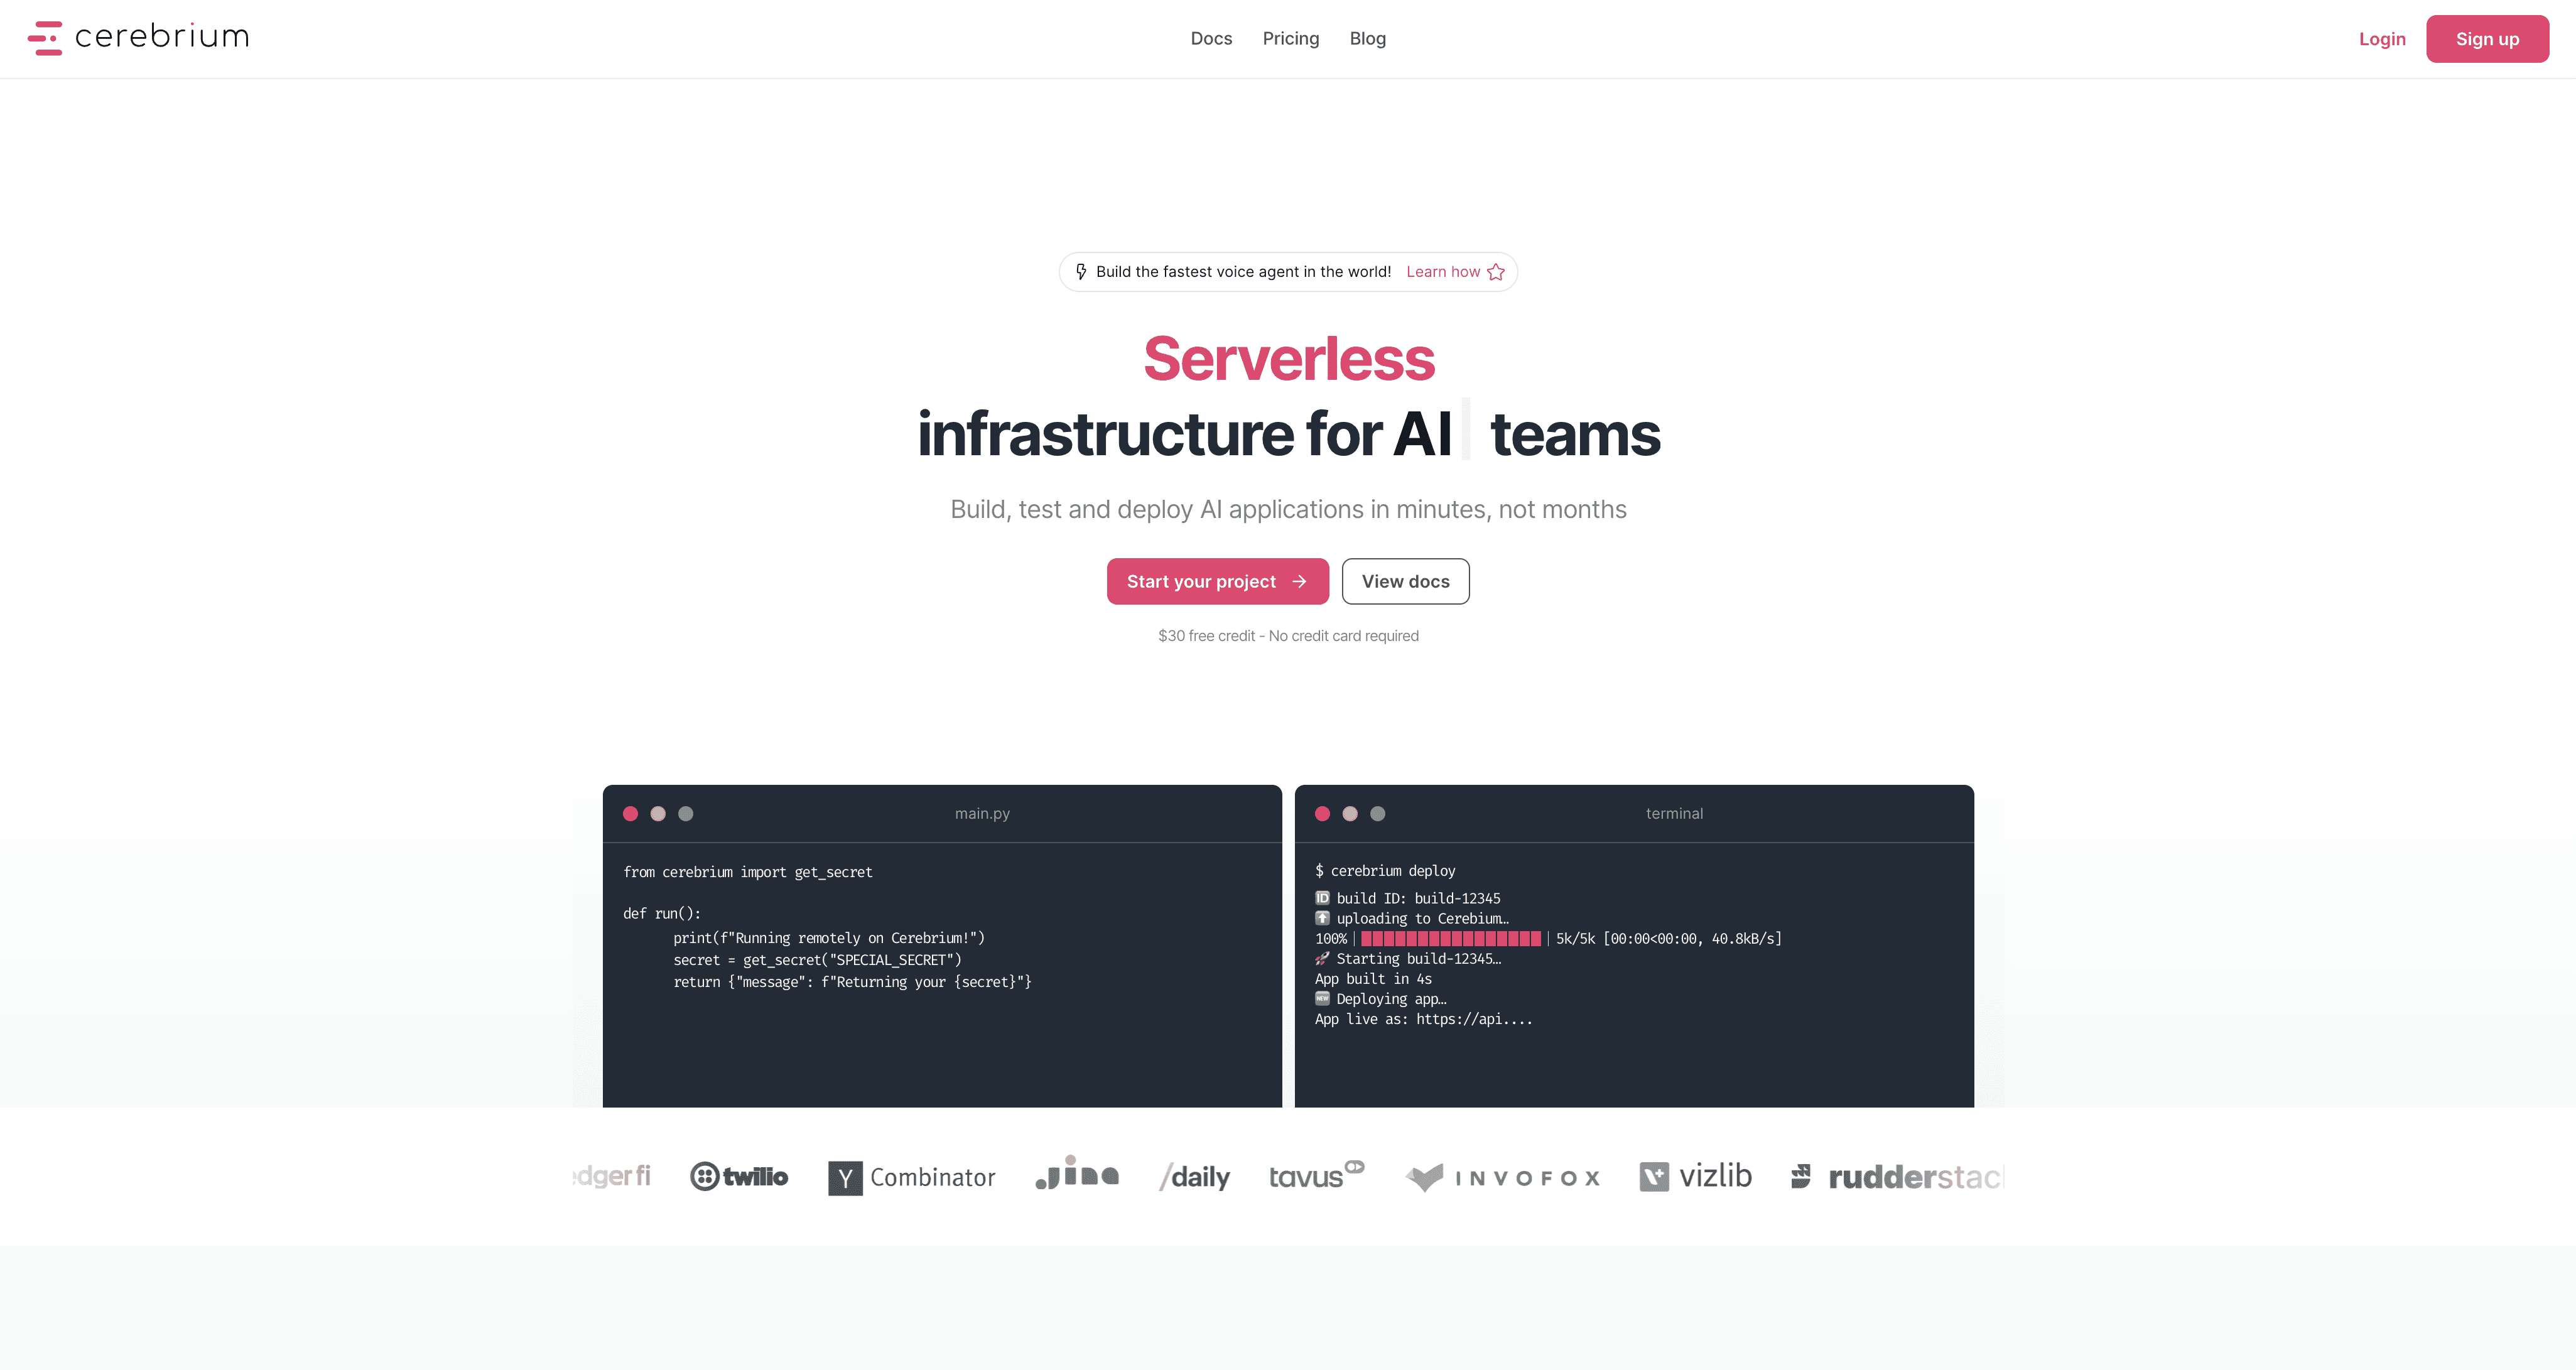
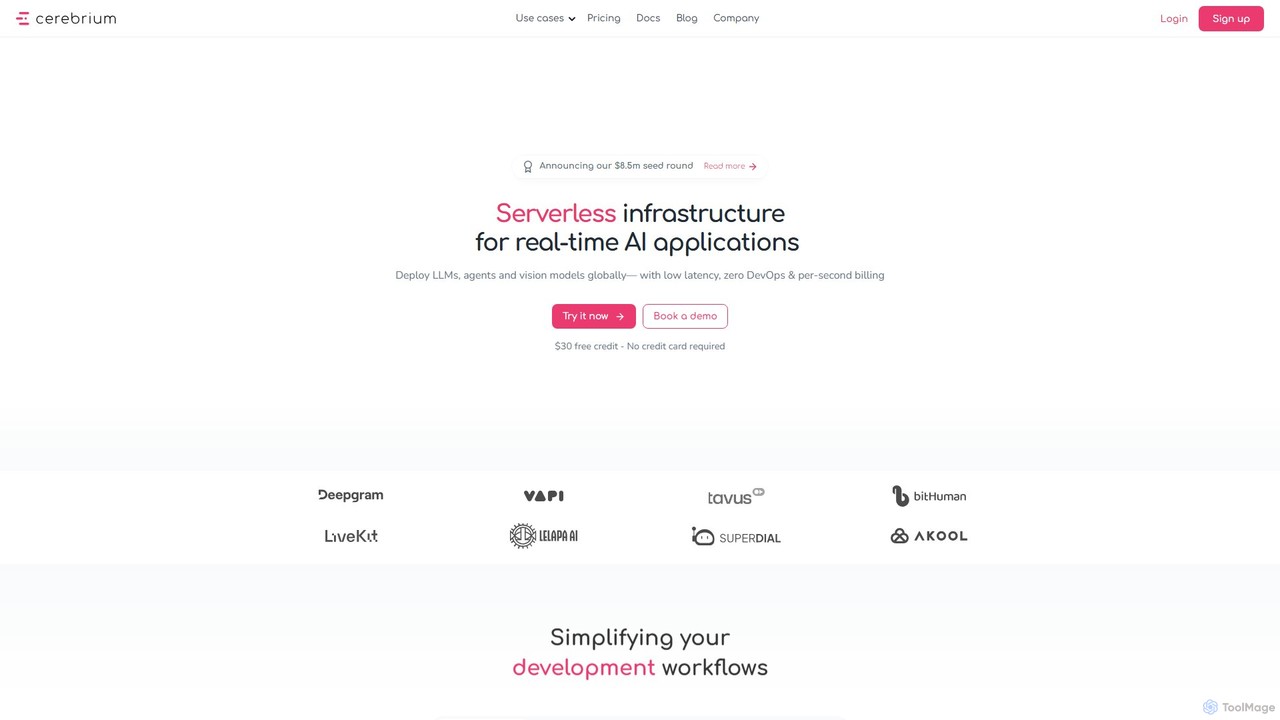
Cerebrium Overview
Cerebrium es una plataforma de infraestructura de IA sin servidor de vanguardia, meticulosamente diseñada para capacitar a desarrolladores y empresas en el despliegue, la gestión y el escalado de aplicaciones de IA de alto rendimiento. Simplifica fundamentalmente el flujo de trabajo de desarrollo al abstraer las complejidades de la gestión de la infraestructura, como el aprovisionamiento de servidores, la configuración y la orquestación. Esto permite a los equipos centrarse por completo en la creación de productos de IA innovadores, desde bots de voz en tiempo real e IA generativa hasta trabajos de procesamiento por lotes a gran escala.
Fundada con la visión de reimaginar la infraestructura de IA, Cerebrium proporciona un entorno robusto, fiable y escalable en el que confían tanto startups como grandes empresas. La plataforma está optimizada para la velocidad, el rendimiento y la rentabilidad, garantizando que los modelos de IA puedan desplegarse globalmente con baja latencia y alta disponibilidad.
Cómo usar Cerebrium
Empezar a usar Cerebrium está diseñado para ser un proceso sencillo y rápido, que permite a los desarrolladores pasar del código a un punto final de API escalable en minutos:
- Inicializar Proyecto: Comience utilizando la CLI o el panel de control de Cerebrium para inicializar un nuevo proyecto. Esto establece la configuración básica para su aplicación.
- Seleccionar Hardware: Elija el hardware óptimo para su carga de trabajo. Cerebrium ofrece una amplia selección de más de 12 tipos de GPU, incluyendo NVIDIA T4, A10, A100, H100, así como CPUs, asegurando que tenga la potencia de cálculo adecuada para cualquier tarea.
- Configurar y Desplegar: Configure los ajustes de su aplicación sin necesidad de ninguna sintaxis especial. Puede utilizar Dockerfiles personalizados para un control total del entorno. Un solo comando (`cerebrium deploy`) envía su código y lo despliega como una función sin servidor.
- Escalar y Monitorizar: Una vez desplegada, su aplicación escala automáticamente de cero a miles de solicitudes según la demanda. Puede supervisar el rendimiento, ver registros y realizar un seguimiento de las métricas de extremo a extremo a través de las herramientas de observabilidad integradas y el soporte de OpenTelemetry.
Características principales de Cerebrium
- Autoescalado sin servidor: Escala automáticamente las aplicaciones de cero a miles de contenedores y viceversa, asegurando que solo pague por el cómputo que utiliza.
- Arranques en frío rápidos: Las aplicaciones en Cerebrium tienen un tiempo medio de arranque en frío de 2 segundos o menos, crucial para aplicaciones en tiempo real orientadas al usuario.
- Amplio Soporte de GPU: Acceso a más de 12 tipos diferentes de GPU (T4, A10, A100, H100, H200, etc.) para adaptarse a requisitos específicos de rendimiento y coste.
- Despliegues Multi-Región: Despliegue aplicaciones globalmente en múltiples regiones para reducir la latencia para los usuarios y garantizar la residencia de datos y el cumplimiento normativo.
- Soporte de Endpoints Avanzados: Soporte nativo para APIs REST, endpoints WebSocket para interacciones en tiempo real y endpoints de Streaming para modelos de IA generativa.
- Gestión Eficiente de Cargas de Trabajo: Características como el procesamiento por lotes de solicitudes para maximizar el rendimiento de la GPU, controles de concurrencia y trabajos asíncronos para tareas en segundo plano como el entrenamiento de modelos.
- Flujo de Trabajo Amigable para el Desarrollador: Integración perfecta con pipelines de CI/CD, despliegues graduales para actualizaciones sin tiempo de inactividad y gestión segura de secretos.
- Seguridad y Cumplimiento: La plataforma cumple con SOC 2 e HIPAA, con una garantía de tiempo de actividad del 99.999%, asegurando que los datos estén seguros y los servicios sean fiables.
Casos de uso para Cerebrium
Cerebrium es lo suficientemente versátil como para impulsar una amplia gama de aplicaciones de IA, como demuestran sus exitosos casos de estudio:
- Modelos de Lenguaje Grandes (LLMs): Despliegue y escalado de aplicaciones de IA generativa, como chatbots, herramientas de creación de contenido y asistentes de codificación.
- IA de Voz en Tiempo Real: Creación de agentes de voz de IA de latencia ultrabaja y servicios de transcripción en tiempo real, como se ve en empresas como Vapi.
- Avatares Digitales y Asistentes Virtuales: Potenciando avatares y asistentes digitales similares a los humanos que requieren inferencia e interacción en tiempo real, como los utilizados por Tavus y bitHuman.
- Procesamiento de Imagen y Vídeo: Ejecución de pipelines de inferencia a gran escala para reconocimiento de imágenes, análisis de vídeo y generación de contenido.
- Procesamiento por Lotes y Entrenamiento de Modelos: Ejecución de grandes trabajos asíncronos para el ajuste fino de modelos o el procesamiento eficiente de conjuntos de datos masivos.
Ventajas de Cerebrium
Cerebrium ofrece una ventaja competitiva significativa para los equipos que construyen con IA:
- Simplicidad Radical: Elimina la necesidad de un equipo dedicado de MLOps o infraestructura, permitiendo a los desarrolladores desplegar modelos de forma independiente.
- Rentabilidad: El modelo de precios por segundo para el cómputo significa que no se incurre en costes por recursos inactivos, lo que conduce a ahorros significativos.
- Alto Rendimiento: Optimizado para baja latencia y alto rendimiento, lo que lo hace ideal para servicios de IA exigentes y en tiempo real.
- Escalabilidad bajo Demanda: Maneja sin esfuerzo picos de tráfico impredecibles sin intervención manual.
- Flexibilidad y Control: Soporta entornos personalizados a través de Docker, dando a los desarrolladores un control total sobre su pila de aplicaciones.
Precios y planes
La tarificación de Cerebrium es transparente y se basa en un modelo de pago por uso para los recursos de cómputo, complementado con planes mensuales para características y soporte adicionales.
- Plan Hobby: 0 $/mes + costes de cómputo. Ideal para desarrolladores y pequeños proyectos, incluye 3 puestos de usuario, hasta 3 aplicaciones desplegadas y soporte comunitario.
- Plan Standard: 100 $/mes + costes de cómputo. Diseñado para aplicaciones de producción, este plan ofrece 10 puestos de usuario, 10 aplicaciones desplegadas, 30 GPUs concurrentes y retención de registros de 30 días.
- Plan Enterprise: Precios personalizados. Para grandes equipos y empresas que requieren escala ilimitada, soporte dedicado, retención de registros ilimitada y características de cumplimiento avanzadas.
Los costes de cómputo se facturan por segundo y varían según el hardware (por ejemplo, T4 a 0.000164 $/s, A100 80GB a 0.000694 $/s). La memoria y el almacenamiento también se facturan según el uso, siendo los primeros 100 GB de almacenamiento gratuitos.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 31.5K
- 2026-1: 35.9K
- 2026-2: 25.5K
- 2026-3: 32.1K
- 2026-4: 53.9K
- 2026-5: 42.3K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos86.8%
- 🇳🇬Nigeria5.2%
- 🇻🇳Vietnam4.6%
- 🇮🇳India1.9%
- 🇧🇷Brasil1.6%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 97.3% |
Referral | 2.1% |
Email | 0.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| cerebrium | $6.12 |
| cerebrium ai | $0.00 |
| cerebrium careers | $0.00 |
| confidential gpus serverless | $0.00 |
| ultravox-glm-4p7 latency | $0.00 |
Cerebrium Alternatives

Runpod
Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.
Aprendizaje Automático
Replicate
Replicate es una plataforma en la nube para que los desarrolladores ejecuten, ajusten e implementen modelos de IA a través de una API simple. Elimina la necesidad de gestionar infraestructuras complejas, ofreciendo acceso a miles de modelos con precios de pago por uso y escalado automático.
Aprendizaje Automático
Baseten
Baseten es una plataforma de inferencia de grado de producción para desplegar, escalar y gestionar modelos de IA. Ofrece tiempos de ejecución de alto rendimiento, flujos de trabajo de desarrollador fluidos y opciones de despliegue flexibles (nube, autohospedado, híbrido). Ideal para equipos de ingeniería y ML que construyen aplicaciones de IA de misión crítica.
Despliegue
ai-rnd.com
Una plataforma integrada para la investigación y el desarrollo de IA, que proporciona un espacio de trabajo unificado, modelos preentrenados y despliegue con un solo clic para acelerar todo el ciclo de vida de la IA. Ideal para desarrolladores, investigadores y empresas.
Gestión de Datos
LangDrive
LangDrive es una plataforma centrada en el desarrollador que ofrece una API unificada para ajustar, gestionar y desplegar Modelos de Lenguaje Grandes (LLMs) de código abierto. Simplifica el complejo pipeline de MLOps, permitiendo a las empresas crear potentes modelos de IA personalizados para tareas especializadas con mayor control sobre los datos y los costos.
Gestión de APICerebrium Categories
Cerebrium Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Modal
Modal es una plataforma de infraestructura sin servidor de alto rendimiento para desarrolladores de IA y ML. Permite ejecutar funciones de Python en la nube con una sola línea de código, proporcionando acceso instantáneo a GPUs, escalado automático de cero a miles de contenedores y precios por segundo. Elimine la sobrecarga de la infraestructura y céntrese en construir y desplegar aplicaciones de computación intensiva como la IA generativa, el procesamiento por lotes y el análisis de datos.
Despliegue de Modelo
Beam
Beam es una plataforma en la nube sin servidor diseñada para que los desarrolladores ejecuten, escalen e implementen modelos y aplicaciones de IA/ML en GPU con facilidad. Ofrece autoescalado instantáneo, facturación por segundo y un flujo de trabajo optimizado, permitiéndole pasar del código a una API escalable en minutos sin gestionar una infraestructura compleja.
Aprendizaje Automático
Inferless
Inferless es una plataforma de GPU sin servidor diseñada para que los desarrolladores desplieguen modelos de aprendizaje automático en minutos. Elimina la gestión de infraestructura, ofreciendo escalado automático desde cero para manejar cargas de trabajo con picos. La plataforma está optimizada para arranques en frío ultrarrápidos y eficiencia de costos, permitiendo a los usuarios ahorrar hasta un 90% en facturas de GPU pagando solo por lo que usan.
Despliegue de Aprendizaje AutomáticoRunpod
Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.
Aprendizaje AutomáticoReplicate
Replicate es una plataforma en la nube para que los desarrolladores ejecuten, ajusten e implementen modelos de IA a través de una API simple. Elimina la necesidad de gestionar infraestructuras complejas, ofreciendo acceso a miles de modelos con precios de pago por uso y escalado automático.
Aprendizaje AutomáticoBaseten
Baseten es una plataforma de inferencia de grado de producción para desplegar, escalar y gestionar modelos de IA. Ofrece tiempos de ejecución de alto rendimiento, flujos de trabajo de desarrollador fluidos y opciones de despliegue flexibles (nube, autohospedado, híbrido). Ideal para equipos de ingeniería y ML que construyen aplicaciones de IA de misión crítica.
Despliegueai-rnd.com
Una plataforma integrada para la investigación y el desarrollo de IA, que proporciona un espacio de trabajo unificado, modelos preentrenados y despliegue con un solo clic para acelerar todo el ciclo de vida de la IA. Ideal para desarrolladores, investigadores y empresas.
Gestión de DatosLangDrive
LangDrive es una plataforma centrada en el desarrollador que ofrece una API unificada para ajustar, gestionar y desplegar Modelos de Lenguaje Grandes (LLMs) de código abierto. Simplifica el complejo pipeline de MLOps, permitiendo a las empresas crear potentes modelos de IA personalizados para tareas especializadas con mayor control sobre los datos y los costos.
Gestión de API
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
OctoAI
OctoAI es una plataforma de computación de alto rendimiento para que los desarrolladores ejecuten, ajusten y escalen modelos de IA generativa de manera eficiente. Ofrece puntos de conexión de API optimizados y listos para producción para modelos populares de código abierto como Llama, Mixtral y Stable Diffusion. Al centrarse en optimizaciones profundas del sistema, OctoAI proporciona velocidades de inferencia más rápidas y costos más bajos, permitiendo a las empresas construir y desplegar aplicaciones de IA escalables sin gestionar una infraestructura compleja.
API
novita.ai
Novita AI es una plataforma en la nube centrada en el desarrollador que ofrece acceso asequible y escalable a más de 200 modelos de IA a través de API sencillas. Proporciona GPU sin servidor, instancias de GPU dedicadas y despliegue de modelos personalizados, permitiendo a los desarrolladores construir y escalar aplicaciones de IA sin gestionar la infraestructura.
GPU
PPIO
PPIO es una plataforma líder de computación en la nube distribuida que proporciona potencia de cómputo de IA, API de modelos y servicios de computación de borde rentables y de alto rendimiento. Ofrece a desarrolladores y empresas soluciones integrales para aplicaciones de IA, video y metaverso, con GPU sin servidor, instancias en contenedores y acceso a populares modelos de lenguaje grandes y multimodales.
Alojamiento de Modelos
Union.ai
Union.ai es una plataforma de nivel empresarial, lista para producción, para orquestar flujos de trabajo complejos de IA y aprendizaje automático. Construida sobre Flyte de código abierto, capacita a los equipos para construir, servir y escalar sistemas de IA compuestos con un rendimiento y eficiencia inigualables. Cierra la brecha entre datos y ML, optimiza los costos de la nube con características como 'scale-to-zero' y mejora la velocidad de los desarrolladores a través de una experiencia integrada y fluida.
Orquestación
Float16.cloud
Float16.cloud es una plataforma de GPU sin servidor diseñada para acelerar el desarrollo de IA. Proporciona acceso instantáneo a GPUs H100 de alto rendimiento con facturación por segundo, configuración cero y sin arranques en frío. Los desarrolladores pueden desplegar LLMs de código abierto, entrenar modelos y ejecutar cargas de trabajo de IA directamente desde scripts de Python sin gestionar la infraestructura.
Plataforma como Servicio (PaaS)
Nexlayer
Nexlayer es la primera plataforma de nube nativa de agentes, diseñada para empoderar a los agentes de codificación de IA para implementar aplicaciones listas para producción rápidamente. Automatiza infraestructuras complejas, permitiendo a desarrolladores y fundadores lanzar aplicaciones full-stack, APIs y bases de datos en minutos sin sobrecarga de DevOps.
Application Development
Cerebrium Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.