
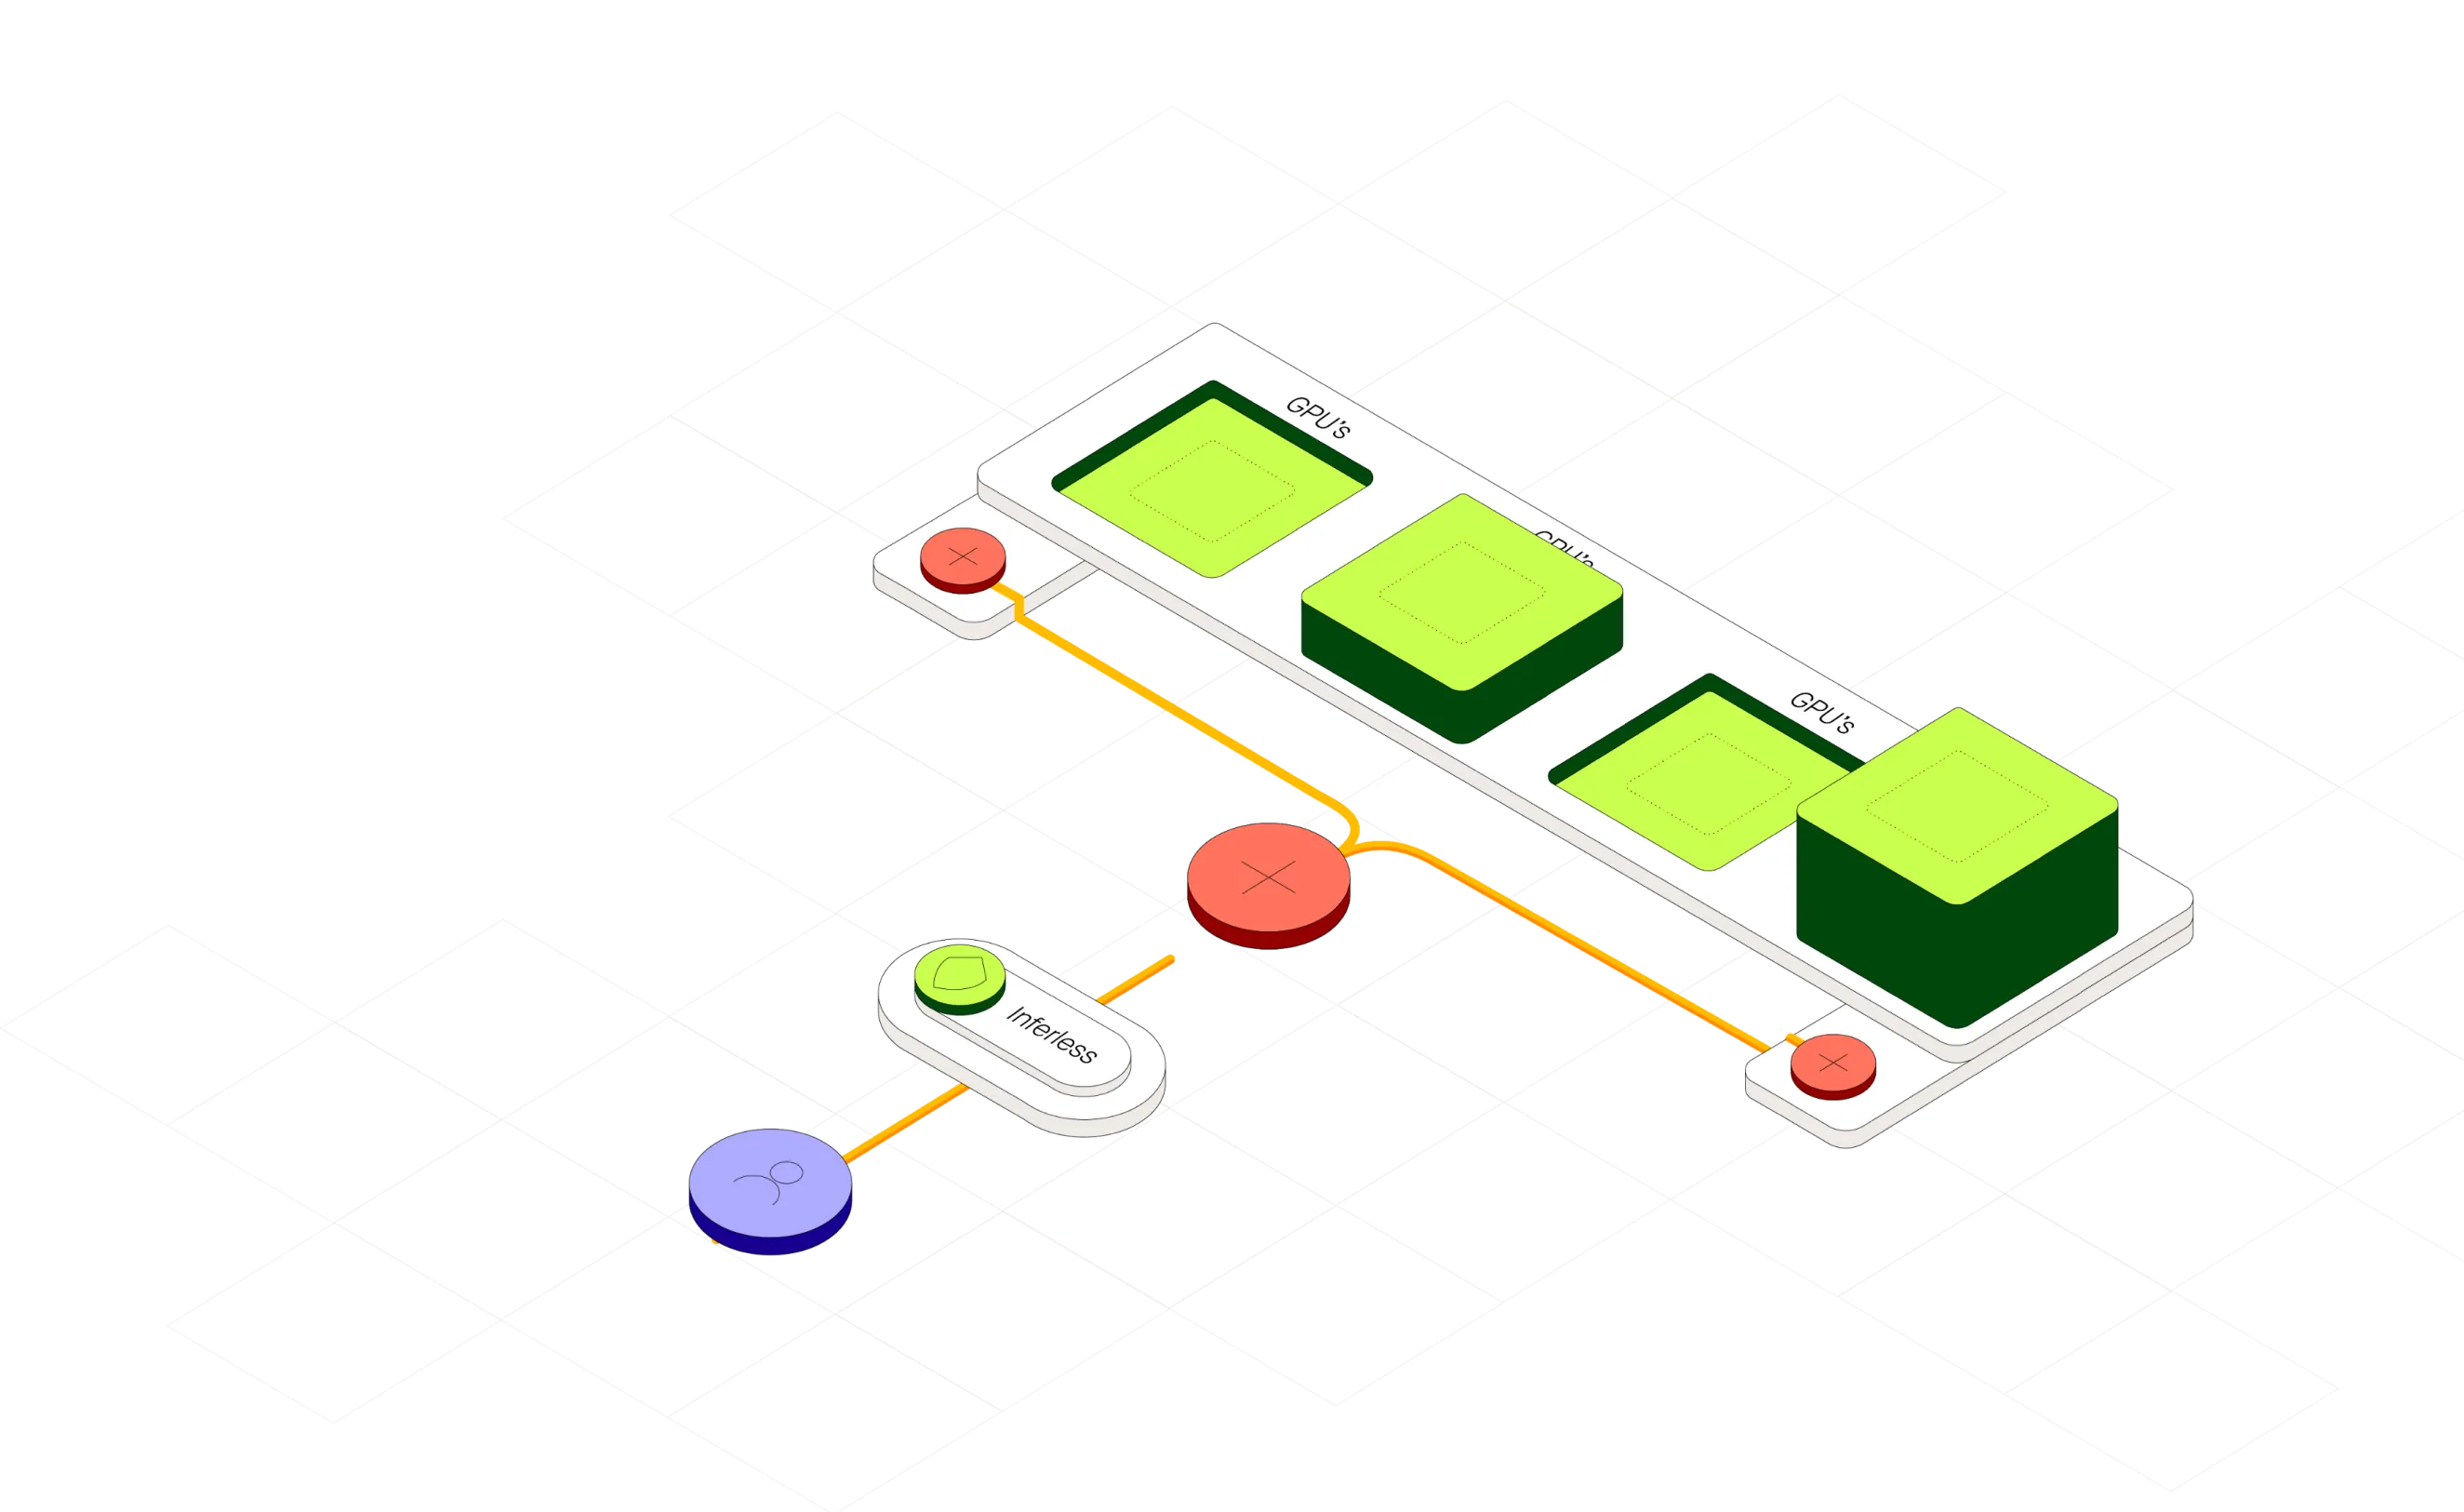

Inferless Overview
Inferless es una plataforma de GPU sin servidor de vanguardia diseñada para agilizar el despliegue de modelos de aprendizaje automático para cargas de trabajo de producción. Permite a los desarrolladores y científicos de datos pasar de un archivo de modelo a un punto final de API en vivo y escalable en solo minutos, abstrayendo por completo las complejidades de la gestión de infraestructura. Al admitir el despliegue directo desde fuentes como Hugging Face, Git, Docker o su propia CLI, Inferless ofrece una flexibilidad inigualable y acelera el camino hacia la producción.
La plataforma está construida para manejar patrones de tráfico impredecibles y con picos gracias a sus robustas capacidades de autoescalado, escalando de cero a cientos de GPUs bajo demanda. Esto garantiza una alta disponibilidad y rendimiento sin el costo de los recursos inactivos. Con un fuerte enfoque en la fiabilidad y seguridad de nivel empresarial, Inferless cuenta con la certificación SOC-2 Tipo II y se somete a escaneos de vulnerabilidad regulares, lo que la convierte en una opción de confianza para empresas de todos los tamaños.
Cómo usar Inferless
Desplegar un modelo en Inferless es un proceso sencillo diseñado para la velocidad y la eficiencia:
- Regístrate y Conecta: Crea una cuenta de Inferless y conecta tu fuente de modelos. Puedes integrar directamente tu cuenta de Hugging Face, un repositorio de Git o un registro de Docker.
- Importa tu Modelo: En el espacio de trabajo de Inferless, selecciona 'Añadir un Modelo Personalizado'. Elige tu proveedor, introduce el nombre del modelo y especifica su tipo (p. ej., Transformer, Diffuser) y tarea (p. ej., Generación de Texto, Texto a Imagen).
- Personaliza la Configuración: Adapta el despliegue a tus necesidades. Puedes modificar el código de inferencia (p. ej., `app.py`), definir esquemas de entrada personalizados y configurar el entorno de ejecución con dependencias de software y bibliotecas específicas.
- Configura el Hardware y el Escalado: Selecciona el tipo de GPU apropiado (p. ej., Nvidia T4, A10, A100). Establece el número mínimo y máximo de réplicas para definir el comportamiento del autoescalado. Configura ajustes como el tiempo de espera de la inferencia, la concurrencia del contenedor y los períodos de reducción de escala.
- Despliega y Monitoriza: Haz clic en 'Desplegar' para construir tu modelo y lanzar el punto final. Una vez en vivo, puedes usar los registros detallados de llamadas y compilación para monitorear el rendimiento, depurar problemas y refinar tus modelos de manera eficiente.
Características principales de Inferless
- Infraestructura de GPU sin Servidor: Cero configuración o gestión de infraestructura. La plataforma se encarga del aprovisionamiento, escalado y mantenimiento automáticamente.
- Arranques en Frío Ultrarrápidos: La arquitectura optimizada garantiza tiempos de respuesta por debajo del segundo incluso para modelos grandes, eliminando los retrasos de calentamiento.
- Autoescalado Dinámico: Escala recursos automáticamente de cero a cientos de GPUs según el tráfico en tiempo real, garantizando un rendimiento y costo óptimos.
- Agrupación Dinámica (Dynamic Batching): Aumenta el rendimiento y la utilización de la GPU al combinar automáticamente múltiples solicitudes del lado del servidor en un solo lote.
- Entornos de Ejecución Personalizados: Flexibilidad total para personalizar el entorno del contenedor con cualquier software y dependencias necesarios.
- CI/CD Automatizado: Habilita la reconstrucción automática para que los modelos se redesplieguen automáticamente tras los cambios en el repositorio de origen, agilizando el ciclo de vida del desarrollo.
- Volúmenes Persistentes: Proporciona volúmenes de escritura similares a NFS que admiten conexiones simultáneas, permitiendo aplicaciones con estado y un intercambio de datos eficiente.
- Seguridad de Nivel Empresarial: Certificado SOC-2 Tipo II, con pruebas de penetración y escaneos de vulnerabilidad regulares para garantizar la seguridad de los datos.
Casos de uso para Inferless
Inferless es ideal para una amplia gama de aplicaciones de IA:
- Aplicaciones de IA Generativa: Despliegue de grandes modelos de lenguaje (LLMs) para chatbots, creación de contenido y generación de código con baja latencia.
- APIs en Tiempo Real: Potenciando servicios que requieren altas consultas por segundo (QPS) y respuestas inmediatas, como la detección de fraudes o los motores de recomendación.
- Visión por Computadora: Sirviendo modelos para reconocimiento de imágenes, detección de objetos y generación de imágenes a escala.
- Procesamiento de Audio y Voz: Alojando modelos de texto a voz (TTS), de voz a texto y otros modelos de IA basados en audio.
- Prototipado y Producción Rentables: Las startups y empresas pueden reducir significativamente sus facturas de nube de GPU (hasta en un 90%) mientras escalan eficazmente.
Ventajas de Inferless
Las principales ventajas de usar Inferless incluyen un ahorro de costos significativo a través de su modelo de pago por uso, una mayor productividad del desarrollador al eliminar la sobrecarga de DevOps y un rendimiento superior con una latencia mínima. Su capacidad para manejar cargas de trabajo con picos de manera confiable la convierte en una solución robusta para entornos de producción. La flexibilidad de la plataforma con entornos de ejecución personalizados e integraciones directas con herramientas como Hugging Face la convierte en una opción versátil y potente para cualquier equipo de ML.
Precios y planes
Inferless ofrece un modelo de precios transparente de pago por uso con un crédito gratuito de $30 para empezar.
- Precios de GPU (Pago por segundo):
- Nvidia T4: $0.66/hora
- Nvidia A10: $1.22/hora
- Nvidia A100 (80GB): $5.36/hora
- Precios de Volumen: Los primeros 50GB de almacenamiento son gratuitos cada mes. El almacenamiento adicional cuesta $0.3/GB/mes.
- Plan Startup: Diseñado para un mínimo de 10,000 solicitudes de inferencia al mes, incluye una concurrencia de 5 GPUs, retención de registros de 15 días y soporte a través de un canal privado de Slack.
- Plan Enterprise: Para un mínimo de 100,000 solicitudes de inferencia al mes, con una concurrencia de 50 GPUs, retención de registros de 365 días y un ingeniero de soporte dedicado.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 31.3K
- 2026-1: 23.7K
- 2026-2: 15.1K
- 2026-3: 20.2K
- 2026-4: 13.3K
- 2026-5: 8.4K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos32.3%
- 🇻🇳Vietnam24.5%
- 🇮🇳India22.9%
- 🇧🇷Brasil11.0%
- 🇮🇹Italia9.3%
Top keywords
| Keyword | Cost per click |
|---|---|
| deepseek | $0.45 |
| goel a, borgohain r (2024) exploring llms speed benchmarks: independent analysis | $0.00 |
| kokoro-82m alternative | $0.00 |
| qwen | $0.28 |
| qwen 2.5 3b architecture | $0.00 |
Inferless Alternatives
Supervised.co
Supervised.co es una plataforma de extremo a extremo para construir, entrenar e implementar modelos de aprendizaje automático supervisado. Simplifica el ciclo de vida de MLOps con anotación de datos integrada, entrenamiento de modelos automatizado y despliegue de API con un solo clic, capacitando a los equipos para crear soluciones de IA de alto rendimiento de manera eficiente.
Anotación de Datos
Modal
Modal es una plataforma de infraestructura sin servidor de alto rendimiento para desarrolladores de IA y ML. Permite ejecutar funciones de Python en la nube con una sola línea de código, proporcionando acceso instantáneo a GPUs, escalado automático de cero a miles de contenedores y precios por segundo. Elimine la sobrecarga de la infraestructura y céntrese en construir y desplegar aplicaciones de computación intensiva como la IA generativa, el procesamiento por lotes y el análisis de datos.
Despliegue de Modelo
Runpod
Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.
Aprendizaje Automático
ClearML GenAI App Engine
Una plataforma de nivel empresarial para desplegar, gestionar y escalar rápidamente aplicaciones de IA Generativa. Proporciona un plano de control de infraestructura unificado para agilizar el despliegue de LLM, monitorizar el rendimiento y optimizar los costes de computación, acelerando la adopción de GenAI de forma segura y eficiente.
MLOps
Beam
Beam es una plataforma en la nube sin servidor diseñada para que los desarrolladores ejecuten, escalen e implementen modelos y aplicaciones de IA/ML en GPU con facilidad. Ofrece autoescalado instantáneo, facturación por segundo y un flujo de trabajo optimizado, permitiéndole pasar del código a una API escalable en minutos sin gestionar una infraestructura compleja.
Aprendizaje AutomáticoInferless Categories
Inferless Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Modal
Modal es una plataforma de infraestructura sin servidor de alto rendimiento para desarrolladores de IA y ML. Permite ejecutar funciones de Python en la nube con una sola línea de código, proporcionando acceso instantáneo a GPUs, escalado automático de cero a miles de contenedores y precios por segundo. Elimine la sobrecarga de la infraestructura y céntrese en construir y desplegar aplicaciones de computación intensiva como la IA generativa, el procesamiento por lotes y el análisis de datos.
Despliegue de ModeloRunpod
Runpod es una plataforma en la nube diseñada para IA y aprendizaje automático, que ofrece computación de GPU escalable para implementar, entrenar y ejecutar modelos de IA. Proporciona GPUs sin servidor, plantillas preconstruidas y precios rentables para simplificar todo el flujo de trabajo de desarrollo de IA, desde la idea hasta la producción.
Aprendizaje AutomáticoBeam
Beam es una plataforma en la nube sin servidor diseñada para que los desarrolladores ejecuten, escalen e implementen modelos y aplicaciones de IA/ML en GPU con facilidad. Ofrece autoescalado instantáneo, facturación por segundo y un flujo de trabajo optimizado, permitiéndole pasar del código a una API escalable en minutos sin gestionar una infraestructura compleja.
Aprendizaje Automático
Cerebrium
Cerebrium es una plataforma de infraestructura de IA sin servidor diseñada para que los desarrolladores desplieguen, gestionen y escalen modelos de aprendizaje automático con facilidad. Abstrae la infraestructura compleja, ofreciendo características como autoescalado, arranques en frío rápidos y acceso a GPU de pago por uso, permitiendo a los equipos construir aplicaciones de IA de alto rendimiento sin gestionar servidores.
Serverless
Vast.ai
Vast.ai es una plataforma líder de nube de GPU que ofrece acceso bajo demanda a una vasta red de GPUs para cargas de trabajo de IA y aprendizaje automático. Proporciona a desarrolladores y empresas computación de alto rendimiento a costos significativamente más bajos, hasta un 80% menos que los proveedores de nube tradicionales, a través de un mercado transparente de pago por uso.
Alquiler de GPU
Nebius
Nebius es una plataforma en la nube de alto rendimiento diseñada específicamente para IA y aprendizaje automático. Proporciona acceso a las últimas GPU de NVIDIA, clústeres escalables con redes InfiniBand y servicios totalmente gestionados como Kubernetes y Slurm, permitiendo el entrenamiento, ajuste fino e inferencia de modelos de IA a cualquier escala.
Aprendizaje Automático
Lightning AI
Lightning AI es una plataforma en la nube diseñada para construir, entrenar y desplegar modelos de IA a escala. Combina el popular framework de código abierto PyTorch Lightning con Lightning AI Studio, un entorno colaborativo basado en navegador sin necesidad de configuración. Accede a potentes GPUs, escala de un portátil a la nube sin problemas y acelera todo tu flujo de trabajo de desarrollo de IA.
Plataforma como Servicio (PaaS)
Fluidstack
Fluidstack es una plataforma líder de nube de IA que proporciona clústeres de GPU dedicados de alto rendimiento para entrenar y servir modelos de IA de frontera. Ofrece un despliegue rápido de miles de GPUs, servicios totalmente gestionados con soporte experto 24/7 y precios transparentes con cero tarifas de egreso, capacitando a los equipos de IA para escalar sin fricciones de infraestructura.
Soluciones Empresariales
Gmi Cloud
Gmi Cloud es una plataforma de nube GPU de alto rendimiento diseñada para el entrenamiento e inferencia de IA escalables. Proporciona acceso bajo demanda a GPUs NVIDIA de primer nivel, un motor de inferencia optimizado para baja latencia y un motor de clúster para MLOps simplificado, permitiendo a desarrolladores y empresas construir, desplegar y escalar aplicaciones de IA de manera eficiente y rentable.
MLOps
GreenNode
GreenNode es un proveedor integral de infraestructura en la nube para IA, que ofrece soluciones de GPU NVIDIA de alto rendimiento para startups y empresas. Proporciona acceso instantáneo a recursos de vanguardia como las GPU H100, infraestructura escalable y soporte experto del AI Lab. Centrado en la rentabilidad y el rendimiento, GreenNode ayuda a acelerar el entrenamiento, el ajuste fino y la inferencia de modelos, con una fuerte presencia en el Sudeste Asiático.
Entrenamiento de Modelo
Nebius
Nebius es una plataforma en la nube de alto rendimiento diseñada específicamente para cargas de trabajo exigentes de IA y Machine Learning. Proporciona acceso escalable a las últimas GPUs de NVIDIA, desde instancias únicas hasta clústeres masivos, complementado con un conjunto de servicios gestionados y un AI Studio integrado para agilizar todo el ciclo de vida de ML, desde el entrenamiento hasta la inferencia.
Nube GPU
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización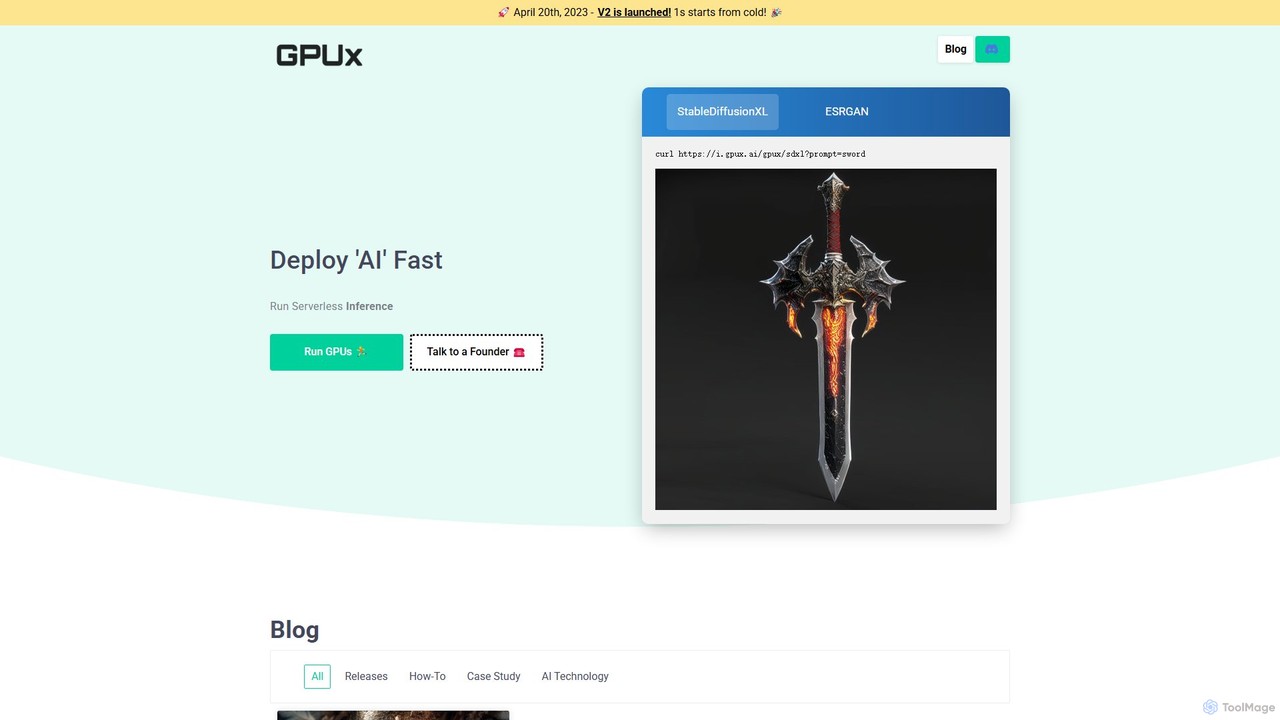
GPUX
GPUX es una plataforma de nube GPU descentralizada y sin servidor para una inferencia de modelos de IA rápida y asequible. Permite a los desarrolladores ejecutar modelos a través de API y a los propietarios de GPU ganar dinero contribuyendo con su hardware a una red P2P.
Despliegue de Modelo
Modelbit
Modelbit es una plataforma MLOps para desplegar modelos de aprendizaje automático directamente desde notebooks de Python a producción. Proporciona un flujo de trabajo de infraestructura como código, permitiendo a los científicos de datos desplegar, alojar, escalar y gestionar modelos con una sola línea de código y un git push.
MLOps
PostgresML
PostgresML es una potente extensión de código abierto que integra el aprendizaje automático y la IA directamente en su base de datos PostgreSQL. Permite la inferencia acelerada por GPU, la búsqueda vectorial y pipelines RAG completos utilizando simples comandos SQL, eliminando el movimiento de datos y simplificando la pila de MLOps para aplicaciones de IA escalables y de alto rendimiento.
MLOps
Inferless Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.