

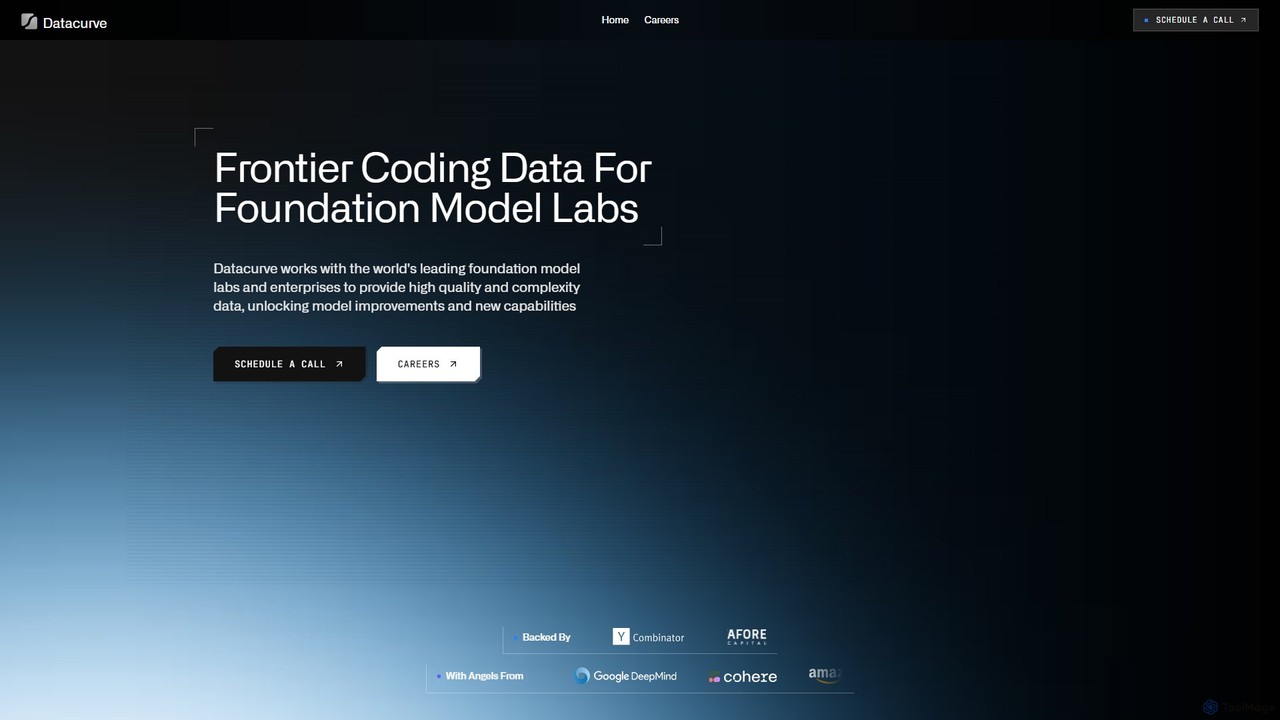
Datacurve Overview
Datacurve es un proveedor de datos especializado que se asocia con los laboratorios de modelos fundacionales y empresas líderes en el mundo para crear datos de codificación complejos y de alta calidad. Su misión es desbloquear mejoras significativas en los modelos y habilitar nuevas capacidades de IA suministrando los datos de frontera necesarios para el post-entrenamiento y la evaluación. Con el respaldo de Y Combinator e importantes inversores ángeles, Datacurve se ha establecido como un socio crítico para proyectos de IA de misión crítica, contando con la confianza de empresas como Cohere.
La compañía aborda la creciente necesidad de conjuntos de datos sofisticados que van más allá de simples fragmentos de código. Se centran en datos que capturan los matices del desarrollo de software, incluyendo el razonamiento, la depuración y el comportamiento agéntico. Esto se logra a través de una plataforma única, gamificada y basada en recompensas llamada 'Shipd', que atrae y retiene a una comunidad de más de 14,000 ingenieros de élite que compiten en 'Quests' para generar datos diversos y complejos.
Cómo usar Datacurve
Datacurve opera como un proveedor de servicios de alto contacto, no como una plataforma de autoservicio. El proceso de colaboración se adapta a las necesidades específicas de cada cliente:
- Consulta Inicial: Los clientes potenciales programan una llamada para discutir los objetivos de su proyecto, los requisitos de datos, la complejidad deseada y la escala.
- Definición del Alcance y Piloto: El equipo técnico de Datacurve colabora con el cliente para definir los formatos de datos precisos, las métricas de calidad y los criterios de evaluación. A menudo se inicia un programa piloto para iterar rápidamente y asegurar que los datos se alineen perfectamente con las necesidades de investigación y desarrollo del cliente.
- Campaña de Creación de Datos: Una vez definido el alcance, Datacurve lanza una 'Quest' en su plataforma Shipd. Se seleccionan ingenieros validados de su grupo global para participar en estas competiciones basadas en recompensas y crear los datos especificados.
- Aseguramiento de Calidad Multicapa: Todos los datos generados se someten a un riguroso proceso de control de calidad multicapa. Esto incluye comprobaciones de consistencia automatizadas, detección de anomalías estadísticas y meticulosos bucles de evaluación humana para corregir errores y manejar casos extremos.
- Producción a Escala y Entrega: Tras un piloto exitoso, Datacurve escala la producción para satisfacer demandas de alto volumen, garantizando una entrega oportuna que se alinea con los cronogramas de lanzamiento de modelos e investigación del cliente.
Características principales de Datacurve
- Datos de Ajuste Fino Supervisado (SFT): Conjuntos de datos de alta calidad en una variedad de tareas de codificación para ajustar modelos.
- Entornos de Aprendizaje por Refuerzo (RLE): Entornos de RL diseñados a medida para una evaluación y verificación de código exhaustivas a nivel de repositorio.
- Aprendizaje por Refuerzo con Retroalimentación Humana (RLHF): Bucles de RLHF personalizados con el punto final del modelo del cliente integrado directamente en el proceso de retroalimentación.
- Trazas de Flujo de Trabajo Agéntico: Telemetría completa del proceso de un desarrollador de software, incluyendo ejecución de código, bucles de edición, navegación de archivos y pensamientos verbales/escritos, diseñada para entrenar agentes de software avanzados.
- Tareas de Razonamiento y Depuración: Conjuntos de datos construidos a partir de errores de producción del mundo real y escenarios de razonamiento complejos aportados por ingenieros profesionales.
- Banco de Tareas de Repositorio Privado: La capacidad de diseñar tareas de entrenamiento y evaluación personalizadas en bases de código privadas y propietarias (p. ej., aplicaciones empresariales, juegos, software de sistemas).
- Datos de Interfaz Multimodal: Tareas que enseñan a los modelos a conectar código estático con comportamiento dinámico, utilizando indicaciones, capturas de pantalla o grabaciones para entrenar una comprensión de cómo debe verse, sentirse y funcionar el software interactivo.
Casos de uso para Datacurve
Los datos de Datacurve son fundamentales para una gama de aplicaciones de IA avanzadas:
- Entrenamiento de Modelos Fundacionales de Próxima Generación: Proporcionando los datos algorítmicos y de razonamiento centrales para mejorar las capacidades de codificación fundamentales de un modelo.
- Desarrollo de Agentes de Software de IA Autónomos: Usando trazas agénticas detalladas para entrenar modelos que pueden realizar tareas complejas de desarrollo de software de forma independiente, como codificar, depurar y probar.
- Benchmarking y Evaluación de Modelos: Creando benchmarks personalizados y desafiantes en código privado o público para evaluar y comparar con precisión el rendimiento de diferentes modelos.
- Ajuste Fino para Dominios Especializados: Creando conjuntos de datos para adaptar modelos a industrias o tareas específicas, como el desarrollo de juegos, software de modelado financiero o sistemas embebidos.
- Mejora de la Generación y Depuración de Código: Usando conjuntos de datos de errores del mundo real y soluciones de ingeniería para mejorar la capacidad de un modelo para generar código correcto e identificar y corregir errores de manera efectiva.
Ventajas de Datacurve
- Calidad y Complejidad de Datos Inigualables: Un proceso de control de calidad multicapa y la especialización en formatos complejos garantizan la máxima precisión.
- Plataforma de Colaboradores Gamificada: El sistema de recompensas y misiones de la plataforma 'Shipd' incentiva a los mejores ingenieros a producir datos creativos, diversos y de alta calidad.
- Experiencia en Datos de Frontera: Profundo conocimiento de las necesidades de datos para la investigación de IA de vanguardia, incluida la IA agéntica y el razonamiento avanzado.
- Escalabilidad y Velocidad: Infraestructura diseñada para la producción de alto volumen y un equipo técnico que permite ciclos de iteración rápidos con los equipos de investigación del cliente.
- Socio de Confianza para Líderes en IA: Un historial probado de trabajo con los equipos de IA más exigentes del mundo en sus proyectos más críticos.
Precios y planes
Datacurve ofrece planes empresariales personalizados. El precio se determina proyecto por proyecto, dependiendo de factores como la complejidad de los datos, el volumen requerido, el cronograma del proyecto y los servicios específicos involucrados. Para recibir un presupuesto y discutir su proyecto, debe programar una reunión con su equipo a través del sitio web oficial.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 13.3K
- 2026-1: 16.6K
- 2026-2: 10.6K
- 2026-3: 13.2K
- 2026-4: 10.1K
- 2026-5: 93.9K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos70.2%
- 🇮🇳India15.2%
- 🇰🇷Corea del Sur7.0%
- 🇨🇦Canadá6.5%
- 🇯🇵Japón1.2%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 82.7% |
Referral | 14.8% |
Email | 2.5% |
Top keywords
| Keyword | Cost per click |
|---|---|
| data curve | $4.37 |
| datacurve | $4.94 |
| deep swe | $0.00 |
| deepswe | $0.00 |
| deepswe benchmark | $0.00 |
Datacurve Videos on YouTube
Singularity Feed | AI Models , Agents & Robotics

Matthew Berman

John Oluleke-Oke

Eliott Meunier

Datacurve Alternatives
Surge AI
Surge AI es una plataforma de etiquetado de datos de primer nivel que proporciona inteligencia humana de élite para impulsar el desarrollo de IA avanzada y AGI. Especializada en datos de alta calidad para RLHF, evaluación de modelos y creación de conjuntos de datos personalizados, Surge AI se asocia con laboratorios de IA líderes como OpenAI y Anthropic para entrenar, alinear y probar modelos de próxima generación. Se centran en los matices y la complejidad necesarios para construir sistemas verdaderamente inteligentes.
MLOps
DefinedCrowd
DefinedCrowd es un proveedor líder de datos de entrenamiento de IA de alta calidad. Aprovecha una comunidad global para recopilar, anotar y enriquecer datos para modelos de aprendizaje automático, especializándose en voz, PNL y visión por computadora. Ofrece un servicio totalmente gestionado para ayudar a las empresas a construir aplicaciones de IA robustas e imparciales a escala.
Aprendizaje Automático
Revelo
Revelo es una plataforma de talento de primer nivel que conecta a empresas con el 2% superior de desarrolladores de software preseleccionados de América Latina. Ofrece una solución de servicio completo, gestionando nóminas, beneficios y cumplimiento normativo, permitiendo a las empresas escalar sus equipos de ingeniería de forma rápida y rentable. Con alineación de zona horaria y ahorros significativos sobre las contrataciones en EE. UU., Revelo también proporciona servicios especializados de datos humanos para entrenar modelos de IA y LLM.
Etiquetado de Datos
Innovatiana
Innovatiana es un servicio especializado que proporciona datos de entrenamiento de alta calidad y de origen ético para modelos de IA. Ofrecen creación de conjuntos de datos personalizados y etiquetado de datos para visión por computadora, PNL, IA generativa y procesamiento de documentos. Al emplear equipos dedicados y capacitados en lugar de crowdsourcing, Innovatiana garantiza una precisión de datos superior, seguridad y un desarrollo de IA responsable, ayudando a las empresas a construir modelos más robustos e imparciales.
Creación de Conjunto de Datos
Alaya AI
Alaya AI es una plataforma de datos de IA descentralizada que conecta a una comunidad global con tareas de entrenamiento de IA. Proporciona soluciones de datos escalables y de alta calidad para desarrolladores a través de un modelo gamificado de 'entrenar para ganar', empoderando a usuarios de todo el mundo para contribuir al desarrollo de la IA y obtener recompensas.
Entrenamiento de ModeloDatacurve Categories
Datacurve Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
SuperAnnotate
SuperAnnotate es una plataforma de datos de IA líder que agiliza todo el pipeline de datos para el aprendizaje automático. Permite a los equipos anotar, gestionar y curar conjuntos de datos multimodales de alta calidad (imagen, vídeo, texto, audio) para acelerar el desarrollo de modelos, incluso para flujos de trabajo complejos como RLHF, RAG y SFT. Está diseñada para mejorar la precisión y la eficiencia del modelo.
Etiquetado
BasicAI
BasicAI ofrece una plataforma integral de anotación de datos y servicios gestionados para crear datos de entrenamiento de alta calidad para modelos de IA. Se especializa en datos 3D LiDAR, de imagen, vídeo y PNL, proporcionando herramientas asistidas por IA, flujos de trabajo escalables y seguridad de nivel empresarial para acelerar el desarrollo de la IA.
Etiquetado de DatosSurge AI
Surge AI es una plataforma de etiquetado de datos de primer nivel que proporciona inteligencia humana de élite para impulsar el desarrollo de IA avanzada y AGI. Especializada en datos de alta calidad para RLHF, evaluación de modelos y creación de conjuntos de datos personalizados, Surge AI se asocia con laboratorios de IA líderes como OpenAI y Anthropic para entrenar, alinear y probar modelos de próxima generación. Se centran en los matices y la complejidad necesarios para construir sistemas verdaderamente inteligentes.
MLOps
Labelbox
Labelbox es una plataforma de IA integral y centrada en datos, o "Fábrica de Datos", diseñada para equipos de IA. Proporciona software integrado, servicios de expertos y un mercado de talentos para crear, gestionar y evaluar datos de entrenamiento de alta calidad para modelos avanzados de IA, incluidos LLMs y sistemas multimodales.
Etiquetado
Jyek
Jyek es una plataforma de agente de IA que comprende objetivos, crea planes de ejecución, utiliza herramientas y entrega resultados verificables para tareas complejas de múltiples pasos.
Automatización
Scale AI
Scale AI es una plataforma integral que acelera el desarrollo de IA al proporcionar datos de alta calidad, evaluación de modelos y servicios de ajuste fino. Se dirige a laboratorios de IA líderes, empresas y agencias gubernamentales, ofreciendo un completo Motor de Datos para RLHF, etiquetado y generación de datos para potenciar la IA generativa avanzada y los LLMs.
Etiquetado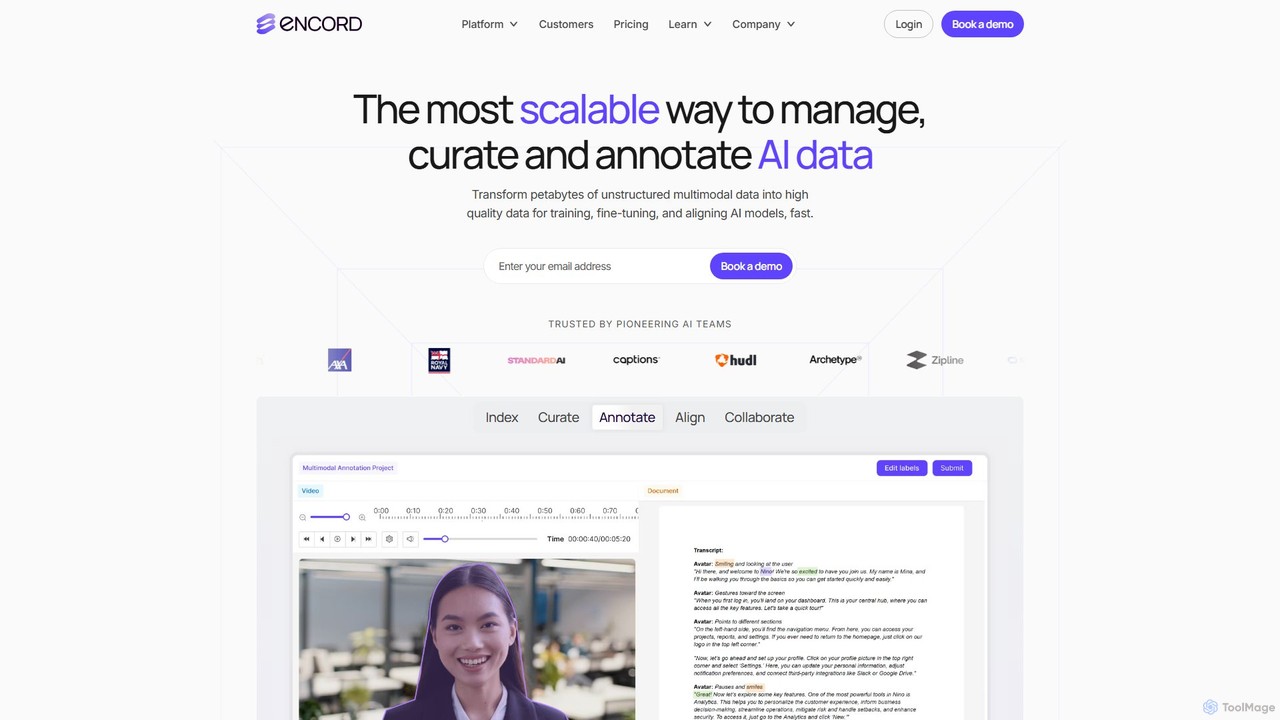
Encord
Encord es una plataforma integral de desarrollo de datos para IA visual y multimodal. Proporciona herramientas para gestionar, curar y anotar datos no estructurados a gran escala, como imágenes, vídeos y archivos DICOM. La plataforma ayuda a los equipos de IA a crear conjuntos de datos de alta calidad, mejorar el rendimiento de los modelos y acelerar el despliegue de aplicaciones de IA listas para producción mediante etiquetado avanzado, evaluación de modelos y flujos de trabajo con intervención humana.
AnotaciónDefinedCrowd
DefinedCrowd es un proveedor líder de datos de entrenamiento de IA de alta calidad. Aprovecha una comunidad global para recopilar, anotar y enriquecer datos para modelos de aprendizaje automático, especializándose en voz, PNL y visión por computadora. Ofrece un servicio totalmente gestionado para ayudar a las empresas a construir aplicaciones de IA robustas e imparciales a escala.
Aprendizaje AutomáticoRevelo
Revelo es una plataforma de talento de primer nivel que conecta a empresas con el 2% superior de desarrolladores de software preseleccionados de América Latina. Ofrece una solución de servicio completo, gestionando nóminas, beneficios y cumplimiento normativo, permitiendo a las empresas escalar sus equipos de ingeniería de forma rápida y rentable. Con alineación de zona horaria y ahorros significativos sobre las contrataciones en EE. UU., Revelo también proporciona servicios especializados de datos humanos para entrenar modelos de IA y LLM.
Etiquetado de DatosInnovatiana
Innovatiana es un servicio especializado que proporciona datos de entrenamiento de alta calidad y de origen ético para modelos de IA. Ofrecen creación de conjuntos de datos personalizados y etiquetado de datos para visión por computadora, PNL, IA generativa y procesamiento de documentos. Al emplear equipos dedicados y capacitados en lugar de crowdsourcing, Innovatiana garantiza una precisión de datos superior, seguridad y un desarrollo de IA responsable, ayudando a las empresas a construir modelos más robustos e imparciales.
Creación de Conjunto de DatosAlaya AI
Alaya AI es una plataforma de datos de IA descentralizada que conecta a una comunidad global con tareas de entrenamiento de IA. Proporciona soluciones de datos escalables y de alta calidad para desarrolladores a través de un modelo gamificado de 'entrenar para ganar', empoderando a usuarios de todo el mundo para contribuir al desarrollo de la IA y obtener recompensas.
Entrenamiento de Modelo
Cursor
Cursor es un editor de código AI-first diseñado para la programación en pareja con inteligencia artificial. Construido como una bifurcación de VS Code, ofrece un entorno familiar potenciado con capacidades avanzadas de IA para la generación de código, edición, depuración y comprensión del código base, con el objetivo de aumentar significativamente la productividad del desarrollador.
Asistente de Código
Emergent
Emergent es la primera plataforma de "vibe-coding" agéntica del mundo, diseñada para construir ambiciosas aplicaciones full-stack usando IA. Traduce descripciones en lenguaje natural e intenciones en código funcional, capacitando a desarrolladores y equipos para prototipar, construir e iterar en software más rápido que nunca.
Desarrollo
BLACKBOX.AI
BLACKBOX.AI es un agente de codificación de IA autónomo diseñado para acelerar el desarrollo de software. Ayuda a los desarrolladores a escribir código más rápido, depurar eficientemente e incluso puede construir aplicaciones completas a partir de imágenes o descripciones de texto, integrándose perfectamente con IDEs populares como JetBrains.
Asistente de Código
Kiro
Kiro es un Entorno de Desarrollo Integrado (IDE) impulsado por IA, diseñado para agilizar todo el ciclo de vida del desarrollo de software, desde el prototipo hasta la producción. Introduce un enfoque estructurado de desarrollo guiado por especificaciones, transformando indicaciones en lenguaje natural en requisitos claros, diseños de sistema y tareas ejecutables. Aprovechando agentes de IA, Kiro automatiza la codificación, las pruebas y la documentación, ayudando a los desarrolladores a construir aplicaciones complejas más rápido y con mayor calidad.
Asistente de Código
Datacurve Comments (0)
Sign in to comment.
Iniciar sesiónNo comments yet.