

SvectorDB Overview
SvectorDB est une base de données vectorielle sans serveur, puissante et centrée sur le développeur, qui rationalise le processus de création et de mise à l'échelle d'applications alimentées par l'IA. Elle est conçue pour gérer le gros du travail de la gestion des vecteurs, permettant aux développeurs de passer en toute transparence d'un prototype avec un seul vecteur à un environnement de production avec des millions de vecteurs. En tant que micro-startup transparente, SvectorDB est fière de sa communication directe, mettant en relation les utilisateurs avec les véritables créateurs du produit pour le support.
La plateforme est conçue pour la simplicité et l'efficacité, permettant aux développeurs d'intégrer des capacités de recherche vectorielle sophistiquées dans leurs projets avec un minimum de code. Elle prend en charge à la fois l'utilisation de vos propres embeddings et l'utilisation de ses vectoriseurs intégrés pour le texte et les images, offrant une flexibilité pour diverses tâches d'IA.
Comment utiliser SvectorDB
Démarrer avec SvectorDB est simple. Le processus consiste à configurer une base de données, puis à interagir avec elle à l'aide des SDK ou des intégrations fournis.
1. Configuration de la base de données : Tout d'abord, créez une base de données via le tableau de bord de SvectorDB. Vous devrez spécifier des paramètres tels que la dimension (par exemple, la taille de vos vecteurs), la métrique (par exemple, EUCLIDEAN pour le calcul de la distance), le type (par exemple, 'sandbox' pour le niveau gratuit) et la région.
2. Utilisation des SDK (JavaScript/Python) : Une fois la base de données créée, vous pouvez utiliser les clients officiels JavaScript ou Python pour interagir avec elle. Les opérations de base comprennent :
setItem: Créer ou mettre à jour un élément avec sa clé, sa valeur et sa représentation vectorielle.query: Effectuer une recherche de similarité basée sur un vecteur de requête ou trouver les vecteurs les plus proches de la clé d'un élément existant.embed: Utiliser des modèles intégrés pour générer des embeddings vectoriels directement à partir de texte ou d'images.
3. Intégration AWS CloudFormation : Pour une gestion automatisée de l'infrastructure, SvectorDB propose une intégration CloudFormation. Vous pouvez activer le fournisseur de ressources SvectorDB dans votre compte AWS, ajouter votre ID de compte AWS et votre clé d'intégration dans le tableau de bord SvectorDB, puis définir vos bases de données et vos clés API directement dans vos modèles CloudFormation. Cela permet une intégration CI/CD transparente et des pratiques d'infrastructure en tant que code.
Fonctionnalités principales de SvectorDB
- Nativement sans serveur : Fonctionne sur un modèle de paiement à la requête, éliminant le besoin de provisionnement, de gestion ou de mise à l'échelle de serveurs. Vous ne payez que pour ce que vous utilisez.
- Recherche hybride : Combine la recherche par similarité vectorielle avec le filtrage de métadonnées traditionnel à l'aide de requêtes de style Lucene/ElasticSearch, permettant des résultats plus précis et contextuels.
- Mises à jour instantanées : Les upserts (mises à jour ou insertions) et les suppressions sont reflétés instantanément, garantissant une grande cohérence des données sans les délais des modèles de cohérence éventuelle.
- Vectoriseurs intégrés : Fournit des vectoriseurs prêts à l'emploi pour le texte (par exemple, ALL_MINILM_L6_V2) et les images (par exemple, CLIP_VIT_BASE_PATH32), simplifiant le processus de génération d'embeddings.
- Support CloudFormation : S'intègre nativement avec AWS CloudFormation, permettant aux développeurs de gérer les ressources SvectorDB en tant que code au sein de leur infrastructure AWS existante.
- API conviviale pour les développeurs : Offre des SDK simples et intuitifs pour JavaScript et Python, conçus pour permettre aux développeurs d'être opérationnels en quelques minutes.
Cas d'utilisation pour SvectorDB
SvectorDB est idéal pour une gamme d'applications d'IA modernes :
- Moteurs de recommandation : En représentant les utilisateurs et les articles sous forme de vecteurs, SvectorDB peut rapidement trouver et suggérer les articles les plus pertinents aux utilisateurs en fonction de leur comportement et de leurs préférences.
- Recherche de documents / d'images : Transformez des données non structurées comme des documents et des images en vecteurs pour permettre une recherche sémantique et visuelle puissante. Cela va au-delà des mots-clés pour comprendre le sens et le contexte de la requête.
- Génération Augmentée par Récupération (RAG) : Augmentez les grands modèles de langage (LLM) avec un contexte pertinent et à jour récupéré de SvectorDB. Cela améliore la qualité, la précision et la pertinence du contenu généré, réduisant les hallucinations.
Avantages de SvectorDB
SvectorDB offre plusieurs avantages clés :
- Rapport coût-efficacité : La tarification à la requête est très compétitive et souvent nettement moins chère que les alternatives à capacité provisionnée comme Pinecone. Le niveau gratuit généreux permet un développement et des tests approfondis sans frais.
- Simplicité et rapidité : La plateforme est conçue pour minimiser la complexité, permettant un développement et un déploiement rapides des fonctionnalités d'IA.
- Évolutivité : S'adapte sans effort des petits projets aux applications avec des millions de vecteurs sans nécessiter de configuration ou d'intervention manuelle.
- Transparence : L'entreprise est ouverte sur ses limites (par exemple, limites d'enregistrement par défaut, pas de snapshots côté utilisateur) et fournit un accès direct à l'équipe principale pour le support, favorisant une relation de confiance avec ses utilisateurs.
Tarification et plans
La tarification de SvectorDB est transparente et basée sur l'utilisation.
- Niveau gratuit (Bases de données Sandbox) : Les utilisateurs peuvent créer jusqu'à 10 bases de données sandbox gratuites, chacune avec une limite de 5 000 enregistrements. Il n'y a pas de limite de temps sur le niveau gratuit.
- Bases de données standard (Paiement à la requête) :
- Stockage : 0,25 $ par Go par mois.
- Requêtes (Lectures) : 5,00 $ par million de requêtes. Une seule requête compte pour une opération de lecture, quel que soit le nombre de résultats retournés.
- Écritures (Puts/Deletes) : 20,00 $ par million de requêtes. Un seul appel put ou delete compte pour une opération d'écriture.
Ce modèle garantit que vous ne payez que pour les ressources que vous consommez, ce qui en fait un choix économique pour les projets à petite échelle comme pour les applications de production à grande échelle.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 1.6K
- 2026-1: 1.9K
- 2026-2: 2.4K
- 2026-3: 3.7K
- 2026-4: 1.5K
- 2026-5: 2.4K
Geography
Top 5 countries / regions
- 🇺🇸États-Unis51.7%
- 🇧🇷Brésil42.7%
- 🇮🇳Inde5.6%
Top keywords
| Keyword | Cost per click |
|---|---|
| aws vector database | $3.62 |
| aws vector db | $0.00 |
| aws vector dbs | $0.00 |
| is vectore db faster than document db? | $0.00 |
| pinecone pricing | $13.07 |
SvectorDB Alternatives
Superlinked
Superlinked est un framework Python et une infrastructure cloud, connu sous le nom de The Vector Computer, conçu pour les ingénieurs en IA. Il permet la création d'applications de recherche et de recommandation haute performance en combinant efficacement les données structurées et non structurées en embeddings vectoriels multimodaux.
Recherche vectorielle
infiniflow
infiniflow est une base de données open-source, native de l'IA et à haute performance, spécialement conçue pour les applications LLM. Elle offre une recherche vectorielle incroyablement rapide, de puissantes capacités de recherche hybride (vecteur, texte intégral, tenseur) et un déploiement simplifié. Avec une API Python intuitive, elle est conçue pour alimenter des tâches d'IA exigeantes comme la Génération Augmentée par Récupération (RAG) et la recherche sémantique avec une latence de l'ordre de la milliseconde.
Recherche vectorielle
Pinecone
Pinecone est une base de données vectorielle haute performance et entièrement gérée, conçue pour créer des applications d'IA expertes à grande échelle. Elle permet aux développeurs de mettre en œuvre des fonctionnalités avancées telles que la recherche sémantique, la génération augmentée par récupération (RAG) et les recommandations personnalisées en stockant et en interrogeant efficacement des milliards d'embeddings vectoriels en temps réel.
Base de données
Qdrant
Qdrant est une base de données vectorielles open-source et un moteur de recherche par similarité haute performance, construit en Rust. Il est conçu pour alimenter la prochaine génération d'applications d'IA en gérant et en recherchant efficacement des milliards de vecteurs de haute dimension. Avec des fonctionnalités avancées telles que le filtrage riche, le stockage de charges utiles et diverses méthodes de quantification, Qdrant permet aux développeurs de créer des solutions évolutives et rentables pour la recherche sémantique, les systèmes de recommandation et la Génération Augmentée par Récupération (RAG).
Recherche vectorielle
MyScale
MyScale est une base de données vectorielle haute performance qui combine de manière unique la recherche vectorielle avec la puissance de SQL. Elle est conçue pour la création d'applications d'IA avancées telles que RAG, la recherche sémantique et les systèmes de recommandation, simplifiant la pile technologique en permettant aux développeurs d'exécuter des requêtes hybrides sur des vecteurs et des données structurées à l'aide d'une seule interface familière.
Base de données vectorielleSvectorDB Categories
SvectorDB Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.
Related AI tools
Pinecone
Pinecone est une base de données vectorielle haute performance et entièrement gérée, conçue pour créer des applications d'IA expertes à grande échelle. Elle permet aux développeurs de mettre en œuvre des fonctionnalités avancées telles que la recherche sémantique, la génération augmentée par récupération (RAG) et les recommandations personnalisées en stockant et en interrogeant efficacement des milliards d'embeddings vectoriels en temps réel.
Base de donnéesQdrant
Qdrant est une base de données vectorielles open-source et un moteur de recherche par similarité haute performance, construit en Rust. Il est conçu pour alimenter la prochaine génération d'applications d'IA en gérant et en recherchant efficacement des milliards de vecteurs de haute dimension. Avec des fonctionnalités avancées telles que le filtrage riche, le stockage de charges utiles et diverses méthodes de quantification, Qdrant permet aux développeurs de créer des solutions évolutives et rentables pour la recherche sémantique, les systèmes de recommandation et la Génération Augmentée par Récupération (RAG).
Recherche vectorielleMyScale
MyScale est une base de données vectorielle haute performance qui combine de manière unique la recherche vectorielle avec la puissance de SQL. Elle est conçue pour la création d'applications d'IA avancées telles que RAG, la recherche sémantique et les systèmes de recommandation, simplifiant la pile technologique en permettant aux développeurs d'exécuter des requêtes hybrides sur des vecteurs et des données structurées à l'aide d'une seule interface familière.
Base de données vectorielleSuperlinked
Superlinked est un framework Python et une infrastructure cloud, connu sous le nom de The Vector Computer, conçu pour les ingénieurs en IA. Il permet la création d'applications de recherche et de recommandation haute performance en combinant efficacement les données structurées et non structurées en embeddings vectoriels multimodaux.
Recherche vectorielleinfiniflow
infiniflow est une base de données open-source, native de l'IA et à haute performance, spécialement conçue pour les applications LLM. Elle offre une recherche vectorielle incroyablement rapide, de puissantes capacités de recherche hybride (vecteur, texte intégral, tenseur) et un déploiement simplifié. Avec une API Python intuitive, elle est conçue pour alimenter des tâches d'IA exigeantes comme la Génération Augmentée par Récupération (RAG) et la recherche sémantique avec une latence de l'ordre de la milliseconde.
Recherche vectorielle
Milvus
Milvus est une base de données vectorielle open-source haute performance conçue pour les applications d'IA. Elle permet aux développeurs de gérer et de rechercher des milliards de vecteurs de haute dimension avec une latence minimale. Idéale pour construire des systèmes évolutifs comme la génération augmentée par récupération (RAG), les moteurs de recommandation et la recherche sémantique, Milvus offre des options de déploiement flexibles, du prototypage local aux clusters distribués à grande échelle.
Apprentissage automatique
Zilliz
Zilliz est une base de données vectorielle de niveau entreprise conçue pour les applications d'IA évolutives. Propulsée par le populaire projet open-source Milvus, elle fournit un service haute performance, rentable et entièrement géré (Zilliz Cloud) pour stocker, indexer et rechercher des milliards d'embeddings vectoriels. Elle est conçue pour alimenter des applications telles que le RAG, les systèmes de recommandation et la recherche multimodale, avec des intégrations transparentes dans les principaux frameworks d'IA et plateformes cloud.
Apprentissage Automatique
LanceDB
LanceDB est un lakehouse multimodal natif de l'IA et open-source, conçu pour construire et faire évoluer des applications d'IA. Il fournit une plateforme unifiée pour stocker, rechercher et gérer des données complexes telles que le texte, les images, la voix et les vecteurs. Idéal pour le RAG, la recherche sémantique et l'entraînement de modèles, LanceDB offre une recherche hybride ultra-rapide, une scalabilité massive jusqu'aux pétaoctets et des économies de coûts significatives, ce qui en fait une base puissante pour l'IA d'entreprise.
Base de données vectorielle
ragie
Ragie est une plateforme RAG-as-a-Service entièrement gérée, conçue pour les développeurs. Elle simplifie le processus de création et de déploiement d'applications d'IA en gérant l'ensemble du pipeline de Génération Augmentée par la Récupération (Retrieval-Augmented Generation). Connectez vos sources de données et utilisez une API simple pour alimenter des chatbots précis et contextuels, une recherche sémantique et des systèmes de gestion des connaissances, sans la complexité de la gestion de l'infrastructure.
Apprentissage automatique
Skald
Skald est une API RAG open-source conçue pour les développeurs afin de construire rapidement des agents IA sans la complexité de la gestion de l'infrastructure RAG. Elle simplifie le stockage des connaissances, la gestion du contexte et la recherche sémantique, offrant une solution puissante pour intégrer la mémoire à long terme dans les applications IA.
Chiffon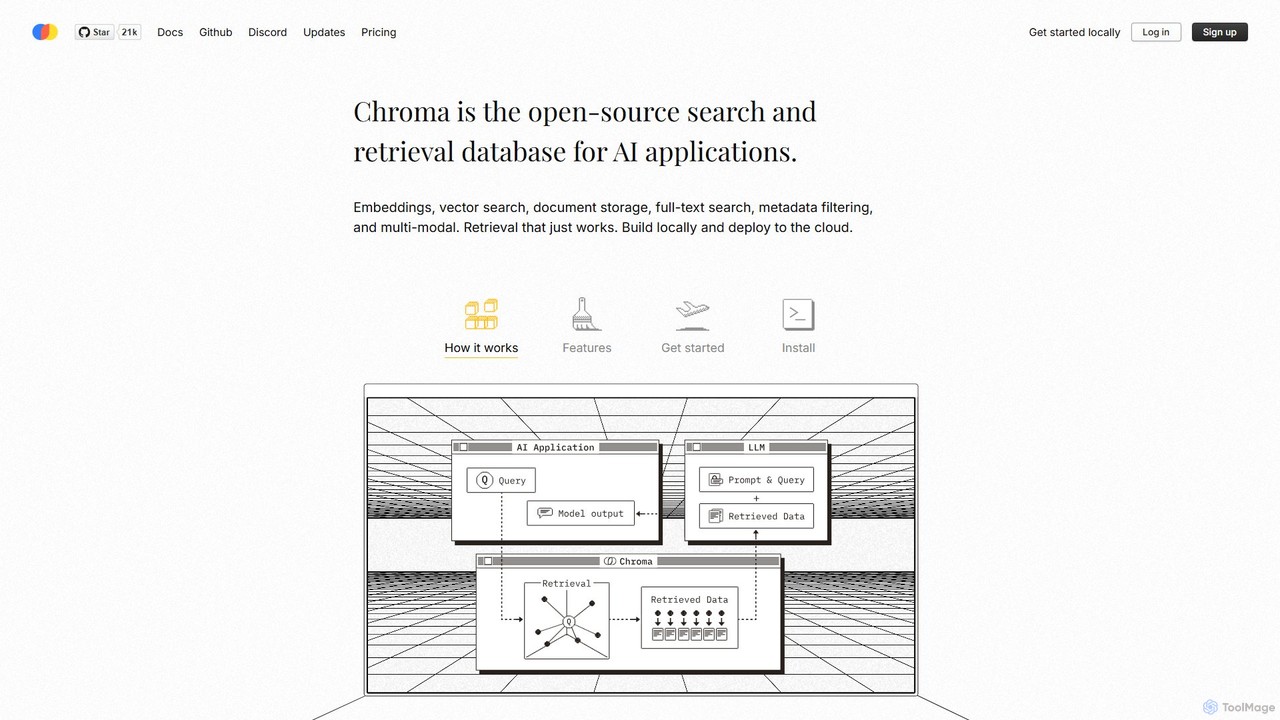
Chroma
Chroma est la base de données de recherche open-source et native pour l'IA, conçue pour créer de puissantes applications d'IA avec la Génération Augmentée par la Récupération (RAG). Elle simplifie le stockage et la recherche d'embeddings, de documents et de métadonnées, offrant une recherche vectorielle, une recherche plein texte et une plateforme cloud évolutive et sans serveur. Elle est conçue pour être simple d'utilisation, rentable et puissante, du développement local à la production à grande échelle.
Base de données vectorielle
Weaviate
Weaviate est une base de données vectorielle open-source et native IA conçue pour les développeurs. Elle permet une recherche vectorielle, par mot-clé et hybride, évolutive et à faible latence. Idéale pour créer des applications d'IA telles que la recherche sémantique, les moteurs de recommandation et les systèmes de Génération Augmentée par Récupération (RAG), elle s'intègre de manière transparente avec les modèles de machine learning populaires pour stocker et interroger des données en fonction de leur signification sémantique.
Base de données vectorielle
SurrealDB
SurrealDB est une base de données cloud multimodèle de nouvelle génération, conçue pour les applications modernes. Elle simplifie le développement backend en unifiant les modèles de document, relationnel, graphe et série temporelle avec une recherche plein texte, une recherche vectorielle et un apprentissage automatique intégrés à la base de données. Conçue pour la scalabilité et les données en temps réel, elle permet aux développeurs de créer des applications complexes et alimentées par l'IA avec une facilité et une vitesse sans précédent.
Base de données vectorielle
Activeloop
Activeloop fournit Deep Lake, une base de données spécialisée pour l'IA, conçue pour gérer, interroger et diffuser des ensembles de données multimodales à grande échelle (texte, images, audio, vidéo) afin de créer des applications d'IA avancées. Elle simplifie l'infrastructure de données complexe, permettant aux développeurs de créer facilement de puissants systèmes de Génération Augmentée par la Récupération (RAG), des moteurs de recherche sémantique et des agents d'IA intelligents.
Gestion des Données
Vespa.ai
Vespa.ai est une plateforme de recherche IA haute performance pour la création d'applications à grande échelle. Elle unifie la recherche vectorielle, la recherche textuelle et le classement par apprentissage automatique pour alimenter des cas d'utilisation avancés tels que la Génération Augmentée par Récupération (RAG), les moteurs de recommandation et la recherche intelligente. Conçue pour l'inférence en temps réel et la scalabilité, elle est utilisée par des entreprises de premier plan comme Spotify et Perplexity pour traiter des ensembles de données massifs avec une faible latence.
Recherche
SvectorDB Comments (0)
Sign in to comment.
ConnexionNo comments yet.