Crawly
ウェブスクレイピング
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
ウェブスクレイピング
ウェブスクレイピング
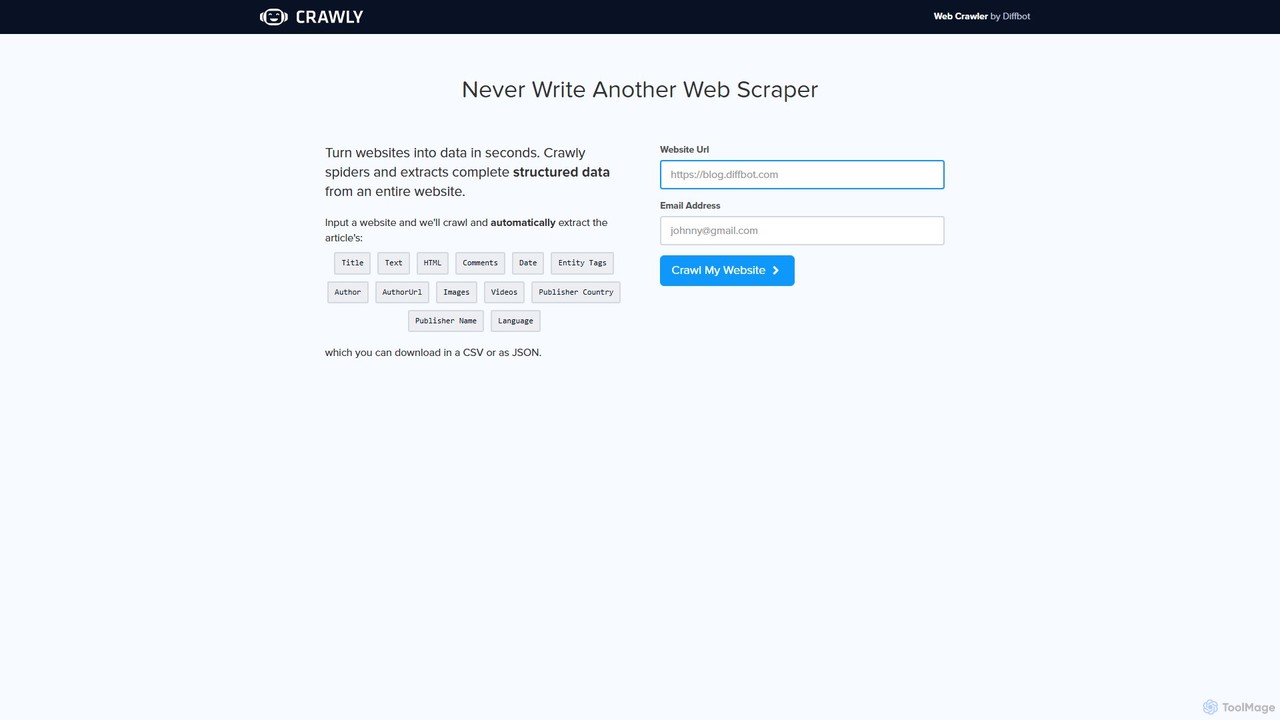
CrawlyはDiffbotが開発したAI搭載のウェブクローラーで、ウェブサイト全体から構造化データを自動的に抽出します。URLを入力するだけで、Crawlyがサイトをスパイダーし、記事、製品、ディスカッションなどの重要な情報を取得し、コーディング不要でクリーンなJSONまたはCSVデータに変換します。
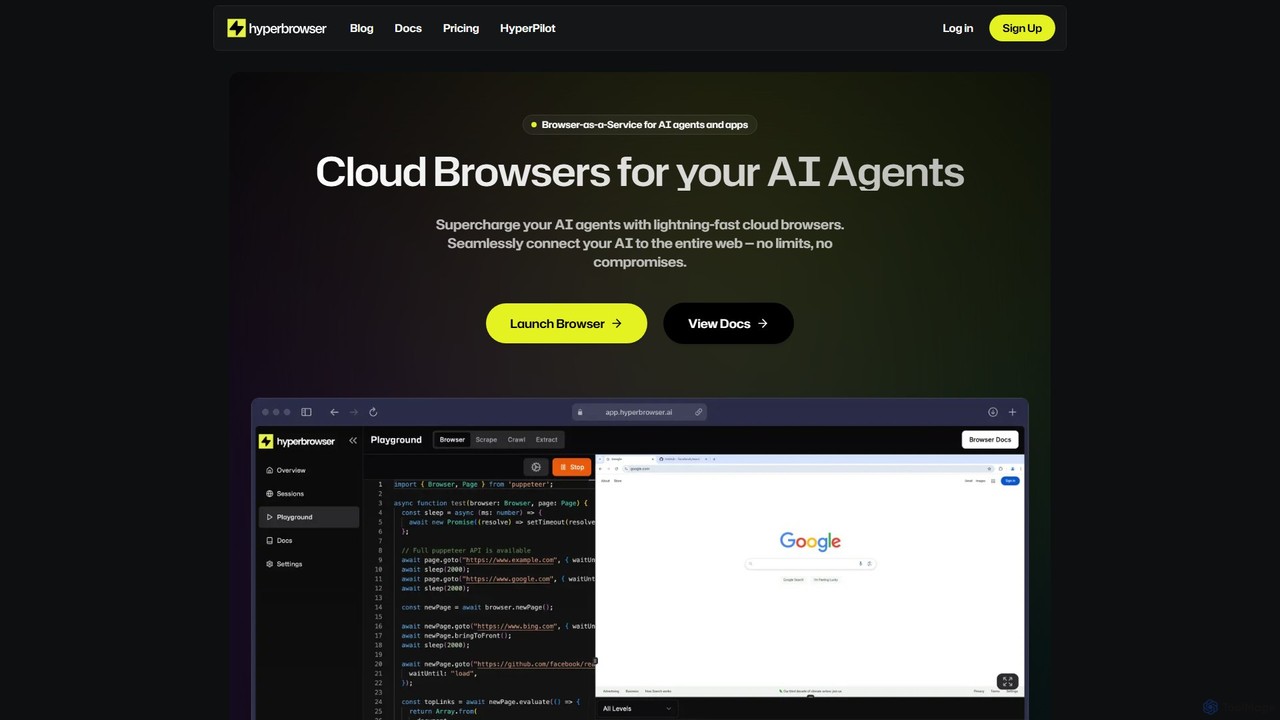
Hyperbrowserは、AIエージェントと開発者向けに設計されたBrowser-as-a-Service(BaaS)プラットフォームです。スケーラブルで超高速なクラウドブラウザを提供し、ウェブタスクの自動化、データ抽出、AI駆動のウェブインタラクションを可能にします。ステルスブラウジング、自動キャプチャ解決、開発者フレンドリーなAPIなどの機能により、複雑なワークフローを制限なく強化します。
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| 基本情報 | Crawly | Hyperbrowser |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | ウェブスクレイピング | ウェブスクレイピング |
| 対象ユーザーと職種 | 未確認 | 未確認 |
| カテゴリー | ウェブスクレイピング · API · 市場調査 · 自動化 | ウェブスクレイピング · API · 自動化 |
| Added | 2025/08/10 | 2025/08/05 |
| 更新 | 2026/11/19 | 2026/11/19 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
Crawlyは、AIによるデータ抽出のリーダーであるDiffbotによって開発された、強力でインテリジェントなウェブクローラーです。ウェブスクレイピングの手作業や技術的な課題を完全に排除することを目的として設計されています。Crawlyは、複雑なコードを書いたり、ウェブサイトの更新で壊れやすいセレクタを使用したりする代わりに、コンピュータビジョンや自然言語処理を含む高度な人工知能を活用して、人間のようにウェブページを理解し解釈します。これにより、単一のURLを入力するだけで、ウェブサイト全体から完全な構造化データを自動的に識別し抽出することが可能になります。
Crawlyの核心的な約束は、「ウェブサイトを数秒でデータに変える」ことです。ウェブサイト内をナビゲートし、リンクをたどり、各ページの構造を分析して、記事、製品、ディスカッション、画像ギャラリーなどのさまざまなコンテンツタイプを区別します。抽出されたデータは、その後、クリーンで構造化された形式に整理され、アプリケーション、データ分析、または機械学習モデルですぐに使用できる状態になります。
Crawlyの使い方は、技術的なスキルに関係なく、誰にでも非常にシンプルでアクセスしやすいように設計されています。プロセスはわずか数ステップで完了します:
Crawlyは、幅広い用途に適した多目的なツールです:
Crawlyの主な利点は、そのシンプルさとパワーです。ウェブデータ抽出を民主化し、通常はエンジニアチームが必要なタスクを非開発者が実行できるようにします。スクレイピングプロセス全体を自動化することで、膨大な時間とリソースを節約します。さらに、AI駆動のアプローチにより、従来の方法よりも高い精度と優れた回復力が保証され、信頼性の高い高品質なデータストリームを提供します。Diffbotの製品であるため、世界中の主要企業から信頼されているエンタープライズグレードの技術に支えられています。
Crawlyは、ホームページから直接無料のトライアルクロールを提供しており、ユーザーはURLとメールアドレスを入力するだけでその機能を試すことができます。これは、ツールが生成できる構造化データのサンプルを提供することを目的としています。大規模なクロール、頻繁なデータ抽出、またはプログラムによる使用のためのAPIアクセスなど、より広範なニーズに対しては、通常、親会社であるDiffbotが提供するツールのフルスイートに登録する必要があります。Diffbotの価格は階層化されており、スタートアップ、ビジネス、大企業向けのプランが用意され、異なるレベルのAPIコールと機能を提供しています。
Hyperbrowserは、AIエージェントとアプリケーションをウェブ全体に接続するために構築された、強力なBrowser-as-a-Service(BaaS)プラットフォームです。開発者に高速で安全、かつスケーラブルなクラウドブラウザのフリートへのアクセスを提供し、ローカルのブラウザインスタンスを管理する複雑さを解消します。このサービスは、大規模なウェブスクレイピング、ブラウザの自動化、洗練されたAIエージェントが人間のようにウェブサイトと対話できるようにするなど、要求の厳しいタスクに特化して設計されています。分離されたコンテナでヘッドレスブラウザを提供することにより、Hyperbrowserは、単純なデータ抽出から複雑でミッションクリティカルな自動化ワークフローまで、あらゆるプロジェクトで信頼性、セキュリティ、および最高のパフォーマンスを保証します。
Hyperbrowserの利用開始は、開発者向けに設計された簡単なプロセスです。まず、ウェブサイトでサインアップしてアカウントを作成し、一意のAPIキーを取得します。クレジットカード不要の寛大な無料プランから始めることができます。キーを取得したら、PythonおよびNodeJS向けの使いやすいSDKを使用するか、APIに直接cURLリクエストを送信することで、Hyperbrowserをアプリケーションに統合できます。プラットフォームは、OpenAI ToolsやAnthropic Toolsなどの人気のあるAIフレームワークとの統合を含む、明確なドキュメントとコード例を提供します。たとえば、ブラウザセッションを起動し、AIエージェントにタスク(例:「DoordashでBurma Loveのガーリックヌードルを注文する」)を割り当て、Hyperbrowserにウェブインタラクション全体を管理させ、構造化された結果を返させることができます。
Hyperbrowserは多用途であり、幅広いシナリオに適用できます。主な使用例には、大規模なウェブスクレイピングがあり、ユーザーはブロックされることなくGoogle検索結果やShopifyなどのeコマースサイトから数百万ページのデータを抽出・構造化できます。もう一つの重要な応用は、AIウェブエージェントの動力源となり、予約、購入、詳細な競合分析などの複雑なアクションを実行できるようにすることです。また、自動ソフトウェアテストにも非常に価値があり、開発者は実際のブラウザ環境で大規模なエンドツーエンドテストを実行できます。さらに、企業は競合他社の価格、製品、マーケティング戦略に関するデータ収集を自動化することで、市場調査と競合分析に利用しています。
Hyperbrowserの主な利点は、スケーラブルで信頼性が高く、検出不可能なブラウザ自動化を提供する能力です。プラットフォームは99.9%の稼働時間を保証し、ミッションクリティカルなアプリケーションに適しています。その超高速、サブ秒のブラウザ起動時間は、オンデマンドでの迅速なスケーリングを可能にします。組み込みのフォールトトレランスと自動回復メカニズムにより、ワークフローは回復力があり信頼性が高くなります。最も重要なのは、その高度なステルス機能と自動キャプチャ解決が、ボット対策によってブロックされる可能性のあるウェブ自動化タスクの成功率を大幅に向上させることです。
Hyperbrowserは、さまざまなニーズに合わせてフリーミアムモデルを備えた、柔軟で透明性の高い料金体系を提供しています。
無料プラン:月額$0、1,000クレジット、同時ブラウザ1台、7日間のデータ保持、基本ステルスモードが含まれます。
スタートアッププラン:月額$30(+従量課金)、30,000クレジット、同時ブラウザ25台、30日間のデータ保持、自動キャプチャ解決、基本ステルスモードが含まれます。
スケールプラン:月額$100(+従量課金)、100,000クレジット、同時ブラウザ100台、30日間のデータ保持、自動キャプチャ解決、高度ステルスモードが含まれます。
エンタープライズプラン:大量利用向けのカスタム価格設定。250台以上の同時ブラウザ、180日以上のデータ保持、プレミアムサポート、HIPAA/SOC 2などのコンプライアンスオプションを提供します。
使用量は、クレジットあたり$0.001、ブラウザ時間あたり$0.10、プロキシデータGBあたり$10で請求されます。
分類情報から、製品同士の重なりとそれぞれの明確な焦点が分かります。 未確認の項目は明示し、推測で補完しません。
市場での可視性の差を正しく示すため、同じ尺度で比較しています。
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇳🇬Nigeria | 82.43% | 1.5K |
| 🇩🇪Germany | 9.9% | 177 |
| 🇨🇦Canada | 7.67% | 137 |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 43.97% | 31.4K |
| 🇮🇳India | 28.23% | 20.2K |
| 🇻🇳Vietnam | 12.18% | 8.7K |
| 🇧🇷Brazil | 8.2% | 5.9K |
| 🇩🇪Germany | 7.42% | 5.3K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| ダイレクト | 91.73% | 65.5K |
| 参照元 | 7.22% | 5.2K |
| Eメール | 1.05% | 750 |
評価や反応は参考指標であり、製品適合性そのものではありません。
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.