
Fireworks AI Overview
Fireworks AIは、比類のない速度と効率で生成AIアプリケーションを構築、カスタマイズ、スケールさせるために設計された最先端の開発者プラットフォームです。最速の推論プラットフォームとして位置づけられ、開発者や企業がわずか数行のコードでLlama、Mistral、DeepSeek、QwenなどのオープンソースAIモデルを実行し、ファインチューニングできるようにします。このプラットフォームは、高度に最適化された推論エンジンであるFireAttention上に構築されており、リアルタイムのパフォーマンス、最小限のレイテンシー、高いスループットを提供し、ミッションクリティカルなアプリケーションに最適です。Fireworks AIはGPU管理の複雑さを抽象化し、ユーザーが革新的なAI製品の構築に集中できるようにします。
Fireworks AIの使い方
Fireworks AIの使用は、開発者にとって合理化されたプロセスです。まず、ウェブサイトでサインアップしてプラットフォームへのアクセス権を取得し、初期の無料クレジットを受け取ります。その後、直感的なSDKを使用するか、直接APIコールを行って、数百の事前にサポートされているオープンモデルで実験を開始できます。プラットフォームはOpenAIと互換性があり、移行が容易です。カスタムニーズに合わせて、教師ありファインチューニング(SFT)や強化学習ファインチューニング(RFT)などの高度な技術を使用してデータをアップロードし、モデルをファインチューニングできます。モデルの準備ができたら、柔軟なデプロイメントオプションのいずれかを使用してデプロイできます。コールドスタートなしでトークンごとに支払う簡単な使用のためのサーバーレス、または専用のGPUリソースを提供し、より高いレート制限と大規模での低コストを提供するオンデマンドデプロイメントです。
Fireworks AIの主な機能
- 超高速推論エンジン:独自のFireAttentionエンジンを搭載し、業界をリードする速度、低レイテンシー、高スループットを提供し、vLLMなどの標準的な推論エンジンを大幅に上回ります。
- 広範なオープンモデルライブラリ:Llama 3.1、Mixtral、Qwen、DeepSeekを含む、テキスト、ビジョン、オーディオ、画像生成のための数百の人気オープンソースモデルに即座にアクセスできます。ユーザーはカスタムモデルをアップロードすることもできます。
- 高度なファインチューニングとカスタマイズ:特定のユースケースで最高の品質を達成するために、教師ありファインチューニング(SFT)、強化学習ファインチューニング(RFT)、量子化対応チューニングなど、洗練されたモデルカスタマイズツールを提供します。
- Multi-LoRAサービング:追加のサービングコストなしで、単一のデプロイメントに数百のファインチューニングされたLoRAアダプターをデプロイし、大規模なパーソナライゼーションと実験を効率的に可能にします。
- 柔軟なデプロイメントオプション:プロトタイピングから大規模な本番環境まで、さまざまな規模と要件に合わせて、サーバーレス(トークンごと)、オンデマンド(GPU秒ごと)、エンタープライズリザーブドキャパシティを提供します。
- マルチモーダル機能:テキスト生成、音声テキスト変換、画像生成、視覚言語理解など、幅広いAIタスクをサポートします。
- 複合AIと構造化出力:関数呼び出し、JSONモード、文法モードなどの機能により、他のツールやAPIと対話できる複雑で信頼性の高いAIシステムを構築できます。
- エンタープライズグレードのセキュリティとスケーラビリティ:SOC2 Type II、GDPR、HIPAAに準拠し、高可用性とシームレスなスケーリングのために10以上のクラウドと15以上の地域にグローバルに展開しています。
Fireworks AIの使用例
Fireworks AIは、Notion、Sourcegraph、Quoraなどの主要企業によってさまざまなアプリケーションで信頼されています。一般的なユースケースは次のとおりです。
- リアルタイムAIエージェント:最小限のレイテンシーで応答性の高い音声エージェントとチャットボットを構築。
- AI搭載開発者ツール:SourcegraphのCodyのような、高速なコード補完とAI搭載検索を備えた高度なコーディングアシスタントを作成。
- エンタープライズRAGシステム:Notionで見られるように、大規模な検索拡張生成(RAG)ワークフローを強化し、正確で文脈を意識した回答を提供。
- 大規模なパーソナライズAI:Quoraのドメイン固有の基盤モデルなど、さまざまなユーザーやドメイン向けに数千のカスタムモデルを提供。
- 高スループットのメディア処理:コンテンツ作成および分析プラットフォーム向けに、高速な音声文字起こしと画像生成を実行。
Fireworks AIの利点
Fireworks AIの主な利点は、その極めて高いパフォーマンスです。顧客の声は、大幅なレイテンシーの削減(例:Notionで2秒から350ミリ秒へ)を強調しており、リアルタイムのユーザーエクスペリエンスを可能にしています。最適化されたエンジンやMulti-LoRAサービングなどの革新的な機能によって達成されるコスト効率も、もう一つの重要な利点です。このプラットフォームは、通常の複雑さなしに深いカスタマイズを提供し、高度なAIをアクセスしやすくします。最後に、堅牢なSDK、広範なドキュメント、シームレスなスケーラビリティを備えた開発者中心のアプローチにより、チームはアイデアから本番まで迅速かつ確実に移行できます。
料金プラン
Fireworks AIは、新規ユーザー向けの1ドルの無料クレジットから始まるフリーミアムの従量課金モデルで運営されています。料金はサービスごとに分類されています。
- サーバーレス推論:100万トークンごとに請求され、料金はモデルサイズによって異なります(例:4B-16Bモデルで0.20ドル、>16Bモデルで0.90ドル)。
- ファインチューニング:100万トレーニングトークンごとに課金されます(例:最大16Bパラメータのモデルで0.50ドル)。ファインチューニングされたモデルのサービングコストはベースモデルと同じです。
- 音声テキスト変換:オーディオ分単位で価格設定されます(例:Whisper-v3-largeで0.0015ドル/分)。
- 画像生成:モデルに応じて、ステップごとまたは画像ごとに請求されます。
- オンデマンドデプロイメント:NVIDIA H100(5.80ドル/時)やA100(2.90ドル/時)などの専用ハードウェアに対してGPU秒単位で支払い、より高いスループットとレート制限なしを提供します。
この柔軟な構造により、ユーザーは特定の利用パターンと規模に基づいてコストを最適化できます。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 284.6K
- 2026-1: 355.9K
- 2026-2: 323.2K
- 2026-3: 438.1K
- 2026-4: 720.8K
- 2026-5: 610.7K
Geography
Top 5 countries / regions
- 🇺🇸アメリカ合衆国55.9%
- 🇻🇳ベトナム15.8%
- 🇮🇳インド11.5%
- 🇷🇺ロシア9.3%
- 🇨🇳中国7.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 90.6% |
Referral | 7.1% |
Email | 2.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| fireworks | $0.00 |
| fireworks ai | $0.00 |
| fireworks ai careers | $0.00 |
| kimi ai | $0.38 |
Fireworks AI Videos on YouTube




Fireworks AI

Fireworks AI
Fireworks AI Alternatives
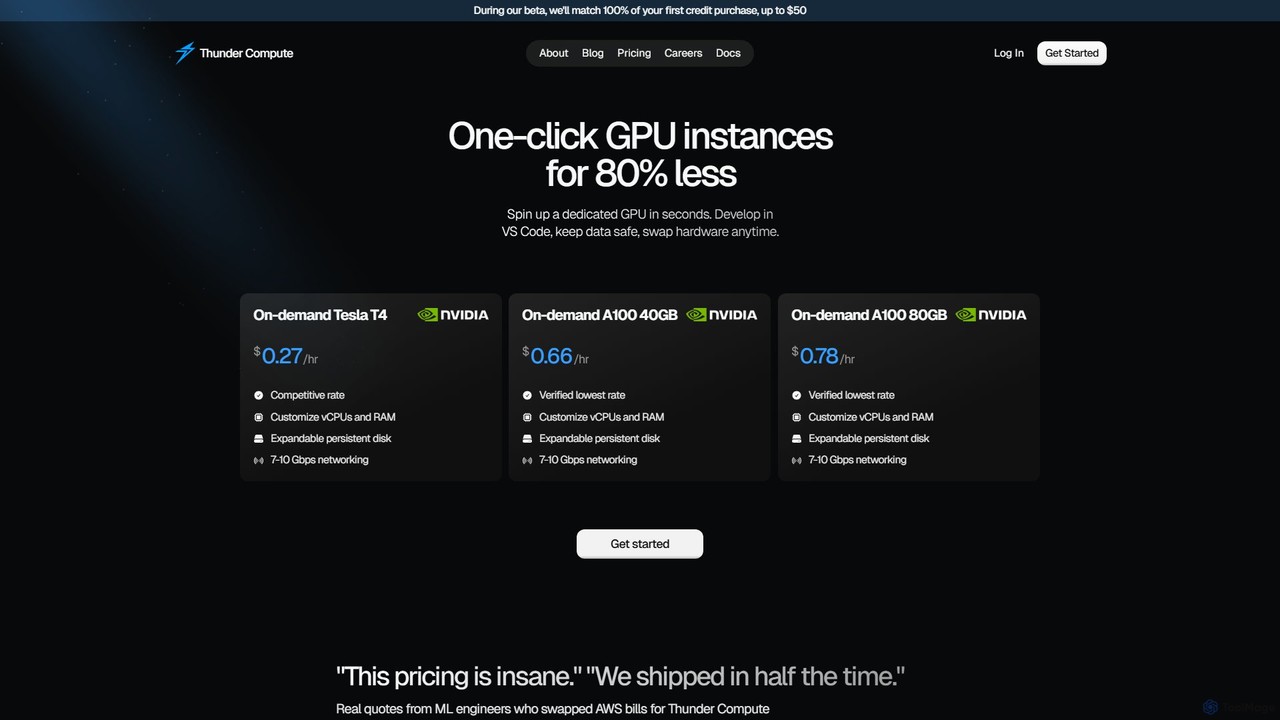
thundercompute
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習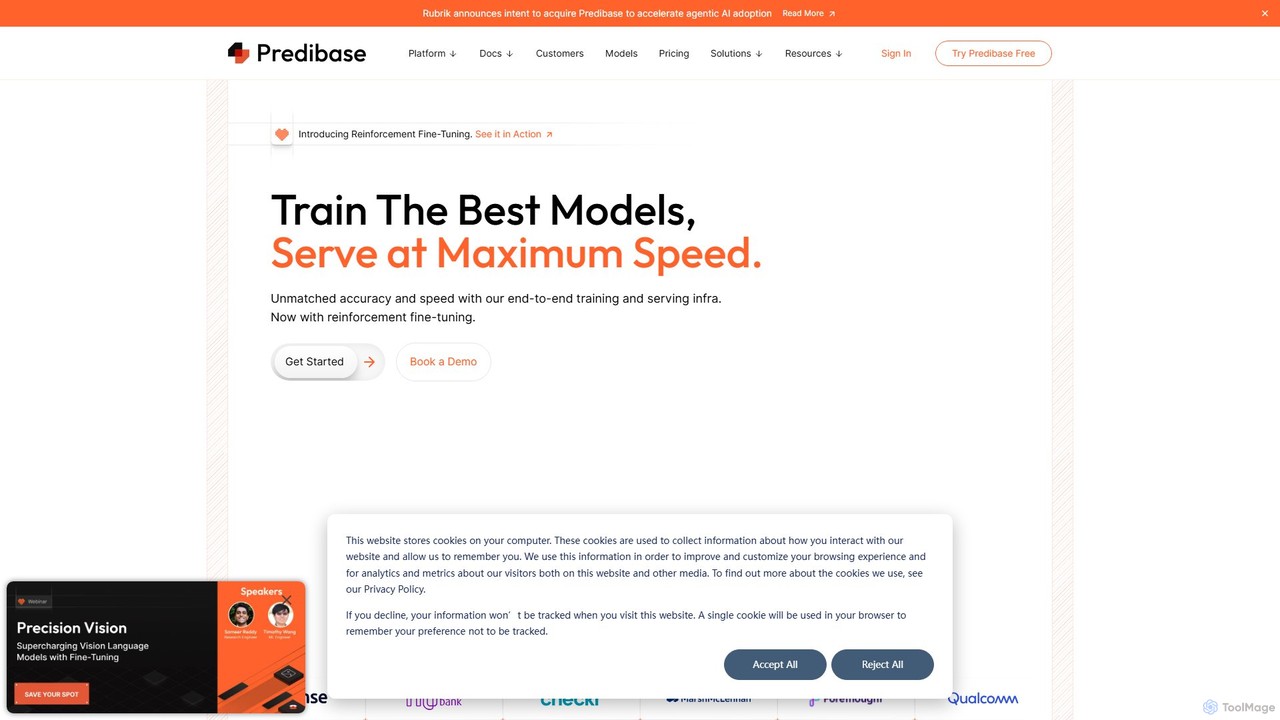
Paperspace
Paperspaceは、AIと機械学習のために設計された高性能クラウドコンピューティングプラットフォームです。強力なクラウドGPU、管理されたJupyterノートブック、モデルの構築、トレーニング、デプロイを行うための完全なMLOpsプラットフォーム(Gradient)への簡単なアクセスを提供します。インフラ管理の複雑さなしにAIワークフローを加速させたい開発者、データサイエンティスト、企業に最適です。
機械学習
FinetuneDB
FinetuneDBは、開発者向けのオールインワンAIファインチューニングプラットフォームです。高品質なデータセットの構築、Llama 3やGPT-4o miniなどのモデルのファインチューニングから、単一の安全なプラットフォーム上でのデプロイと継続的な評価まで、カスタム大規模言語モデル(LLM)作成の全ワークフローを簡素化します。
LlmopsFireworks AI Categories
Fireworks AI Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Together AI
Together AIは、開発者向けの主要なクラウドプラットフォームであり、オープンソースの生成AIモデルを実行、ファインチューニング、トレーニングするための高速でコスト効率の高いインフラストラクチャを提供します。200以上のモデルの広範なライブラリ、サーバーレス推論API、カスタマイズ可能なファインチューニング、専用GPUクラスタを提供し、AIアプリケーションの構築とスケーリングのためのエンドツーエンドソリューションを構築します。
GPUインフラ
MonsterAPI
MonsterAPIは、オープンソースの生成AIモデルのファインチューニングとデプロイを簡素化する開発者中心のプラットフォームです。Llama、SDXL、Whisperなどのモデルをサポートするノーコードのチャットインターフェース「MonsterGPT」を提供します。このプラットフォームは、スケーラブルなAPIエンドポイントとエンタープライズ級のGPUインフラを、従来の数分の一のコストと時間で提供し、高度なAIをすべての開発者が利用できるようにします。
サービスとしてのプラットフォーム (PaaS)FinetuneDB
FinetuneDBは、開発者向けのオールインワンAIファインチューニングプラットフォームです。高品質なデータセットの構築、Llama 3やGPT-4o miniなどのモデルのファインチューニングから、単一の安全なプラットフォーム上でのデプロイと継続的な評価まで、カスタム大規模言語モデル(LLM)作成の全ワークフローを簡素化します。
Llmops
Mistral AI
Mistral AIは、オープンソースで高性能な大規模言語モデル(LLM)を提供する主要なAI企業です。多機能AIアシスタント「Le Chat」と強力な開発者プラットフォーム「La Plateforme」を提供し、個人および企業ユーザー向けに設定可能性、効率性、プライバシーを重視しています。
企業ソリューション
fal.ai
開発者向けの生成メディアプラットフォームで、画像、動画、3D向けの高度なAIモデルを実行およびファインチューニングするための超高速APIを提供します。最大4倍高速な推論速度で最先端のモデルにアクセスできます。
API & インフラ
Runware
Runwareは、開発者が画像および動画生成のための生成AIを統合するための、高性能かつ低コストのAPIを提供します。カスタムハードウェアと再生可能エネルギーを活用し、Stable Diffusion、FLUX.1、Klingなど30万以上のモデルに対して業界トップクラスの推論速度を実現します。MLの専門知識を必要としない、スケーラブルで使いやすいプラットフォームであり、次世代のAIネイティブアプリケーションの構築のために設計されています。
APIプラットフォーム
Xunfei Spark Agent Development Platform
iFlytekによるワンストップのAIエージェント開発プラットフォームです。Spark大規模言語モデルを搭載し、開発者がローコードインターフェース、豊富なプラグインマーケットプレイス、堅牢な管理ツールを通じて、ライフサイクル全体をカバーするインテリジェントなAIアプリケーションを構築、デバッグ、展開できるようにします。
エージェントビルダー
Fireworks AI Comments (0)
Sign in to comment.
ログインNo comments yet.