
Unsloth Overview
Unslothは、大規模言語モデル(LLM)のカスタマイズにおける2つの大きな課題、すなわちトレーニング速度とメモリ消費を解決するために開発された、革命的なオープンソースAIライブラリです。専任チームによって開発されたUnslothは、手動で導出された数学的最適化と手書きのGPUカーネルを採用することで、ファインチューニングの効率を再定義します。この革新的なアプローチにより、開発者、研究者、企業は、Llama、Mistral、GemmaなどのモデルをFlash Attention 2のような標準的な手法よりも最大30倍高速にトレーニングし、メモリ使用量を驚異的な90%削減することができます。これは、かつて1ヶ月かかっていたタスクがわずか24時間で完了し、強力なモデルが単一のコンシューマー向けGPUでファインチューニングできることを意味します。
Unslothの核心的な魔法は、ハードウェアレベルでの深い最適化にあります。汎用的な高レベルライブラリに頼るのではなく、Unslothの作成者は第一原理に立ち返り、トレーニングプロセスで最も計算量の多いステップを書き直してGPU効率を最大化しました。これにより、トレーニングが高速化するだけでなく、推論速度も最大2倍向上し、ファインチューニングされたモデルの迅速なデプロイが可能になります。Unslothはスケーラビリティを考慮して設計されており、単一GPU、マルチGPUシステム、さらにはエンタープライズレベルのタスク向けのマルチノードクラスタでも卓越したパフォーマンスを発揮します。
Unslothの使い方
Unslothの使用は、PythonとHugging Faceエコシステムに精通している人なら誰でも簡単にできるように設計されています。プロセスは通常、以下のステップを含みます:
- インストール: 通常は簡単なpipコマンドで、UnslothライブラリをPython環境にインストールします。ライブラリはオープンソースのフリーウェアとして利用可能です。
- インポートとモデルのロード: トレーニングスクリプトで、Unslothから`FastLanguageModel`をインポートします。Hugging Faceの`transformers`から直接モデルをロードする代わりに、Unslothの関数を使用してベースモデルをロードします。この関数は、必要なすべてのパフォーマンスパッチと最適化を自動的に適用します。このステップでモデル名(例:'unsloth/llama-3-8b-Instruct-bnb-4bit')とデータ型(例:4ビット量子化)を指定できます。
- LoRAアダプタの追加: Unslothは、モデルにLoRA(Low-Rank Adaptation)アダプタを追加するプロセスを簡素化します。LoRAパラメータ(`r`、`lora_alpha`、`target_modules`など)を設定し、1行のコードでモデルに適用できます。
- データ準備: Hugging Faceのファインチューニングタスクで通常行うように、トレーニングデータセットを準備します。
- トレーニング: Hugging Faceの`SFTTrainer`または同様のトレーニングクラスを使用し、Unslothで最適化されたモデル、データセット、トレーニング引数を渡します。Unslothはこのワークフローとシームレスに統合され、バックプロパゲーションと最適化のステップを自動的に高速化します。
- 推論: トレーニングが完了したら、ファインチューニングされたモデルを推論に使用できます。このプロセスもUnslothの速度向上の恩恵を受けます。
Unslothの主な機能
- 極端な速度向上: Flash Attention 2などの標準的な実装と比較して、最大30倍高速なトレーニングとファインチューニング。
- 大幅なメモリ削減: VRAM使用量を最大90%削減し、コンシューマー向けGPU(Tesla T4やGeForce RTXシリーズなど)での大規模モデルのファインチューニングを可能にします。
- 手書きのGPUカーネル: 中核となる数学演算は、ハードウェアのパフォーマンスを最大化するために手動で最適化されており、汎用ライブラリの能力を上回ります。
- 幅広いモデルサポート: Llama 1/2/3、Mistral、Gemma、Qwen、DeepSeekなど、人気のオープンソースLLMを幅広くネイティブサポート。
- 量子化サポート: 4ビットおよび16ビットのLoRAファインチューニングを完全にサポートし、トレーニングをさらにメモリ効率的にします。
- スケーラビリティ: シングルGPU、マルチGPU(最大8基)、マルチノード(エンタープライズ)構成に最適化されています。
- 高速な推論: トレーニング後に最大2倍の推論速度を実現し、モデルのデプロイをより効率的にします。
- 精度向上: エンタープライズプランでは、特定のタスクでモデルの精度を最大30%向上させる機能を提供します。
Unslothの使用例
Unslothは、LLMを扱うすべての人にとって多目的なツールです:
- AIスタートアップ: 莫大なクラウドコンピューティングコストをかけずに、ニッチなアプリケーション向けのカスタム専門モデルを構築し、反復開発する。
- 学術研究者: 限られた大学のハードウェア予算で研究サイクルを加速し、より多くの実験を実行する。
- 企業のMLOpsチーム: 顧客サポート、文書分析、コード生成などのタスクのための内部モデルのトレーニングコストと時間を大幅に削減する。
- 個人開発者・愛好家: 個人のコンピュータでLLMのファインチューニングを実験・学習し、最先端のAI開発への参入障壁を下げる。
- データサイエンティスト: 特定のデータセットでモデルを迅速にファインチューニングし、洞察を抽出したり、ビジネスインテリジェンスのための予測ツールを構築したりする。
Unslothの利点
Unslothの主な利点は、その比類のない効率性です。速度とメモリという核心的なボトルネックに取り組むことで、強力なAIカスタマイズへのアクセスを民主化します。これにより、GPUハードウェアとクラウドサービスのコストが大幅に削減されます。オープンソースであることは透明性とコミュニティ主導の改善を促進し、Hugging Faceエコシステムとのシームレスな統合は、この分野の誰もが容易に採用できることを保証します。最終的に、Unslothはユーザーがより少ないリソースでより多くのことを達成できるようにし、かつてはリソース集約的だったプロセスを高速でアクセスしやすいものに変えます。
料金プラン
Unslothは、3つの異なる階層を持つフリーミアムモデルで運営されています:
- 無料: これはUnslothのオープンソース、フリーウェア版です。2倍の速度向上、60%のVRAM削減を提供し、シングルGPU設定をサポートします。個人や小規模プロジェクトに最適で、Mistral、Gemma、Llamaなどのモデルの4ビットおよび16ビットLoRAファインチューニングをサポートします。
- Unsloth Pro: プロフェッショナルやチームを対象としたこのプランは、GPUあたり2.5倍の速度向上、80%のVRAM削減、強化されたマルチGPUサポート(最大8基)を提供します。このプランは、より高いパワーと効率を必要とするあらゆるユースケースに適しています。価格についてはUnslothチームにお問い合わせください。
- Unsloth Enterprise: 大規模な運用のための究極のパフォーマンス階層です。最大32倍の高速トレーニング、90%のVRAM削減、マルチノードサポート、最大30%の精度向上を解放します。また、フルモデルトレーニング(LoRAだけでなく)、5倍高速な推論、専用のカスタマーサポートも含まれています。価格についてはUnslothチームにお問い合わせください。
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 426.2K
- 2026-1: 574.8K
- 2026-2: 698.3K
- 2026-3: 1.3M
- 2026-4: 1.6M
- 2026-5: 1.1M
Geography
Top 5 countries / regions
- 🇨🇳中国43.4%
- 🇺🇸アメリカ合衆国30.2%
- 🇮🇳インド11.4%
- 🇰🇷韓国7.9%
- 🇩🇪ドイツ7.1%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 64.9% |
Referral | 34.0% |
Email | 1.1% |
Top keywords
| Keyword | Cost per click |
|---|---|
| kimi k2.6 | $0.00 |
| qwen3.5 | $0.00 |
| unsloth | $2.86 |
| unsloth ai | $3.35 |
| unsloth studio | $2.57 |
Unsloth Videos on YouTube

Byte Goose AI.



Docker

Unsloth Alternatives
thundercompute
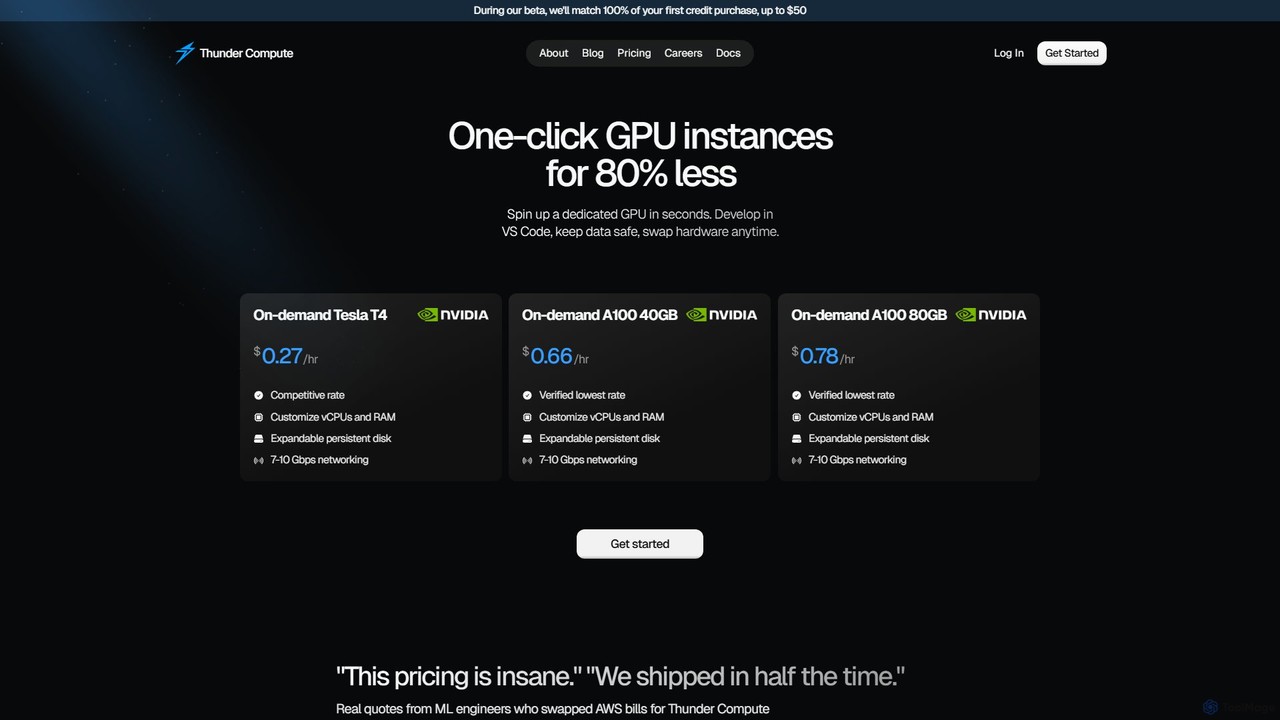
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習
Fluidstack
Fluidstackは、最先端のAIモデルのトレーニングとサービス提供のための高性能な専用GPUクラスタを提供する、業界をリードするAIクラウドプラットフォームです。数千台のGPUの迅速な展開、24時間365日の専門家によるサポートを含むフルマネージドサービス、そしてデータ転送費用ゼロの透明な価格設定により、AIチームがインフラの摩擦なくスケールアップできるよう支援します。
企業ソリューション
Unsloth Categories
Unsloth Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

FinetuneDB
FinetuneDBは、開発者向けのオールインワンAIファインチューニングプラットフォームです。高品質なデータセットの構築、Llama 3やGPT-4o miniなどのモデルのファインチューニングから、単一の安全なプラットフォーム上でのデプロイと継続的な評価まで、カスタム大規模言語モデル(LLM)作成の全ワークフローを簡素化します。
Llmopsthundercompute
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習
EntryPoint AI
EntryPoint AIは、大規模言語モデル(LLM)のファインチューニングを簡素化するために設計されたノーコードプラットフォームです。ユーザーはコードを書くことなく、データセットの管理、OpenAIなどのプロバイダーからのカスタムAIモデルのトレーニング、評価、デプロイが可能です。このプラットフォームは、特定のビジネス課題に対するモデルの品質、速度、予測可能性を向上させ、あらゆる規模のチームが高度なAIカスタマイズを行えるようにします。
データ管理
Metrics Help
Metrics Helpは、機械学習の実務家向けのオープンソースWebツールです。MLトレーニングメトリクスの包括的なガイドおよびインタラクティブなアナライザーとして機能します。ユーザーはトレーニングログを貼り付けることで、精度、損失、パープレキシティなどの主要なメトリクスの説明を即座に取得し、モデルのパフォーマンス分析とデバッグを支援します。
モデルトレーニング
hyperficient
hyperficientは、開発者やMLエンジニア向けのオープンソースAIツールで、ニューラルネットワークの最も効率的なファインチューニング戦略の探索を自動化します。計算コスト、GPU時間、手作業を大幅に削減し、限られたリソースで最適なモデル性能を実現します。
ライブラリ
TensorFlow
TensorFlowは、Googleが開発したエンドツーエンドのオープンソース機械学習プラットフォームです。研究者や開発者がMLを活用したアプリケーションを構築・展開できるよう、ツール、ライブラリ、コミュニティリソースからなる包括的で柔軟なエコシステムを提供します。初心者から専門家まで、TensorFlowは簡単なモデル構築のための直感的な高レベルAPIと、高度な研究のための強力な低レベルAPIを提供し、サーバー、エッジデバイス、ブラウザへの展開を可能にします。
フレームワーク
Label Studio
Label Studioは、多様なデータタイプ向けに設計された多機能なオープンソースのデータラベリングプラットフォームです。画像、テキスト、音声、動画、時系列データにアノテーションを付け、LLMのファインチューニング、機械学習用のトレーニングデータの準備、人間参加型のフィードバックによるAIモデルの検証を可能にします。
訓練データ
Unsloth Comments (0)
Sign in to comment.
ログインNo comments yet.