
xTuring Overview
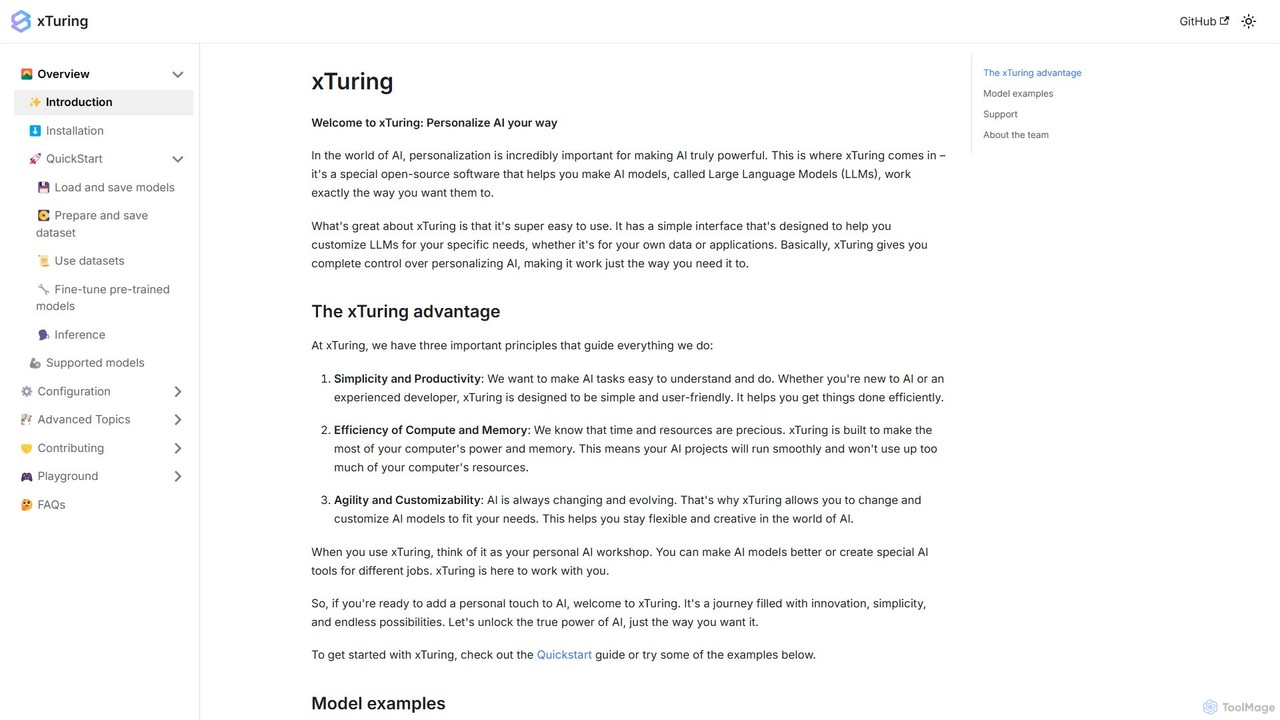
xTuringは、Stochastic AIによって開発された強力なオープンソースライブラリであり、誰もが大規模言語モデル(LLM)のパーソナライゼーションにアクセスしやすく、効率的に行えるようにすることを使命としています。AIが主導する世界では、特定のニーズに合わせてモデルを調整する能力が不可欠であり、xTuringはそのための完璧なツールキットを提供します。このライブラリは、シンプルさと生産性、計算とメモリの効率性、そして俊敏性とカスタマイズ性という3つの基本原則に基づいて構築されています。これにより、AIの世界に足を踏み入れたばかりの初心者から、効率化されたワークフローを求める経験豊富な開発者まで、理想的な選択肢となります。
このライブラリは、モデルのトレーニングと最適化の複雑さを抽象化し、ユーザーが独自のアプリケーションに集中できるようにします。xTuringを使えば、強力な事前学習済みモデルを取り入れ、独自のデータセットに適応させることができます。専門的なチャットボットの作成、特定分野のテキスト分析ツールの開発、パーソナライズされたコンテンツ生成ツールの作成など、様々な用途に活用できます。まるで、必要な通りに正確に機能するAIモデルを構築し、改良できる個人用のAIワークショップを持っているかのようです。
xTuringの使い方
xTuringの使用は非常に簡単で、主に数行のPythonコードで完結します。プロセスは通常、以下の手順に従います。
1. インストール: まず、pipを使用してライブラリをインストールします:pip install xturing。
2. データセットの準備: データは特定の形式である必要があります。一般的なテキストのファインチューニングにはTextDatasetクラスを使用できます。指示ベースのタスク(質疑応答など)には、通常「text」と「instruction」フィールドが必要なInstructionDatasetクラスを使用します。
3. モデルの選択と読み込み: xTuringは多くの人気のあるLLMをサポートしています。1行のコードでモデルを初期化できます。たとえば、LLaMA 2を使用するには、model = BaseModel.create('llama2')と記述します。xTuringは、LoRAやINT8/INT4量子化などのメモリ効率の良いバージョン(例:llama2_lora_int8)もサポートしています。
4. ファインチューニングの開始: モデルとデータセットが読み込まれたら、.finetune()メソッドでファインチューニングプロセスを開始します:model.finetune(dataset=my_dataset)。
5. 推論: ファインチューニング後、カスタムモデルで.generate()メソッドを呼び出すことで、簡単にテキストを生成できます。
xTuringの主な機能
- 簡素化されたファインチューニング: テキストベースおよび指示ベースのタスクの両方でLLMのファインチューニングプロセスを劇的に簡素化する高レベルAPIを提供します。
- 幅広いモデルサポート: LLaMA、LLaMA 2、Falcon、BLOOM、GPT-J、GPT-2、OPT、Cerebras-GPT、Galacticaなど、多数の人気オープンソースモデルをネイティブにサポートします。
- メモリと計算の効率性: LoRA(Low-Rank Adaptation)、INT8、INT4量子化などの高度な最適化技術を統合し、ユーザーがコンシューマーグレードのハードウェアで大規模モデルをファインチューニングできるようにします。
- 柔軟なデータセット処理: 標準的なテキストデータセットと、より複雑な指示ベースのデータセットの両方を処理するための使いやすいクラスを提供します。
- オープンソースとコミュニティ主導: Apache 2.0ライセンスの下で、xTuringは完全に無料で使用および変更が可能です。Discord上の活発なコミュニティによるサポートとコラボレーションに支えられています。
- 汎用モデルラッパー: 公式にリストされていなくても、Hugging Face互換のあらゆる大規模言語モデルをファインチューニングできるラッパーが含まれています。
xTuringの使用例
xTuringは多用途であり、多くのシナリオに適用できます。
- カスタムチャットボット: 企業の内部文書やカスタマーサポートのログでモデルをファインチューニングし、知識豊富で役立つチャットボットを作成します。
- 特定分野のアシスタント: 法律、医療、金融などの分野で、関連する専門テキストでトレーニングすることにより、専門的なAIアシスタントを開発します。
- パーソナライズされたコンテンツ作成: マーケティングコピー、クリエイティブな物語、技術文書など、特定のスタイルやトーンでテキストを生成するツールを作成します。
- 研究と実験: 研究者は、さまざまなモデル、データセット、ファインチューニング技術を迅速に実験し、AIの限界を押し広げることができます。
- コード生成: 特定のプログラミング言語やコードベースでモデルをファインチューニングし、カスタムのコード補完または生成ツールを作成します。
xTuringの利点
xTuringの主な利点は、AIのパーソナライゼーションを民主化するというコミットメントにあります。その主な強みは次のとおりです。
- アクセシビリティ: シンプルなAPIが参入障壁を下げ、深いMLの専門知識がない開発者でも強力なモデルをファインチューニングできるようにします。
- リソース効率: LoRAと量子化の組み込みサポートにより、高価なハイエンドGPUクラスタを必要とせずに大規模モデルをトレーニングすることが可能です。
- 柔軟性: フレームワークは俊敏でカスタマイズ可能に設計されており、ユーザーは急速に進化するAIの状況に適応し、独自の変更を統合できます。
- 生産性: ボイラープレートコードや複雑な設定を処理することで、xTuringは開発者がより迅速に結果を出し、より速く反復できるようにします。
料金プラン
xTuringは完全に無料のオープンソースプロジェクトです。寛容なApache 2.0ライセンスの下でライセンスされており、個人および商用の両方で料金なしで使用できます。プロジェクトはStochastic AIとオープンソースコミュニティによって維持されています。
xTuring Alternatives
hyperficient
hyperficientは、開発者やMLエンジニア向けのオープンソースAIツールで、ニューラルネットワークの最も効率的なファインチューニング戦略の探索を自動化します。計算コスト、GPU時間、手作業を大幅に削減し、限られたリソースで最適なモデル性能を実現します。
ライブラリ
Falcon LLM
Falcon LLMは、技術革新研究所(TII)によって開発された、強力なオープンソースおよびオープンアクセスの大規模言語モデルファミリーです。最先端の性能、スケーラビリティ、マルチモーダル性で知られ、効率的なエッジ展開版から巨大な180Bパラメータモデルまでを網羅し、世界中の開発者、研究者、企業に高度なAIへのアクセスを民主化することを目指しています。
機械学習
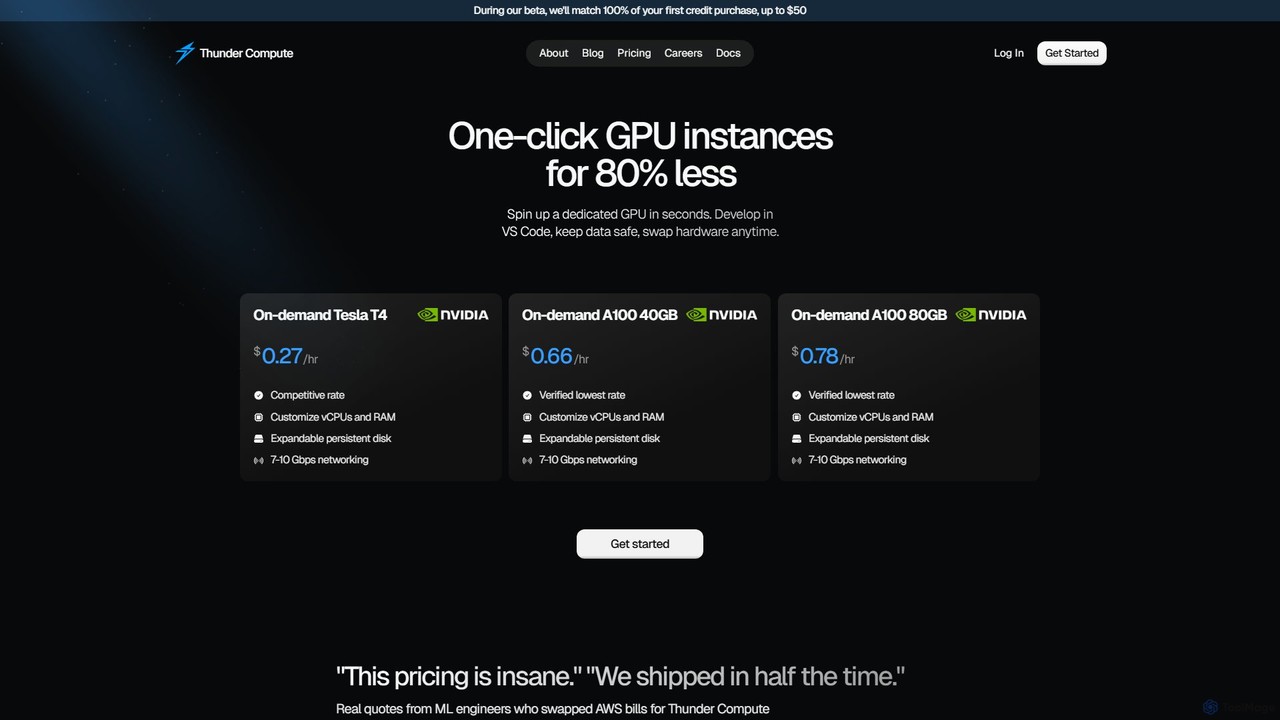
thundercompute
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習xTuring Categories
xTuring Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
hyperficient
hyperficientは、開発者やMLエンジニア向けのオープンソースAIツールで、ニューラルネットワークの最も効率的なファインチューニング戦略の探索を自動化します。計算コスト、GPU時間、手作業を大幅に削減し、限られたリソースで最適なモデル性能を実現します。
ライブラリ
Falcon LLM
Falcon LLMは、技術革新研究所(TII)によって開発された、強力なオープンソースおよびオープンアクセスの大規模言語モデルファミリーです。最先端の性能、スケーラビリティ、マルチモーダル性で知られ、効率的なエッジ展開版から巨大な180Bパラメータモデルまでを網羅し、世界中の開発者、研究者、企業に高度なAIへのアクセスを民主化することを目指しています。
機械学習
FinetuneDB
FinetuneDBは、開発者向けのオールインワンAIファインチューニングプラットフォームです。高品質なデータセットの構築、Llama 3やGPT-4o miniなどのモデルのファインチューニングから、単一の安全なプラットフォーム上でのデプロイと継続的な評価まで、カスタム大規模言語モデル(LLM)作成の全ワークフローを簡素化します。
Llmopsthundercompute
Thunder Computeは、AIおよび機械学習開発者向けに設計された超低コストのGPUクラウドプラットフォームです。NVIDIA A100やT4などのオンデマンドGPUインスタンスを、主要なクラウドプロバイダーより最大80%安い価格で提供します。ワンクリック設定、VS Code統合、シームレスなスケーラビリティといった機能により、プロトタイピングから本番環境までの開発ワークフローを劇的に簡素化し、開発者がインフラ管理ではなくモデル構築に集中できるようにします。
機械学習
EntryPoint AI
EntryPoint AIは、大規模言語モデル(LLM)のファインチューニングを簡素化するために設計されたノーコードプラットフォームです。ユーザーはコードを書くことなく、データセットの管理、OpenAIなどのプロバイダーからのカスタムAIモデルのトレーニング、評価、デプロイが可能です。このプラットフォームは、特定のビジネス課題に対するモデルの品質、速度、予測可能性を向上させ、あらゆる規模のチームが高度なAIカスタマイズを行えるようにします。
データ管理
Metrics Help
Metrics Helpは、機械学習の実務家向けのオープンソースWebツールです。MLトレーニングメトリクスの包括的なガイドおよびインタラクティブなアナライザーとして機能します。ユーザーはトレーニングログを貼り付けることで、精度、損失、パープレキシティなどの主要なメトリクスの説明を即座に取得し、モデルのパフォーマンス分析とデバッグを支援します。
モデルトレーニング
xTuring Comments (0)
Sign in to comment.
ログインNo comments yet.