
Fireworks AI Overview
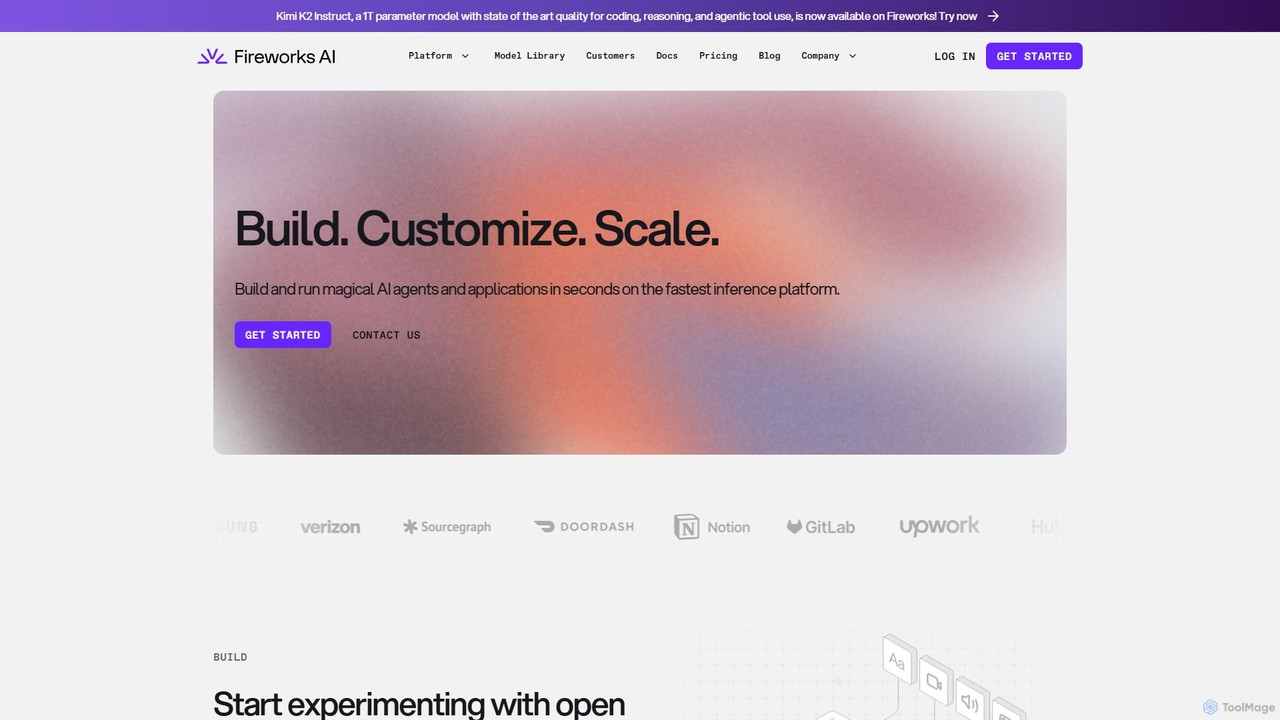
Fireworks AI는 비할 데 없는 속도와 효율성으로 생성형 AI 애플리케이션을 구축, 맞춤화 및 확장하도록 설계된 최첨단 개발자 플랫폼입니다. 가장 빠른 추론 플랫폼으로 자리매김하여 개발자와 기업이 단 몇 줄의 코드로 Llama, Mistral, DeepSeek, Qwen과 같은 오픈 소스 AI 모델을 실행하고 미세 조정할 수 있도록 지원합니다. 이 플랫폼은 고도로 최적화된 추론 엔진인 FireAttention을 기반으로 구축되어 실시간 성능, 최소한의 대기 시간 및 높은 처리량을 제공하므로 미션 크리티컬 애플리케이션에 이상적입니다. Fireworks AI는 GPU 관리의 복잡성을 추상화하여 사용자가 혁신적인 AI 제품을 구축하는 데 집중할 수 있도록 합니다.
Fireworks AI 사용 방법
Fireworks AI를 사용하는 것은 개발자에게 간소화된 프로세스입니다. 먼저 웹사이트에 가입하여 플랫폼에 액세스하고 초기 무료 크레딧을 받습니다. 그런 다음 직관적인 SDK를 사용하거나 직접 API를 호출하여 수백 개의 사전 지원되는 오픈 모델로 실험을 시작할 수 있습니다. 이 플랫폼은 OpenAI와 호환되므로 마이그레이션이 쉽습니다. 맞춤형 요구 사항의 경우, SFT(Supervised Fine-Tuning) 또는 RFT(Reinforcement Fine-Tuning)와 같은 고급 기술을 사용하여 데이터를 업로드하여 모델을 미세 조정할 수 있습니다. 모델이 준비되면 유연한 배포 옵션 중 하나를 사용하여 배포할 수 있습니다. 콜드 스타트 없이 토큰당 결제하는 간편한 사용을 위한 Serverless 또는 전용 GPU 리소스를 제공하여 더 높은 속도 제한과 대규모에서 더 낮은 비용을 제공하는 On-Demand Deployments를 선택할 수 있습니다.
Fireworks AI의 핵심 기능
- 초고속 추론 엔진: 독점적인 FireAttention 엔진으로 구동되어 업계 최고의 속도, 낮은 대기 시간 및 높은 처리량을 제공하며 vLLM과 같은 표준 추론 엔진보다 훨씬 뛰어난 성능을 보입니다.
- 광범위한 오픈 모델 라이브러리: Llama 3.1, Mixtral, Qwen, DeepSeek을 포함한 텍스트, 비전, 오디오 및 이미지 생성을 위한 수백 개의 인기 있는 오픈 소스 모델에 즉시 액세스할 수 있습니다. 사용자는 사용자 지정 모델을 업로드할 수도 있습니다.
- 고급 미세 조정 및 맞춤화: 특정 사용 사례에 대해 최고의 품질을 달성하기 위해 SFT(Supervised Fine-Tuning), RFT(Reinforcement Fine-Tuning) 및 양자화 인식 튜닝을 포함한 정교한 모델 맞춤화 도구를 제공합니다.
- Multi-LoRA 서빙: 추가 서빙 비용 없이 단일 배포에서 수백 개의 미세 조정된 LoRA 어댑터를 배포하여 대규모 개인화 및 실험을 효율적으로 수행할 수 있습니다.
- 유연한 배포 옵션: 프로토타이핑에서 대규모 프로덕션에 이르기까지 다양한 규모와 요구 사항에 맞게 Serverless(토큰당 결제), On-Demand(GPU 초당 결제) 및 Enterprise Reserved 용량을 제공합니다.
- 다중 모드 기능: 텍스트 생성, 음성-텍스트 변환, 이미지 생성 및 비전-언어 이해를 포함한 광범위한 AI 작업을 지원합니다.
- 복합 AI 및 구조화된 출력: 함수 호출, JSON 모드 및 문법 모드와 같은 기능을 통해 다른 도구 및 API와 상호 작용할 수 있는 복잡하고 신뢰할 수 있는 AI 시스템을 구축할 수 있습니다.
- 엔터프라이즈급 보안 및 확장성: SOC2 Type II, GDPR 및 HIPAA를 준수하며, 고가용성 및 원활한 확장을 위해 10개 이상의 클라우드와 15개 이상의 지역에 걸쳐 전 세계적으로 배포됩니다.
Fireworks AI의 사용 사례
Fireworks AI는 Notion, Sourcegraph, Quora와 같은 선도적인 기업에서 다양한 애플리케이션에 신뢰를 받고 있습니다. 일반적인 사용 사례는 다음과 같습니다.
- 실시간 AI 에이전트: 최소한의 대기 시간으로 매우 응답성이 뛰어난 음성 에이전트 및 챗봇 구축.
- AI 기반 개발자 도구: Sourcegraph의 Cody와 같은 고급 코딩 도우미를 빠른 코드 완성 및 AI 기반 검색 기능으로 생성.
- 엔터프라이즈 RAG 시스템: Notion에서 볼 수 있듯이 대규모 검색 증강 생성(RAG) 워크플로우를 구동하여 정확하고 상황에 맞는 답변을 제공.
- 대규모 개인화 AI: Quora의 도메인별 파운데이션 모델과 같이 다양한 사용자 또는 도메인을 위한 수천 개의 맞춤형 모델 제공.
- 고처리량 미디어 처리: 콘텐츠 제작 및 분석 플랫폼을 위한 빠른 오디오 변환 및 이미지 생성 수행.
Fireworks AI의 장점
Fireworks AI의 주요 장점은 극도의 성능입니다. 고객 후기는 상당한 대기 시간 감소(예: Notion의 경우 2초에서 350ms로)를 강조하여 실시간 사용자 경험을 가능하게 합니다. 최적화된 엔진과 Multi-LoRA 서빙과 같은 혁신적인 기능을 통해 달성된 비용 효율성도 또 다른 핵심 이점입니다. 이 플랫폼은 일반적인 복잡성 없이 심층적인 맞춤화를 제공하여 고급 AI에 대한 접근성을 높입니다. 마지막으로, 강력한 SDK, 광범위한 문서 및 원활한 확장성을 갖춘 개발자 중심 접근 방식을 통해 팀은 아이디어에서 프로덕션까지 빠르고 안정적으로 진행할 수 있습니다.
가격 및 플랜
Fireworks AI는 신규 사용자에게 1달러의 무료 크레딧으로 시작하는 프리미엄, 종량제 모델로 운영됩니다. 가격은 서비스별로 분류됩니다.
- Serverless 추론: 1백만 토큰당 청구되며, 요금은 모델 크기에 따라 다릅니다(예: 4B-16B 모델의 경우 0.20달러, >16B 모델의 경우 0.90달러).
- 미세 조정: 1백만 학습 토큰당 요금이 부과됩니다(예: 최대 16B 매개변수 모델의 경우 0.50달러). 미세 조정된 모델 서빙 비용은 기본 모델과 동일합니다.
- 음성-텍스트 변환: 오디오 분당 가격이 책정됩니다(예: Whisper-v3-large의 경우 0.0015달러/분).
- 이미지 생성: 모델에 따라 단계별 또는 이미지별로 청구됩니다.
- On-Demand 배포: NVIDIA H100(시간당 5.80달러) 또는 A100(시간당 2.90달러)과 같은 전용 하드웨어에 대해 GPU 초당 결제하며, 더 높은 처리량과 속도 제한이 없습니다.
이 유연한 구조를 통해 사용자는 특정 사용 패턴과 규모에 따라 비용을 최적화할 수 있습니다.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 284.6K
- 2026-1: 355.9K
- 2026-2: 323.2K
- 2026-3: 438.1K
- 2026-4: 720.8K
- 2026-5: 610.7K
Geography
Top 5 countries / regions
- 🇺🇸미국55.9%
- 🇻🇳베트남15.8%
- 🇮🇳인도11.5%
- 🇷🇺러시아9.3%
- 🇨🇳중국7.5%
Traffic sources
| Source type | Percentage |
|---|---|
Direct | 90.6% |
Referral | 7.1% |
Email | 2.3% |
Top keywords
| Keyword | Cost per click |
|---|---|
| baseten | $4.41 |
| fireworks | $0.00 |
| fireworks ai | $0.00 |
| fireworks ai careers | $0.00 |
| kimi ai | $0.38 |
Fireworks AI Videos on YouTube




Fireworks AI

Fireworks AI
Fireworks AI Alternatives
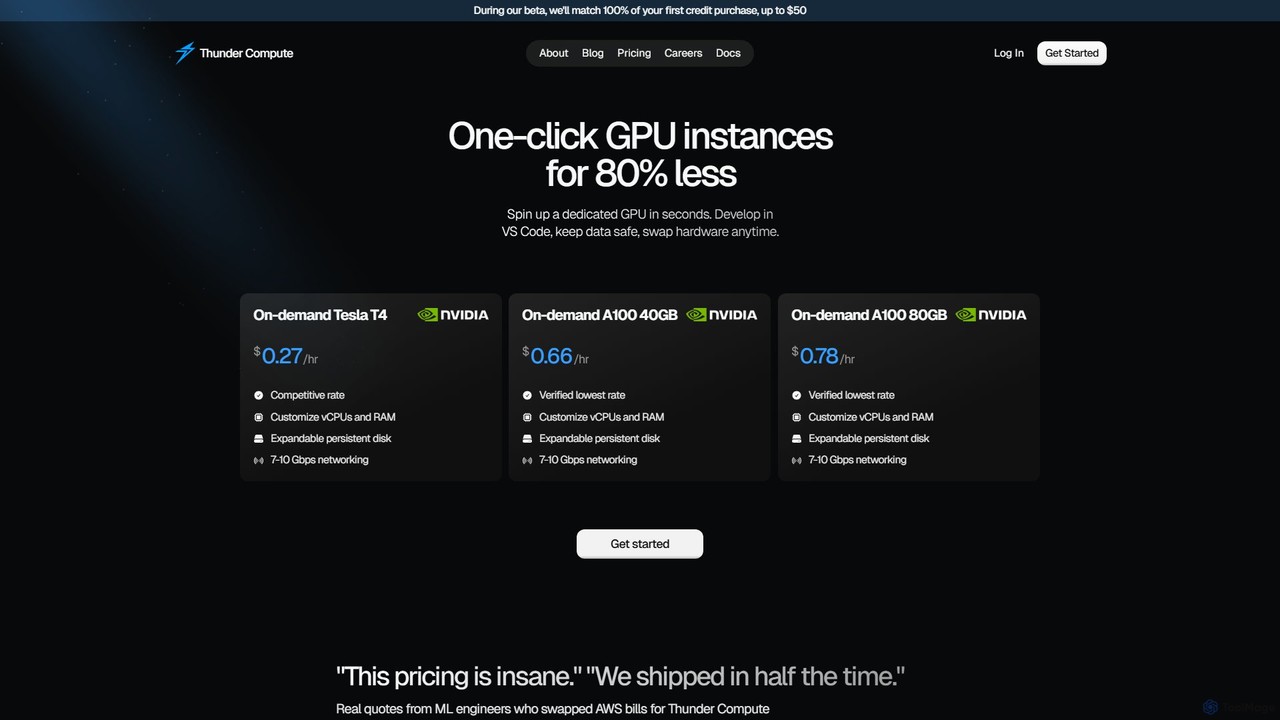
thundercompute
Thunder Compute는 AI 및 머신러닝 개발자를 위해 설계된 초저가 GPU 클라우드 플랫폼입니다. NVIDIA A100 및 T4와 같은 온디맨드 GPU 인스턴스를 주요 클라우드 제공업체보다 최대 80% 저렴한 가격에 제공합니다. 원클릭 설정, VS Code 통합, 원활한 확장성 등의 기능을 통해 프로토타이핑부터 프로덕션까지의 개발 워크플로우를 획기적으로 단순화하여 개발자가 인프라 관리 대신 모델 구축에 집중할 수 있도록 합니다.
머신러닝
Paperspace
Paperspace는 인공지능 및 머신러닝을 위해 설계된 고성능 클라우드 컴퓨팅 플랫폼입니다. 강력한 클라우드 GPU, 관리형 Jupyter 노트북, 모델 구축, 훈련 및 배포를 위한 완전한 MLOps 플랫폼(Gradient)에 손쉽게 액세스할 수 있도록 지원합니다. 복잡한 인프라 관리 없이 AI 워크플로우를 가속화하려는 개발자, 데이터 과학자 및 기업에 이상적입니다.
머신러닝
FinetuneDB
FinetuneDB는 개발자를 위한 올인원 AI 미세 조정 플랫폼입니다. 고품질 데이터셋 구축, Llama 3 및 GPT-4o mini와 같은 모델 미세 조정부터 단일 보안 플랫폼에서의 배포 및 지속적인 평가에 이르기까지 맞춤형 대규모 언어 모델(LLM) 생성의 전체 워크플로우를 간소화합니다.
LlmopsFireworks AI Categories
Fireworks AI Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Together AI
Together AI는 개발자를 위한 선도적인 클라우드 플랫폼으로, 오픈 소스 생성형 AI 모델을 실행, 미세 조정 및 훈련하기 위한 빠르고 비용 효율적인 인프라를 제공합니다. 200개 이상의 모델 라이브러리, 서버리스 추론 API, 맞춤형 미세 조정 및 전용 GPU 클러스터를 제공하여 AI 애플리케이션 구축 및 확장을 위한 엔드투엔드 솔루션을 만듭니다.
GPU 인프라
MonsterAPI
MonsterAPI는 개발자 중심의 플랫폼으로, 오픈 소스 생성형 AI 모델의 파인튜닝 및 배포를 간소화합니다. Llama, SDXL, Whisper와 같은 모델을 지원하는 코드 없는 채팅 인터페이스인 MonsterGPT를 제공합니다. 이 플랫폼은 확장 가능한 API 엔드포인트와 엔터프라이즈급 GPU 인프라를 기존 비용과 시간의 일부만으로 제공하여 모든 개발자가 고급 AI에 접근할 수 있도록 합니다.
서비스형 플랫폼 (PaaS)FinetuneDB
FinetuneDB는 개발자를 위한 올인원 AI 미세 조정 플랫폼입니다. 고품질 데이터셋 구축, Llama 3 및 GPT-4o mini와 같은 모델 미세 조정부터 단일 보안 플랫폼에서의 배포 및 지속적인 평가에 이르기까지 맞춤형 대규모 언어 모델(LLM) 생성의 전체 워크플로우를 간소화합니다.
Llmops
Mistral AI
Mistral AI는 오픈 소스 및 고성능 대규모 언어 모델(LLM)을 제공하는 선도적인 AI 기업입니다. 다재다능한 AI 어시스턴트 Le Chat과 강력한 개발자 플랫폼 La Plateforme을 제공하며, 개인 및 기업 사용자를 위한 구성 가능성, 효율성 및 개인 정보 보호에 중점을 둡니다.
기업 솔루션
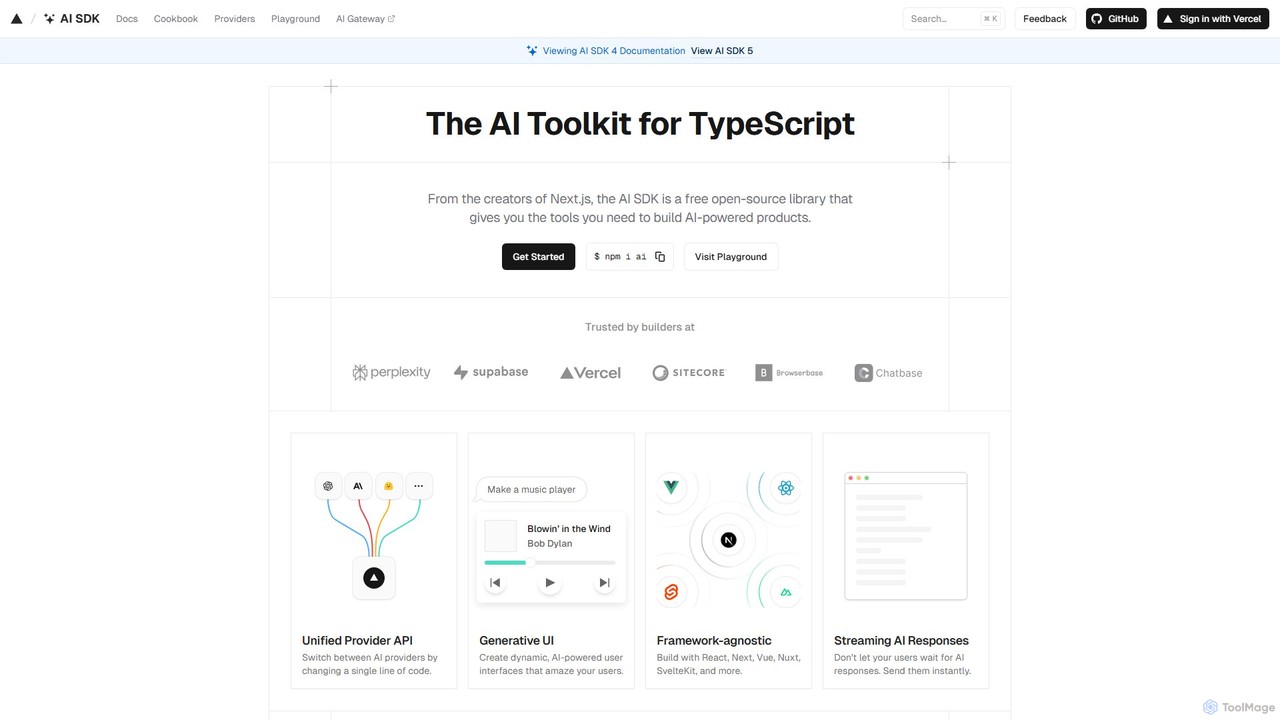
AI SDK
Vercel의 AI SDK는 AI 기반 애플리케이션 구축을 위한 무료 오픈소스 TypeScript 툴킷입니다. OpenAI, Google, Anthropic과 같은 다양한 대규모 언어 모델(LLM)을 원활하게 통합할 수 있는 통합 API를 제공합니다. 스트리밍 응답, 생성형 UI 구성 요소, 도구 호출과 같은 기능으로 개발을 단순화하여 개발자가 Next.js, React, Svelte와 같은 프레임워크에서 AI 기능을 더 빠르게 구축하고 출시할 수 있도록 지원합니다.
라이브러리
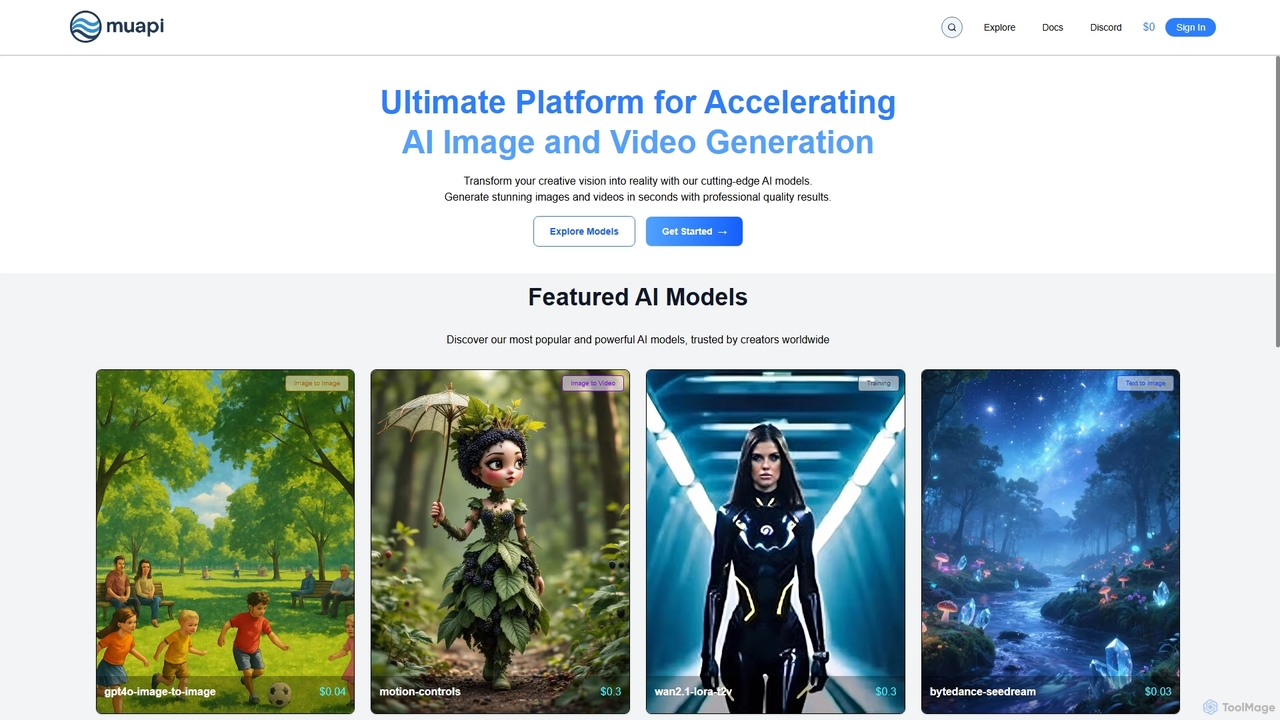
Muapi
Muapi는 AI 이미지 및 비디오 생성을 가속화하기 위해 설계된 강력한 API 플랫폼입니다. 개발자와 크리에이터에게 다양한 최첨단 AI 모델에 대한 통합된 액세스를 제공합니다. Muapi를 사용하면 텍스트-비디오, 이미지-비디오, 일관된 캐릭터 생성 및 스타일 변환과 같은 기능을 애플리케이션에 쉽게 통합할 수 있습니다. 이 플랫폼은 여러 고급 생성 AI 작업을 위한 단일 API 엔드포인트를 제공하여 개발 프로세스를 단순화하며, 명확한 종량제 가격 구조를 갖추고 있습니다.
API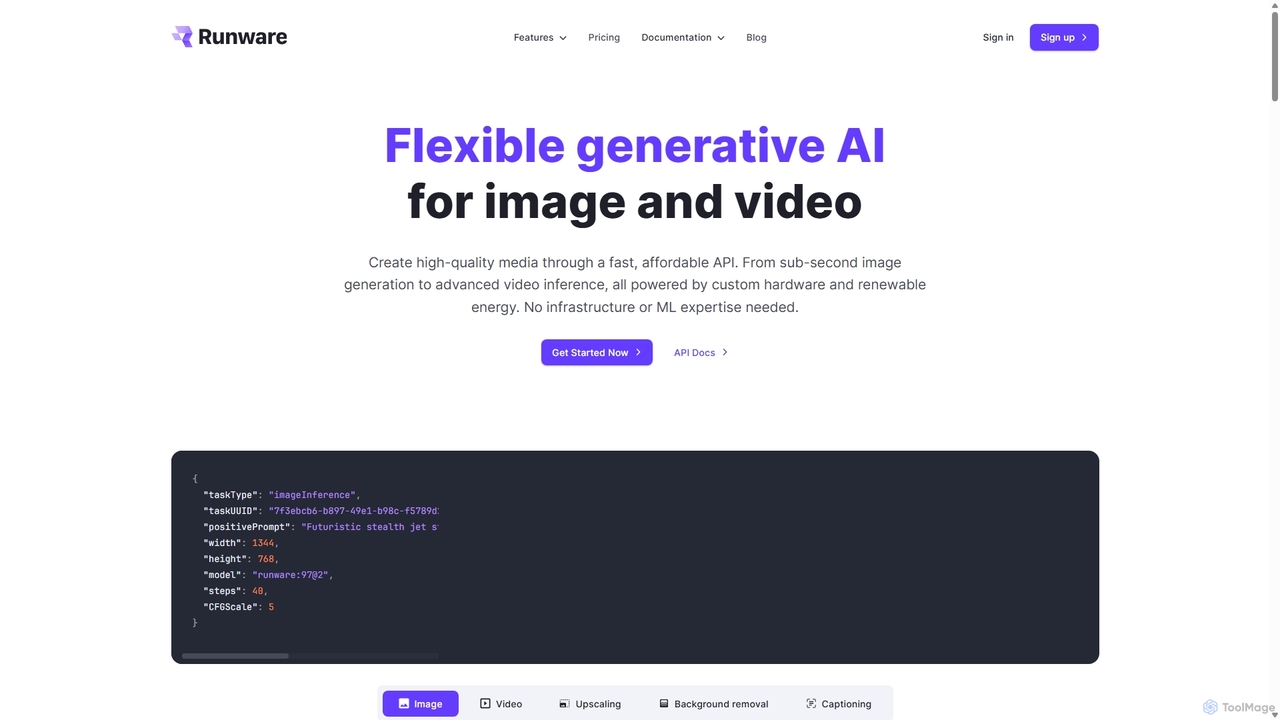
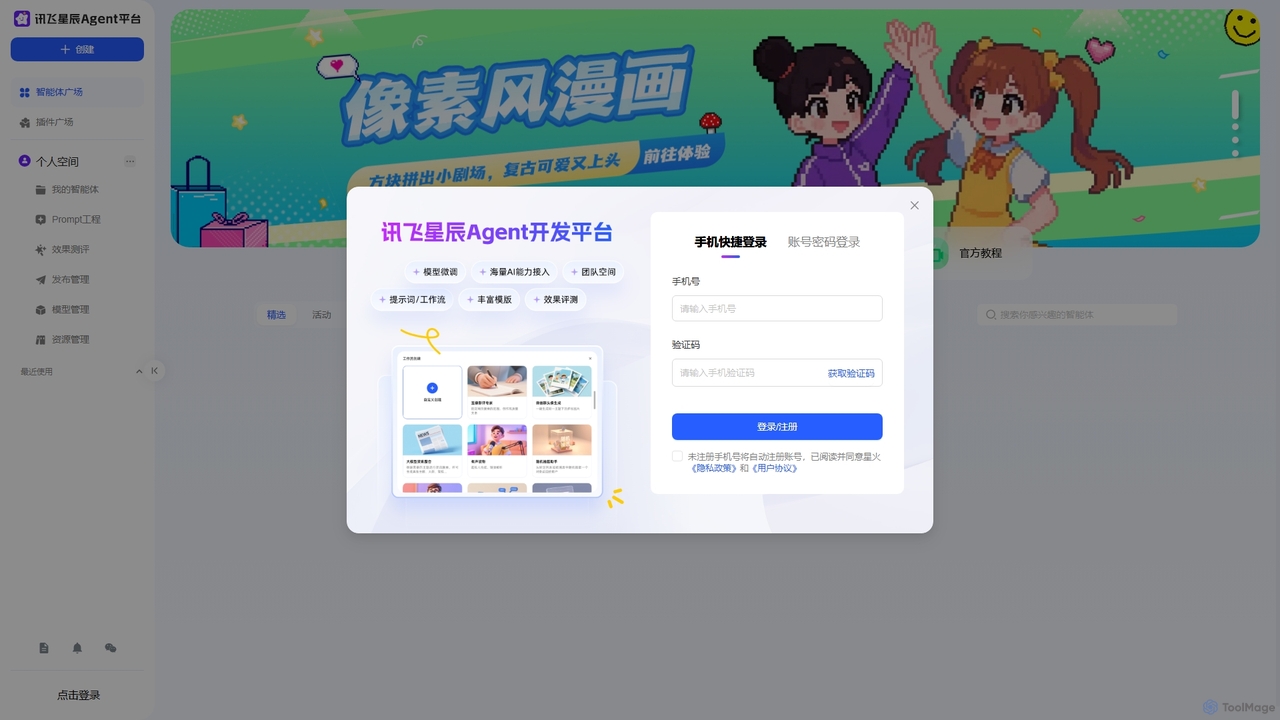
Xunfei Spark Agent Development Platform
iFlytek이 제공하는 원스톱 AI 에이전트 개발 플랫폼입니다. Spark 대규모 언어 모델을 기반으로 하며, 개발자가 로우코드 인터페이스, 광범위한 플러그인 마켓플레이스 및 강력한 관리 도구를 통해 전체 라이프사이클을 포괄하는 지능형 AI 애플리케이션을 구축, 디버깅 및 배포할 수 있도록 지원합니다.
에이전트 빌더
Fireworks AI Comments (0)
Sign in to comment.
로그인No comments yet.