

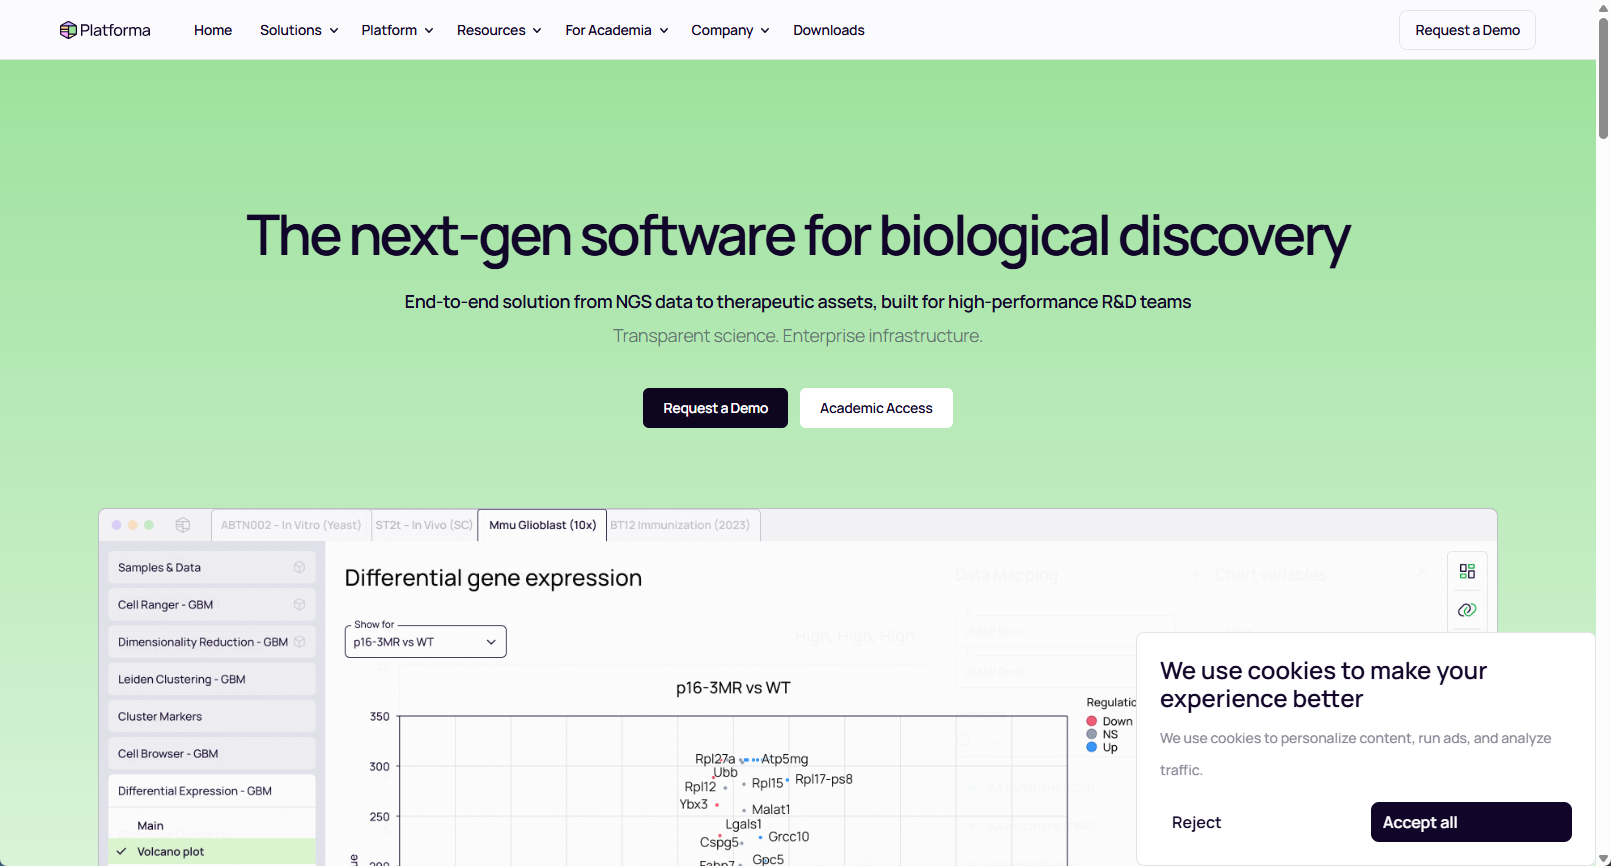
Platforma Overview
Platforma는 MiLaboratories가 고처리량 항체, TCR 및 펩타이드 발굴 연구를 위해 개발한 엔드투엔드 바이오인포매틱스 소프트웨어 애플리케이션입니다.
Platforma는 시험관 내(in vitro) 발굴 방식(파지 디스플레이 및 효모 디스플레이)과 생체 내(in vivo) 발굴 방식(면역화 및 단일세포 분석)을 모두 지원하며, 클로노타이핑(clonotyping), 농축 분석(enrichment analysis), 개발성 위험 요소 탐지(liability flagging), 구조 기반 클러스터링(structural clustering)을 하나의 관리형 화이트박스 환경에서 수행합니다.
Platforma를 사용하면 습식 실험(wet-lab) 연구자가 별도의 전산생물학 전문팀 없이도 복잡한 계산 분석 워크플로우를 실행할 수 있으며, 원시 NGS 데이터를 다양하고 개발 가능성이 높은 후보 리드 패널로 변환할 수 있습니다.
면역 레퍼토리 프로파일링 분야에서 가장 널리 사용되는 도구인 MiXCR을 기반으로 구축된 Platforma는 목적에 맞게 설계된 엔드투엔드 발굴 솔루션을 제공합니다.
시험관 내 항체 발굴(In vitro antibody discovery)
파지 디스플레이 및 효모 디스플레이 라이브러리를 분석하고, 패닝(panning) 단계별 농축 변화를 추적하며, 실제 항원 결합체(true binder)와 빠르게 증식하는 비특이적 클론(passenger clone)을 구분합니다.
생체 내 항체 발굴(In vivo antibody discovery)
자연 상태의 중쇄/경쇄 페어링(native heavy/light chain pairing)을 분석하고, 체세포 과변이(somatic hypermutation)를 생식세포(germline) 단계까지 추적하며, 벌크 데이터, 단일세포 데이터 및 멀티오믹스 데이터를 하나의 의사결정 매트릭스로 통합합니다.
Platforma 사용 방법
Platforma는 사용자의 자체 인프라(HPC 또는 프라이빗 클라우드)에 구축됩니다.
사용자는 다양한 생물학적 분석 블록을 선택하거나, 연구 목적에 맞는 맞춤형 블록을 구축할 수 있습니다.
Annotation 및 클로노타이핑
내장된 MiXCR 엔진을 활용하여 10x Genomics VDJ 출력 데이터, 단일 B세포 시퀀싱 데이터, VHH/scFv/Fab 디스플레이 라이브러리를 처리합니다.
이를 통해 고유한 클로노타입을 추출하고 V(D)J 유전자를 즉시 할당할 수 있습니다.
대규모 클로노타입 클러스터링
별도의 전산생물학 전문팀 없이도 수백만 개의 B세포 면역 레퍼토리 서열을 처리할 수 있습니다.
MMSeqs2 엔진을 사용하여 CDR 영역, 프레임워크 영역 또는 전체 길이 서열 기준으로 서열을 기능적 패밀리로 그룹화하고, 구조적으로 다양한 리드 패널을 확보할 수 있습니다.
라이브러리 특성 분석
선택 과정의 각 단계에서 서열 수준의 지표를 활용하여 초기 라이브러리의 다양성과 구조적 무결성을 평가합니다.
계통 추적 및 SHM 트리 분석
공통 생식세포 조상으로부터 친화도 성숙 과정을 추적하는 체세포 과변이(SHM) 계통 트리를 생성합니다.
계통학적 관계는 블랙박스 방식으로 숨겨지지 않고 완전히 확인할 수 있습니다.
농축 분석
각 패닝 단계별 변화량(fold-change)을 계산하고, 음성 대조군 데이터를 활용하여 항원 특이적 결합체와 빠르게 증가하는 비특이적 클론을 구별합니다.
개발 가능성 및 위험 요소 분석
항체 후보물질의 개발 가능성을 자동으로 평가하고, 고비용의 습식 실험 검증 이전에 서열 및 구조 기반 위험 요소를 직접 탐지합니다.
구조 모델링
3차원 항체 모델을 생성하여 파라토프(paratope) 표면을 분석하고 구조 기반 후보 선정 과정을 지원합니다.
리드 후보 우선순위 선정
농축 점수, 위험 요소 분석 결과 및 클러스터링 데이터를 하나의 통합 작업 공간에서 분석하고, 인터랙티브 항체 공간 맵을 통해 시각화합니다.
Platforma 핵심 기능
MiXCR 오류 보정 기능을 활용한 V(D)J 조립 및 클로노타이핑
패닝 단계별 농축 분석 및 음성 대조군 기반 변화 추적
생식세포 조상까지 추적 가능한 체세포 과변이(SHM) 계통 트리 생성
항원 특이성 매핑 — 표면 마커, 유세포 분석(flow cytometry), 항원 결합 점수를 면역 레퍼토리 데이터에 통합하여 기능 검증
인터랙티브 데이터 시각화 — 다양한 동적 차트와 UMAP 기반 분석을 통한 전체 항체 공간 시각화
예측된 에피토프 기반 파라토프 및 3D 구조 클러스터링
개발 위험 감소를 위한 서열 및 구조 기반 위험 요소 주석 처리
농축 데이터, 위험 요소, 클러스터링 및 기능 데이터를 통합한 리드 패널 선정
주요 활용 분야
시험관 내 항체 발굴
파지 디스플레이 및 효모 디스플레이 기술에서 생성된 선택 결과를 분석하여 높은 친화도와 안정적으로 농축된 항체 결합체를 찾아냅니다.
생체 내 항체 발굴
자연 면역 레퍼토리를 분석하여 희귀하고 높은 친화도를 가진 치료용 후보물질을 발굴합니다.
강력한 계통 트리를 활용하여 체세포 과변이(SHM)를 추적하고, 단일세포 멀티오믹스 데이터와 자연 중쇄/경쇄 페어링 정보를 통합합니다.
펩타이드 발굴
펩타이드 디스플레이 라이브러리의 농축 변화를 추적하여 다양성과 개발 가능성을 갖춘 후보 펩타이드를 식별합니다.
중개 연구(Translational Research)
적응 면역 레퍼토리를 해석하고, TCR/BCR 레퍼토리 신호를 환자 임상 결과와 직접 연결하며, 다양한 임상 코호트를 비교 분석합니다.
멀티오믹스 분석
전사체 데이터(transcriptomics)와 면역 레퍼토리를 통합하여 새로운 세포 유형 마커와 강화된 기능적 경로를 발견합니다.
Platforma의 장점
엔드투엔드 노코드(no-code) 워크플로우
전체 발굴 파이프라인을 하나의 인터랙티브 사용자 인터페이스에서 원활하게 수행할 수 있는 종합 솔루션입니다.
수십억 규모 데이터 처리 능력
대규모 처리 환경을 위해 설계되었으며, 계산 병목 현상 없이 수십억 개의 서열 데이터를 효율적으로 분석합니다.
지능형 리드 후보 선정
리드 선정 과정은 후보를 필터링하고 점수화하며, 동시에 다양성을 확보합니다.
단순한 "Top-N" 방식의 정렬로 인해 중복 클론이 선택되는 문제를 방지합니다.
대신 각 클론 패밀리를 대표하는 최적 후보를 선정하여 구조적으로 다양하고 개발 가능성이 높은 리드를 하나의 통합 과정에서 제공합니다.
연구 생물학에 맞춘 유연한 적용
Platforma는 사용자가 시스템에 맞추는 것이 아니라 연구 목적과 생물학적 요구사항에 맞춰 적용됩니다.
VHH, knob-in-hole 방식의 이중특이 항체(bispecific antibody), 삼중특이 항체(trispecific antibody), 맞춤형 스캐폴드(custom scaffold) 등 비표준 형식을 지원합니다.
또한 DMS, pH-switch selection, multi-arm panning, Tite-Seq와 같은 특수 실험 설계도 각 프로토콜에 맞게 구성할 수 있습니다.
필요한 분석 블록이 존재하지 않는 경우 MiLaboratories 연구진이 직접 구축합니다.
투명한 분석 환경 — 블랙박스 없음
모든 필터, 가중치 및 순위 결정 규칙을 확인하고 수정할 수 있습니다.
분석 블록 로직은 오픈소스 기반이며, 검증된 표준 엔진과 공개된 연구 방법론을 기반으로 감사 가능한 분석 환경을 제공합니다.
데이터가 위치한 곳에 배포
사용자의 클라우드 환경 또는 온프레미스 환경에 배포할 수 있습니다.
엔터프라이즈급 데이터 주권(data sovereignty)은 Platforma 설계의 핵심 기능입니다.
Platforma FAQ
Platforma Alternatives
Platforma Categories
Platforma Jobs
Platforma Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Actimo Labs
Actimo Labs는 정밀하고 신속한 에피토프 매핑을 위한 고급 AI 기반 플랫폼인 ActiMap을 제공합니다. 학계, 제약 및 생명공학 분야의 연구원들을 위해 설계된 이 플랫폼은 단백질 서열로부터 표적 상호작용을 예측하여 항체 발견 및 생물치료제 설계를 몇 분 안에 가속화하고 비용과 개발 일정을 크게 줄여줍니다.
생물정보학
Constellab
Constellab은 생명 과학 및 생명 공학 분야를 위해 설계된 주권형 AI 및 데이터 과학 플랫폼입니다. 데이터 분석, 시각화 및 프로젝트 관리를 위한 협업적이고 코드 없는 환경을 제공하며, 데이터 보안, 추적성 및 규제 준수를 보장하기 위해 유연한 배포 옵션(클라우드, 온프레미스)을 갖추고 있습니다.
로우코드 노코드

monday.com
monday.com은 업무의 모든 측면을 단일 협업 플랫폼으로 통합하는 포괄적인 Work OS(업무 운영 체제)입니다. AI를 활용하여 작업을 자동화하고 워크플로우를 간소화하며, 프로젝트 관리, 영업, 마케팅, IT 등 다양한 팀에 데이터 기반 인사이트를 제공하여 생산성과 가시성을 향상시킵니다.
CRM
Lovable
Lovable은 간단한 대화형 인터페이스를 통해 웹 애플리케이션과 웹사이트를 구축할 수 있는 AI 기반 개발 플랫폼입니다. 아이디어를 평이한 영어로 설명하면 AI가 전체 스택 애플리케이션을 생성하여 기술 및 비기술 사용자 모두를 위한 신속한 프로토타이핑 및 개발을 가능하게 합니다.
로우 코드 노 코드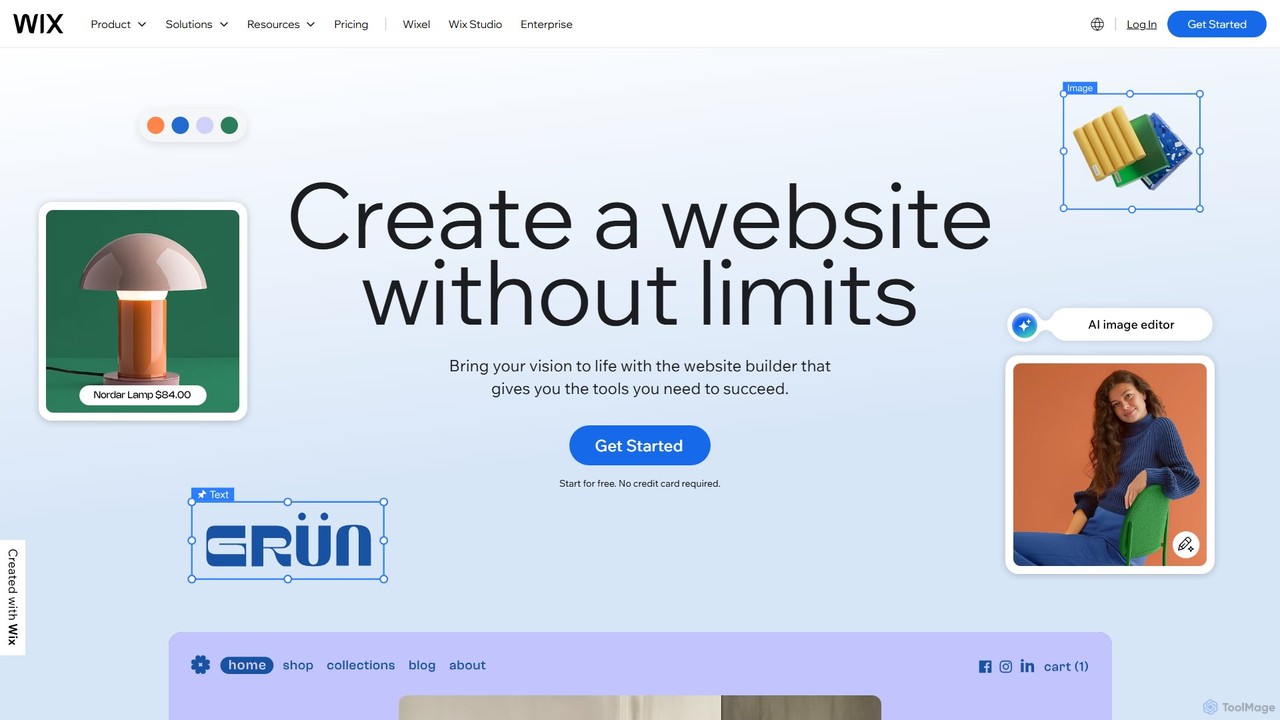
Wix Studio
Wix Studio는 에이전시, 프리랜서, 기업을 위해 설계된 고급스럽고 유연한 웹 제작 플랫폼입니다. 정교한 시각적 디자인 캔버스와 반응형 AI, 코드 없는 애니메이션, 맞춤형 CSS 기능을 결합했습니다. 또한 이 플랫폼은 풀스택 개발 환경(Velo), 통합 비즈니스 솔루션, 팀 협업 및 클라이언트 관리를 위한 강력한 도구를 포함하며, 모두 안전하고 확장 가능한 인프라 위에 구축되었습니다.
노코드
Platforma Comments (0)
Sign in to comment.
로그인No comments yet.