
DataChain Overview
DataChain é uma plataforma avançada de código aberto projetada para enfrentar os desafios do "Heavy Data" — os dados ricos, multimodais e não estruturados que alimentam a próxima geração de IA. Desenvolvida pela equipe por trás do popular DVC (Data Version Control), a DataChain oferece uma solução abrangente para curar, enriquecer e versionar conjuntos de dados massivos, como vídeos, imagens, arquivos de áudio e PDFs, que normalmente residem em armazenamentos de objetos como S3, GCS ou Azure.
A plataforma é construída com uma filosofia que prioriza o desenvolvedor, capacitando as equipes a transformar arquivos brutos e não estruturados em conhecimento pronto para IA. Ela permite a extração de estrutura, embeddings e insights críticos, essenciais para alimentar agentes de IA sofisticados, copilotos e fluxos de trabalho adaptativos. Ao transformar dados pesados em uma vantagem competitiva, a DataChain ajuda as equipes a construir pipelines de dados eficientes e poderosos sem a necessidade de reprocessamento constante de dados.
Como usar o DataChain
O DataChain oferece um fluxo de trabalho simplificado e centrado em código que se integra perfeitamente ao ambiente existente de um desenvolvedor.
- Desenvolva Localmente: Comece definindo seus pipelines de processamento de dados usando código Python simples diretamente em seu Ambiente de Desenvolvimento Integrado (IDE) local. Essa abordagem intuitiva elimina a necessidade de consultas SQL complexas ou linguagens especializadas.
- Conecte-se a Fontes de Dados: Conecte-se aos seus dados não estruturados armazenados no S3, GCS, Azure ou outro armazenamento de objetos. O DataChain opera com uma arquitetura de cópia zero, o que significa que rastreia versões e referências sem duplicar seus arquivos grandes, economizando custos de armazenamento e tempo significativos.
- Processe e Enriqueça: Aplique Modelos de Linguagem Grandes (LLMs) e modelos de Machine Learning (ML) personalizados aos seus dados para extrair insights, gerar embeddings e estruturar suas informações. Isso pode envolver tarefas como transcrever áudio, executar detecção de objetos em vídeos ou analisar texto de PDFs.
- Versione e Rastreie: O DataChain cria automaticamente um registro de conjunto de dados centralizado que rastreia a linhagem completa dos dados, incluindo todas as dependências de código e dados. Isso garante que cada conjunto de dados seja versionado, auditável e totalmente reprodutível.
- Escale para a Nuvem: Uma vez que seu pipeline é testado localmente, você pode implantá-lo na nuvem e escalá-lo para centenas de GPUs sem retrabalho. A plataforma lida com processamento distribuído e auto-scaling, processando eficientemente milhões ou até bilhões de arquivos.
- Acesse e Consulte: Os conjuntos de dados versionados e estruturados podem ser acessados e consultados por meio de uma interface de usuário da web, interfaces de chat, IDEs ou diretamente por agentes de IA através da API da plataforma.
Recursos principais do DataChain
- Registro de Conjunto de Dados Centralizado: Fornece uma única fonte de verdade para todos os seus conjuntos de dados com linhagem completa, metadados e versionamento.
- Simplicidade do Python com Escala de SQL: Use uma interface Python única e intuitiva para todas as operações de dados, facilitando para os desenvolvedores e tornando-a mais compatível com IDEs e agentes.
- IDE Local e Escala na Nuvem: A maneira mais produtiva de construir pipelines de dados — desenvolva e teste localmente, depois escale para uma infraestrutura de nuvem massiva sem problemas.
- Cópia Zero de Dados, Zero Lock-In: Seus dados permanecem em seu próprio armazenamento. O DataChain gerencia apenas metadados e versões, evitando a dependência de fornecedores e reduzindo custos.
- Processamento de Dados Multimodais: Lida e processa nativamente diversos tipos de dados não estruturados, incluindo vídeos, PDFs, áudio e imagens.
- Processamento de Dados em Grande Escala: Projetado para lidar eficientemente com milhões ou bilhões de arquivos, filtrar dados usando modelos de ML e calcular atualizações de conjuntos de dados com facilidade.
- Reprodutibilidade e Linhagem de Dados: Rastreie automaticamente todas as dependências para reproduzir qualquer versão de um conjunto de dados e atualizá-los automaticamente por meio de processos de ETL.
- Processamento Paralelo e Distribuído: Utiliza a infraestrutura de nuvem moderna para processamento de dados paralelo de alta velocidade.
Casos de uso para o DataChain
O DataChain é versátil e pode ser aplicado a uma ampla gama de desafios de IA e engenharia de dados:
- Ajuste Fino de Modelos Multimodais: Prepare e versione conjuntos de dados complexos para o ajuste fino de modelos como o CLIP para corresponder imagens a legendas de texto.
- Processamento Escalável de Documentos: Construa pipelines para extrair e analisar texto de milhões de documentos (por exemplo, PDFs) e criar embeddings de vetor para sistemas RAG (Geração Aumentada por Recuperação).
- IA Generativa para Visão Computacional: Crie, cure e gerencie vastos conjuntos de dados necessários para treinar e avaliar modelos generativos de visão computacional.
- Alimentando Agentes de IA e Copilotos: Forneça dados confiáveis, versionados e estruturados para garantir que agentes de IA e copilotos operem com informações precisas e atualizadas.
- Cura e Filtragem de Dados: Use modelos de ML para filtrar, rotular e selecionar programaticamente os dados mais valiosos de enormes coleções brutas.
Vantagens do DataChain
O DataChain oferece uma vantagem distinta para equipes que trabalham com sistemas de IA modernos:
- Eficiência: A arquitetura de cópia zero e o processamento escalável reduzem drasticamente o tempo e o custo associados à preparação de dados.
- Centrado no Desenvolvedor: A abordagem nativa de Python reduz a barreira de entrada e aumenta a produtividade das equipes de desenvolvimento.
- Robustez e Reprodutibilidade: Garante que todo o trabalho com dados seja versionado e reprodutível, o que é crítico para aplicações de IA de nível empresarial.
- Base de Código Aberto: Construído sobre um núcleo de código aberto poderoso, oferecendo transparência, flexibilidade e uma comunidade forte.
- De uma Equipe de Confiança: Desenvolvido pelos criadores do DVC, uma ferramenta amplamente respeitada na comunidade MLOps, garantindo um profundo entendimento dos desafios de gerenciamento de dados em ML.
Preços e planos
O DataChain oferece um modelo de preços flexível e em camadas para atender a diferentes necessidades:
- Código Aberto: Um plano gratuito e auto-hospedado que inclui todos os recursos principais, como suporte a armazenamento não estruturado, versionamento e linhagem de dados, busca semântica, pipelines Python e processamento paralelo. É adequado para dados em escala de terabytes e até 30 milhões de itens.
- Equipes (SaaS): Uma oferta de nuvem gerenciada projetada para equipes. Inclui tudo do plano de Código Aberto mais recursos para dados em escala de petabytes (1B+ itens), processamento distribuído, auto-scaling, um registro de conjunto de dados compartilhado com interface de usuário da web, SSO/SAML e RBAC. O preço está disponível mediante contato com as vendas.
- Empresarial: Para grandes organizações com necessidades específicas de segurança e implantação. Este plano inclui todos os recursos do plano Equipes mais opções para Bring Your Own Cloud (BYOC) e implantações on-premise. O preço está disponível mediante contato com as vendas.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 3.8K
- 2026-1: 5.3K
- 2026-2: 4.5K
- 2026-3: 6.0K
- 2026-4: 3.2K
- 2026-5: 4.4K
Geography
Top 5 countries / regions
- 🇺🇸Estados Unidos52.3%
- 🇷🇺Rússia19.7%
- 🇮🇳Índia13.2%
- 🇩🇪Alemanha12.2%
- 🇪🇸Espanha2.6%
Top keywords
| Keyword | Cost per click |
|---|---|
| chemin ai | $0.00 |
| claude structured output | $0.00 |
| data chain | $0.00 |
| datachain | $0.00 |
| unstructured io | $1.63 |
DataChain Alternatives
Tidepool
Tidepool (anteriormente Aquarium) era uma poderosa plataforma MLOps projetada para equipes de IA melhorarem modelos de aprendizado de máquina. Especializava-se em gerenciar e curar conjuntos de dados para visão computacional e PNL, permitindo iteração mais rápida e maior desempenho do modelo através de uma abordagem centrada em dados.
Aprendizado de Máquina
PremAI
PremAI é uma plataforma de nível empresarial para construir, ajustar e implantar modelos de IA seguros e privados. Capacita as empresas a transformar seus dados brutos em modelos especializados de alto desempenho, mantendo a soberania absoluta dos dados e utilizando criptografia de ponta para máxima privacidade.
Banco de dados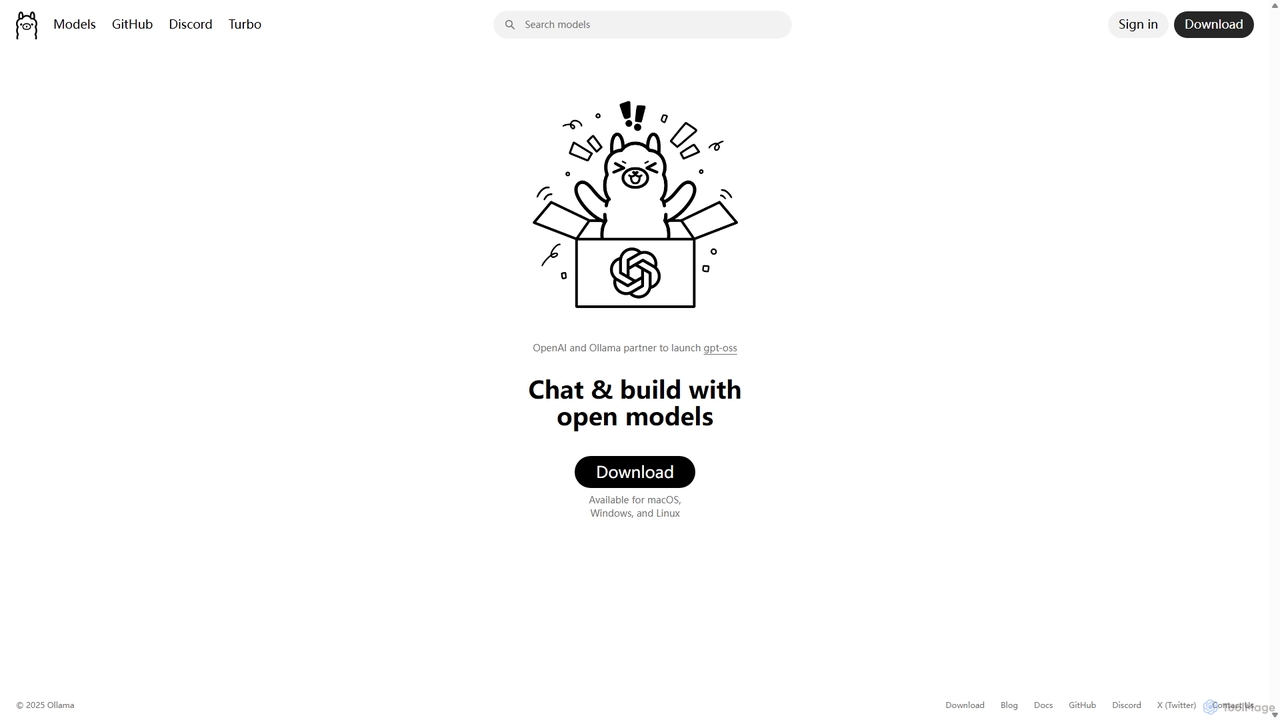
Ollama
Ollama é um poderoso framework de código aberto para executar grandes modelos de linguagem (LLMs) como Llama 3, Mistral e Gemma localmente em seu próprio hardware. Disponível para macOS, Windows e Linux, simplifica a configuração e o gerenciamento de modelos de código aberto, permitindo o desenvolvimento e uso de IA de forma privada, offline e econômica.
Aprendizado de Máquina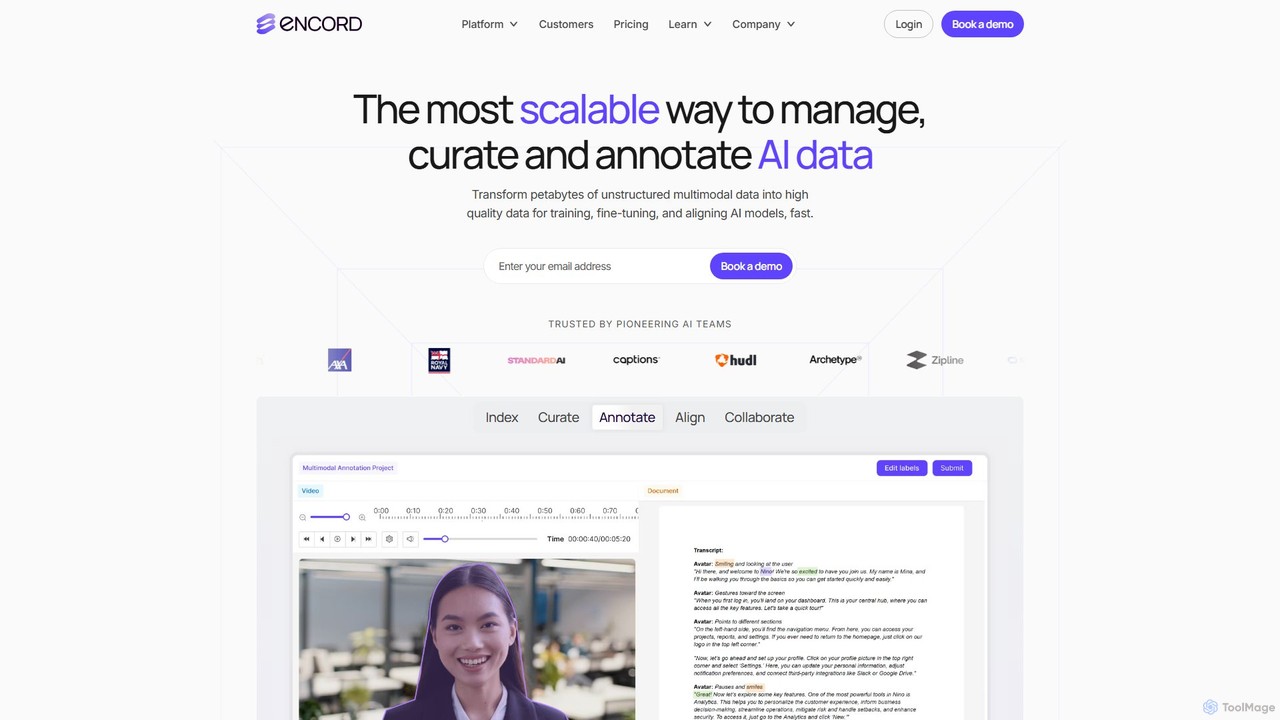
Encord
Encord é uma plataforma abrangente de desenvolvimento de dados para IA visual e multimodal. Fornece ferramentas para gerenciar, curar e anotar dados não estruturados em grande escala, como imagens, vídeos e arquivos DICOM. A plataforma ajuda equipes de IA a construir conjuntos de dados de alta qualidade, melhorar o desempenho do modelo e acelerar a implantação de aplicações de IA prontas para produção por meio de rotulagem avançada, avaliação de modelos e fluxos de trabalho com intervenção humana.
Anotação
Baseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
ImplantaçãoDataChain Categories
DataChain Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools

MLflow
O MLflow é uma plataforma de código aberto para gerenciar o ciclo de vida de machine learning de ponta a ponta. Ele permite que desenvolvedores e cientistas de dados rastreiem experimentos, empacotem código em execuções reprodutíveis, versionem e compartilhem modelos e os implantem em produção, suportando tanto ML tradicional quanto aplicações modernas de GenAI.
Ciência de Dados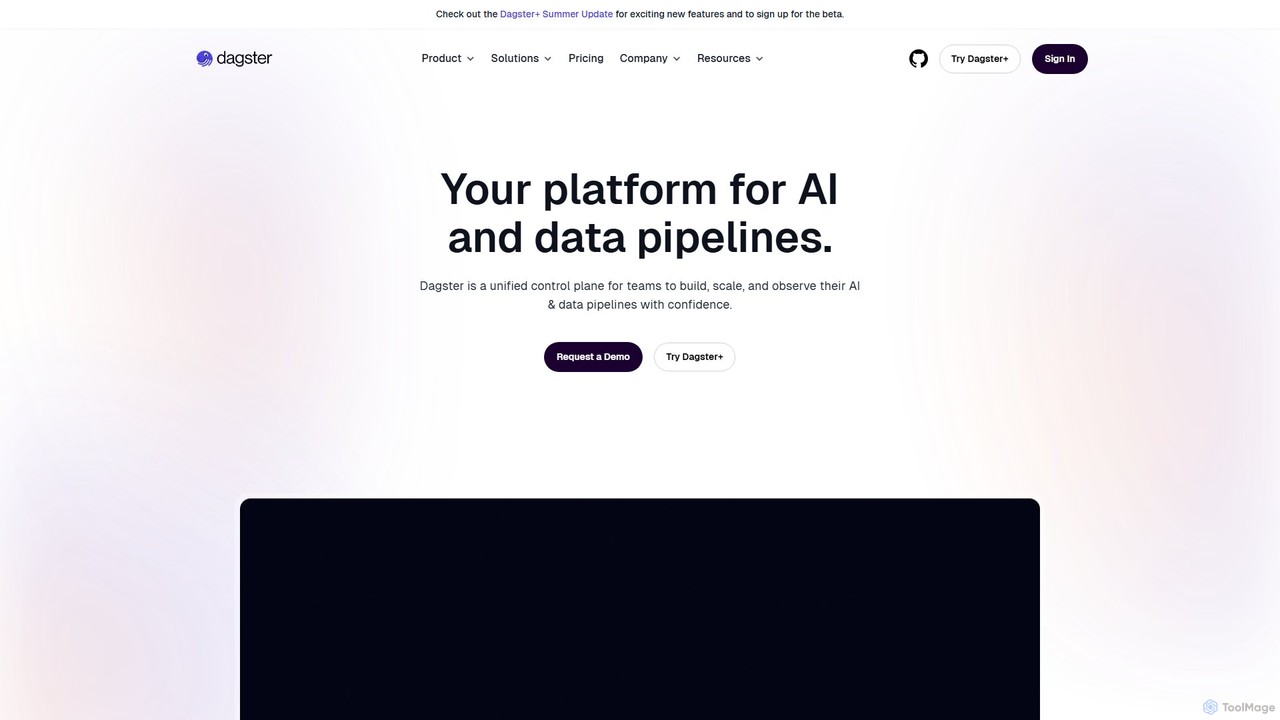
Dagster
Dagster é um orquestrador de dados moderno e de código aberto, projetado para construir, escalar e observar pipelines de IA e dados. Ele atua como um plano de controle unificado, permitindo que as equipes modelem ativos de dados, rastreiem a linhagem e garantam a qualidade dos dados com confiança. Ao integrar as melhores práticas de engenharia de software, como testes locais e componentes reutilizáveis, o Dagster ajuda engenheiros de dados e equipes de ML a entregar produtos de forma mais rápida e confiável.
Operações de Machine Learning
Voxel51
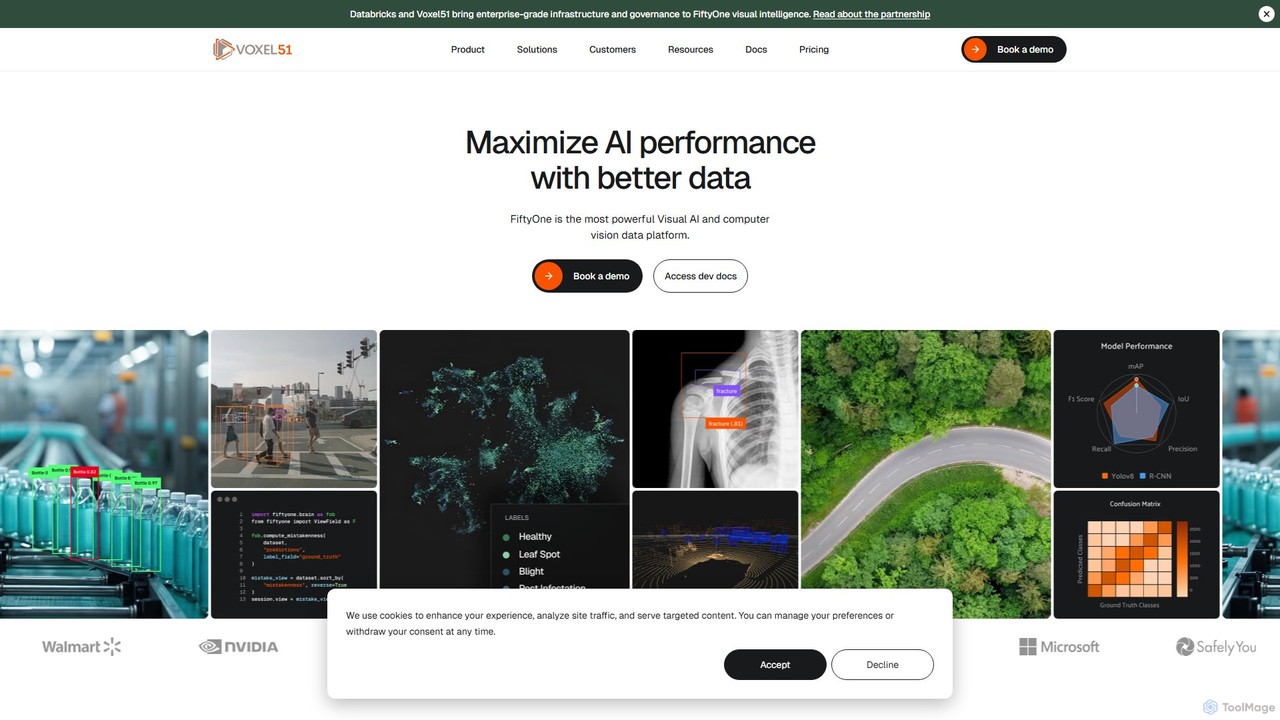
A Voxel51 fornece a FiftyOne, uma plataforma de visão computacional e IA multimodal de nível empresarial. Ela capacita desenvolvedores e cientistas de dados a curar, visualizar e avaliar conjuntos de dados complexos, levando a modelos de maior desempenho. Focando em IA centrada em dados, a FiftyOne otimiza os fluxos de trabalho para anotação de dados, melhoria de qualidade e análise de modelos, acelerando todo o ciclo de vida do desenvolvimento.
MLOps
Flyte
Flyte é uma plataforma de orquestração de fluxos de trabalho de código aberto e nativa da nuvem, projetada para construir, implantar e gerenciar pipelines de dados, aprendizado de máquina e análise de nível de produção. Enfatiza a escalabilidade, reprodutibilidade e facilidade de uso, permitindo que as equipes passem do desenvolvimento local para a produção em larga escala sem problemas. Com um SDK Python-first e suporte para múltiplos idiomas, o Flyte capacita cientistas de dados e engenheiros a criar fluxos de trabalho complexos, versionados e de fácil manutenção.
MLOps
Union.ai
Union.ai é uma plataforma de nível empresarial, pronta para produção, para orquestrar fluxos de trabalho complexos de IA e aprendizado de máquina. Construída sobre o Flyte de código aberto, ela capacita equipes a construir, servir e escalar sistemas de IA compostos com desempenho e eficiência inigualáveis. Ela preenche a lacuna entre dados e ML, otimiza os custos da nuvem com recursos como 'scale-to-zero' e aprimora a velocidade do desenvolvedor por meio de uma experiência integrada e contínua.
Orquestração
Metaflow
Um framework Python centrado no ser humano, originário da Netflix, para construir e gerenciar projetos de ciência de dados, ML e IA do mundo real. Simplifica a orquestração de fluxos de trabalho, gerenciamento de dados e implantação de modelos, permitindo prototipagem rápida e pipelines de produção escaláveis.
MLOps
Graphlit
Graphlit é uma plataforma de API de Conhecimento focada em desenvolvedores para a construção de aplicações e agentes de IA. Ela simplifica a ingestão, memória e recuperação de dados não estruturados de qualquer fonte, oferecendo uma poderosa solução de RAG-as-a-Service. Com SDKs para as principais linguagens e ferramentas para integração de agentes de IA, simplifica a criação de sistemas de IA sofisticados.
Trapo
Eventual
A Eventual está construindo o futuro da infraestrutura de dados com o Daft, um motor de consulta de código aberto e alto desempenho para dados multimodais. Ele permite que engenheiros processem imagens, vídeos, áudio e texto em escala de petabytes com a simplicidade do SQL, acelerando drasticamente os fluxos de trabalho de IA e ML sem a necessidade de profundo conhecimento em sistemas distribuídos.
Aprendizagem de MáquinaTidepool
Tidepool (anteriormente Aquarium) era uma poderosa plataforma MLOps projetada para equipes de IA melhorarem modelos de aprendizado de máquina. Especializava-se em gerenciar e curar conjuntos de dados para visão computacional e PNL, permitindo iteração mais rápida e maior desempenho do modelo através de uma abordagem centrada em dados.
Aprendizado de MáquinaOllama
Ollama é um poderoso framework de código aberto para executar grandes modelos de linguagem (LLMs) como Llama 3, Mistral e Gemma localmente em seu próprio hardware. Disponível para macOS, Windows e Linux, simplifica a configuração e o gerenciamento de modelos de código aberto, permitindo o desenvolvimento e uso de IA de forma privada, offline e econômica.
Aprendizado de MáquinaEncord
Encord é uma plataforma abrangente de desenvolvimento de dados para IA visual e multimodal. Fornece ferramentas para gerenciar, curar e anotar dados não estruturados em grande escala, como imagens, vídeos e arquivos DICOM. A plataforma ajuda equipes de IA a construir conjuntos de dados de alta qualidade, melhorar o desempenho do modelo e acelerar a implantação de aplicações de IA prontas para produção por meio de rotulagem avançada, avaliação de modelos e fluxos de trabalho com intervenção humana.
AnotaçãoBaseten
Baseten é uma plataforma de inferência de nível de produção para implantar, escalar e gerenciar modelos de IA. Oferece runtimes de alto desempenho, fluxos de trabalho de desenvolvedor contínuos e opções de implantação flexíveis (nuvem, auto-hospedado, híbrido). Ideal para equipes de engenharia e ML que constroem aplicações de IA de missão crítica.
Implantação
deepchecks
Deepchecks é uma plataforma de ponta a ponta para avaliar, validar e monitorar aplicações baseadas em LLM. Ajuda as equipes de IA a definir, medir e validar o progresso da IA, garantindo o lançamento de aplicações confiáveis e de alta qualidade, simplificando os testes desde o desenvolvimento, passando pelo CI/CD, até a produção.
Análise
Lightly
Lightly é uma suíte abrangente de visão computacional para equipes de aprendizado de máquina. Ele otimiza todo o ciclo de vida de desenvolvimento de modelos, desde a curadoria e seleção inteligente de dados em dispositivos de borda até o pré-treinamento e ajuste fino de modelos eficientes e sem rótulos. Ao focar nos dados mais valiosos, o Lightly ajuda a construir modelos de IA mais precisos e prontos para produção mais rapidamente, reduzindo significativamente os custos de rotulagem e armazenamento de dados.
Gestão de Dados
DataChain Comments (0)
Sign in to comment.
EntrarNo comments yet.