

hypermink Overview
O HyperMink é uma plataforma dedicada a tornar a IA acessível e privada, defendendo o princípio: "Sua IA, Suas Regras." Seu projeto principal, o Inferenceable, é um servidor de inferência de IA poderoso e de código aberto, projetado para simplicidade, desempenho e prontidão para produção. Construído com Node.js e aproveitando o núcleo de alto desempenho do llama.cpp e llamafile, o Inferenceable capacita desenvolvedores, pesquisadores e empresas a implantar e executar grandes modelos de linguagem (LLMs) em sua própria infraestrutura. Essa abordagem de auto-hospedagem garante privacidade e soberania absolutas dos dados, pois nenhuma informação precisa sair de sua rede local ou ambiente de nuvem. Ele desmistifica efetivamente o processo de uso de IA avançada, dando aos usuários controle total sobre seus modelos e dados, sem ficarem presos a APIs de terceiros caras e restritivas.
Como usar hypermink
Usar o Inferenceable, a ferramenta principal do HyperMink, envolve um processo direto para desenvolvedores familiarizados com tecnologias do lado do servidor:
- Baixar do GitHub: Acesse o repositório oficial do Inferenceable no GitHub e clone ou baixe o código-fonte para sua máquina local ou servidor.
- Instalar Dependências: Navegue até o diretório do projeto e instale as dependências necessárias do Node.js usando um gerenciador de pacotes como npm ou yarn.
- Baixar um Modelo de IA: Obtenha um LLM pré-treinado em um formato compatível, como GGUF, que é amplamente suportado pelo backend llama.cpp. Modelos como Llama 3, Mistral ou Phi-3 são excelentes escolhas.
- Configurar o Servidor: Edite o arquivo de configuração para especificar o caminho para o seu modelo baixado, definir a porta do servidor, definir o tamanho do contexto e ajustar outros parâmetros relacionados ao desempenho.
- Executar o Servidor: Inicie o servidor de inferência executando um comando simples em seu terminal. O servidor carregará o modelo especificado na memória e se preparará para aceitar solicitações de API.
- Integrar com Aplicações: Faça chamadas de API REST para o endpoint do servidor a partir de qualquer uma de suas aplicações — seja um aplicativo da web, um backend móvel ou um script de análise de dados — para obter respostas geradas pelo modelo.
Recursos principais do hypermink
- Código Aberto e Gratuito: O Inferenceable é totalmente gratuito para usar, modificar e distribuir sob sua licença de código aberto. Está disponível no GitHub para total transparência.
- Auto-Hospedado para Máxima Privacidade: Execute LLMs em seu próprio hardware, seja um desktop local ou um servidor de nuvem privado, garantindo que seus dados nunca saiam do seu controle.
- Motor de Alto Desempenho: Construído sobre o núcleo C/C++ altamente otimizado do llama.cpp, oferece velocidades de inferência rápidas com uso eficiente de recursos de CPU e GPU.
- Simples e Conectável: Projetado com uma arquitetura direta em Node.js, tornando-o fácil de configurar, gerenciar e estender com plugins ou modelos personalizados.
- Pronto para Produção: Estável e robusto o suficiente para ser implantado em ambientes de produção para alimentar aplicações de IA do mundo real.
- Amplo Suporte a Modelos: Compatível com uma vasta gama de LLMs de código aberto que usam o formato GGUF, dando a você a flexibilidade de escolher o melhor modelo para suas necessidades.
- Interface de API Padronizada: Fornece uma API RESTful limpa que é fácil de integrar com qualquer linguagem de programação ou plataforma.
Casos de uso para hypermink
O Inferenceable é ideal para uma variedade de aplicações onde a privacidade de dados, o custo e a personalização são críticos:
- Ferramentas de Negócios Internas: Desenvolva um chatbot privado para que os funcionários consultem bases de conhecimento internas ou resumam documentos confidenciais da empresa sem exposição de dados.
- Recursos Personalizados com IA: Integre geração de conteúdo, resumo de texto ou completação de código diretamente em seu produto de software sem depender de provedores de API externos.
- Pesquisa Acadêmica e de IA: Crie um ambiente controlado para experimentar diferentes LLMs, ajustar modelos e estudar seu comportamento sem limites de uso.
- Aplicações com Capacidade Offline: Construa ferramentas de IA que podem ser executadas em máquinas locais sem conexão com a internet, perfeitas para ambientes seguros ou remotos.
- Soluções de IA Custo-Efetivas: Potencialize tarefas de geração ou análise de texto de alto volume, evitando os custos por token associados às APIs comerciais de LLM.
Vantagens do hypermink
A principal vantagem do Inferenceable do HyperMink é o controle. Os usuários ganham soberania completa sobre sua pilha de IA. Isso se traduz em vários benefícios-chave: privacidade de dados incomparável, economia de custos significativa para casos de uso de alto volume, liberdade de restrições e limites de taxa de APIs de terceiros e a flexibilidade para personalizar todos os aspectos do modelo de IA e sua implantação. Além disso, ao executar modelos localmente, as aplicações podem alcançar menor latência, resultando em uma experiência de usuário mais responsiva.
Preços e planos
O produto principal do HyperMink, o servidor Inferenceable, é completamente gratuito e de código aberto. Está disponível para download no GitHub. Os usuários não precisam pagar nenhuma taxa de licença ou assinatura para usar o software. Os únicos custos envolvidos são aqueles associados ao próprio hardware do usuário (CPU, GPU, RAM) e à infraestrutura para hospedar o servidor.
hypermink Alternatives
Models
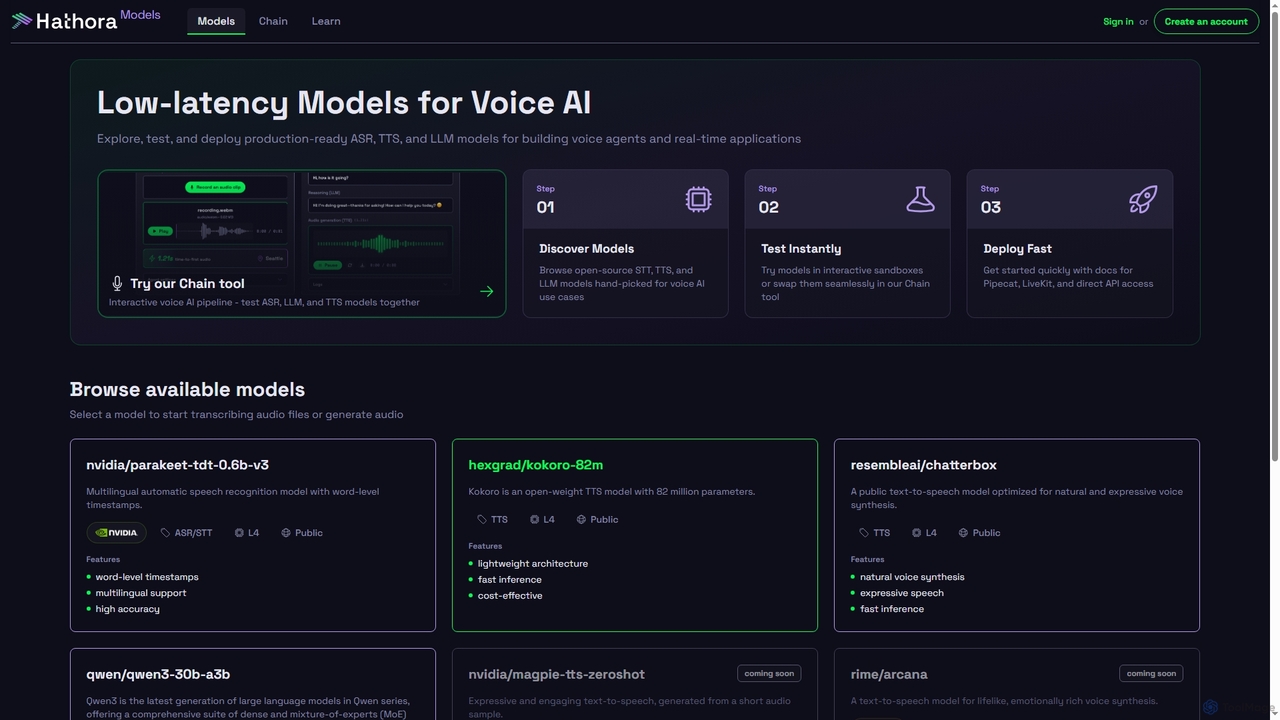
Models da Hathora oferece um catálogo selecionado de modelos ASR, TTS e LLM de baixa latência, otimizados para IA de voz e aplicações em tempo real. Desenvolvedores podem explorar, testar e implantar modelos prontos para produção rapidamente, com sandboxes interativas e acesso direto à API para integração perfeita em agentes de voz e outros aplicativos.
API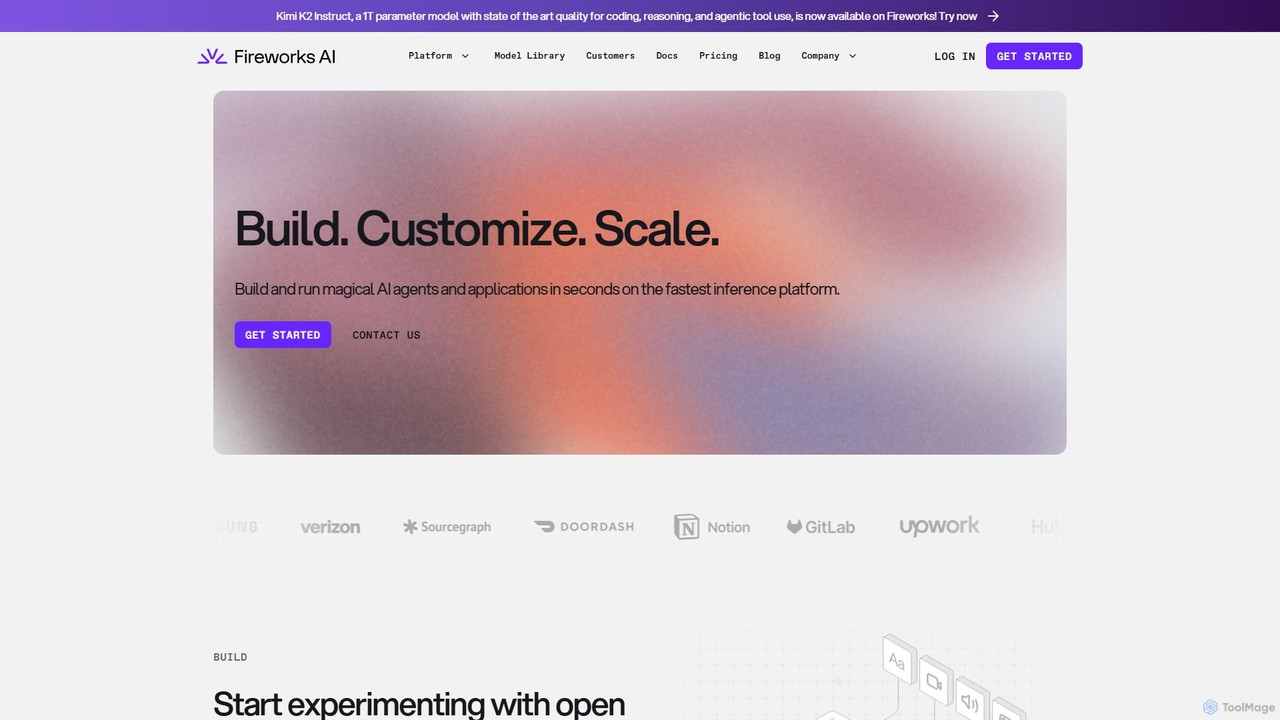
Fireworks AI
Uma plataforma de alto desempenho para desenvolvedores construírem, personalizarem e escalarem aplicações de IA generativa. Oferece um motor de inferência rápido líder do setor, capacidades avançadas de fine-tuning e acesso a uma vasta gama de modelos de código aberto, permitindo soluções de IA em tempo real e com custo-benefício.
Implantação de Modelo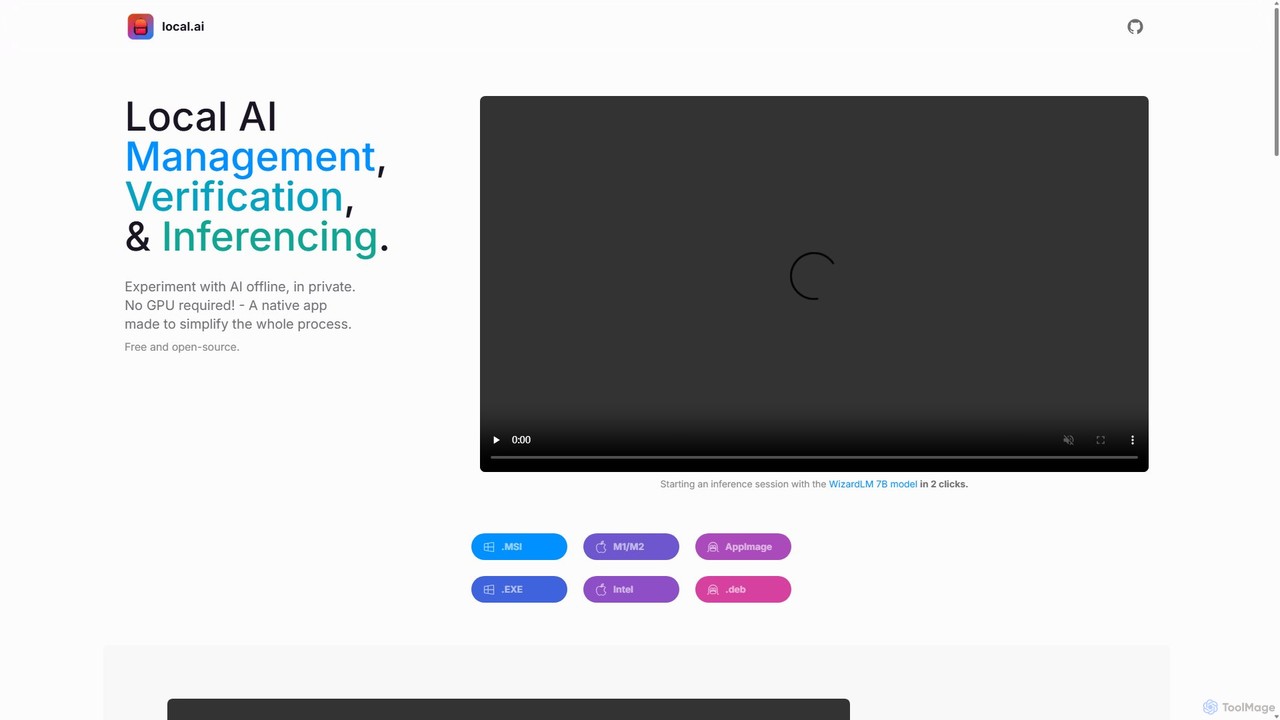
LocalAI
LocalAI é um aplicativo de desktop gratuito e de código aberto que permite executar modelos de IA de forma privada e offline no seu computador. Ele simplifica a experimentação com IA sem a necessidade de uma GPU, oferecendo recursos como gerenciamento de modelos, verificação de integridade e um servidor de inferência local.
Implantação de Modelo
vocode
O Vocode é uma plataforma de código aberto para construir, implantar e escalar agentes de IA de voz hiper-realistas. Ele fornece aos desenvolvedores um framework central e uma API de nível empresarial para criar aplicações sofisticadas de LLM baseadas em voz para tarefas como atendimento ao cliente automatizado, chamadas de vendas e sistemas de resposta de voz interativa (IVR).
Robô de voz
Comet
Comet é uma família de modelos de linguagem grandes (LLMs) de código aberto e alto desempenho, desenvolvidos pela Perplexity AI. Projetado para velocidade e precisão excepcionais, o Comet impulsiona aplicações de IA conversacional rápidas e está disponível para desenvolvedores via API e download direto.
Processamento de Linguagem Naturalhypermink Categories
hypermink Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
LocalAI
LocalAI é um aplicativo de desktop gratuito e de código aberto que permite executar modelos de IA de forma privada e offline no seu computador. Ele simplifica a experimentação com IA sem a necessidade de uma GPU, oferecendo recursos como gerenciamento de modelos, verificação de integridade e um servidor de inferência local.
Implantação de Modelo
vocode
O Vocode é uma plataforma de código aberto para construir, implantar e escalar agentes de IA de voz hiper-realistas. Ele fornece aos desenvolvedores um framework central e uma API de nível empresarial para criar aplicações sofisticadas de LLM baseadas em voz para tarefas como atendimento ao cliente automatizado, chamadas de vendas e sistemas de resposta de voz interativa (IVR).
Robô de vozComet
Comet é uma família de modelos de linguagem grandes (LLMs) de código aberto e alto desempenho, desenvolvidos pela Perplexity AI. Projetado para velocidade e precisão excepcionais, o Comet impulsiona aplicações de IA conversacional rápidas e está disponível para desenvolvedores via API e download direto.
Processamento de Linguagem Natural
Ollama
Ollama é um poderoso framework de código aberto para executar grandes modelos de linguagem (LLMs) como Llama 3, Mistral e Gemma localmente em seu próprio hardware. Disponível para macOS, Windows e Linux, simplifica a configuração e o gerenciamento de modelos de código aberto, permitindo o desenvolvimento e uso de IA de forma privada, offline e econômica.
Aprendizado de Máquina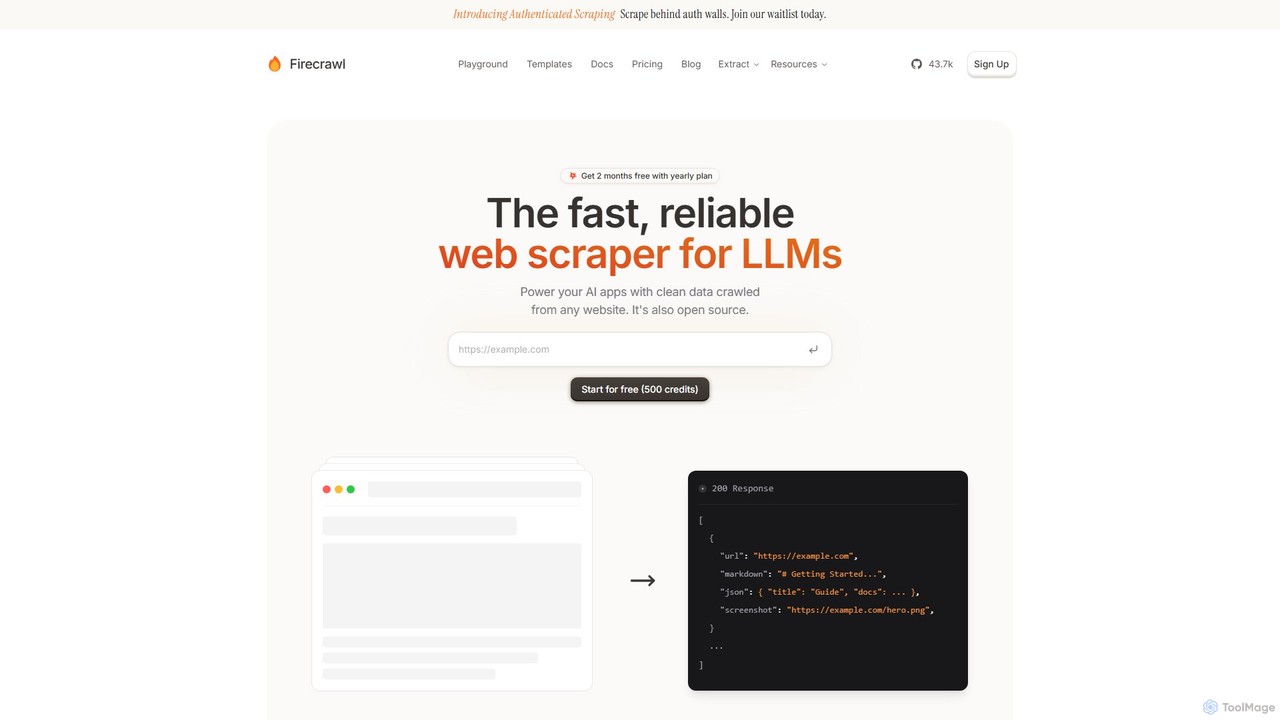
Firecrawl
Firecrawl é uma API de código aberto, focada em desenvolvedores, que transforma qualquer site em dados limpos e prontos para LLM. Ele lida com todas as complexidades da raspagem de dados da web, incluindo renderização de JavaScript, rotação de proxy e limites de taxa, permitindo que você potencialize aplicações de IA, agentes e sistemas RAG com conteúdo web confiável. Oferece funcionalidades de raspagem, rastreamento e pesquisa através de uma API simples.
Coleta de Dados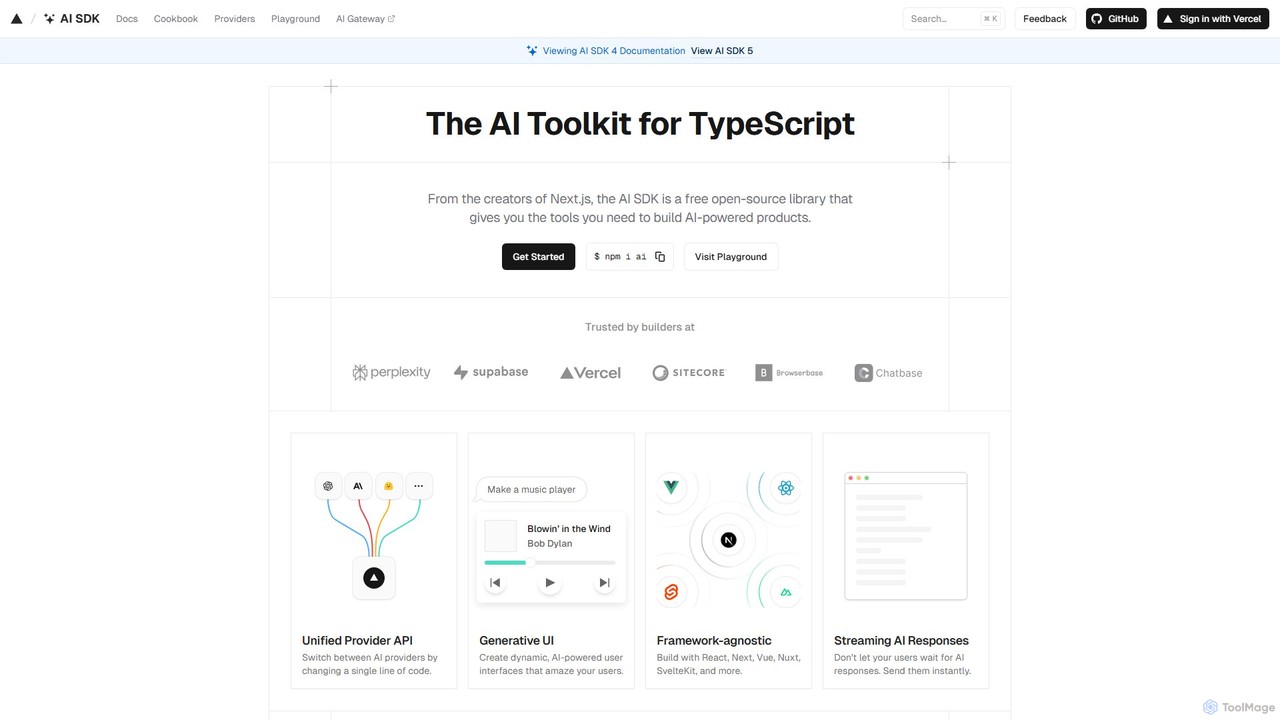
AI SDK
O AI SDK da Vercel é um kit de ferramentas TypeScript gratuito e de código aberto para a construção de aplicações alimentadas por IA. Ele fornece uma API unificada para integrar perfeitamente vários modelos de linguagem grandes (LLMs) como OpenAI, Google e Anthropic. Simplifica o desenvolvimento com recursos como respostas em streaming, componentes de UI generativos e chamada de ferramentas, permitindo que os desenvolvedores construam e enviem recursos de IA mais rapidamente em frameworks como Next.js, React e Svelte.
Biblioteca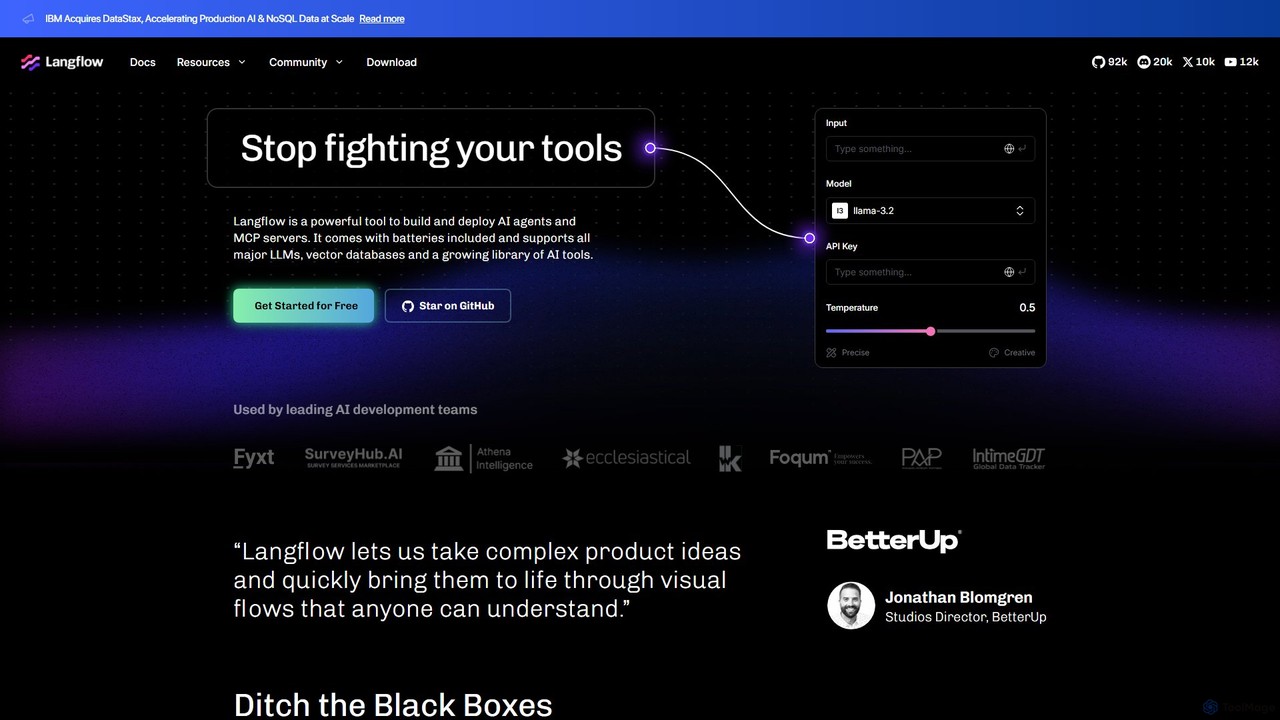
Langflow
Langflow é uma UI visual de código aberto para construir e implantar aplicações de IA. Possui uma interface de arrastar e soltar para encadear LLMs, agentes e ferramentas, permitindo a prototipagem e implantação rápidas de fluxos de trabalho complexos como RAG e sistemas multiagente. Suporta integrações extensas e oferece opções auto-hospedadas e na nuvem.
Low-code No-code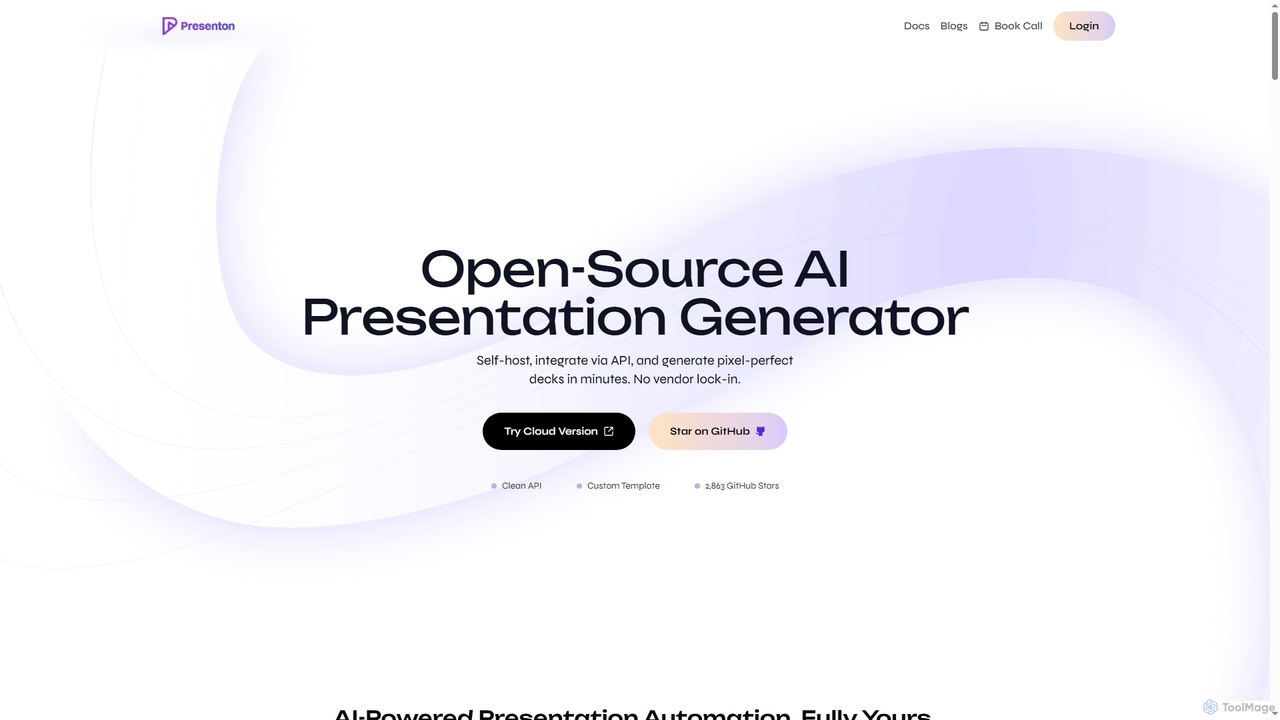
Presenton
Presenton é um gerador de apresentações de IA de código aberto projetado para desenvolvedores e equipes. Permite auto-hospedagem, integração via API e a criação de apresentações perfeitas e alinhadas à marca a partir de modelos personalizados, garantindo controle total, privacidade e sem dependência de fornecedor.
Automação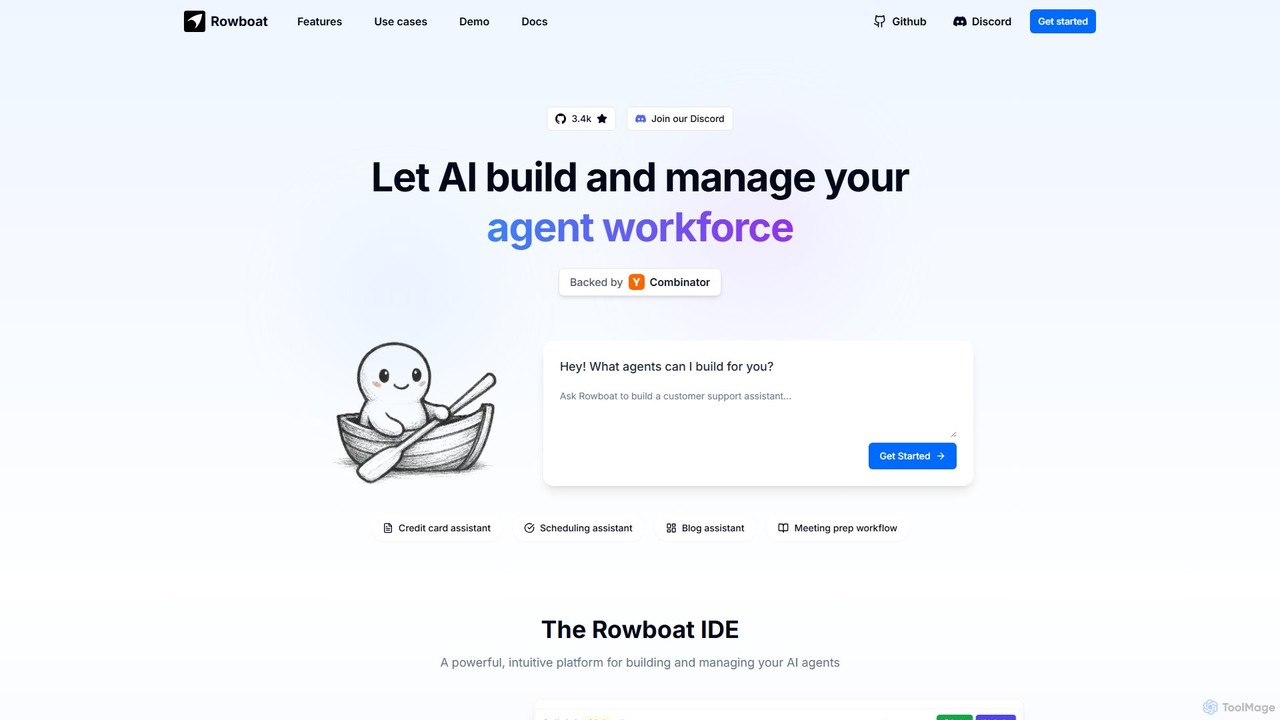
Rowboat
Rowboat é um poderoso IDE alimentado por IA para construir, gerenciar e implantar sistemas complexos de múltiplos agentes. Apoiado pela Y Combinator, permite que os usuários descrevam fluxos de trabalho em inglês simples, e seu copiloto de IA gera automaticamente todo o gráfico de agentes, incluindo papéis, prompts e integrações de ferramentas. Foi projetado para simplificar a criação de agentes de IA robustos e do mundo real para produtividade, e-commerce, suporte e mais, com recursos como flexibilidade de código aberto e suporte para mais de 100 LLMs.
Construtor de Agentes
Forefront
Forefront é uma plataforma de desenvolvimento para construir com IA de código aberto. Simplifica a execução, o ajuste fino e a implantação de grandes modelos de linguagem (LLMs) em seus dados privados, oferecendo uma alternativa escalável, segura e econômica às plataformas de código fechado. Seja dono de seus dados, seus modelos e sua IA.
Grandes Modelos de Linguagem
boundaryml
boundaryml (BAML) é uma linguagem de programação e kit de ferramentas especializado para desenvolvedores extraírem dados estruturados de Modelos de Linguagem Grandes (LLMs) de forma confiável. Transforma a complexa engenharia de prompts em um processo simplificado, semelhante a código, garantindo saídas com segurança de tipo e correção de erros em vários LLMs e linguagens de programação como Python e TypeScript. Foi projetado para aumentar a confiabilidade, reduzir custos e acelerar os ciclos de desenvolvimento de aplicações de IA.
API
Chatbot UI
O Chatbot UI é uma interface de chatbot de código aberto que permite conectar-se a mais de 80 modelos de IA, incluindo os da OpenAI, Google e Anthropic. Oferece uma alternativa auto-hospedável e personalizável às plataformas de chat proprietárias, dando aos utilizadores controlo total sobre os seus dados e conversas. Organize chats, crie prompts e alterne facilmente entre modelos num único espaço de trabalho unificado.
Gerenciamento de API
LM Studio
O LM Studio é um aplicativo de desktop fácil de usar para descobrir, baixar e executar Modelos de Linguagem Grandes (LLMs) de código aberto localmente no seu computador. Oferece uma interface de chat simples e um servidor de inferência local, garantindo privacidade e acesso offline.
Chat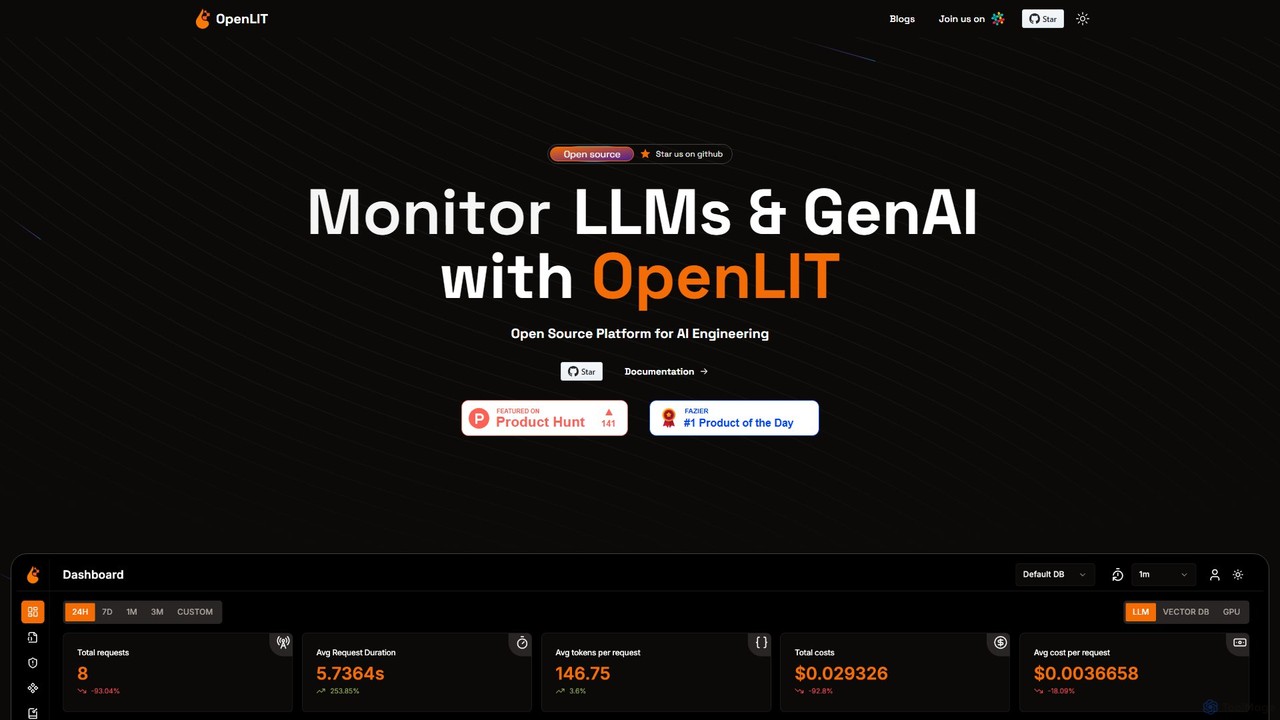
OpenLIT
O OpenLIT é uma plataforma de observabilidade de código aberto, nativa do OpenTelemetry, para aplicações de IA Generativa e LLM. Ele simplifica o desenvolvimento com ferramentas para rastreamento de solicitações, acompanhamento de custos, monitoramento de exceções e análise de desempenho. Com um repositório centralizado de prompts, um cofre seguro para segredos e um playground para comparar LLMs, o OpenLIT oferece uma solução abrangente para monitorar e escalar aplicações de IA com eficiência.
Gestão de Modelos
hypermink Comments (0)
Sign in to comment.
EntrarNo comments yet.