
Crawlbase Overview
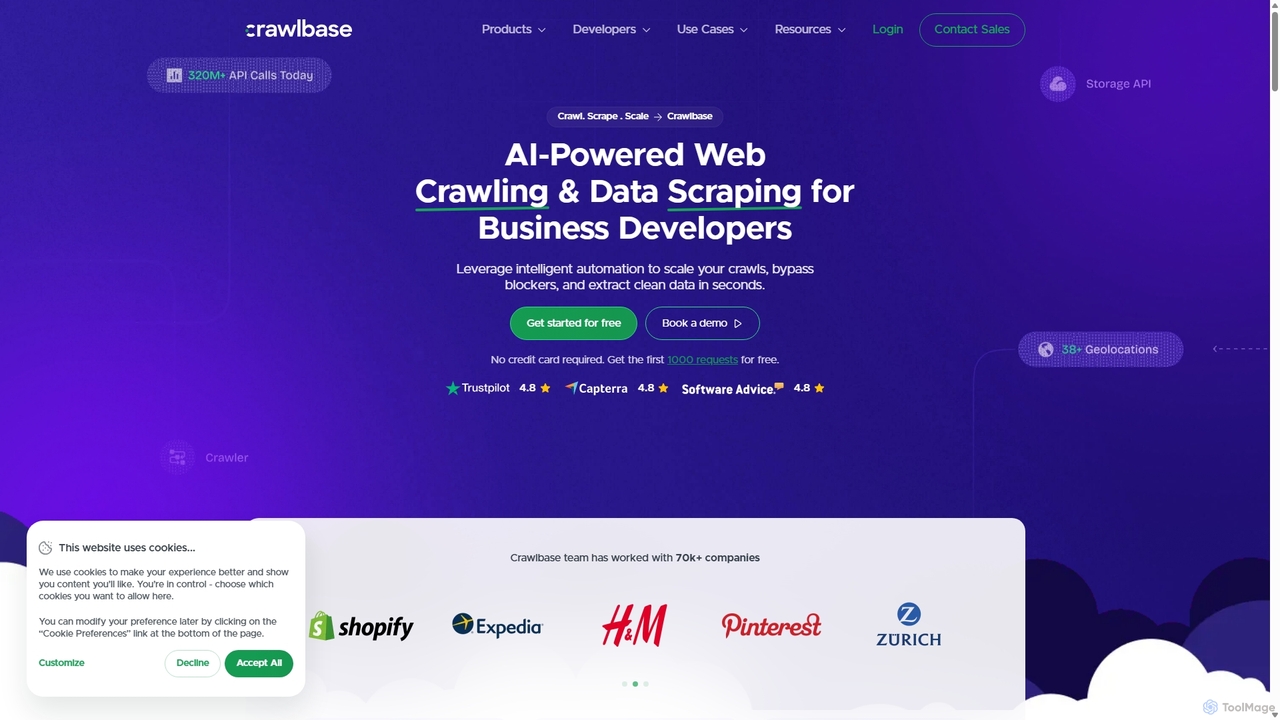
Crawlbase là một nền tảng toàn diện, do AI điều khiển, được thiết kế để dân chủ hóa quyền truy cập vào dữ liệu web. Nó trao quyền cho các nhà phát triển, nhà khoa học dữ liệu và doanh nghiệp thu thập và cào dữ liệu trên internet ở quy mô lớn, biến đổi nội dung web phi cấu trúc thành dữ liệu sạch, có cấu trúc. Bằng cách xử lý cơ sở hạ tầng phức tạp của proxy, tự động hóa trình duyệt và hệ thống chống bot, Crawlbase cho phép người dùng chỉ tập trung vào việc sử dụng dữ liệu. Nền tảng này được xây dựng trên nền tảng hàng triệu proxy dân cư và trung tâm dữ liệu xoay vòng trên toàn thế giới, đảm bảo quyền truy cập ẩn danh và không bị hạn chế vào các trang web như Amazon, LinkedIn, Google, v.v., với thời gian hoạt động được đảm bảo là 99,9%.
Cách sử dụng Crawlbase
Việc tích hợp Crawlbase vào quy trình làm việc của bạn được thiết kế để đơn giản và có thể hoàn thành trong vài phút:
- Tạo tài khoản: Đăng ký tài khoản Crawlbase miễn phí. Bạn sẽ nhận được một mã thông báo API để xác thực. Gói ban đầu bao gồm 1.000 yêu cầu miễn phí để thử nghiệm dịch vụ mà không cần thẻ tín dụng.
- Chọn công cụ phù hợp: Chọn sản phẩm phù hợp với nhu cầu của bạn. Sử dụng API Thu thập dữ liệu (Crawling API) cho các yêu cầu dữ liệu đồng bộ, thời gian thực. Đối với các dự án quy mô lớn, đang diễn ra, Trình thu thập dữ liệu (Crawler) không đồng bộ sẽ tiết kiệm chi phí hơn. Nếu bạn cần một cổng proxy đơn giản cho ứng dụng của mình, Proxy Thông minh (Smart Proxy) là lựa chọn lý tưởng.
- Thực hiện yêu cầu API: Thực hiện một cuộc gọi API đơn giản đến điểm cuối của Crawlbase, truyền mã thông báo API của bạn và URL mục tiêu bạn muốn cào. Bạn có thể bao gồm các tham số khác nhau để bật kết xuất JavaScript, đặt vị trí địa lý hoặc sử dụng các trình cào dữ liệu cụ thể.
- Nhận dữ liệu: Crawlbase xử lý yêu cầu, điều hướng qua các khối chặn, proxy và CAPTCHA. Sau đó, nó trả về nội dung HTML đầy đủ của trang hoặc, nếu sử dụng một trình cào cụ thể (như trình cào Amazon), cung cấp dữ liệu ở định dạng JSON có cấu trúc.
Tính năng chính của Crawlbase
- API Thu thập dữ liệu (Crawling API): Một API mạnh mẽ, dễ sử dụng, lấy nội dung trang web trong thời gian thực. Nó hỗ trợ kết xuất JavaScript cho các trang web động và bao gồm các trình cào tích hợp cho các trang web phổ biến như Amazon, cung cấp dữ liệu có cấu trúc trực tiếp.
- Trình thu thập dữ liệu (The Crawler): Một giải pháp thu thập dữ liệu không đồng bộ được thiết kế cho các dự án trích xuất dữ liệu lớn. Nó sử dụng các lệnh gọi lại (callbacks) để cung cấp dữ liệu đến máy chủ của bạn, tiết kiệm chi phí, băng thông và số lần thử lại cho khối lượng lớn URL.
- Proxy Thông minh (Smart Proxy): Một giải pháp proxy xoay vòng cung cấp quyền truy cập vào hàng triệu IP của trung tâm dữ liệu và dân cư. Nó có thể dễ dàng tích hợp vào bất kỳ ứng dụng hoặc tập lệnh nào yêu cầu một proxy đáng tin cậy để tránh bị chặn.
- Công nghệ chống chặn được hỗ trợ bởi AI: Các thuật toán và mô hình học máy tinh vi tự động xử lý các khối chặn IP, dấu vân tay trình duyệt, CAPTCHA và các biện pháp chống cào dữ liệu khác, đảm bảo tỷ lệ thành công cao.
- Lưu trữ đám mây: Một tính năng tiện lợi cho phép bạn di chuyển dữ liệu đã thu thập và cào trực tiếp đến bộ nhớ đám mây an toàn của Crawlbase, đơn giản hóa quy trình dữ liệu của bạn.
- Định vị địa lý toàn cầu: Truy cập nội dung web từ hơn 30 quốc gia khác nhau, cho phép bạn thực hiện các tìm kiếm được bản địa hóa và thu thập dữ liệu theo khu vực cụ thể.
Các trường hợp sử dụng Crawlbase
Crawlbase rất linh hoạt và hỗ trợ một loạt các hoạt động kinh doanh dựa trên dữ liệu:
- Thương mại điện tử & Bán lẻ: Theo dõi giá của đối thủ cạnh tranh, theo dõi tình trạng sẵn có của sản phẩm, tổng hợp đánh giá của khách hàng và phân tích dữ liệu sản phẩm từ các nền tảng như Amazon, eBay và Walmart để tối ưu hóa chiến lược bán hàng.
- Nghiên cứu thị trường: Thu thập lượng lớn dữ liệu để phân tích xu hướng thị trường, phân tích tình cảm từ mạng xã hội và diễn đàn, và xác định các cơ hội kinh doanh mới nổi.
- Tạo khách hàng tiềm năng: Tự động hóa quy trình thu thập thông tin liên hệ và chi tiết doanh nghiệp từ các mạng chuyên nghiệp như LinkedIn, thư mục trực tuyến và trang web của công ty.
- AI và Học máy: Cung cấp các bộ dữ liệu có cấu trúc, chất lượng cao để đào tạo AI tạo sinh và các mô hình ngôn ngữ lớn (LLM). API có thể thu thập hiệu quả khối lượng lớn dữ liệu văn bản và hình ảnh cần thiết.
- Giám sát SEO: Theo dõi thứ hạng từ khóa trên các công cụ tìm kiếm và địa điểm khác nhau, phân tích chiến lược SEO của đối thủ cạnh tranh và thực hiện kiểm tra trang web toàn diện mà không bị chặn.
Ưu điểm của Crawlbase
Crawlbase mang lại lợi thế cạnh tranh đáng kể bằng cách trừu tượng hóa sự phức tạp của việc cào dữ liệu web. Thay vì xây dựng và duy trì một cơ sở hạ tầng nội bộ tốn kém và mong manh, người dùng được hưởng lợi từ một giải pháp đáng tin cậy, có thể mở rộng và tiết kiệm chi phí. Các ưu điểm chính của nền tảng bao gồm mạng lưới proxy khổng lồ, tỷ lệ thành công cao (trên 99%), đảm bảo thời gian hoạt động 99,9% và hỗ trợ chuyên gia 24/7. Cách tiếp cận ưu tiên nhà phát triển của nó đảm bảo tích hợp dễ dàng và tài liệu mạnh mẽ, trong khi cam kết tuân thủ (GDPR & CCPA) mang lại sự yên tâm cho các doanh nghiệp.
Giá cả và gói dịch vụ
Crawlbase hoạt động theo mô hình freemium linh hoạt và minh bạch. Người dùng mới có thể bắt đầu với gói miễn phí bao gồm 1.000 yêu cầu miễn phí, cho phép họ kiểm tra đầy đủ các khả năng của nền tảng mà không cần cung cấp thẻ tín dụng. Sau thời gian dùng thử miễn phí, giá cả dựa trên hệ thống trả tiền theo mức sử dụng, trong đó chi phí được xác định bởi số lượng yêu cầu được thực hiện và các tính năng được sử dụng (ví dụ: yêu cầu tiêu chuẩn so với yêu cầu có bật JavaScript). Đối với các doanh nghiệp có nhu cầu dữ liệu lớn, Crawlbase cung cấp các gói Doanh nghiệp được thiết kế riêng đi kèm với giá cả tùy chỉnh, quản lý tài khoản chuyên dụng và hỗ trợ cao cấp để đáp ứng các yêu cầu dự án cụ thể.
Traffic
Latest traffic
Status
Monthly traffic trend
- 2025-9: 82.1K
- 2026-1: 74.4K
- 2026-2: 50.0K
- 2026-3: 46.3K
- 2026-4: 35.7K
- 2026-5: 32.4K
Geography
Top 5 countries / regions
- 🇩🇪Đức26.0%
- 🇷🇺Nga22.6%
- 🇻🇳Việt Nam18.4%
- 🇳🇬Nigeria17.5%
- 🇺🇸Hoa Kỳ15.6%
Top keywords
| Keyword | Cost per click |
|---|---|
| apify | $0.89 |
| crawlbase | $2.99 |
| deviantart scraper | $0.00 |
| webscraping at scale | $0.00 |
| прокси в 2026 году бесплатно | $0.00 |
Crawlbase Alternatives
Scrappey
Scrappey là một API cào dữ liệu web tiên tiến được thiết kế để các nhà phát triển dễ dàng trích xuất dữ liệu từ bất kỳ trang web nào. Nó xử lý tất cả các phức tạp như proxy xoay vòng, trình duyệt không đầu và vượt qua các biện pháp chống bot như Cloudflare và CAPTCHA. Với tỷ lệ thành công cao và mô hình trả tiền theo mức sử dụng đơn giản, Scrappey hợp lý hóa việc thu thập dữ liệu cho các ứng dụng khác nhau.
Trích xuất Dữ liệu
Crawlora
Crawlora là một nền tảng trích xuất dữ liệu web không cần code, được hỗ trợ bởi AI, cho phép người dùng dễ dàng lấy dữ liệu từ bất kỳ trang web nào. Giao diện trỏ và nhấp thông minh của nó đơn giản hóa việc trích xuất dữ liệu, cho phép bạn biến các trang web thành dữ liệu có cấu trúc (CSV, JSON) mà không cần viết một dòng mã nào. Lý tưởng cho nghiên cứu thị trường, tạo khách hàng tiềm năng và theo dõi giá cả.
Trích xuất Dữ liệu
Octoparse
Octoparse là một công cụ cào dữ liệu web không cần code mạnh mẽ, cho phép bất kỳ ai cũng có thể trích xuất dữ liệu từ các trang web mà không cần lập trình. Nó có trình thiết kế quy trình làm việc trực quan, trợ lý AI để thiết lập dễ dàng và hàng trăm mẫu dựng sẵn cho các trang web phổ biến. Với tự động hóa dựa trên đám mây, xoay vòng IP và giải CAPTCHA, Octoparse xử lý các tác vụ cào dữ liệu phức tạp một cách hiệu quả, biến các trang web thành dữ liệu có cấu trúc để tạo khách hàng tiềm năng, nghiên cứu thị trường, v.v.
Cào dữ liệu web
Browserless
Browserless là một nền tảng Trình duyệt dưới dạng Dịch vụ (BaaS) mạnh mẽ được thiết kế để scraping web và tự động hóa trình duyệt có khả năng mở rộng. Nó giúp các nhà phát triển vượt qua CAPTCHA và các trình phát hiện bot một cách dễ dàng bằng cách sử dụng Puppeteer, Playwright hoặc ngôn ngữ BrowserQL độc quyền của nó. Dịch vụ này quản lý cơ sở hạ tầng trình duyệt, cho phép người dùng tập trung vào việc xây dựng các kịch bản tự động hóa mà không cần lo lắng về việc cập nhật, rò rỉ bộ nhớ hoặc mở rộng quy mô.
Trích xuất Dữ liệu
FetchFox
FetchFox là một công cụ cào web được hỗ trợ bởi AI cho phép người dùng trích xuất dữ liệu từ bất kỳ trang web nào bằng các lời nhắc văn bản đơn giản. Nó loại bỏ nhu cầu về mã hóa phức tạp hoặc bộ chọn CSS, tự động xử lý các biện pháp chống bot. Có sẵn dưới dạng API, thư viện JavaScript và tiện ích mở rộng Chrome, nó được thiết kế cho cả nhà phát triển và người dùng không chuyên về kỹ thuật để tự động hóa việc thu thập dữ liệu một cách dễ dàng.
Trích xuất Dữ liệuCrawlbase Categories
Crawlbase Jobs
Crawlbase Embed Widget
Copy this embed code to place the badge on your blog, article, or product site and send readers directly to this ToolMage detail page.

Related AI tools
Scrappey
Scrappey là một API cào dữ liệu web tiên tiến được thiết kế để các nhà phát triển dễ dàng trích xuất dữ liệu từ bất kỳ trang web nào. Nó xử lý tất cả các phức tạp như proxy xoay vòng, trình duyệt không đầu và vượt qua các biện pháp chống bot như Cloudflare và CAPTCHA. Với tỷ lệ thành công cao và mô hình trả tiền theo mức sử dụng đơn giản, Scrappey hợp lý hóa việc thu thập dữ liệu cho các ứng dụng khác nhau.
Trích xuất Dữ liệu
Zyte
Zyte là một nền tảng web scraping toàn diện cung cấp API full-stack và dịch vụ trích xuất dữ liệu. Nó đơn giản hóa việc thu thập dữ liệu bằng cách quản lý proxy, trình duyệt không đầu và các hệ thống chống chặn tiên tiến. Được hỗ trợ bởi AI, Zyte cung cấp dữ liệu web đáng tin cậy, có cấu trúc ở quy mô lớn cho các doanh nghiệp trong lĩnh vực thương mại điện tử, nghiên cứu thị trường, v.v.
Thông tin thị trườngOctoparse
Octoparse là một công cụ cào dữ liệu web không cần code mạnh mẽ, cho phép bất kỳ ai cũng có thể trích xuất dữ liệu từ các trang web mà không cần lập trình. Nó có trình thiết kế quy trình làm việc trực quan, trợ lý AI để thiết lập dễ dàng và hàng trăm mẫu dựng sẵn cho các trang web phổ biến. Với tự động hóa dựa trên đám mây, xoay vòng IP và giải CAPTCHA, Octoparse xử lý các tác vụ cào dữ liệu phức tạp một cách hiệu quả, biến các trang web thành dữ liệu có cấu trúc để tạo khách hàng tiềm năng, nghiên cứu thị trường, v.v.
Cào dữ liệu webCrawlora
Crawlora là một nền tảng trích xuất dữ liệu web không cần code, được hỗ trợ bởi AI, cho phép người dùng dễ dàng lấy dữ liệu từ bất kỳ trang web nào. Giao diện trỏ và nhấp thông minh của nó đơn giản hóa việc trích xuất dữ liệu, cho phép bạn biến các trang web thành dữ liệu có cấu trúc (CSV, JSON) mà không cần viết một dòng mã nào. Lý tưởng cho nghiên cứu thị trường, tạo khách hàng tiềm năng và theo dõi giá cả.
Trích xuất Dữ liệuBrowserless
Browserless là một nền tảng Trình duyệt dưới dạng Dịch vụ (BaaS) mạnh mẽ được thiết kế để scraping web và tự động hóa trình duyệt có khả năng mở rộng. Nó giúp các nhà phát triển vượt qua CAPTCHA và các trình phát hiện bot một cách dễ dàng bằng cách sử dụng Puppeteer, Playwright hoặc ngôn ngữ BrowserQL độc quyền của nó. Dịch vụ này quản lý cơ sở hạ tầng trình duyệt, cho phép người dùng tập trung vào việc xây dựng các kịch bản tự động hóa mà không cần lo lắng về việc cập nhật, rò rỉ bộ nhớ hoặc mở rộng quy mô.
Trích xuất Dữ liệu
Kadabra
Kadabra là một nền tảng được hỗ trợ bởi AI, biến các mô tả tiếng Anh đơn giản thành các quy trình tự động hóa dữ liệu và kinh doanh có chức năng, có thể triển khai. Nó cho phép người dùng xây dựng, kiểm tra và triển khai các quy trình làm việc phức tạp một cách trực quan trong vài phút, tích hợp với nhiều công cụ phổ biến để hợp lý hóa hoạt động và nâng cao năng suất.
Quản lý vận hành
Thordata
Thordata là nhà cung cấp dịch vụ proxy hiệu suất cao được thiết kế cho việc cào dữ liệu web quy mô lớn và các ứng dụng AI. Nền tảng này cung cấp một mạng lưới toàn cầu với hơn 60 triệu proxy dân cư, di động, ISP và trung tâm dữ liệu với thời gian hoạt động cao và độ trễ thấp. Thordata cũng cung cấp các API Scraper mạnh mẽ và một Chợ dữ liệu để đơn giản hóa việc thu thập dữ liệu cho các nhiệm vụ như huấn luyện mô hình AI, giám sát thương mại điện tử, phân tích SEO và bảo vệ thương hiệu, đảm bảo quyền truy cập đáng tin cậy và có thể mở rộng vào dữ liệu web công cộng.
Thu thập dữ liệu
Jyek
Jyek là một nền tảng AI agent hiểu mục tiêu, tạo kế hoạch thực thi, sử dụng công cụ và cung cấp kết quả có thể xác minh cho các tác vụ phức tạp nhiều bước.
Tự động hóa
Serpex
Serpex là một API tìm kiếm nhanh, giá cả phải chăng và đáng tin cậy được thiết kế cho các dự án AI và dữ liệu. Nó cung cấp kết quả tìm kiếm web có cấu trúc, thời gian thực từ nhiều công cụ tìm kiếm lớn, vượt qua các thách thức phổ biến như CAPTCHA và chặn địa lý.
Nguồn dữ liệuFetchFox
FetchFox là một công cụ cào web được hỗ trợ bởi AI cho phép người dùng trích xuất dữ liệu từ bất kỳ trang web nào bằng các lời nhắc văn bản đơn giản. Nó loại bỏ nhu cầu về mã hóa phức tạp hoặc bộ chọn CSS, tự động xử lý các biện pháp chống bot. Có sẵn dưới dạng API, thư viện JavaScript và tiện ích mở rộng Chrome, nó được thiết kế cho cả nhà phát triển và người dùng không chuyên về kỹ thuật để tự động hóa việc thu thập dữ liệu một cách dễ dàng.
Trích xuất Dữ liệu
Foxscrape
FoxScrape là một API REST cào dữ liệu web được hỗ trợ bởi AI dành cho các nhà phát triển. Nó đơn giản hóa việc trích xuất dữ liệu bằng cách chuyển đổi bất kỳ trang web nào thành dữ liệu JSON có cấu trúc bằng các tính năng như phân tích cú pháp do AI điều khiển từ tiếng Anh đơn giản, kết xuất JavaScript cho các trang web động và xoay vòng proxy tự động để ngăn chặn việc bị chặn.
Trích xuất Dữ liệu
PandaExtract
PandaExtract là tiện ích mở rộng cào web không cần code tối ưu cho Chrome. Nó cho phép các chuyên gia trích xuất dữ liệu từ bất kỳ trang web nào chỉ bằng một cú nhấp chuột. Lý tưởng cho nghiên cứu thị trường, tạo khách hàng tiềm năng, theo dõi giá và phân tích đối thủ cạnh tranh, không yêu cầu kỹ năng lập trình.
Cào dữ liệu web
Bright Data
Bright Data là nền tảng dữ liệu web hàng đầu thế giới, cung cấp một bộ công cụ toàn diện bao gồm mạng proxy, trình thu thập dữ liệu web do AI hỗ trợ và các bộ dữ liệu sẵn sàng sử dụng. Nó cho phép các doanh nghiệp thu thập lượng lớn dữ liệu web công khai để huấn luyện AI, nghiên cứu thị trường và tình báo cạnh tranh.
Kinh doanh thông minh
Apify
Apify là một nền tảng tự động hóa và trích xuất dữ liệu web toàn diện (full-stack) cho phép các nhà phát triển xây dựng, triển khai và xuất bản các công cụ trích xuất dữ liệu, được gọi là 'Actors'. Nền tảng này cung cấp một thị trường rộng lớn các công cụ trích xuất dữ liệu dựng sẵn cho các trang web phổ biến như Google Maps, Instagram và TikTok, cùng với một cơ sở hạ tầng đám mây mạnh mẽ để tạo ra các giải pháp tùy chỉnh. Với sự hỗ trợ cho Python và JavaScript, các thư viện mã nguồn mở và tích hợp liền mạch, Apify đơn giản hóa việc thu thập dữ liệu web ở mọi quy mô.
Thu thập Dữ liệu
Skyvern
Skyvern là một nền tảng tự động hóa trình duyệt do AI cung cấp, sử dụng thị giác máy tính và ngôn ngữ tự nhiên để tự động hóa các quy trình công việc web phức tạp. Nó có thể xử lý trích xuất dữ liệu, gửi biểu mẫu, truy xuất hóa đơn và nhiều hơn nữa trên bất kỳ trang web nào, tự động thích ứng với các thay đổi mà không cần kịch bản truyền thống.
API
Crawlbase Comments (0)
Sign in to comment.
Đăng nhậpNo comments yet.